
Pdf Vision Foundation Models As Effective Visual Tokenizers For

(PDF) Vision Foundation Models as Effective Visual Tokenizers for ...
Vision Foundation Models as Effective Visual Tokenizers for ...

NeurIPS Poster Vision Foundation Models as Effective Visual Tokenizers ...

Paper page - Vision Foundation Models as Effective Visual Tokenizers ...

Paper page - Vision Foundation Models Can Be Good Tokenizers for Latent ...
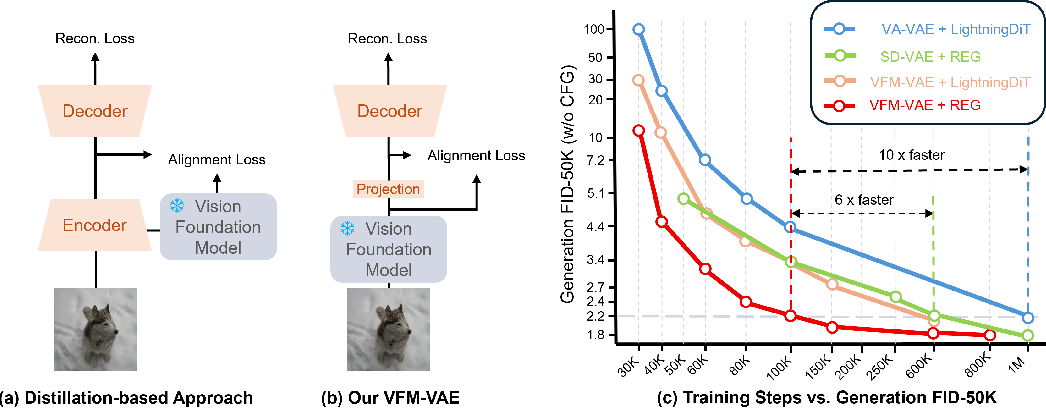
Figure 1 from Vision Foundation Models Can Be Good Tokenizers for ...

Aligning Visual Foundation Encoders to Tokenizers for Diffusion Models ...

VFM-VAE: Vision Foundation Models Can Be Good Tokenizers for Latent ...

Vision Foundation Models Can Be Good Tokenizers for Latent Diffusion ...
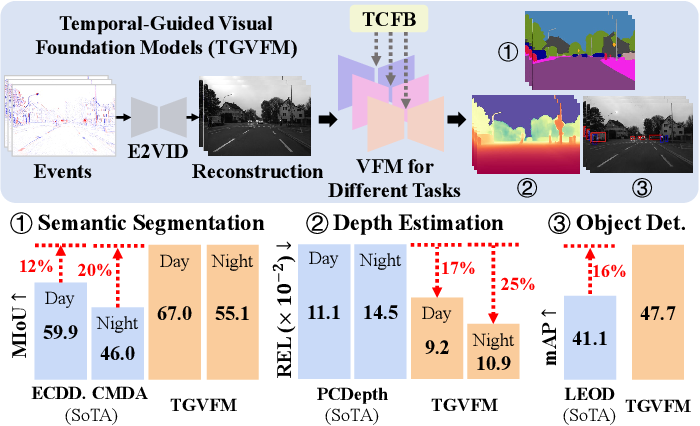
Figure 1 from Temporal-Guided Visual Foundation Models for Event-Based ...
Advertisement Space (300x250)
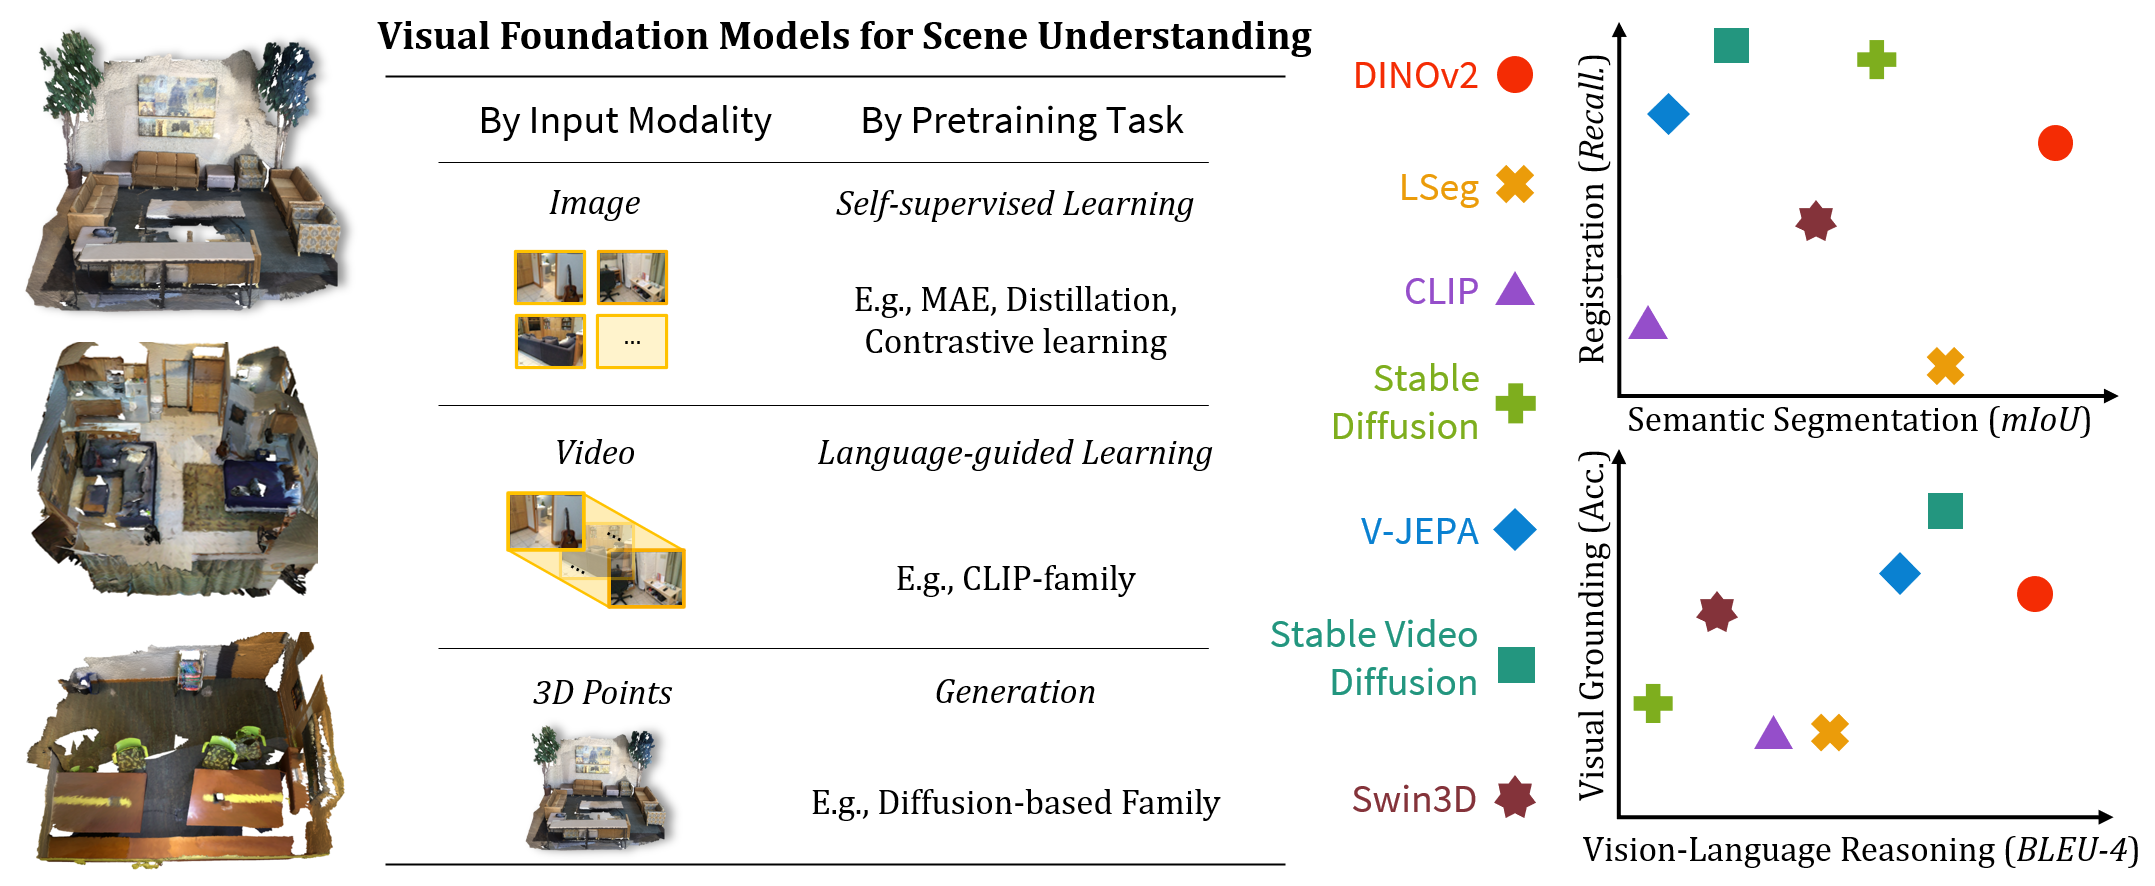
Lexicon3D: Probing Visual Foundation Models for Complex 3D Scene ...

Exploring Large-Scale Vision Foundation Models With | PDF

Vector-Quantized Vision Foundation Models for Object-Centric Learning ...

(PDF) EffoVPR: Effective Foundation Model Utilization for Visual Place ...

Vision Models for Cost-Efficient PDF Parsing in RAG

ICLR Poster Aligning Visual Foundation Encoders to Tokenizers for ...

An investigation of visual foundation models robustness | Request PDF

Advances in Vision Foundation Models | PDF | Cognitive Science ...

(PDF) Vision Foundation Models for Computed Tomography

Paper page - EffoVPR: Effective Foundation Model Utilization for Visual ...
Advertisement Space (336x280)
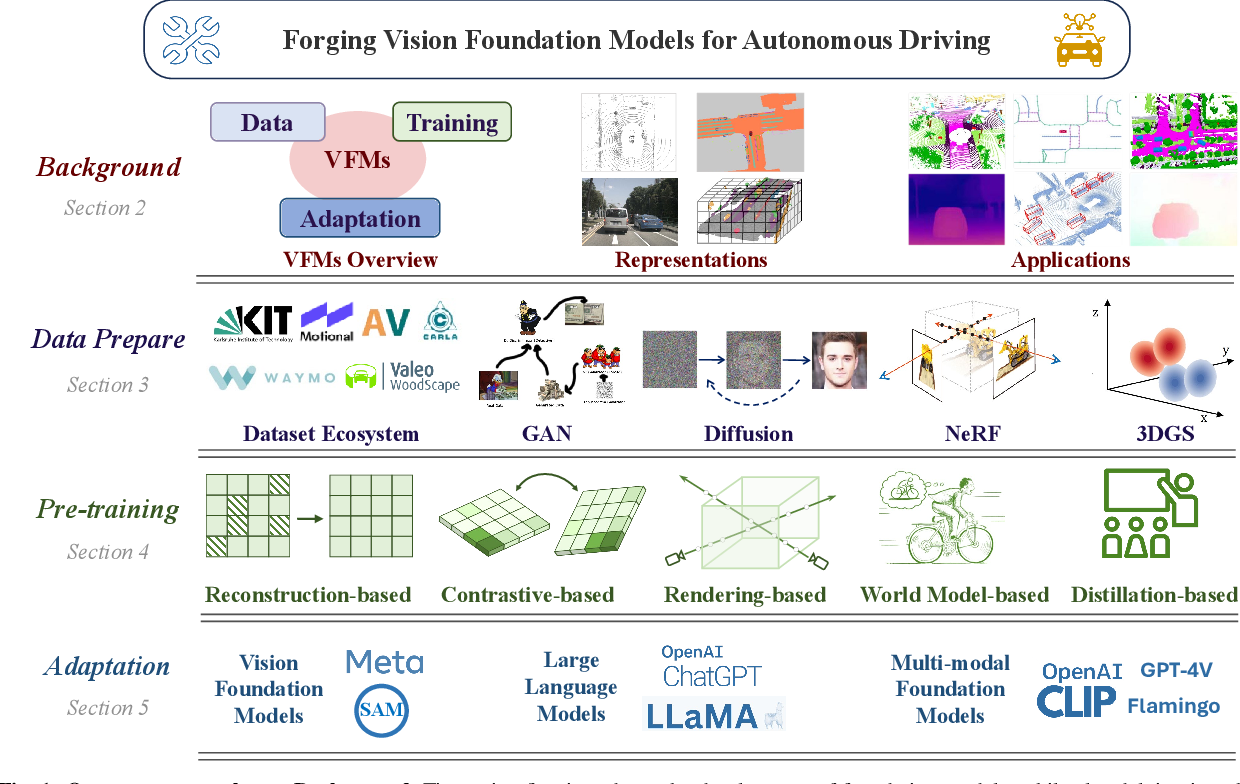
Figure 1 from Forging Vision Foundation Models for Autonomous Driving ...

(PDF) Masked Autoencoders Are Effective Tokenizers for Diffusion Models

论文阅读:InternVL: Scaling up Vision Foundation Models and Aligning for ...
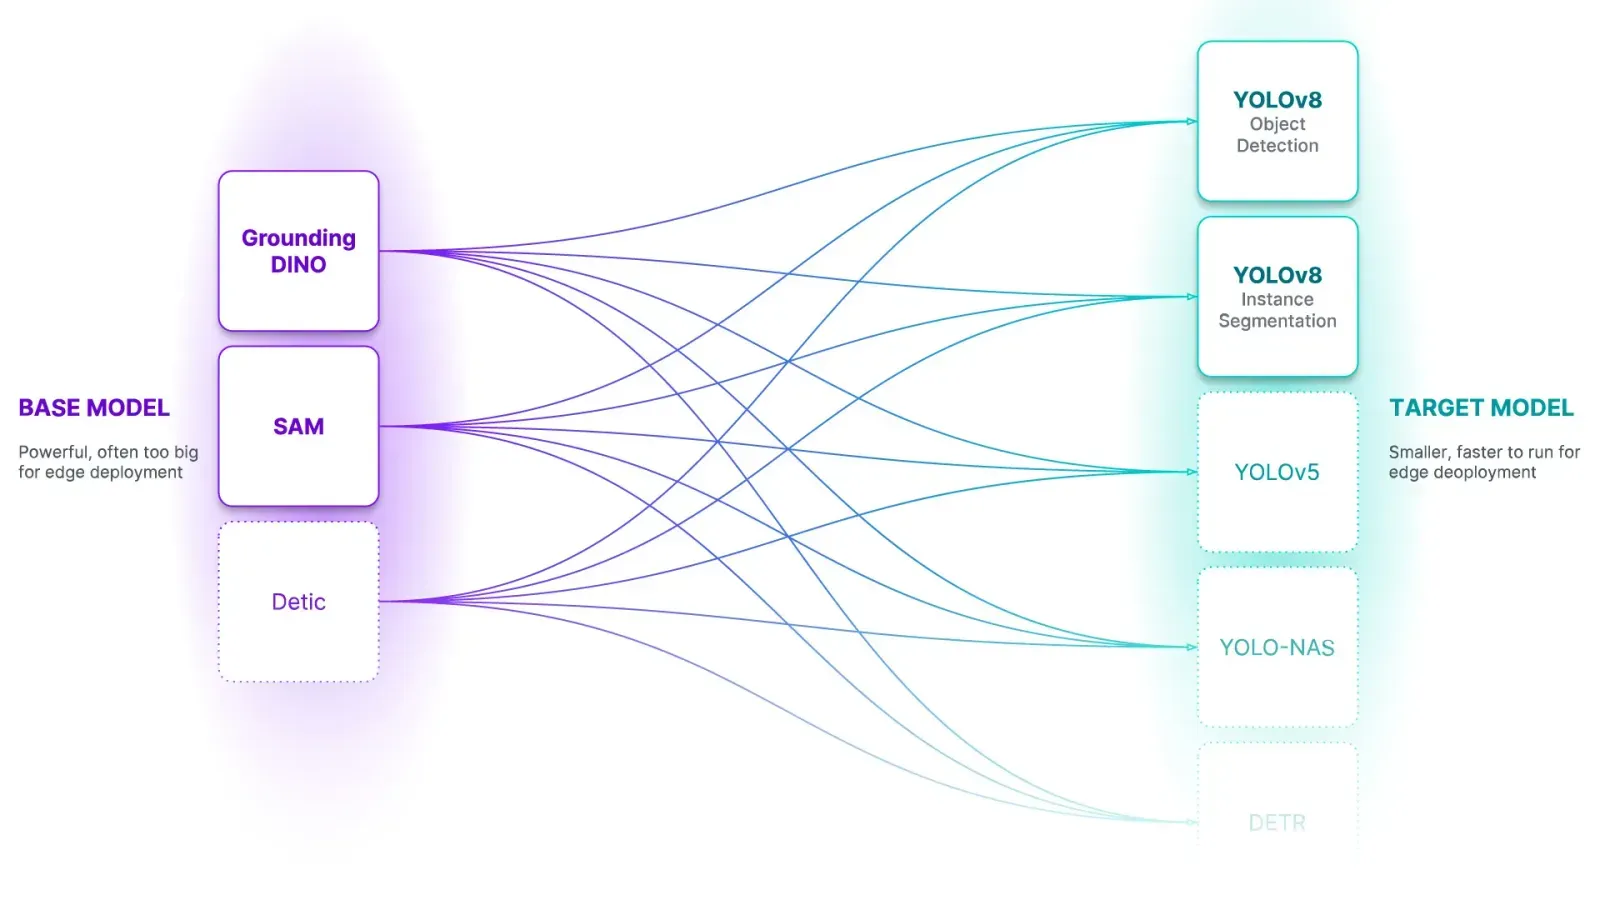
Use Cases for Computer Vision Foundation Models

InternVL: Scaling up Vision Foundation Models and Aligning for Generic ...
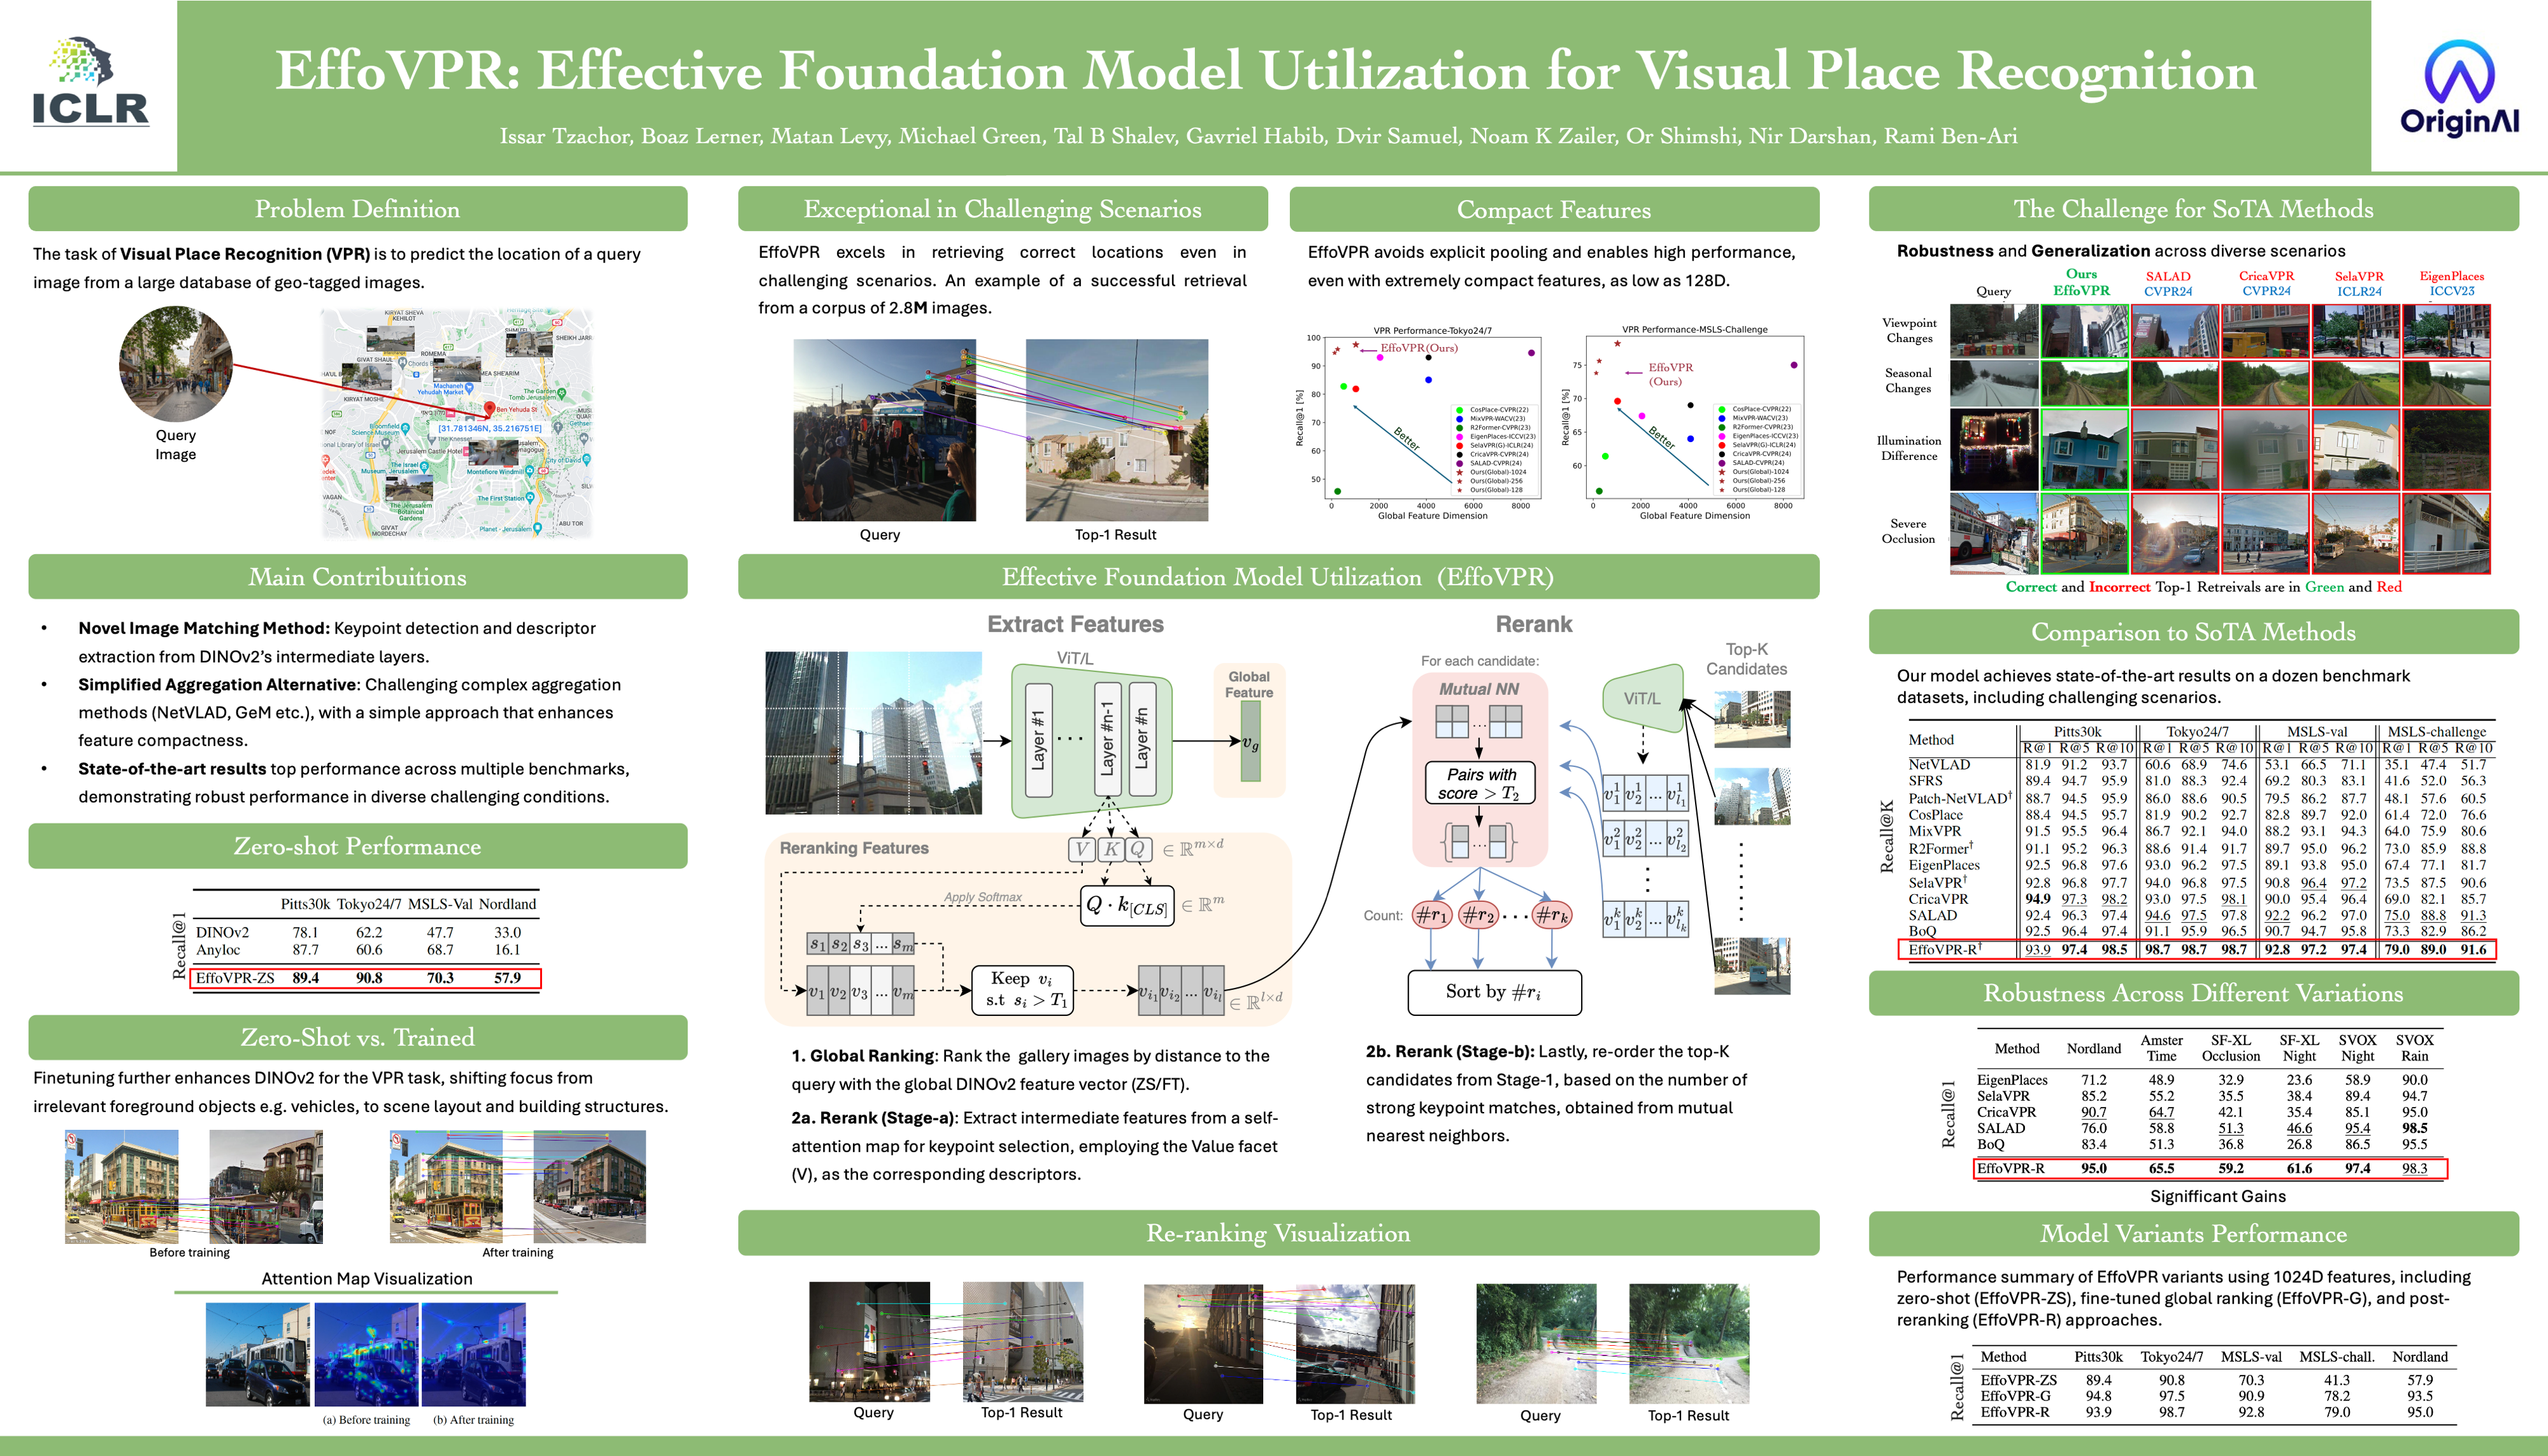
ICLR Poster EffoVPR: Effective Foundation Model Utilization for Visual ...
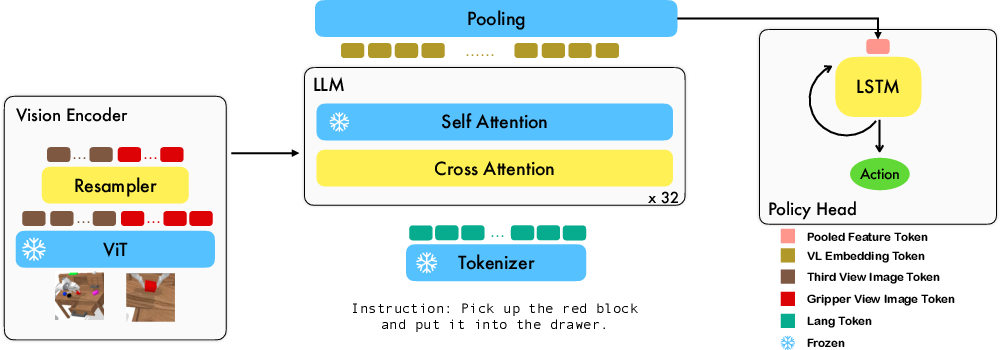
Figure 2 from Vision-Language Foundation Models as Effective Robot ...

[논문 리뷰] AVA-Bench: Atomic Visual Ability Benchmark for Vision ...

Towards Scalable Pre-training of Visual Tokenizers for Generation | AI ...

Visual Foundation Models (VFMs) Explained | Encord
Advertisement Space (336x280)

Distilling Diverse Vision Foundation Models to Improve Robot Learning ...
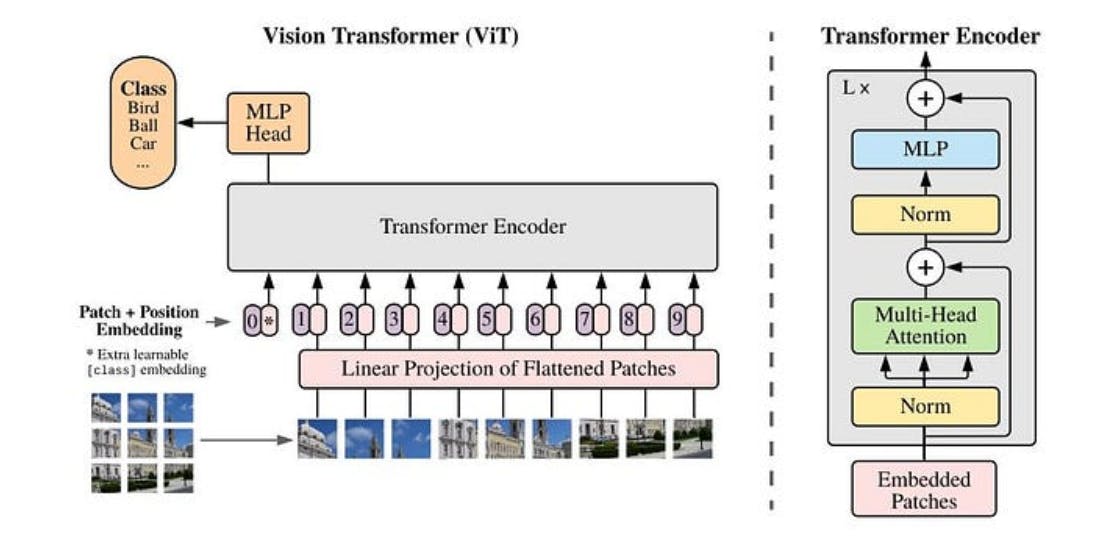
Visual Foundation Models (VFMs) Explained | Encord

Learnings from Scaling Visual Tokenizers for Reconstruction and Generation

(PDF) Vision Foundation Models in Remote Sensing: A Survey

(PDF) Learnings from Scaling Visual Tokenizers for Reconstruction and ...

(PDF) Do computer vision foundation models learn the low-level ...