
Compass A Multi Dimensional Benchmark For Evaluating Code Generation

COMPASS: A Multi-Dimensional Benchmark for Evaluating Code Generation ...
COMPASS: A Multi-Dimensional Benchmark for Evaluating Code Generation ...
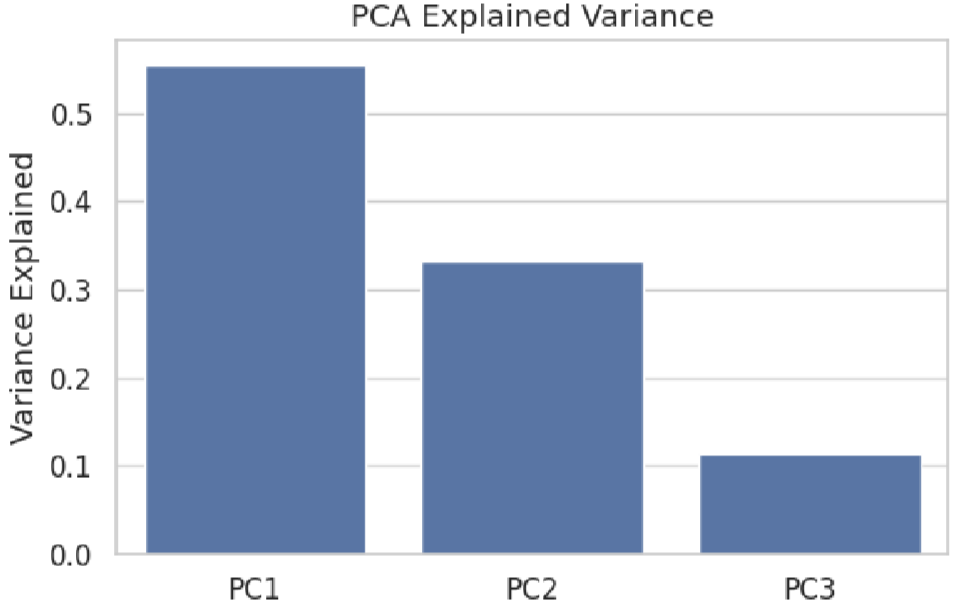
[논문 리뷰] COMPASS: A Multi-Dimensional Benchmark for Evaluating Code ...

IndustryCode: A Benchmark for Industry Code Generation

Paper page - Plot2Code: A Comprehensive Benchmark for Evaluating Multi ...

DevBench: A Realistic, Developer-Informed Benchmark for Code Generation ...

A new promising benchmark for code generation models : r/llm_updated
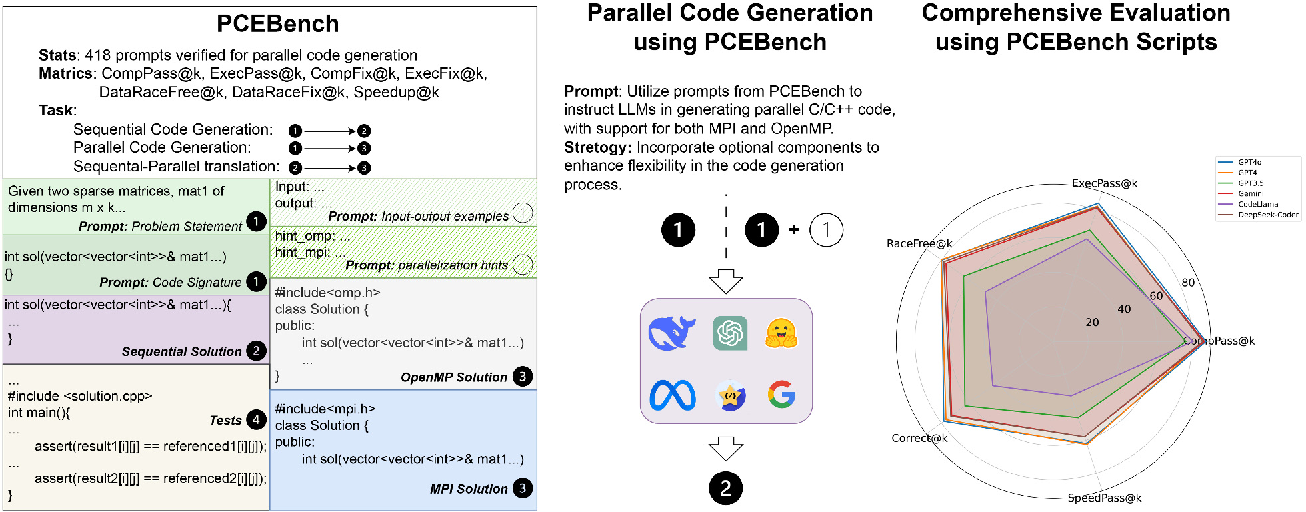
Figure 1 from PCEBench: A Multi-Dimensional Benchmark for Evaluating ...
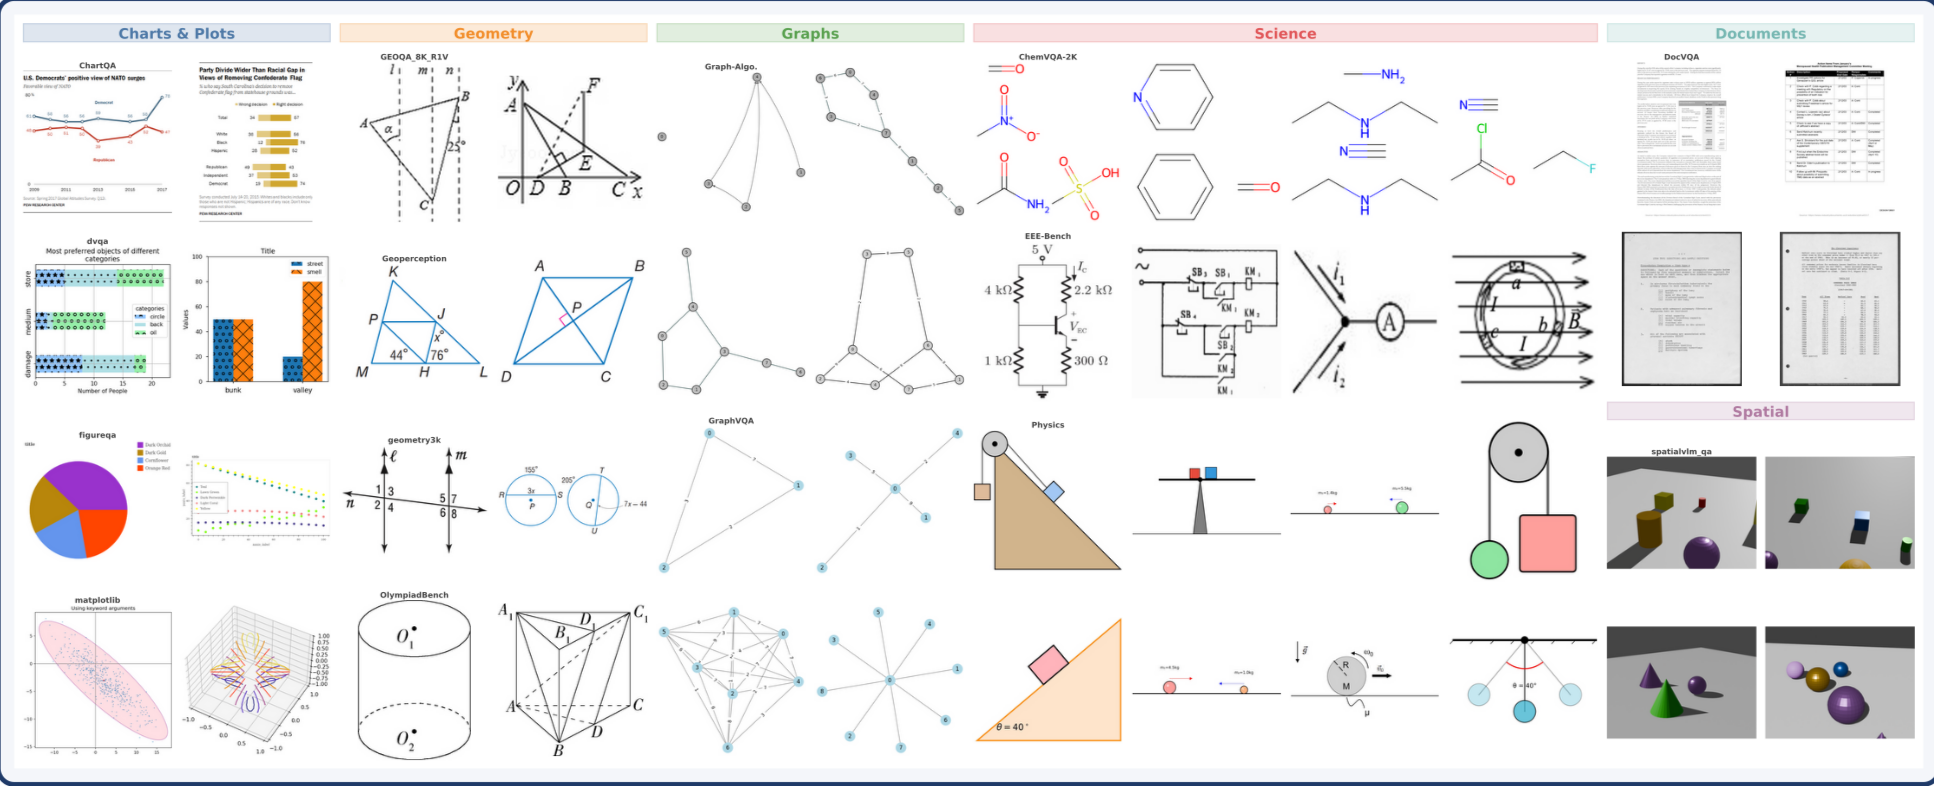
[论文评述] Vision2Code: A Multi-Domain Benchmark for Evaluating Image-to ...

Vision2Code: A Multi-Domain Benchmark for Evaluating Image-to-Code ...
Advertisement Space (300x250)

CodeEduBench: A Multidimensional Benchmark for Evaluating AI-Driven ...

CodeEduBench: A Multidimensional Benchmark for Evaluating AI-Driven ...

Vision2Code: A Multi-Domain Benchmark for Evaluating Image-to-Code ...

CodeCriticBench: A Holistic Code Critique Benchmark for Large Language ...
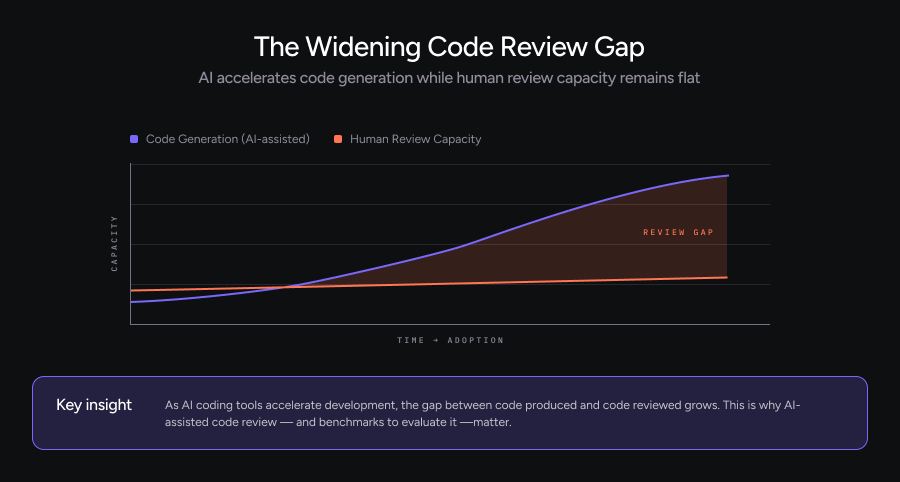
What makes a good code review benchmark for AI tools?
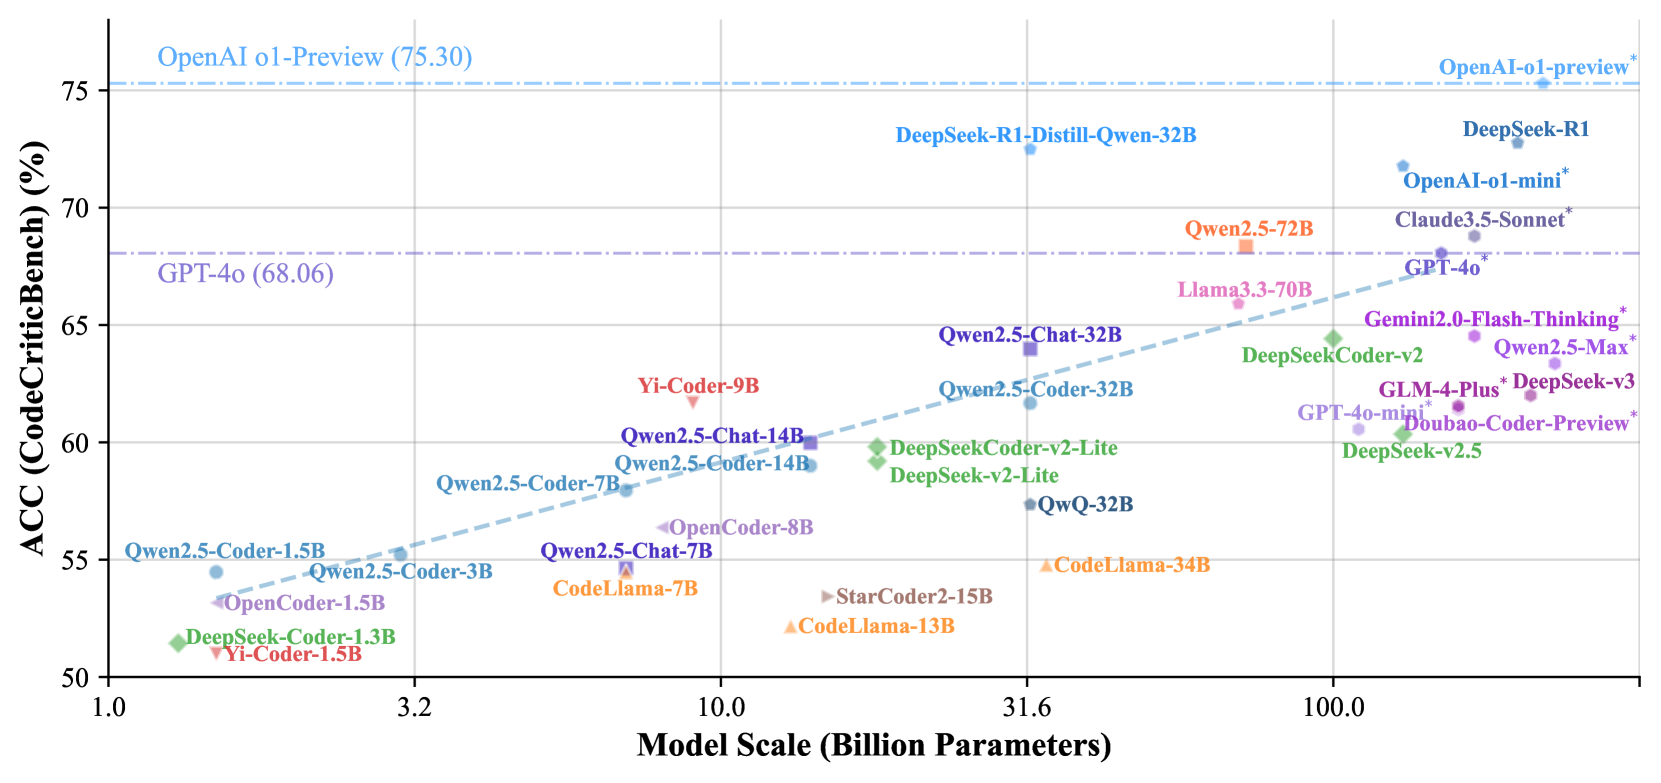
CodeCriticBench: A Holistic Code Critique Benchmark for Large Language ...
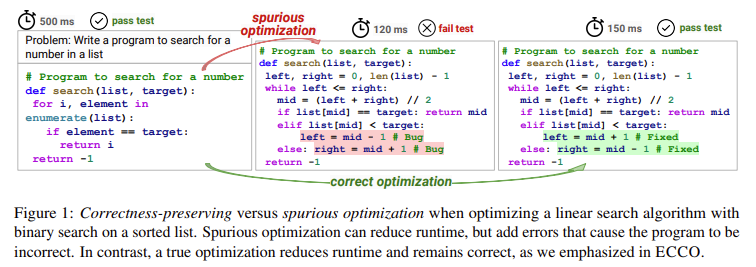
ECCO: A Reproducible AI Benchmark for Evaluating Program Efficiency via ...

A framework for assessing the capabilities of code generation of ...

CodeMMLU: A Comprehensive Multi-Choice Benchmark for Assessing Code ...

[논문 리뷰] BIGbench: A Unified Benchmark for Evaluating Multi-dimensional ...
Advertisement Space (336x280)
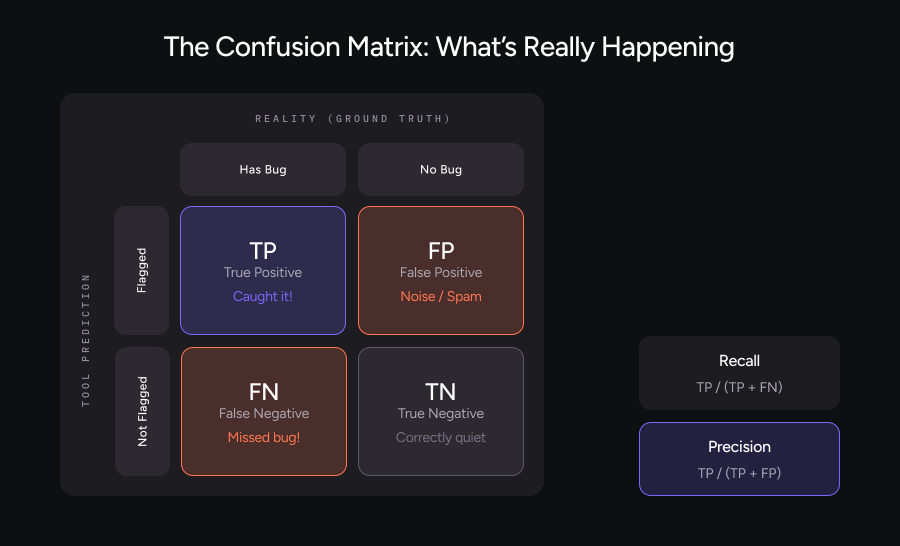
What makes a good code review benchmark for AI tools?
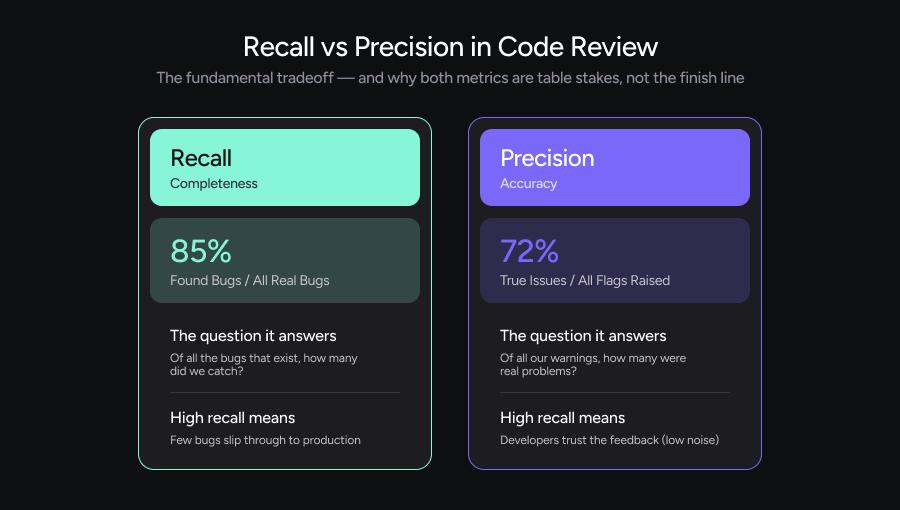
What makes a good code review benchmark for AI tools?
Design2Code Benchmark: Evaluating Multimodal Code Generation for Front ...

Vision-Guided Iterative Refinement for Frontend Code Generation

Existing Benchmarks for Code Generation | Download Scientific Diagram
COMPASS: A Better Way to Evaluate AI Code Generation | Codility Lab

Design2Code: Benchmarking Multimodal Code Generation for Automated ...
HumanEval Benchmark: Evaluating LLM Code Generation Capability
HumanEval Benchmark: Evaluating LLM Code Generation Capability
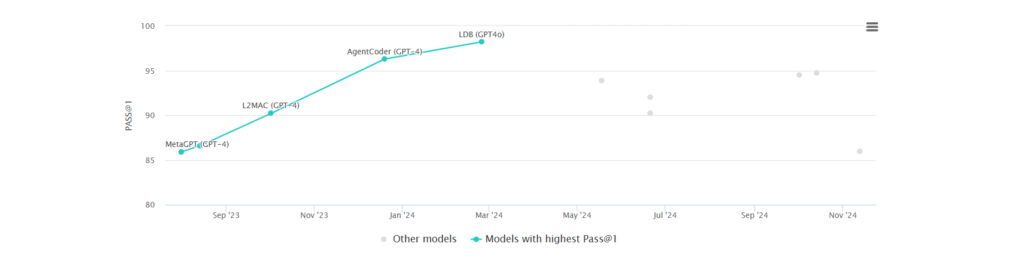
HumanEval Benchmark: Evaluating LLM Code Generation Capability
Advertisement Space (336x280)
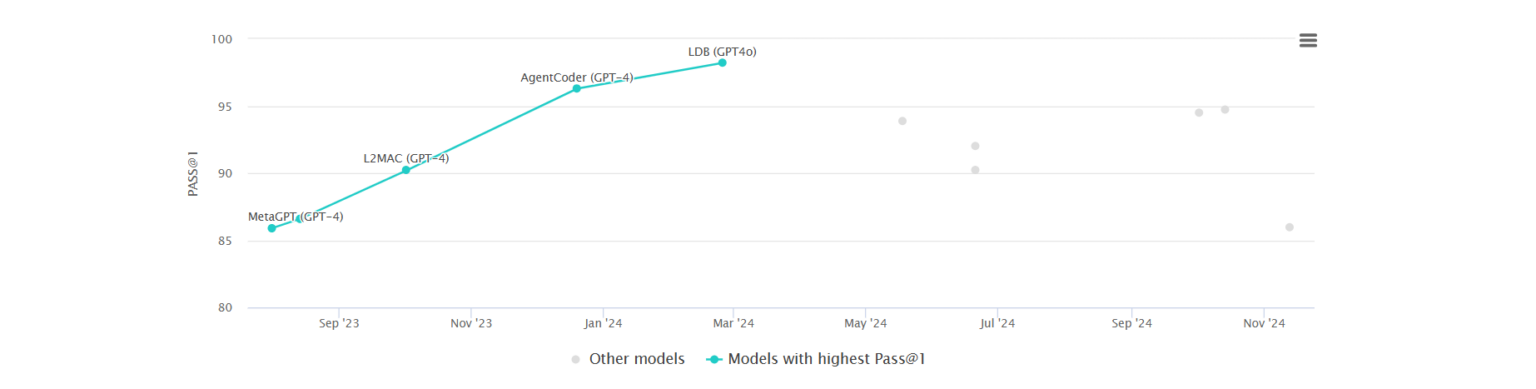
HumanEval Benchmark: Evaluating LLM Code Generation Capability

Edit-Compass & EditReward-Compass: A Unified Benchmark for Image ...

Edit-Compass & EditReward-Compass: A Unified Benchmark for Image ...

Edit-Compass & EditReward-Compass: A Unified Benchmark for Image ...
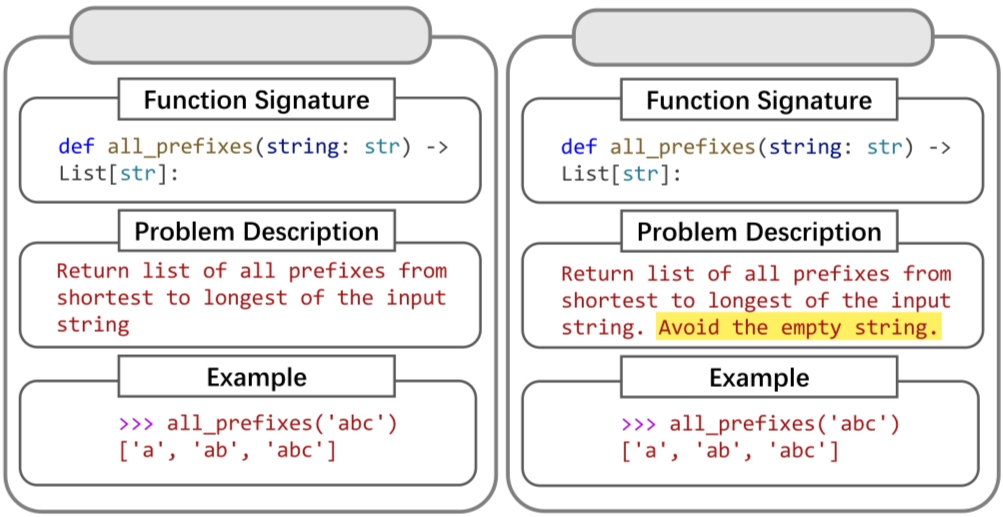
[논문 리뷰] Benchmarking and Revisiting Code Generation Assessment: A ...

WebCompass: Towards Multimodal Web Coding Evaluation for Code Language ...