
Discrete Visual Tokenizers For Multimodal Llms Bridging Vision And
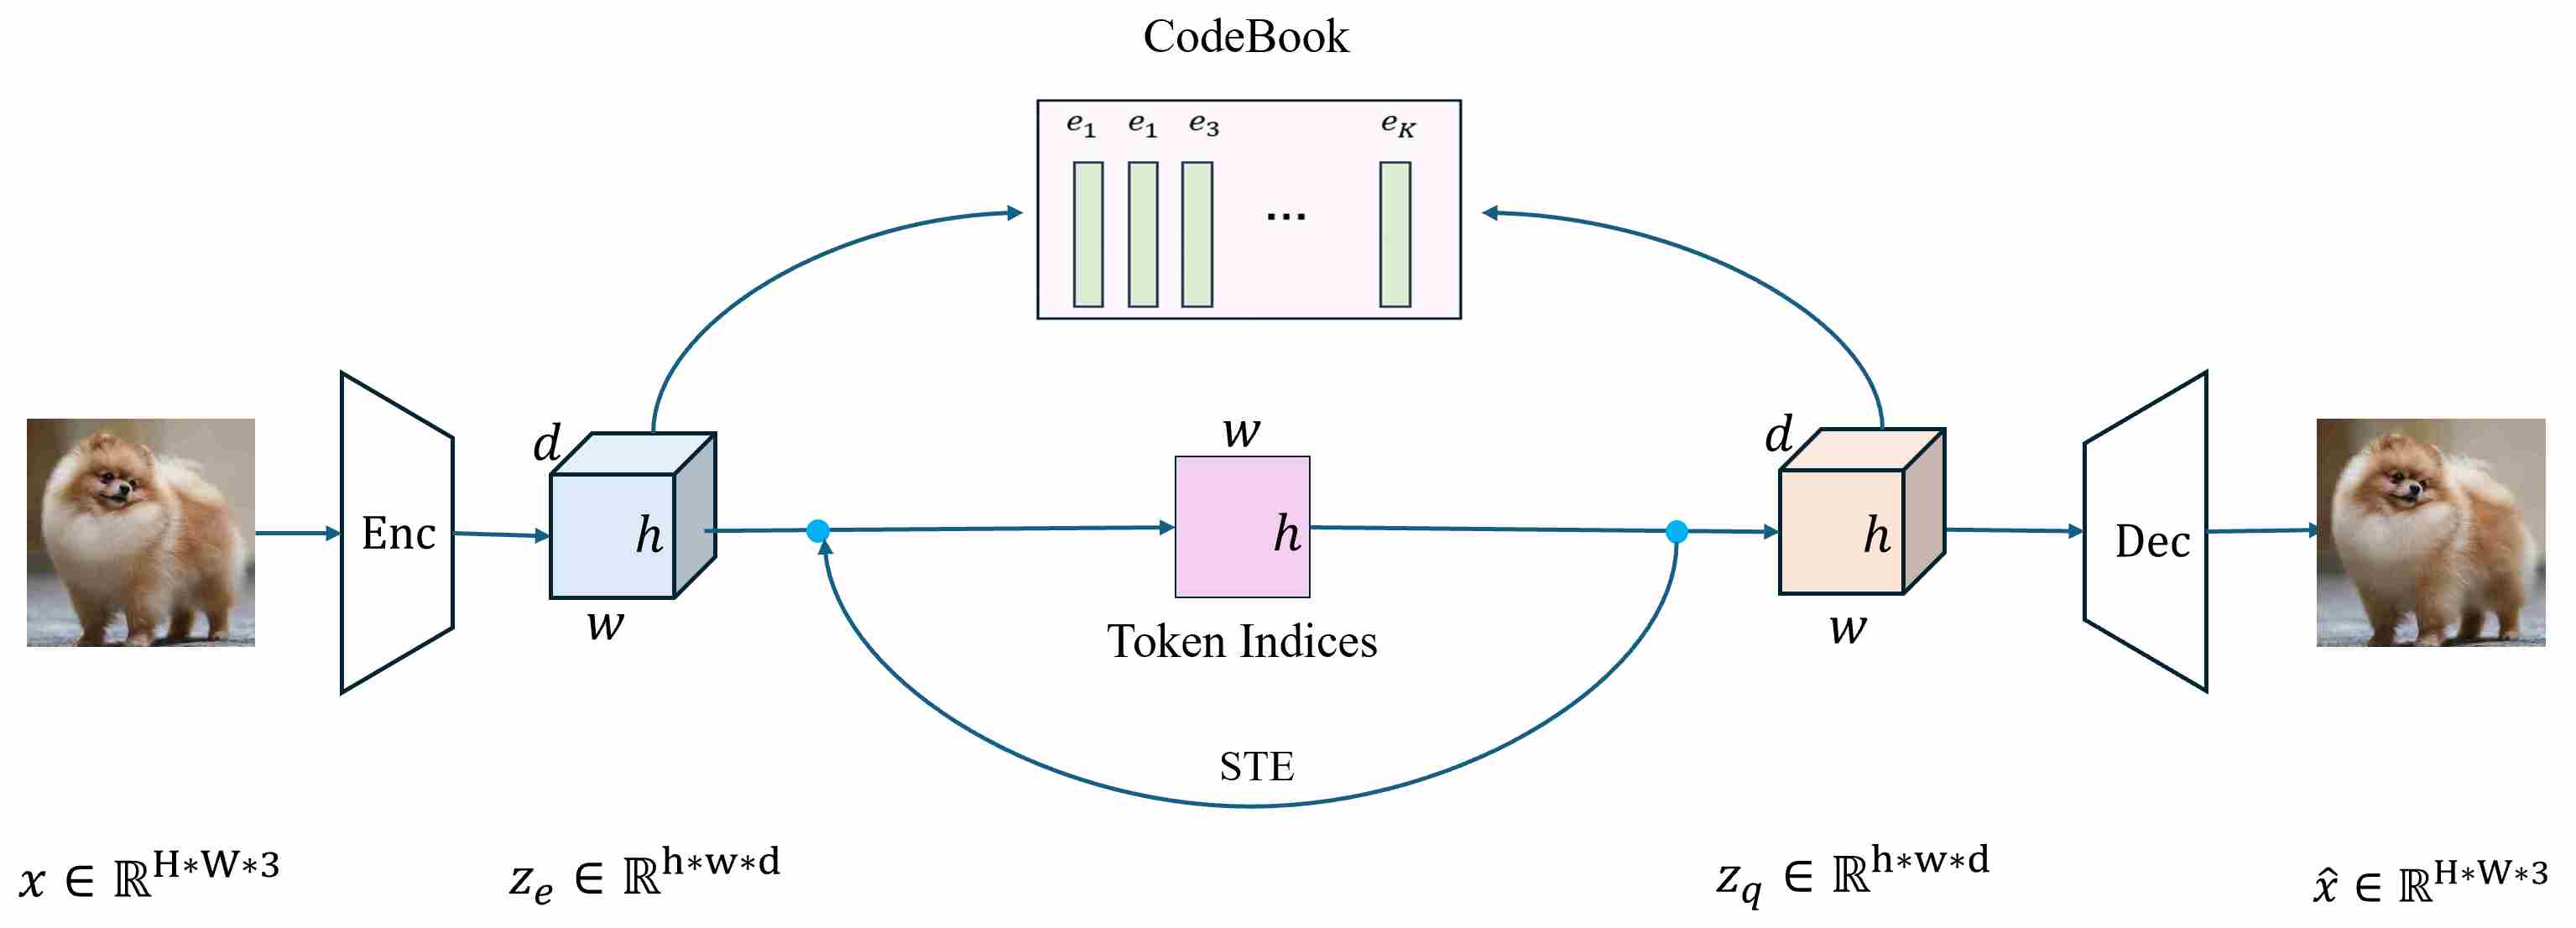
Discrete Visual Tokenizers for Multimodal LLMs: Bridging Vision and ...
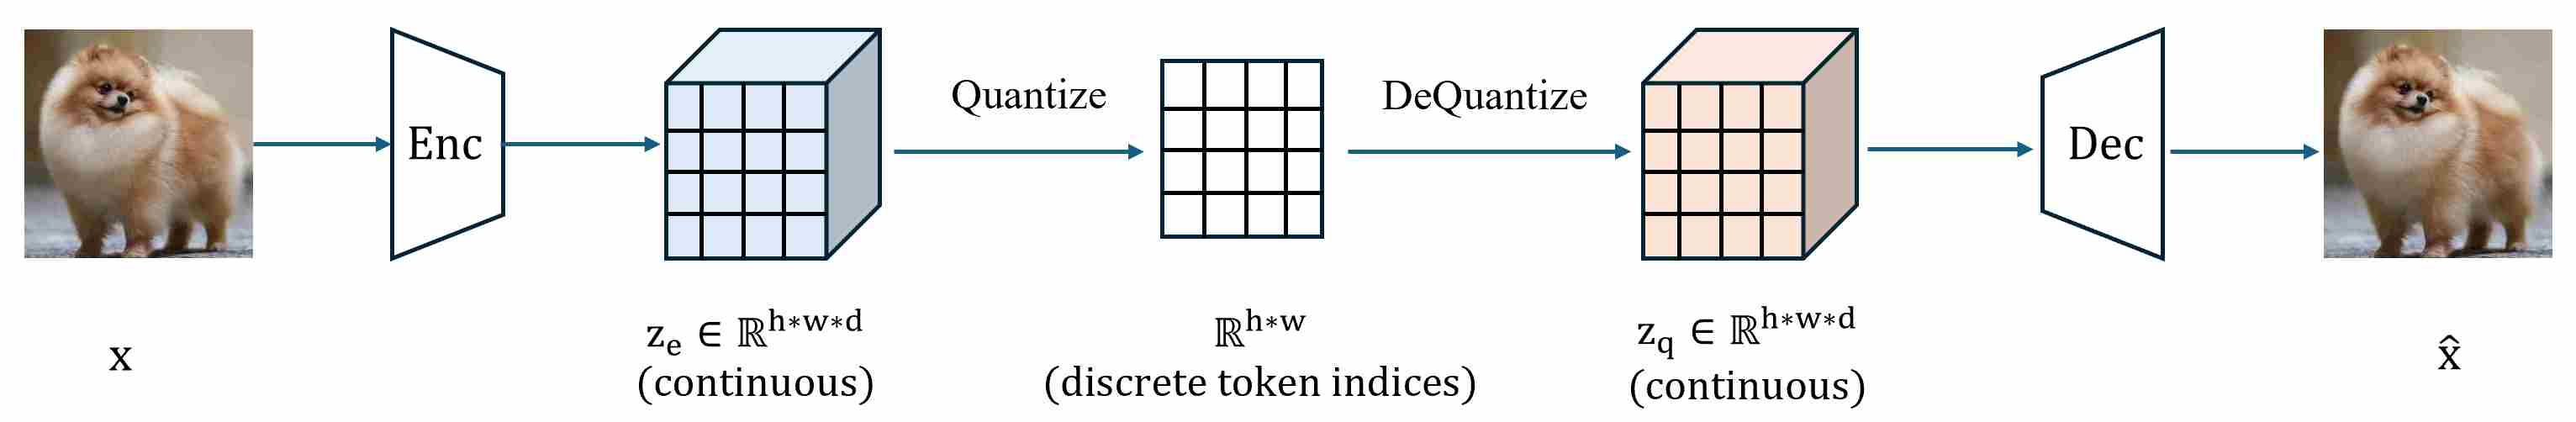
Discrete Visual Tokenizers for Multimodal LLMs: Bridging Vision and ...

Bridging Continuous and Discrete Tokens for Autoregressive Visual ...

8 Best LLMs for Vision and Multimodal Tasks in 2026

How Multimodal LLMs Actually Work: Part 1 — Foundations and Vision ...

Instruction Tuning-free Visual Token Complement for Multimodal LLMs
Multimodal LLMs Explained: Vision Language Models and Beyond

Instruction Tuning-free Visual Token Complement for Multimodal LLMs
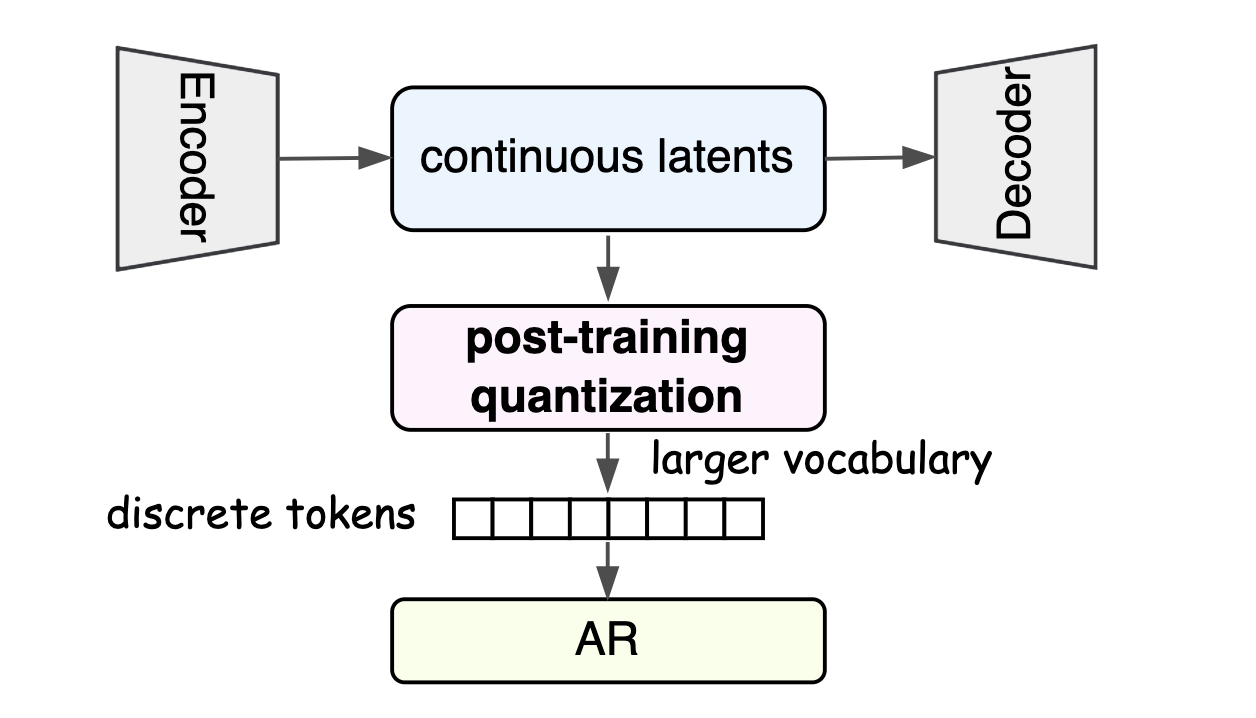
TokenBridge: Bridging Continuous and Discrete Tokens for Autoregressive ...
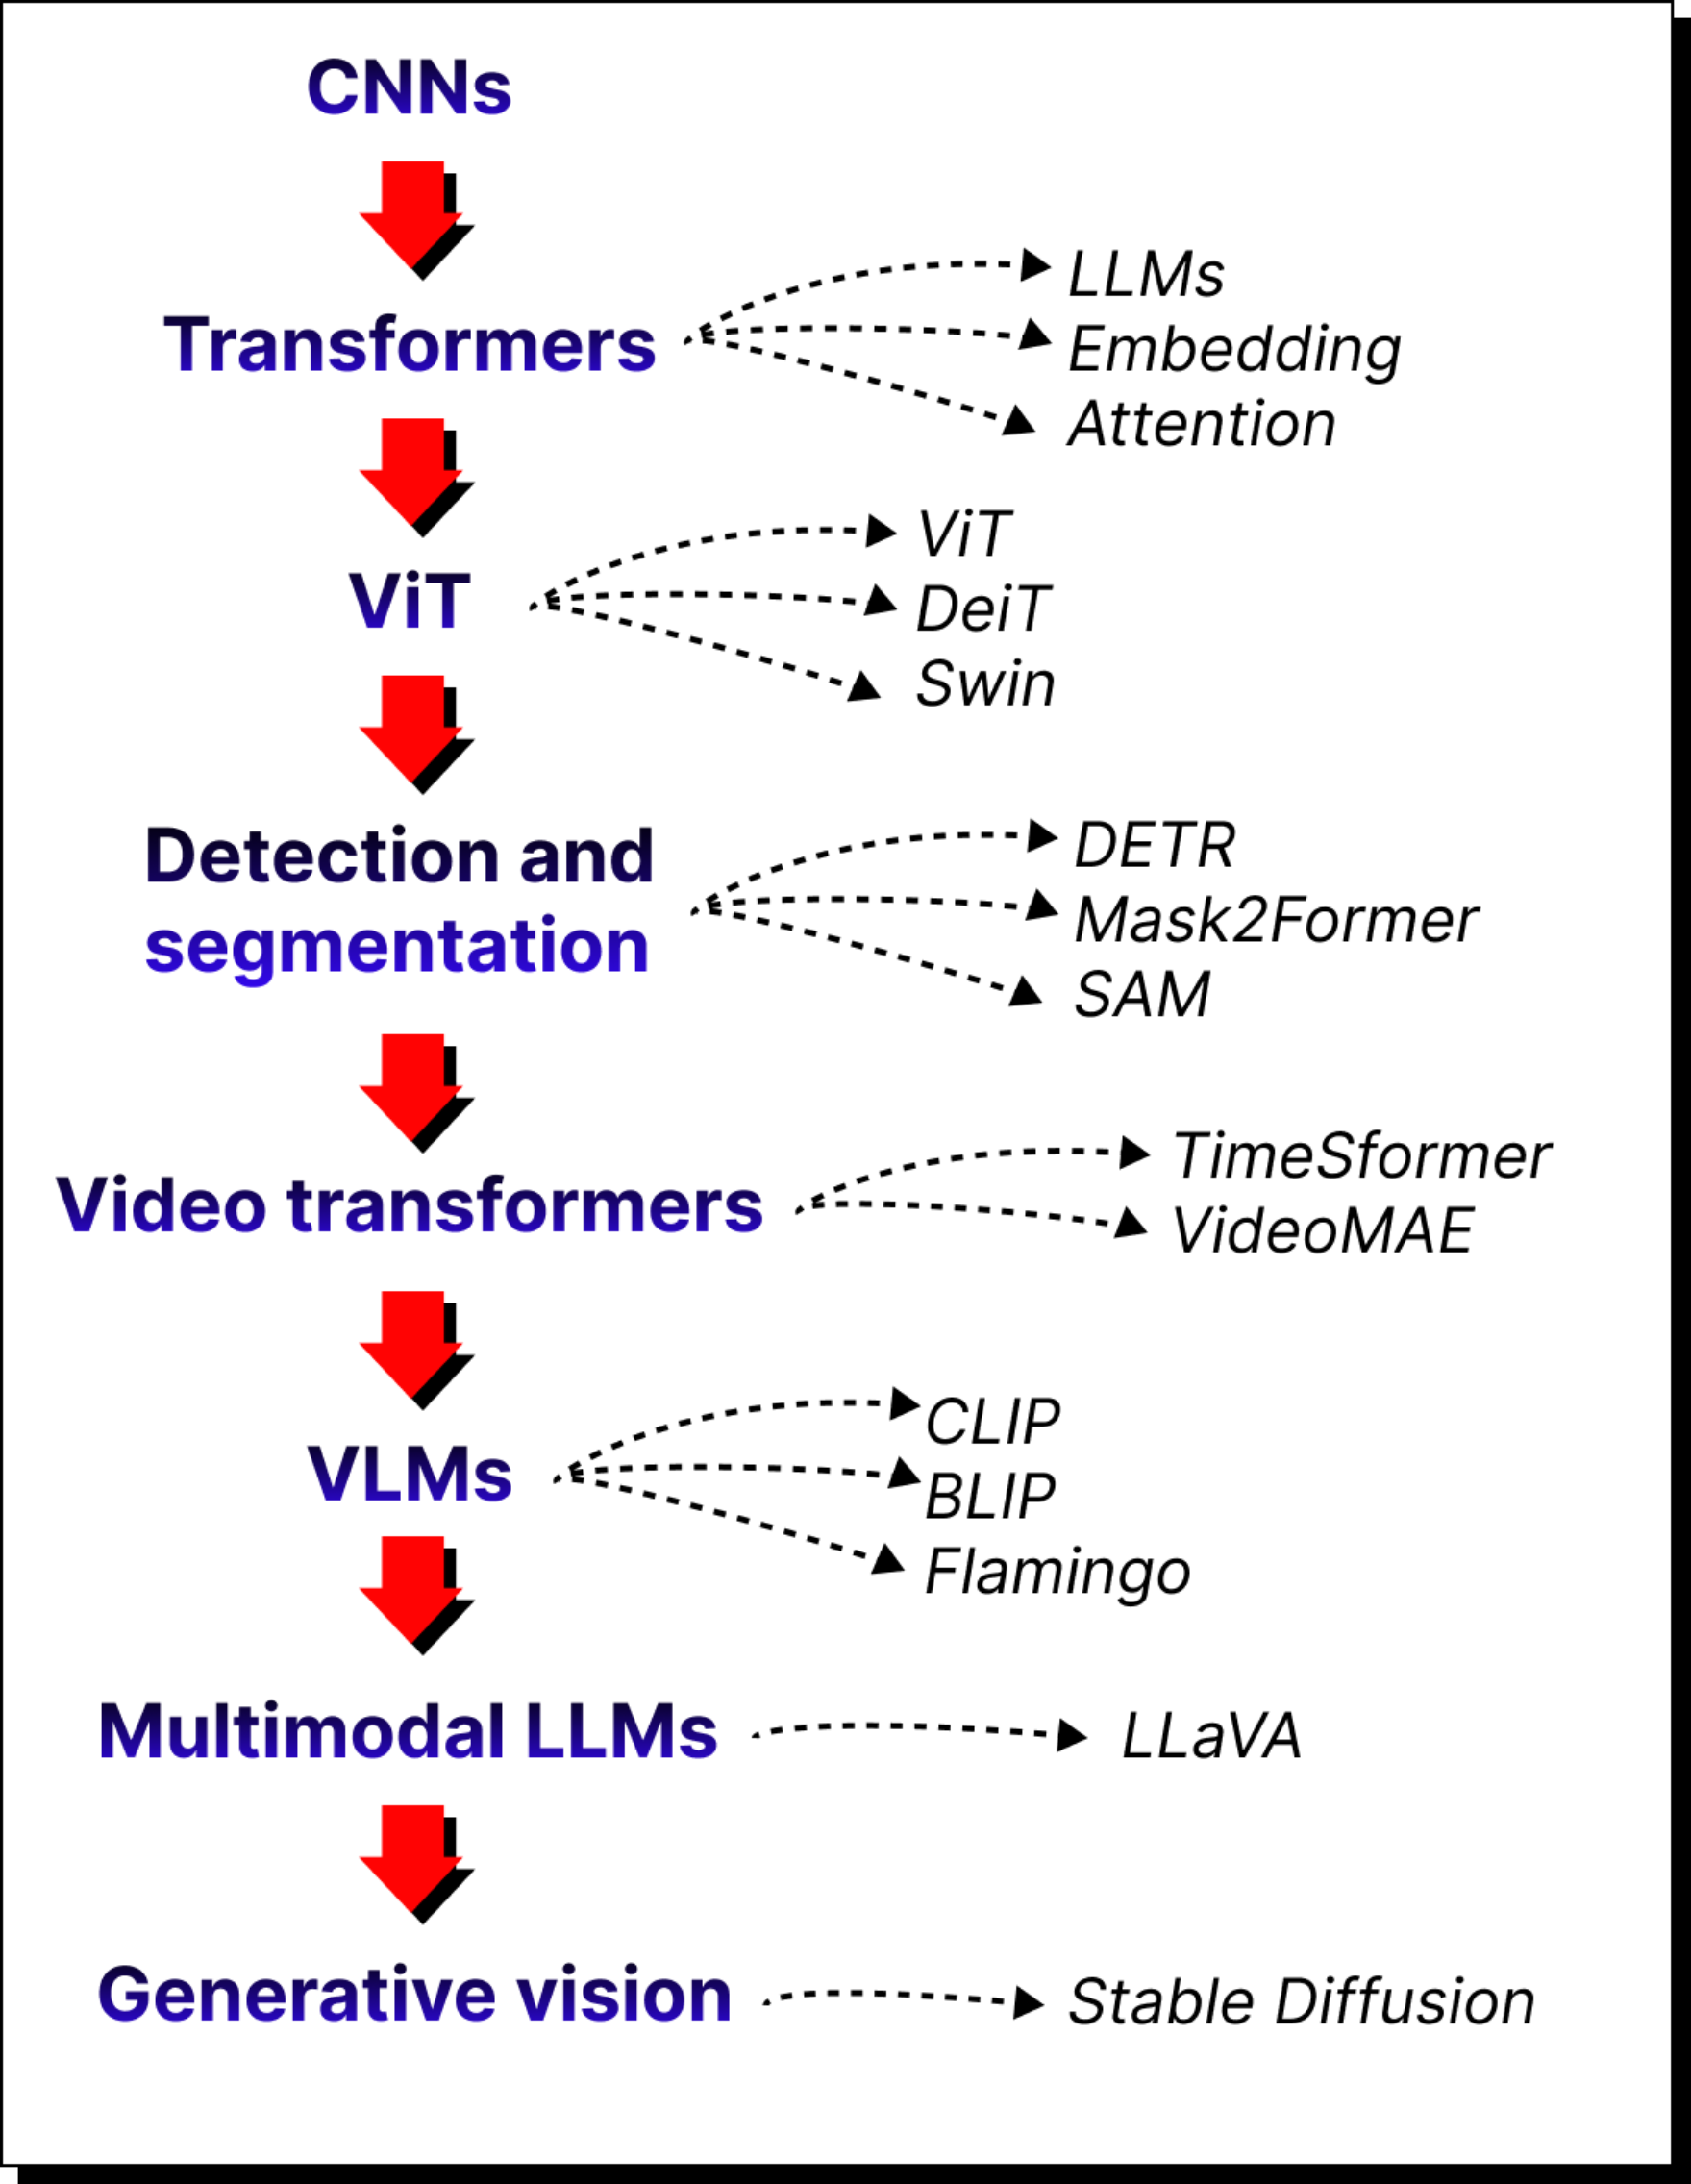
Transformers for Vision and Multimodal LLMs: Lecture 1
Advertisement Space (300x250)
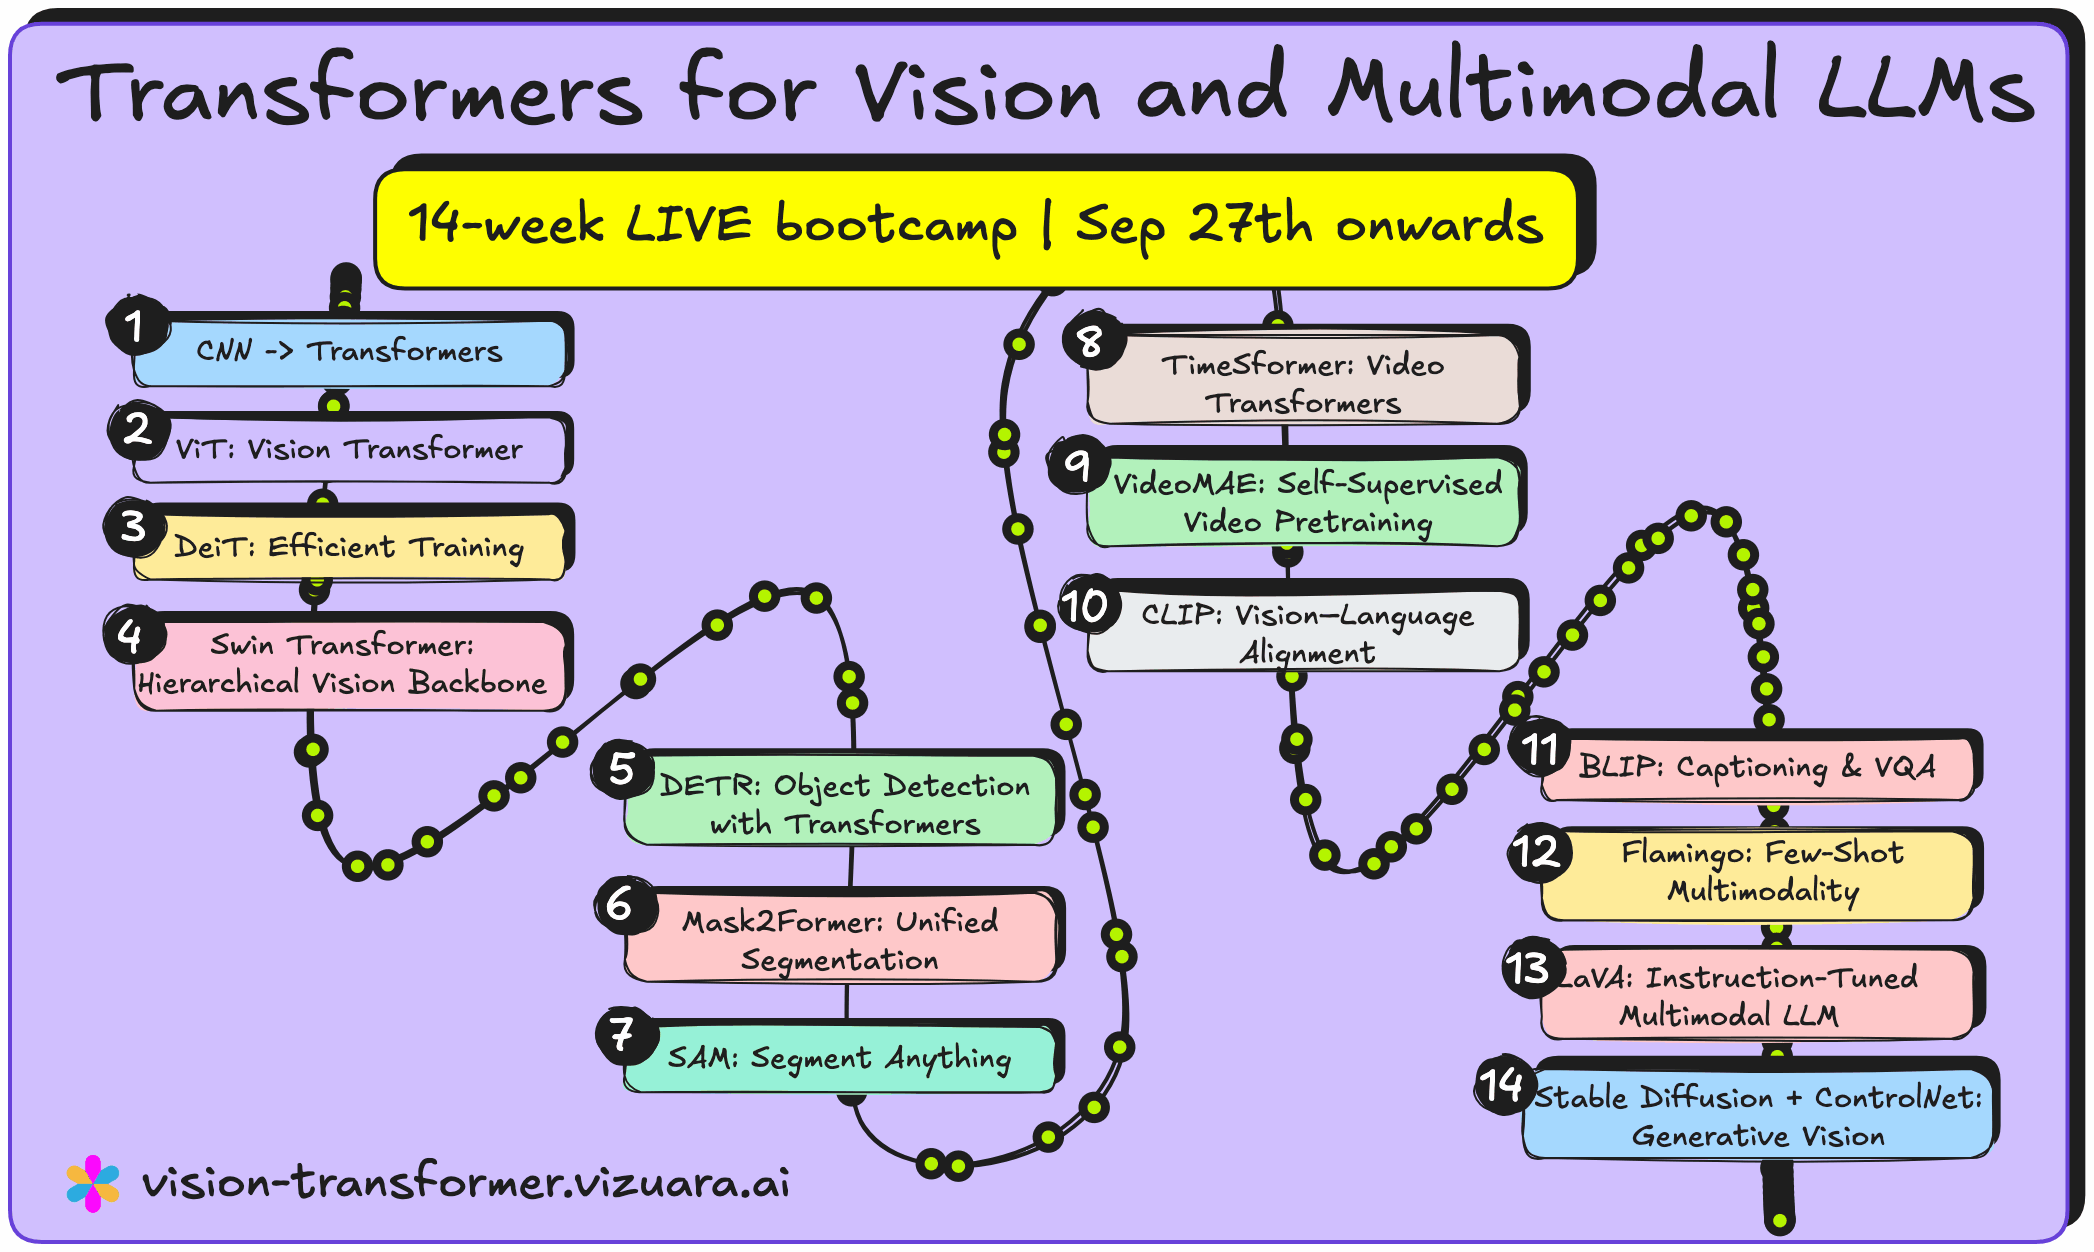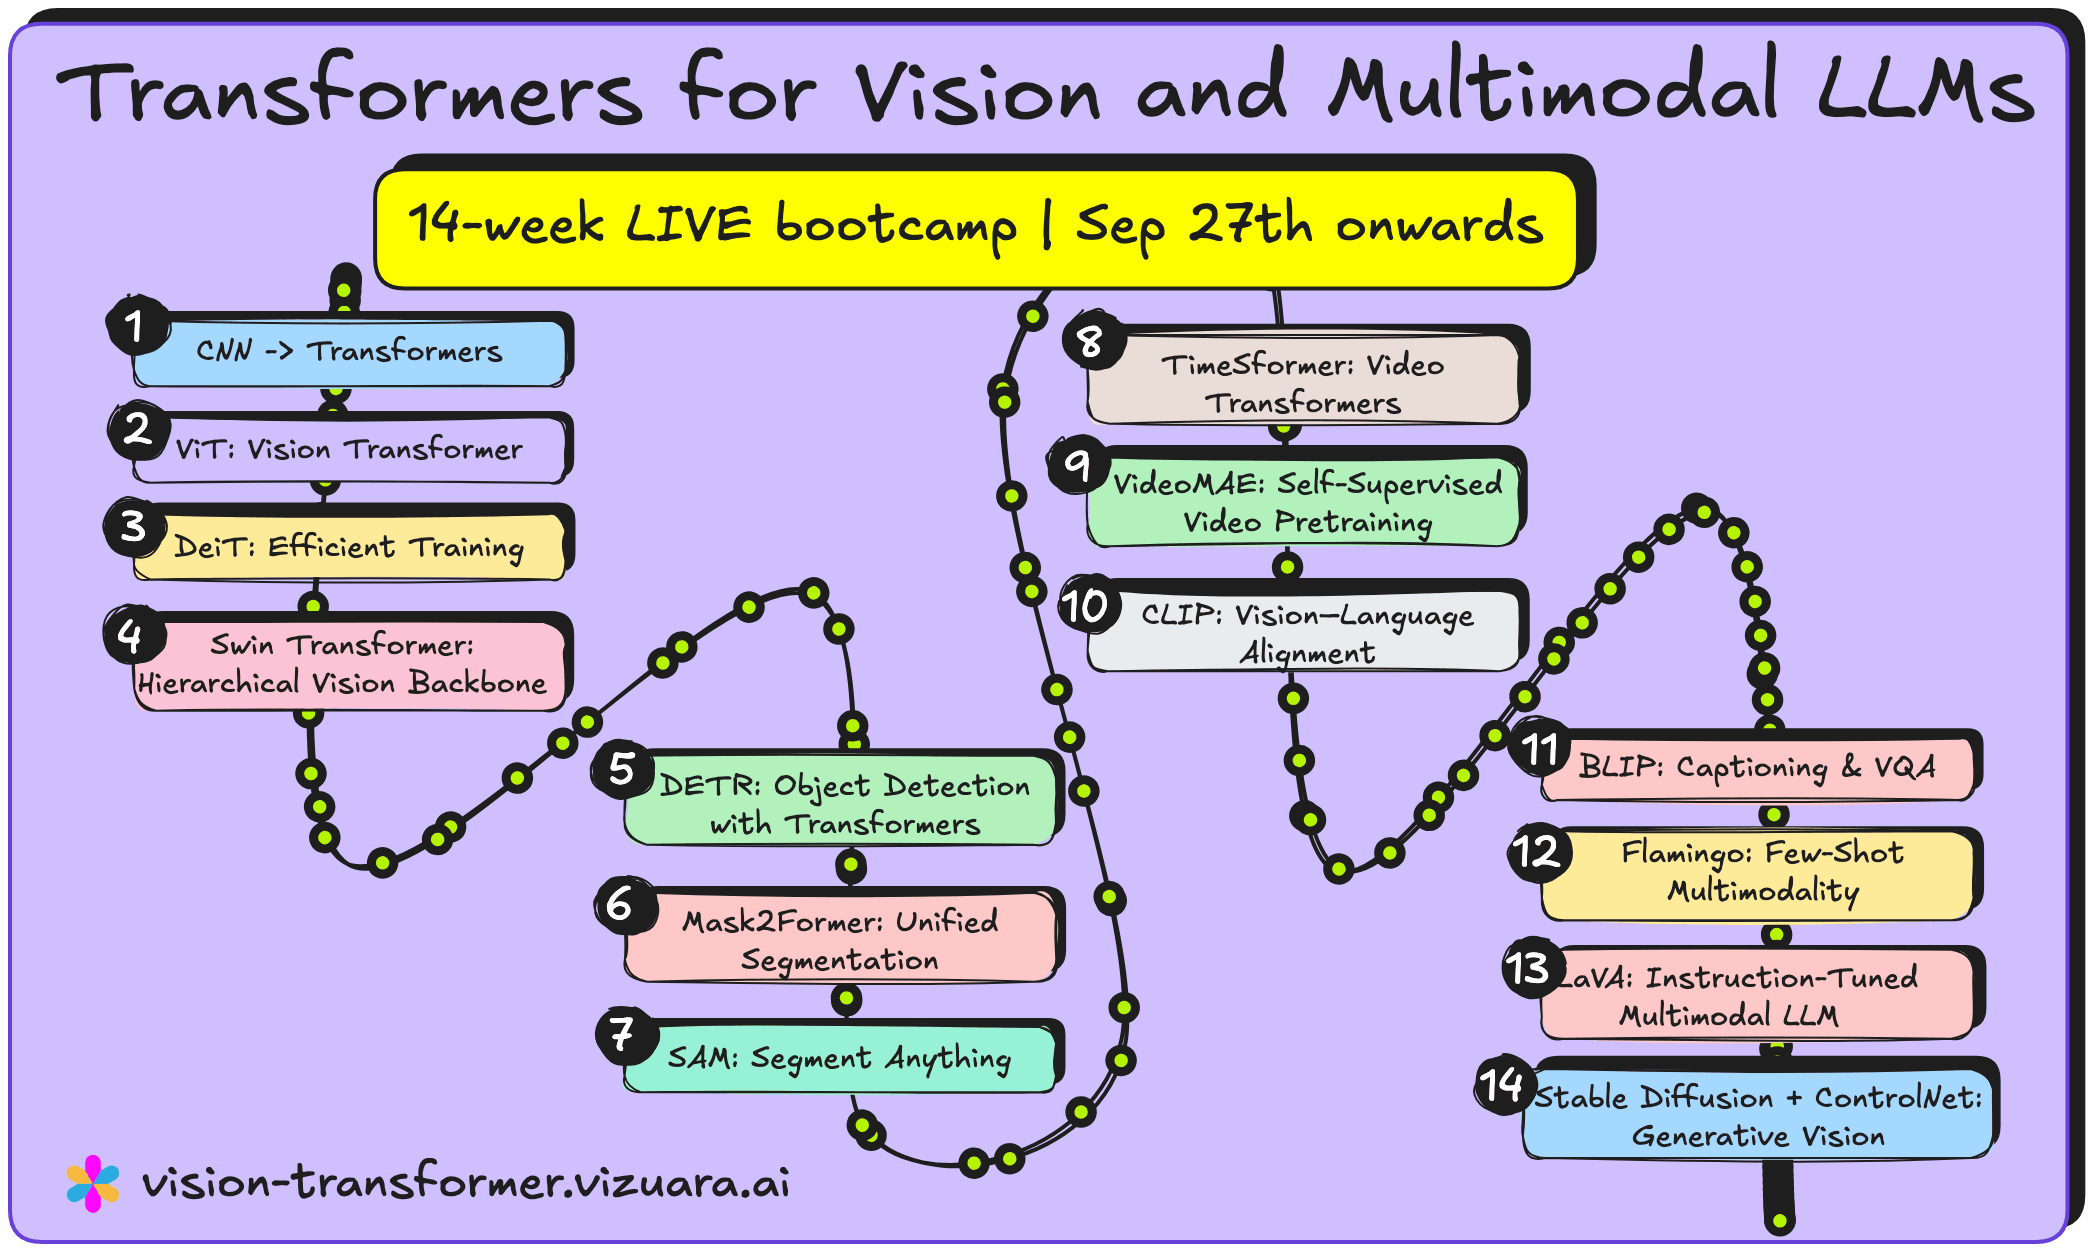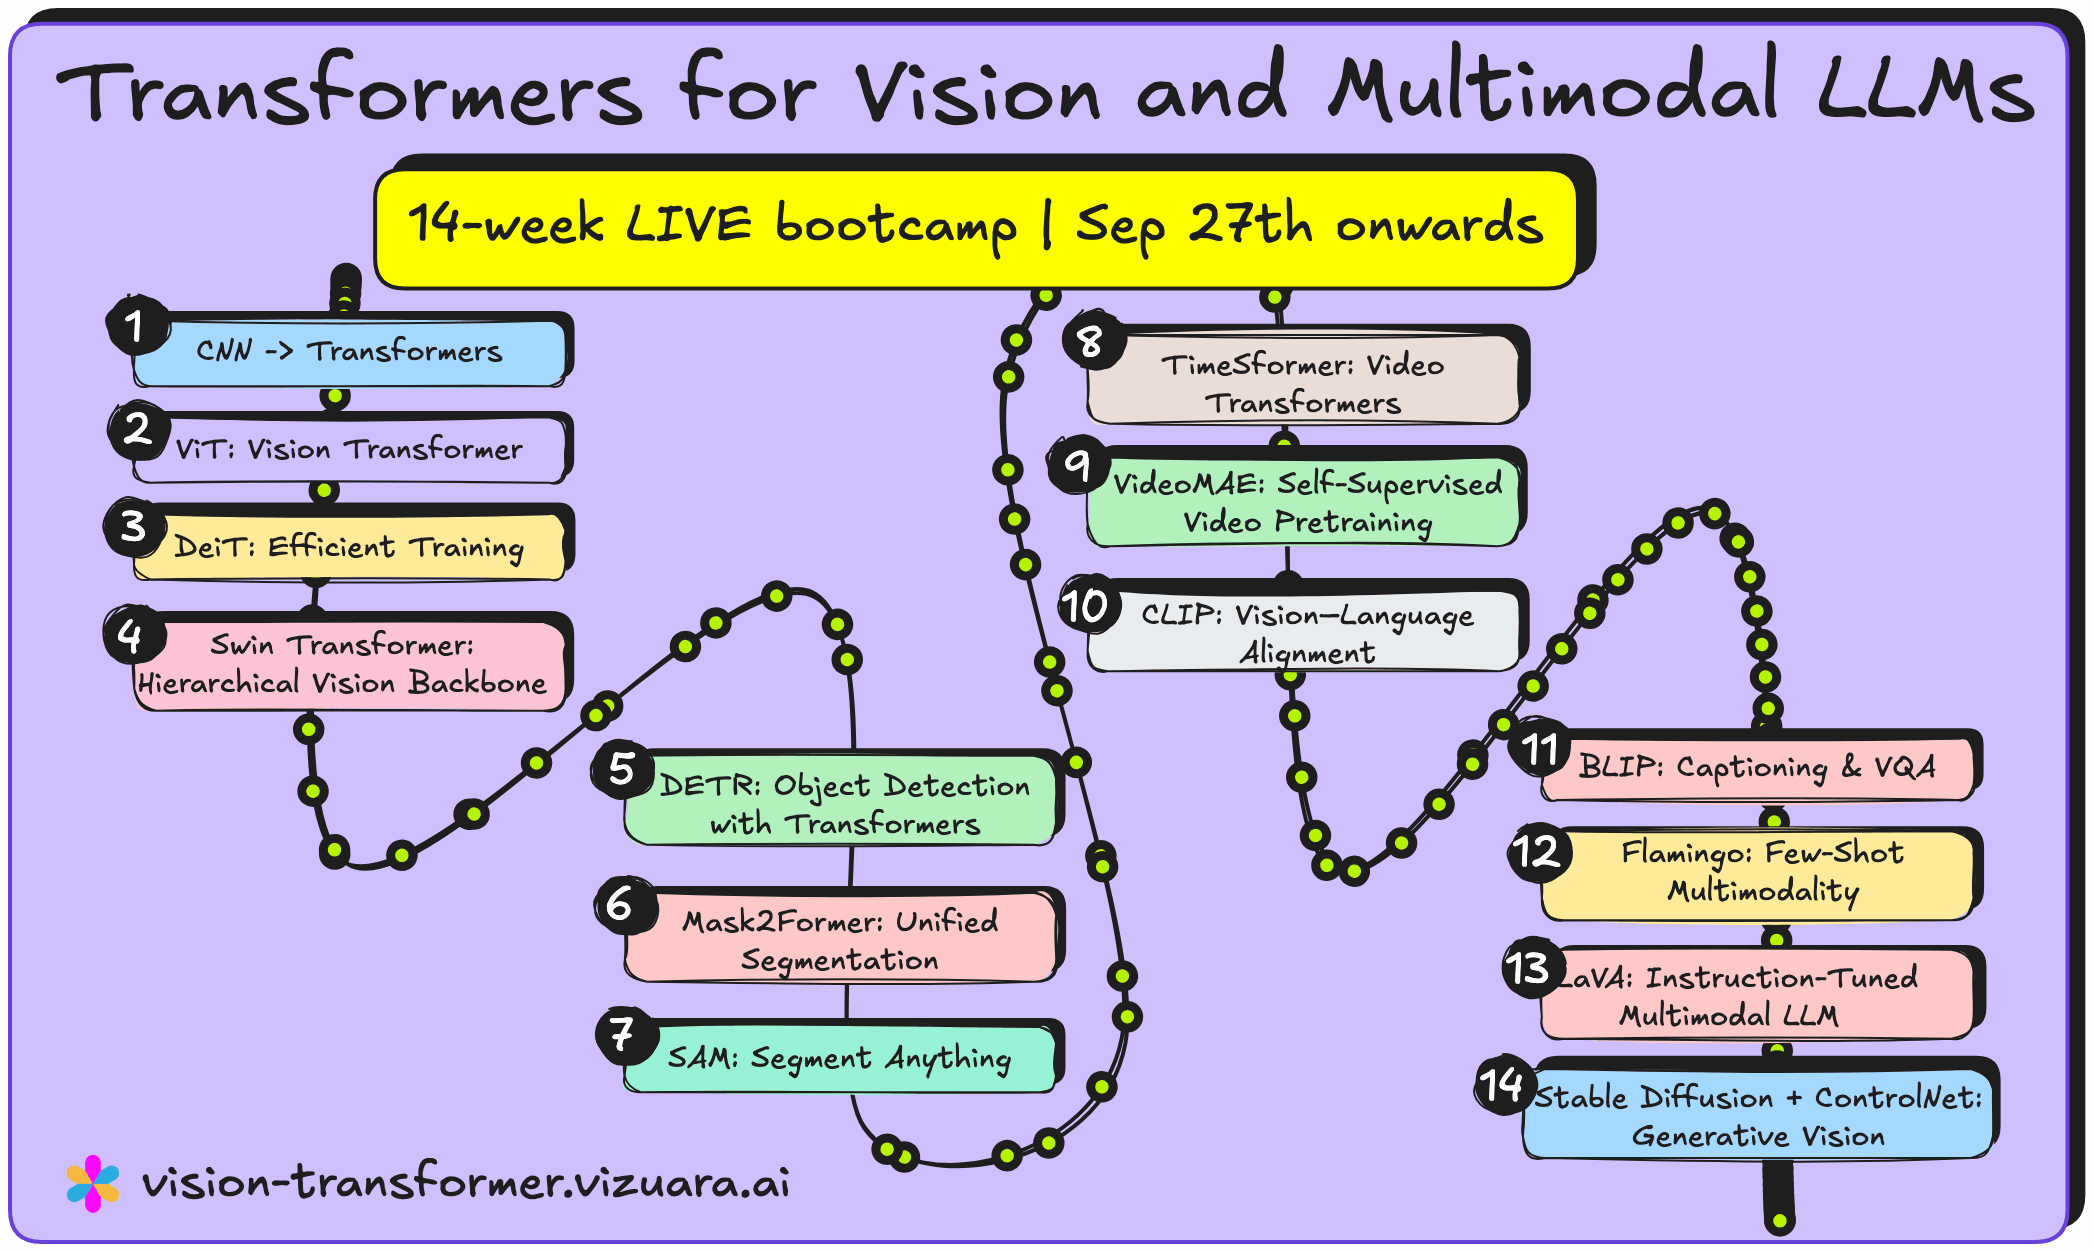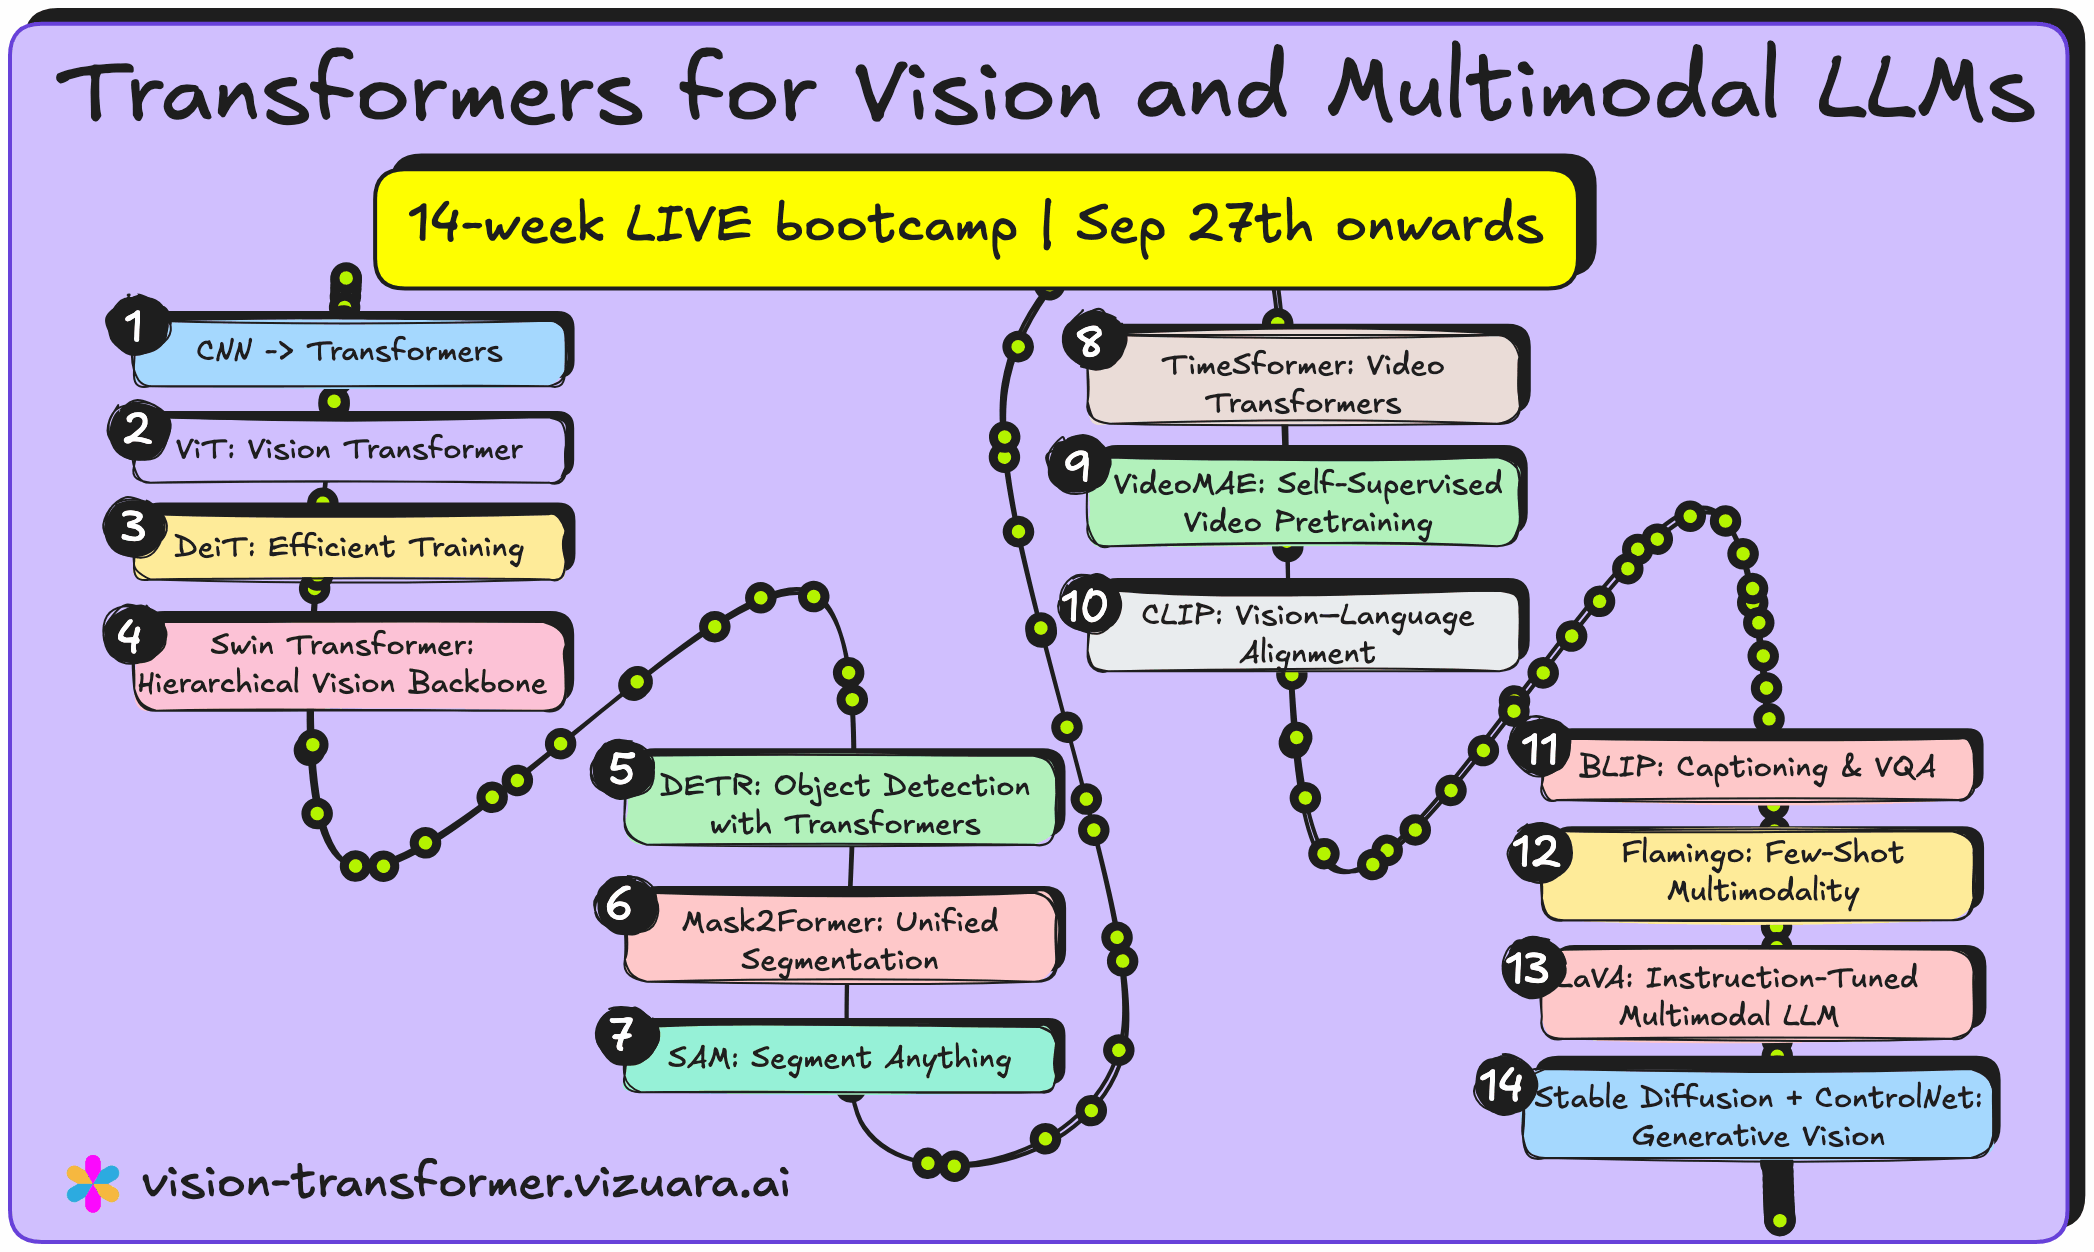
Vision Transformer and Multimodal LLMs

TokenBridge: Bridging The Gap Between Continuous and Discrete Token ...

GitHub - arvindmvepa/mpLLM: Multimodal LLM for visual question ...

Paper page - TokenPacker: Efficient Visual Projector for Multimodal LLM

Slot-MLLM: Object-Centric Visual Tokenization for Multimodal LLM
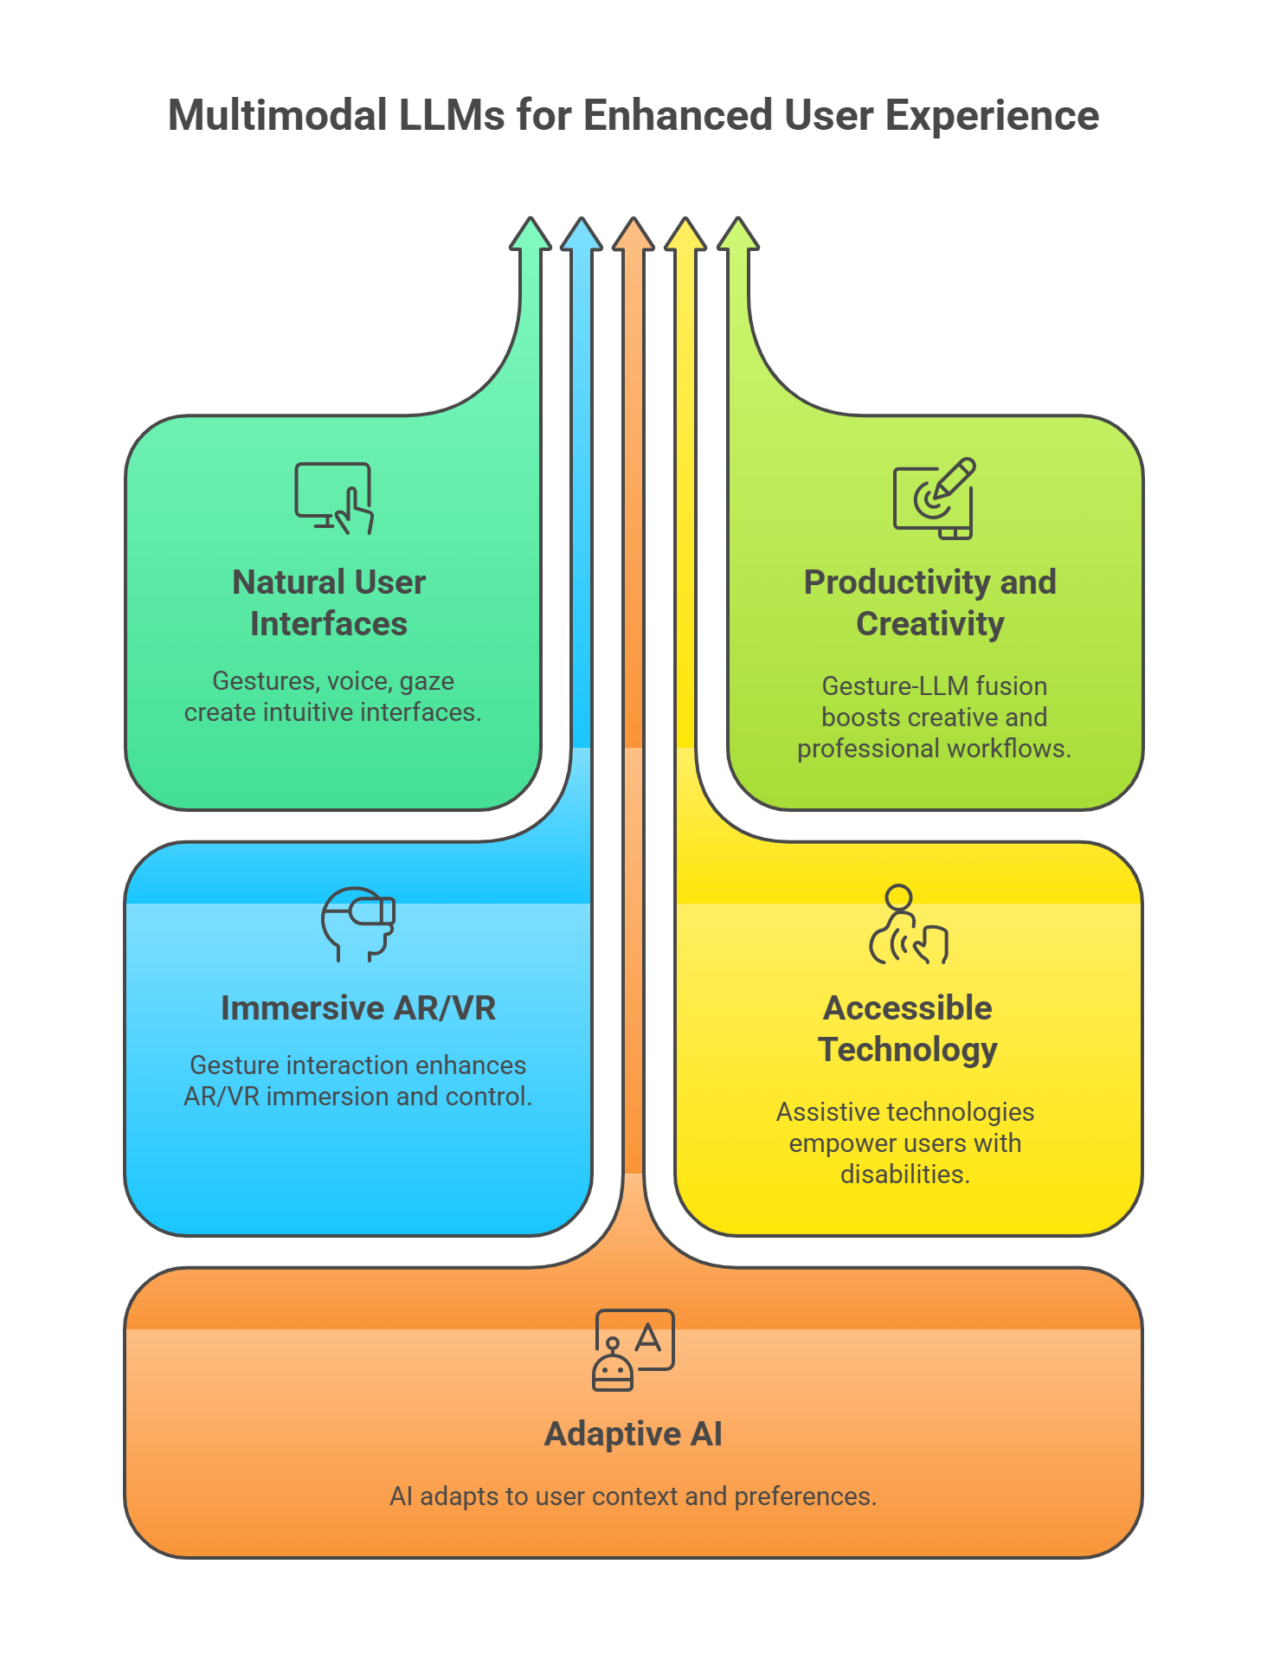
Bridging Vision and Language: The Future of Intuitive Interaction with ...

Hydra-X: Native Unified Multimodal Models with Holistic Visual Tokenizers
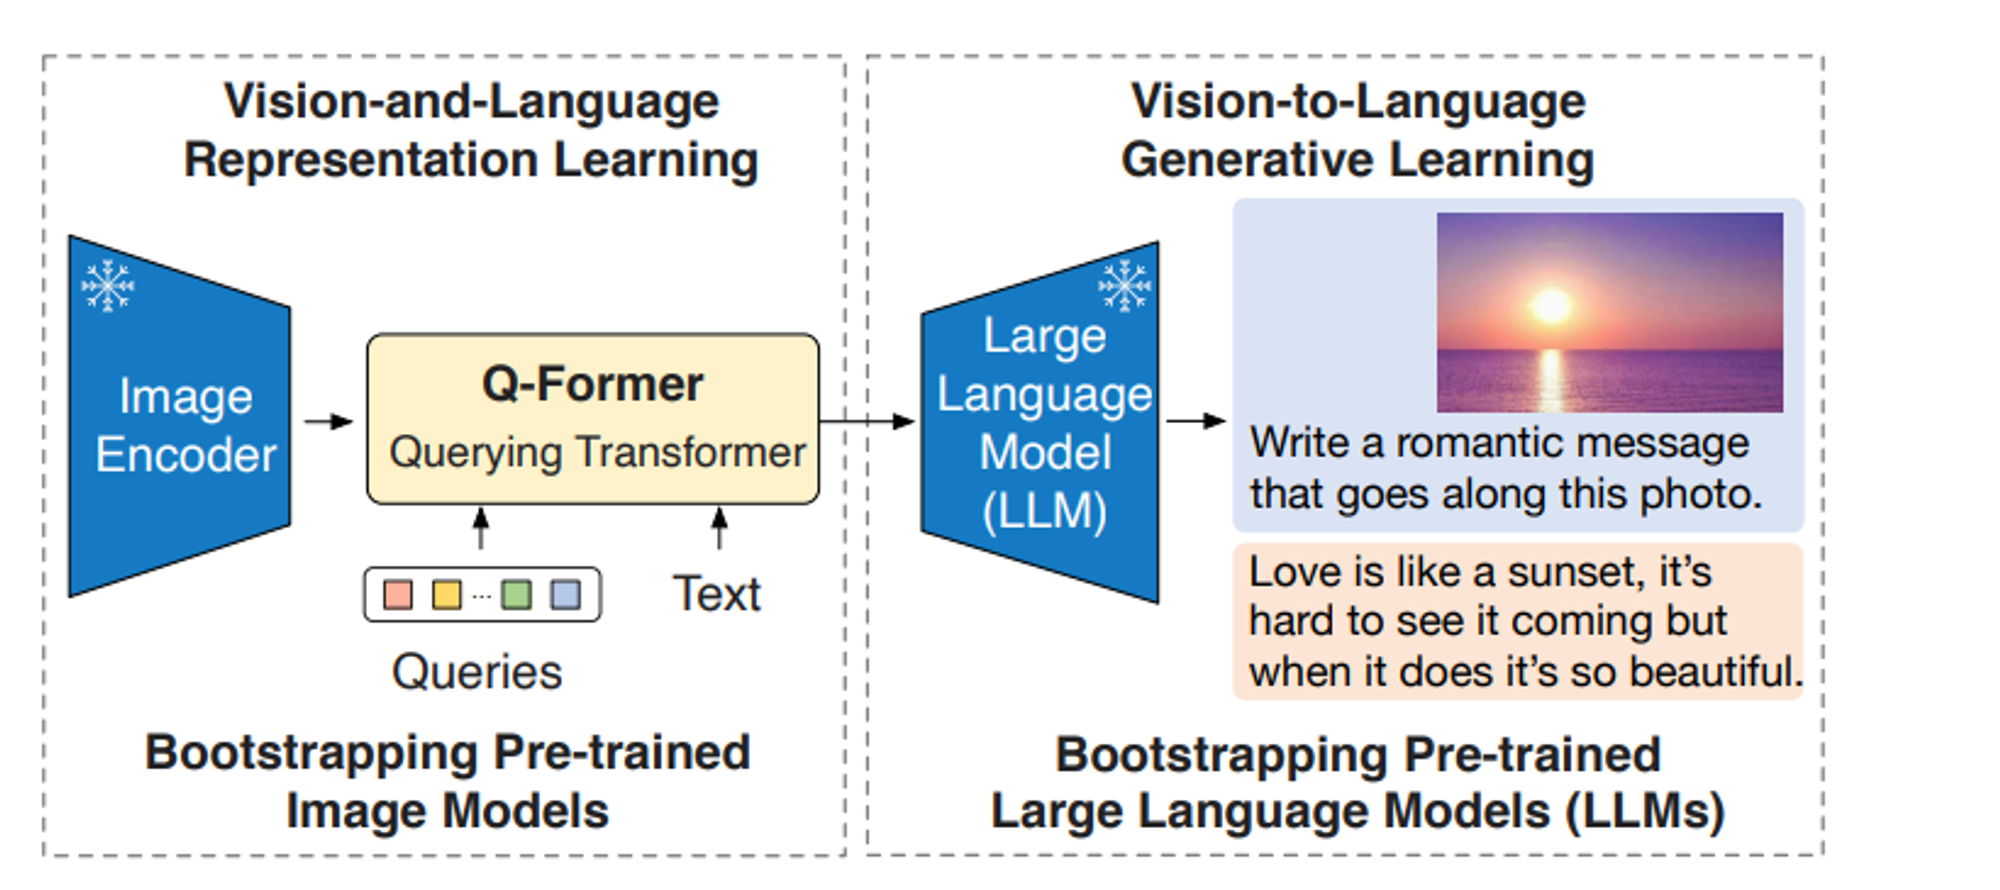
A Comprehensive Guide to Multimodal LLMs and How they Work

Multimodal LLM using Federated Visual Instruction Tuning for Visually ...

Energy-Driven Adaptive Visual Token Pruning for Efficient Vision ...
Advertisement Space (336x280)

Figure 1 from Multimodal LLMs as Customized Reward Models for Text-to ...

[2603.00482] TokenCom: Vision-Language Model for Multimodal and ...

Slot-MLLM: Object-Centric Visual Tokenization for Multimodal LLM

[论文评述] Video Token Sparsification for Efficient Multimodal LLMs in ...

Vision Enhancing LLMs: Empowering Multimodal Knowledge Storage and ...

A Comprehensive Guide to Multimodal LLMs and How they Work
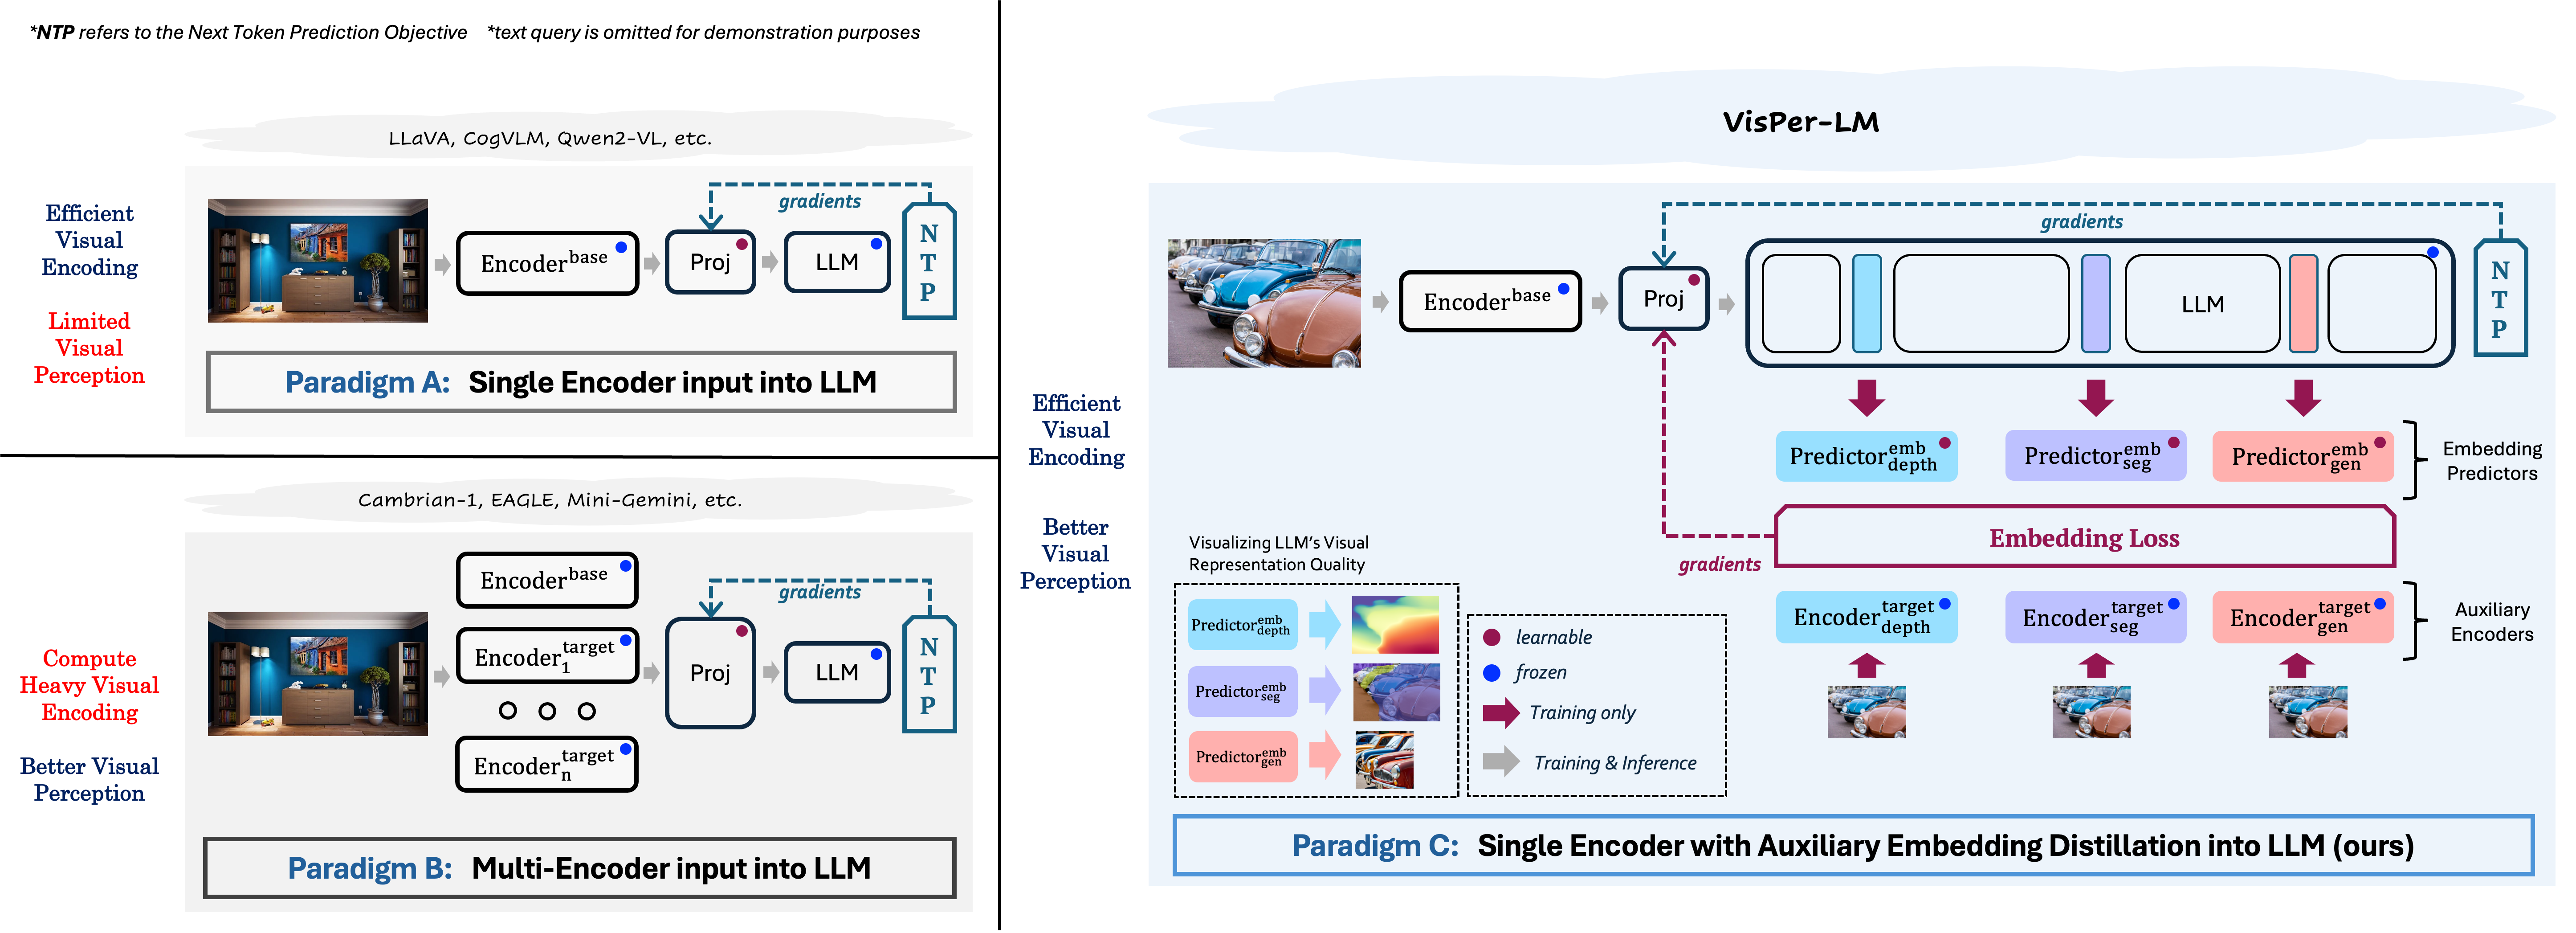
Elevating Perception in Multimodal LLMs with Visual Embedding ...

Blink: Dynamic Visual Token Resolution for Enhanced Multimodal ...

[논문 리뷰] Blink: Dynamic Visual Token Resolution for Enhanced Multimodal ...
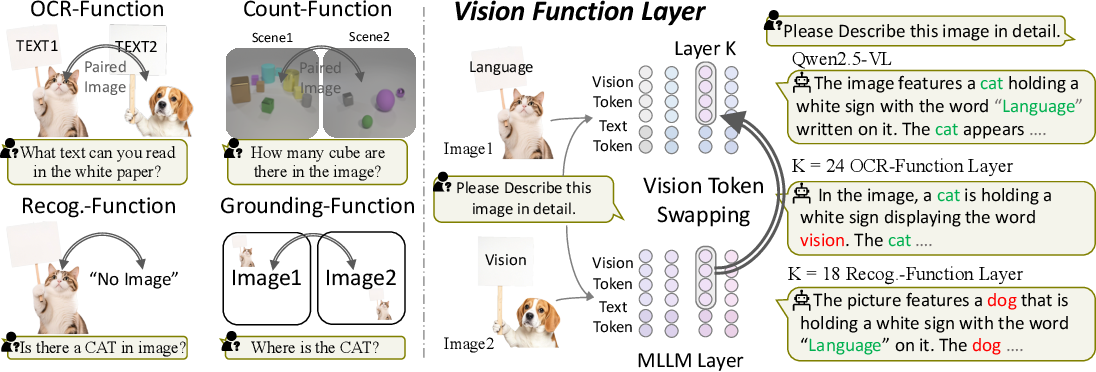
Figure 1 from Vision Function Layer in Multimodal LLMs | Semantic Scholar
Advertisement Space (336x280)

Customized Visual Storytelling with Unified Multimodal LLMs

A Comprehensive Guide to Multimodal LLMs and How they Work

[논문 리뷰] A Multimodal LLM Approach for Visual Question Answering on ...
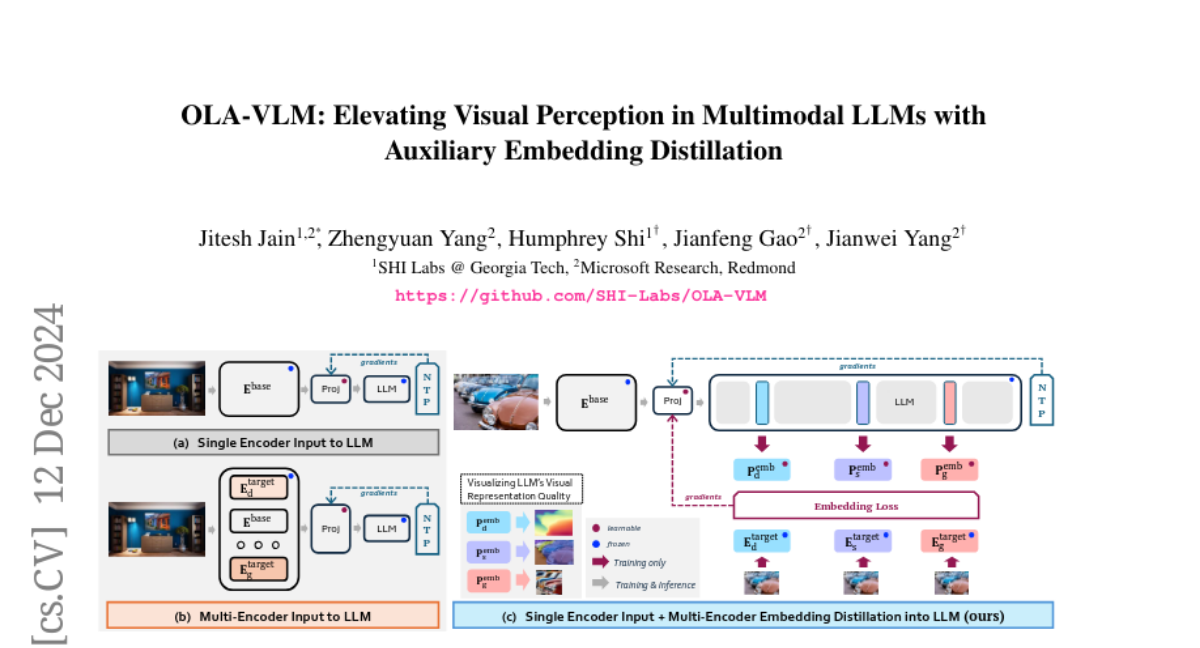
OLA-VLM: Elevating Visual Perception in Multimodal LLMs with Auxiliary ...

Paper page - OLA-VLM: Elevating Visual Perception in Multimodal LLMs ...

[2505.05422] TokLIP: Marry Visual Tokens to CLIP for Multimodal ...