
Explore And Tell Embodied Visual Captioning In 3d Environments

Explore and Tell: Embodied Visual Captioning in 3D Environments
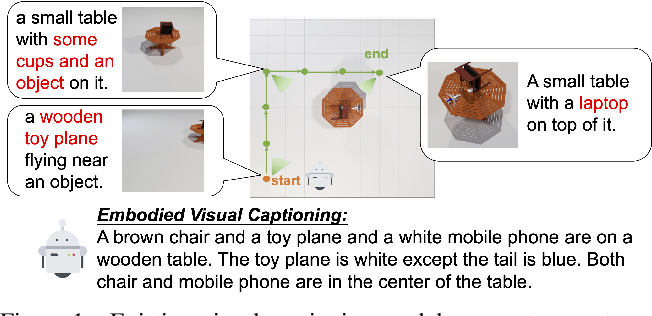
Figure 1 from Explore and Tell: Embodied Visual Captioning in 3D ...

Figure 2 from Explore and Tell: Embodied Visual Captioning in 3D ...

Table 1 from Explore and Tell: Embodied Visual Captioning in 3D ...
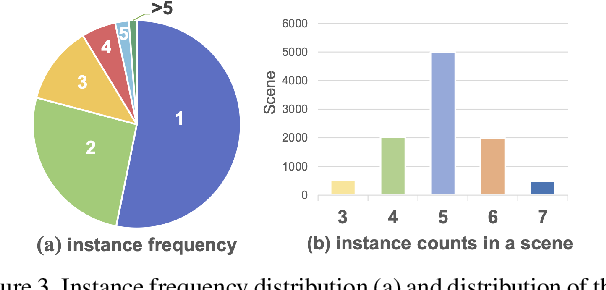
Figure 3 from Explore and Tell: Embodied Visual Captioning in 3D ...
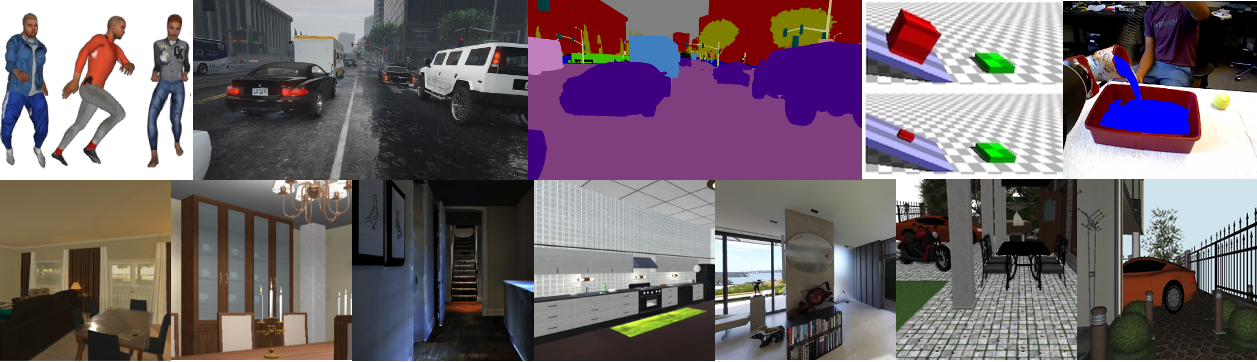
Visual Learning and Embodied Agents in Simulation Environments

Figure 1.1 from Dense Captioning Objects in 3D Environments using ...

Figure 4.1 from Dense Captioning Objects in 3D Environments using ...

Figure 3.1 from Dense Captioning Objects in 3D Environments using ...

Rethinking 3D Dense Caption and Visual Grounding in A Unified Framework ...
Advertisement Space (300x250)

Figure 3.2 from Dense Captioning Objects in 3D Environments using ...

Figure 4.6 from Dense Captioning Objects in 3D Environments using ...

Rethinking 3D Dense Caption and Visual Grounding in A Unified Framework ...

UniT3D: A Unified Transformer for 3D Dense Captioning and Visual Grounding

[2403.19589] "TOD"³Cap: Towards 3D Dense Captioning in Outdoor Scenes

How to Tell Stories in 3D? | Visual Storytelling Institute
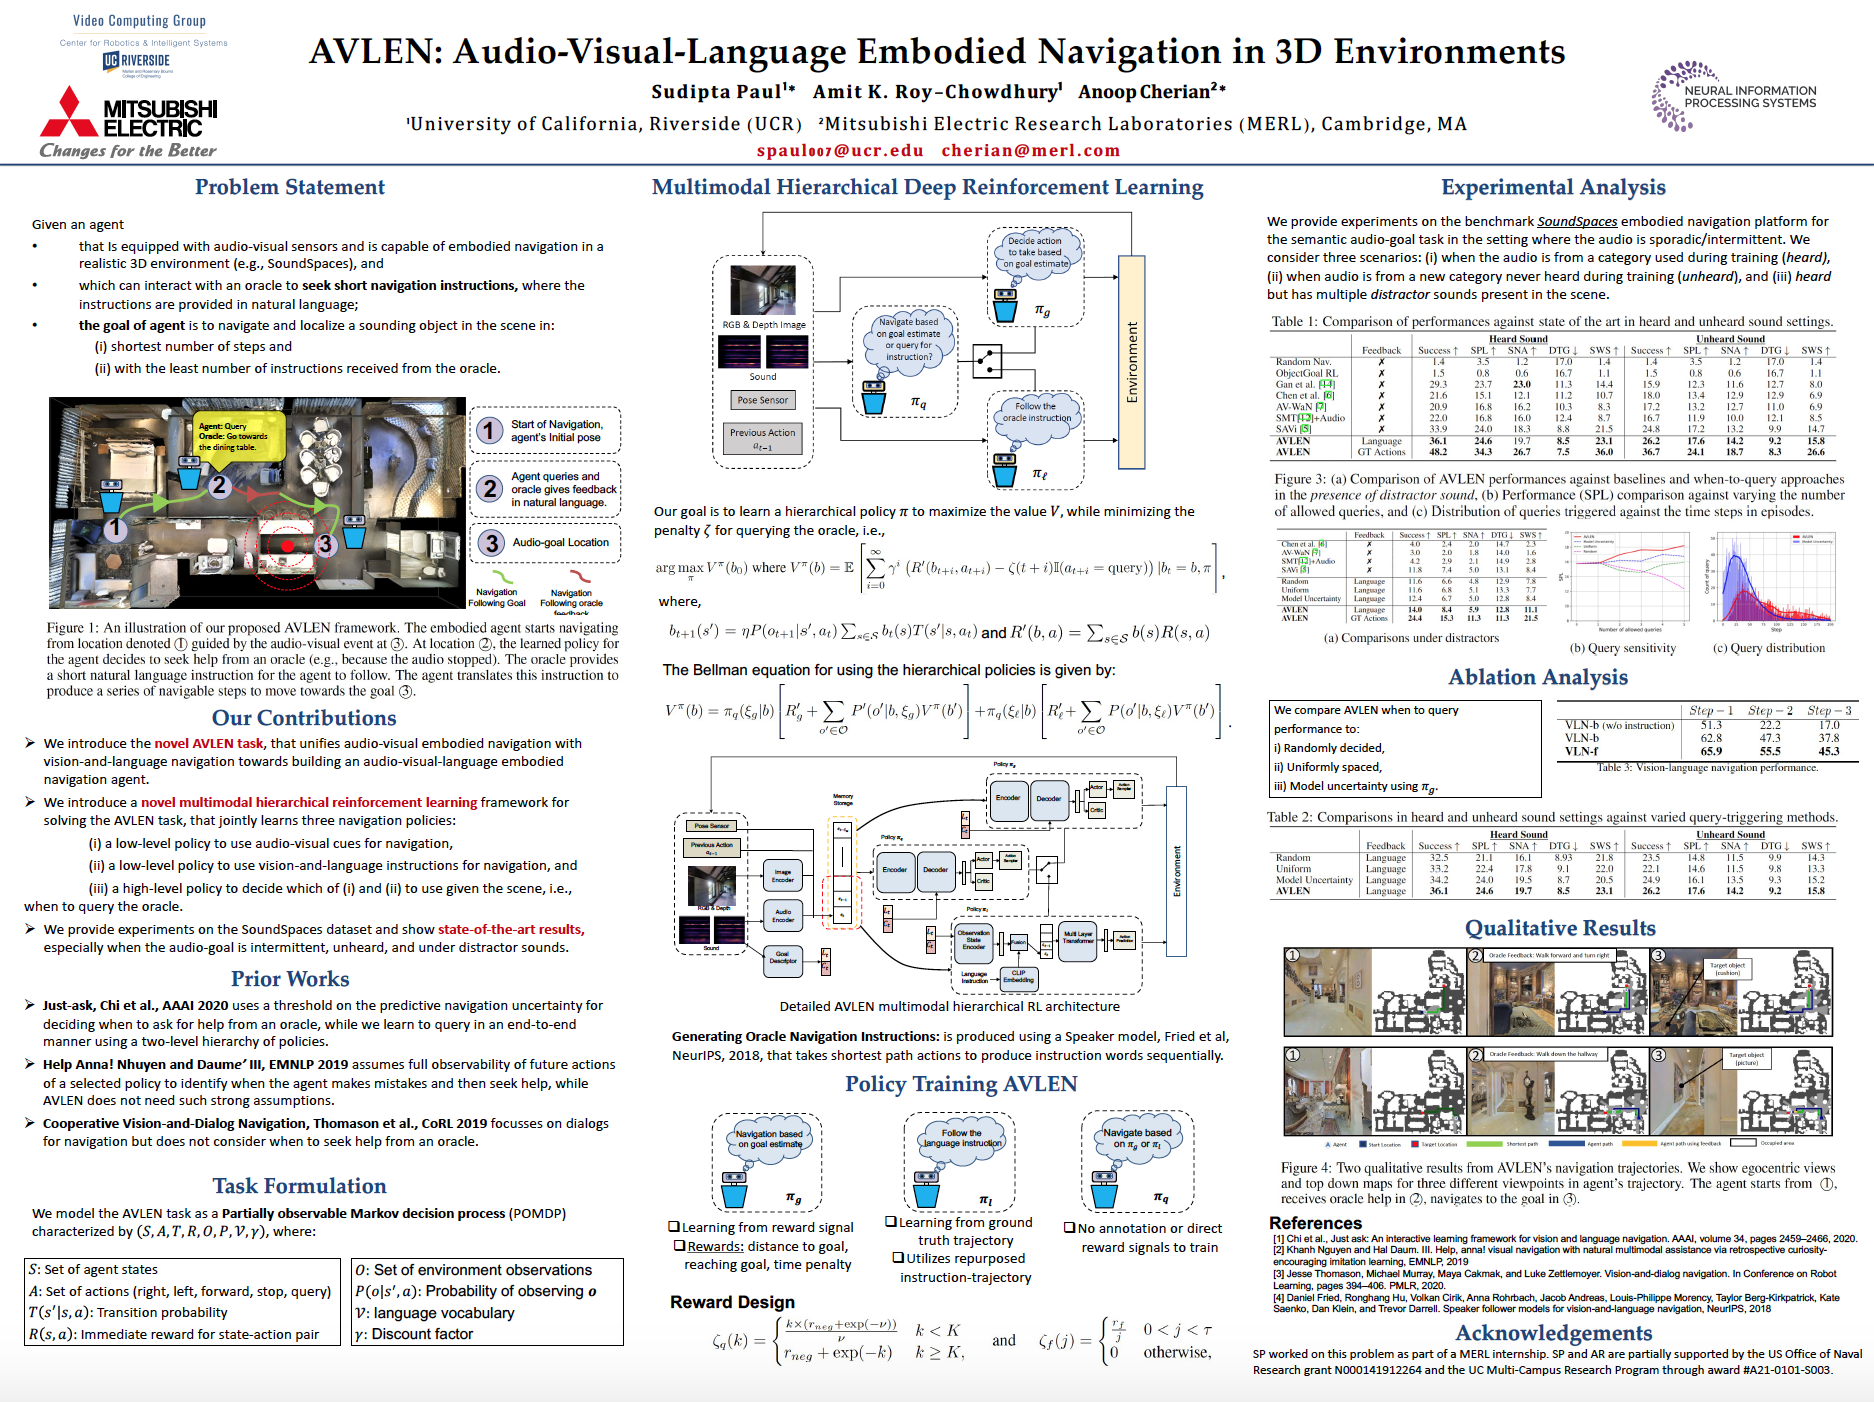
NeurIPS Poster AVLEN: Audio-Visual-Language Embodied Navigation in 3D ...
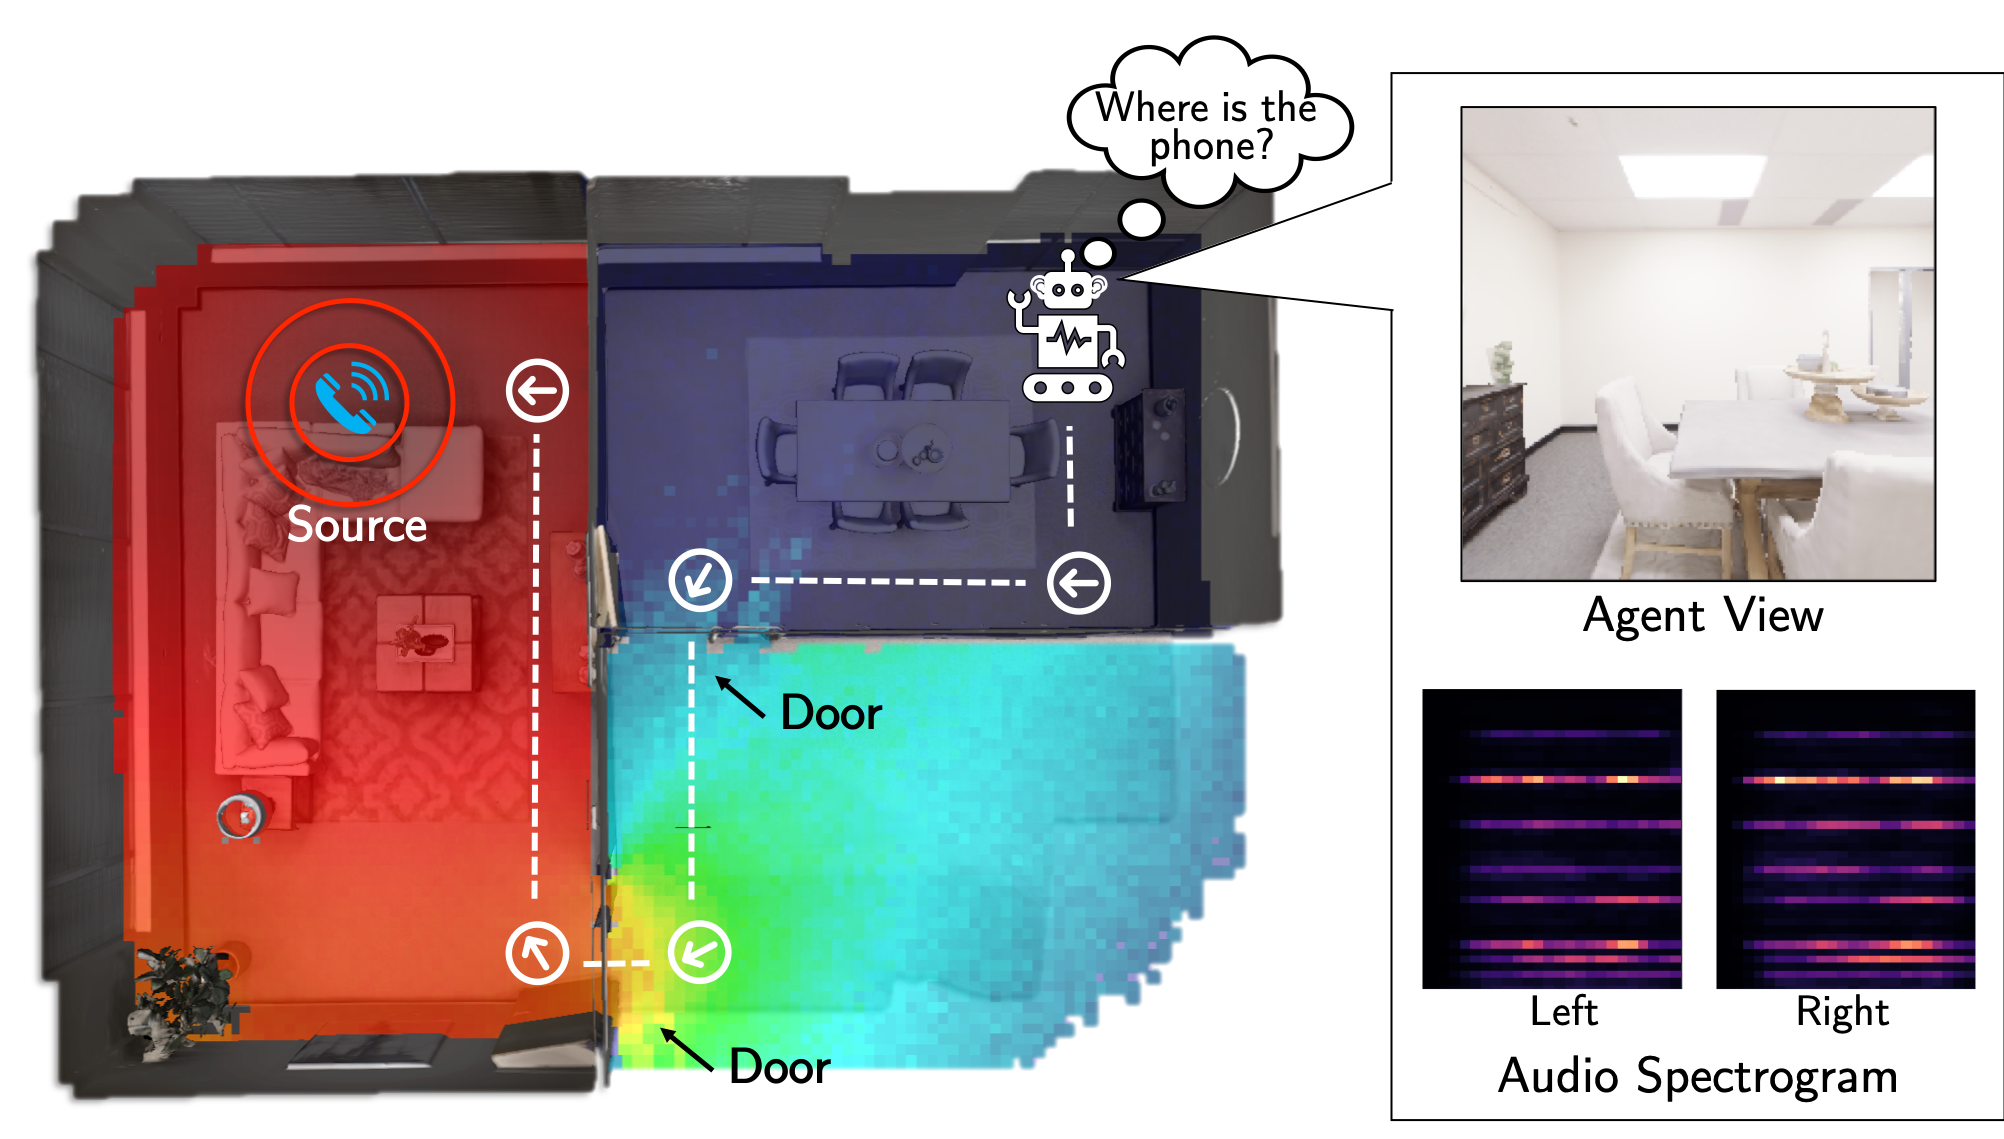
SoundSpaces: Audio-Visual Navigation in 3D Environments

3DJCG: A Unified Framework for Joint Dense Captioning and Visual ...
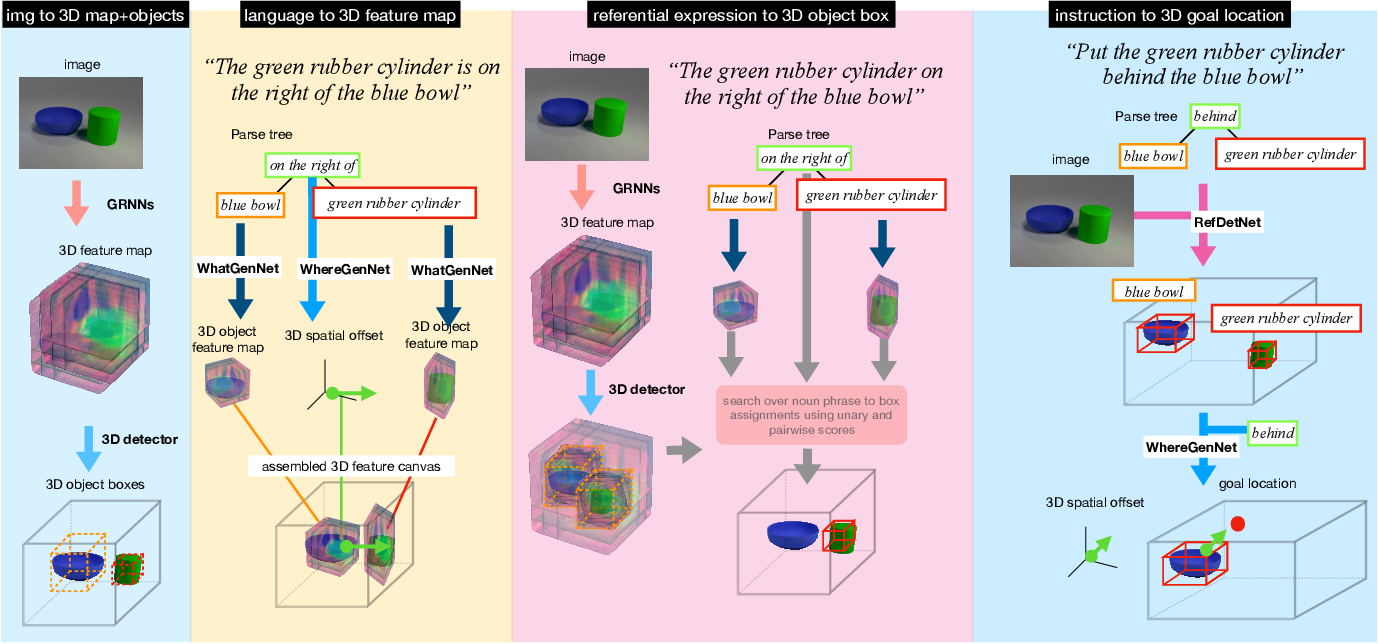
Figure 1 from Embodied Language Grounding With 3D Visual Feature ...
Advertisement Space (336x280)

Visual Captioning at Will: Describing Images and Videos Guided by a Few ...

Figure 1 from 3D Change Localization and Captioning from Dynamic Scans ...
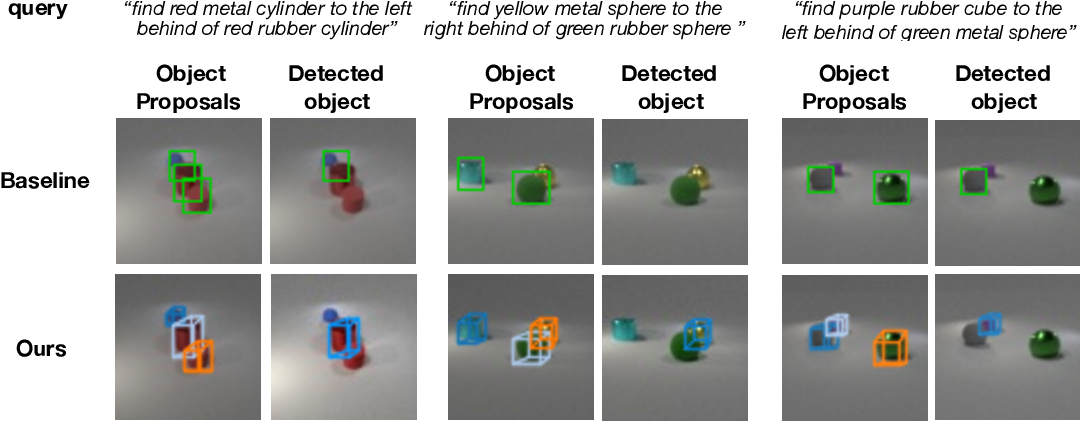
Figure 3 from Embodied Language Grounding with Implicit 3D Visual ...
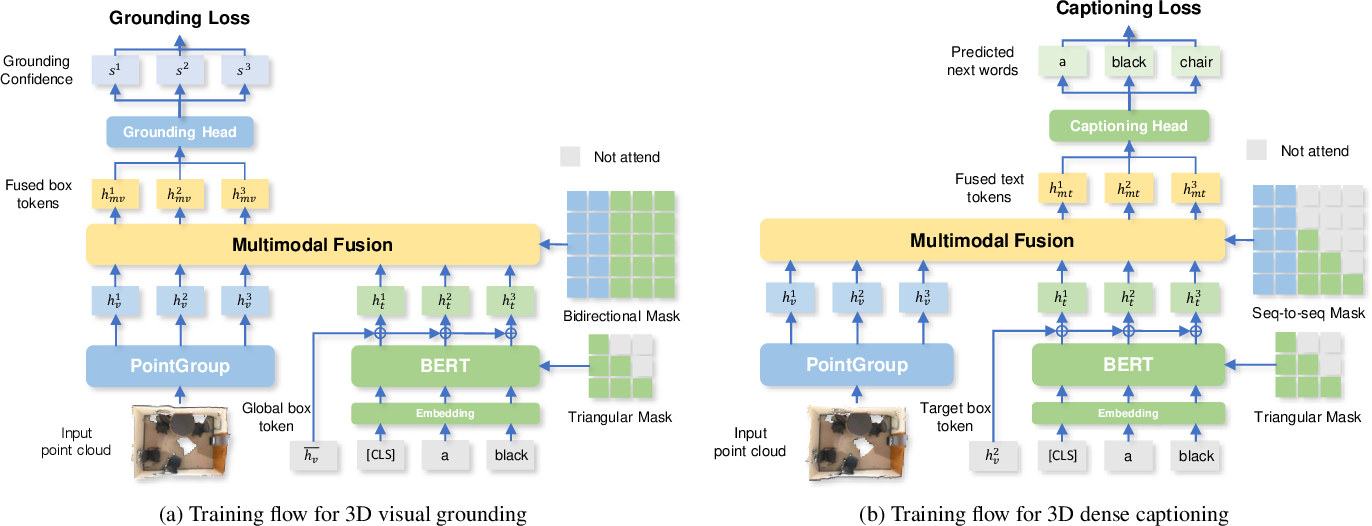
Figure 2 from UniT3D: A Unified Transformer for 3D Dense Captioning and ...

Analysing and Understanding Embodied Interactions in Virtual Reality ...

Paper page - UniT3D: A Unified Transformer for 3D Dense Captioning and ...

1: Example of embodied intelligent virtual characters living in 3D ...

RealmDreamer: Text-Driven 3D Scene Generation with Inpainting and Depth ...

Bi-directional Contextual Attention for 3D Dense Captioning
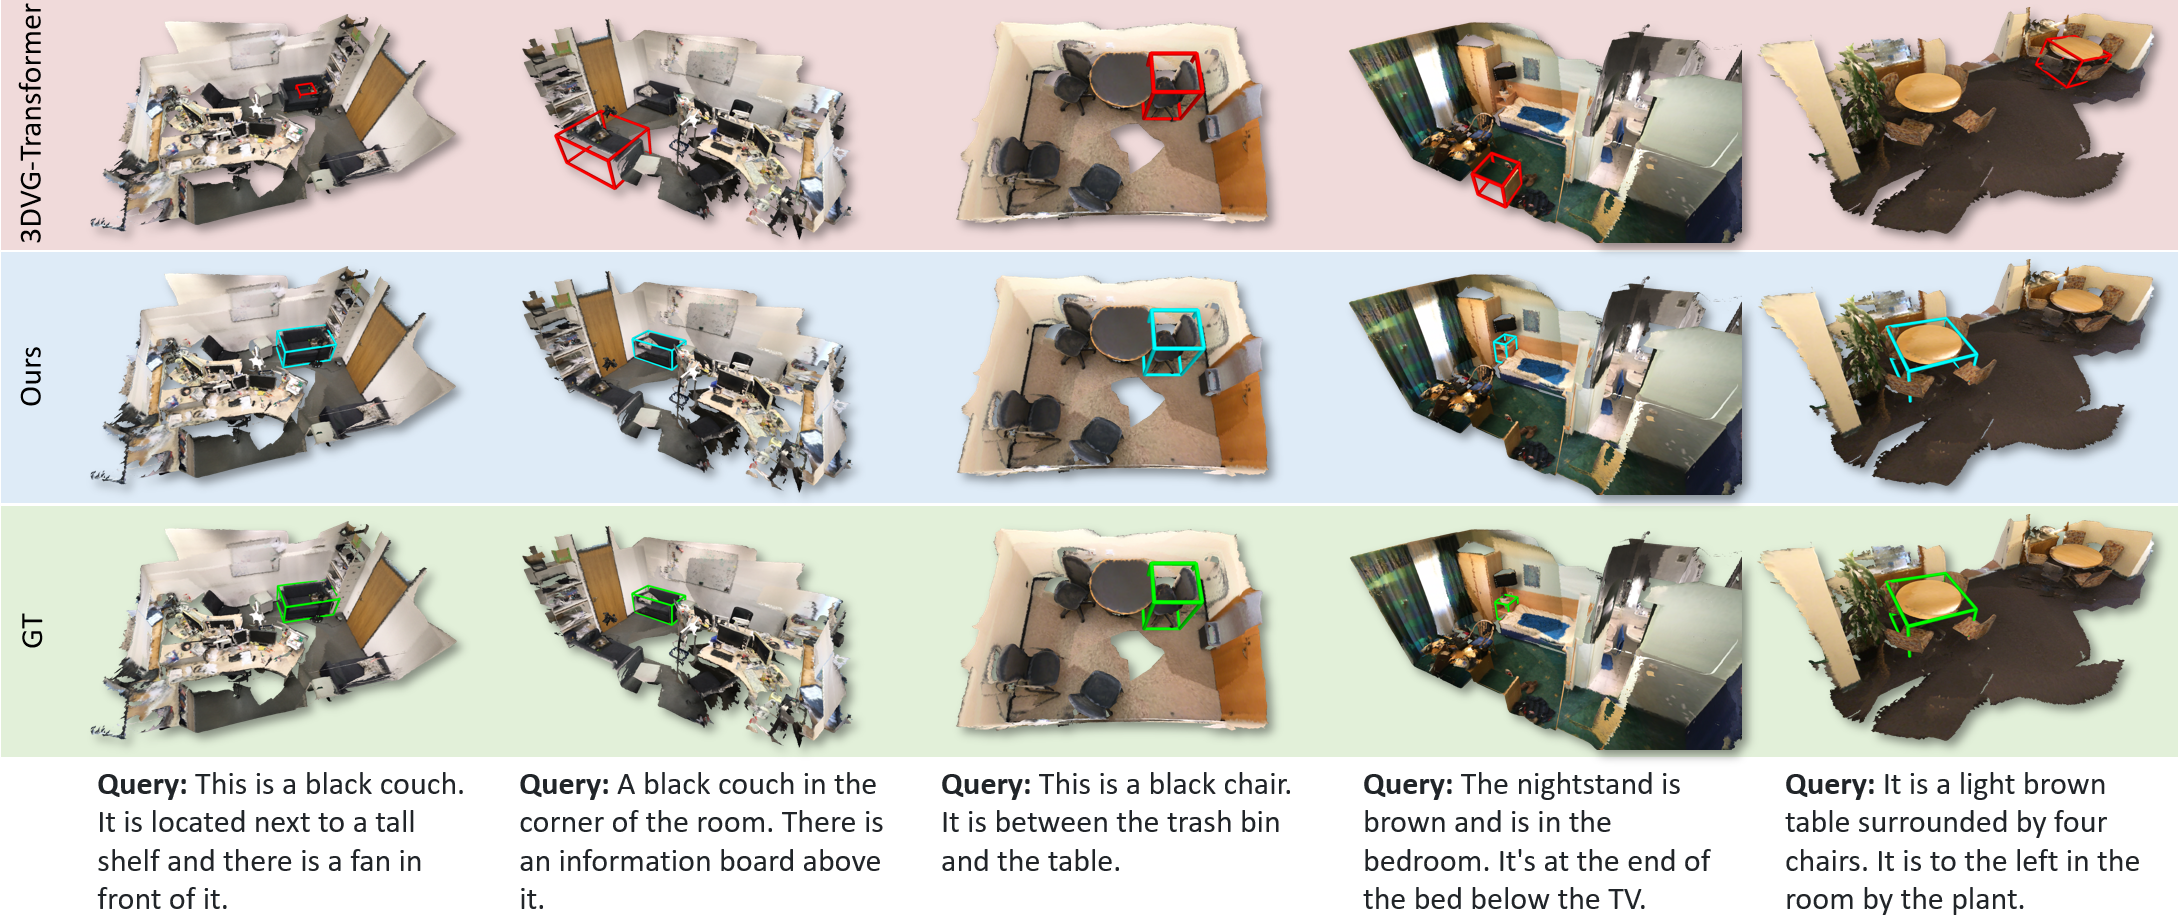
D3Net: A Unified Speaker-Listener Architecture for 3D Dense Captioning ...
Advertisement Space (336x280)

ExCap3D: Expressive 3D Scene Understanding via Object Captioning with ...

Figure 15 from Generating Visual Spatial Description via Holistic 3D ...
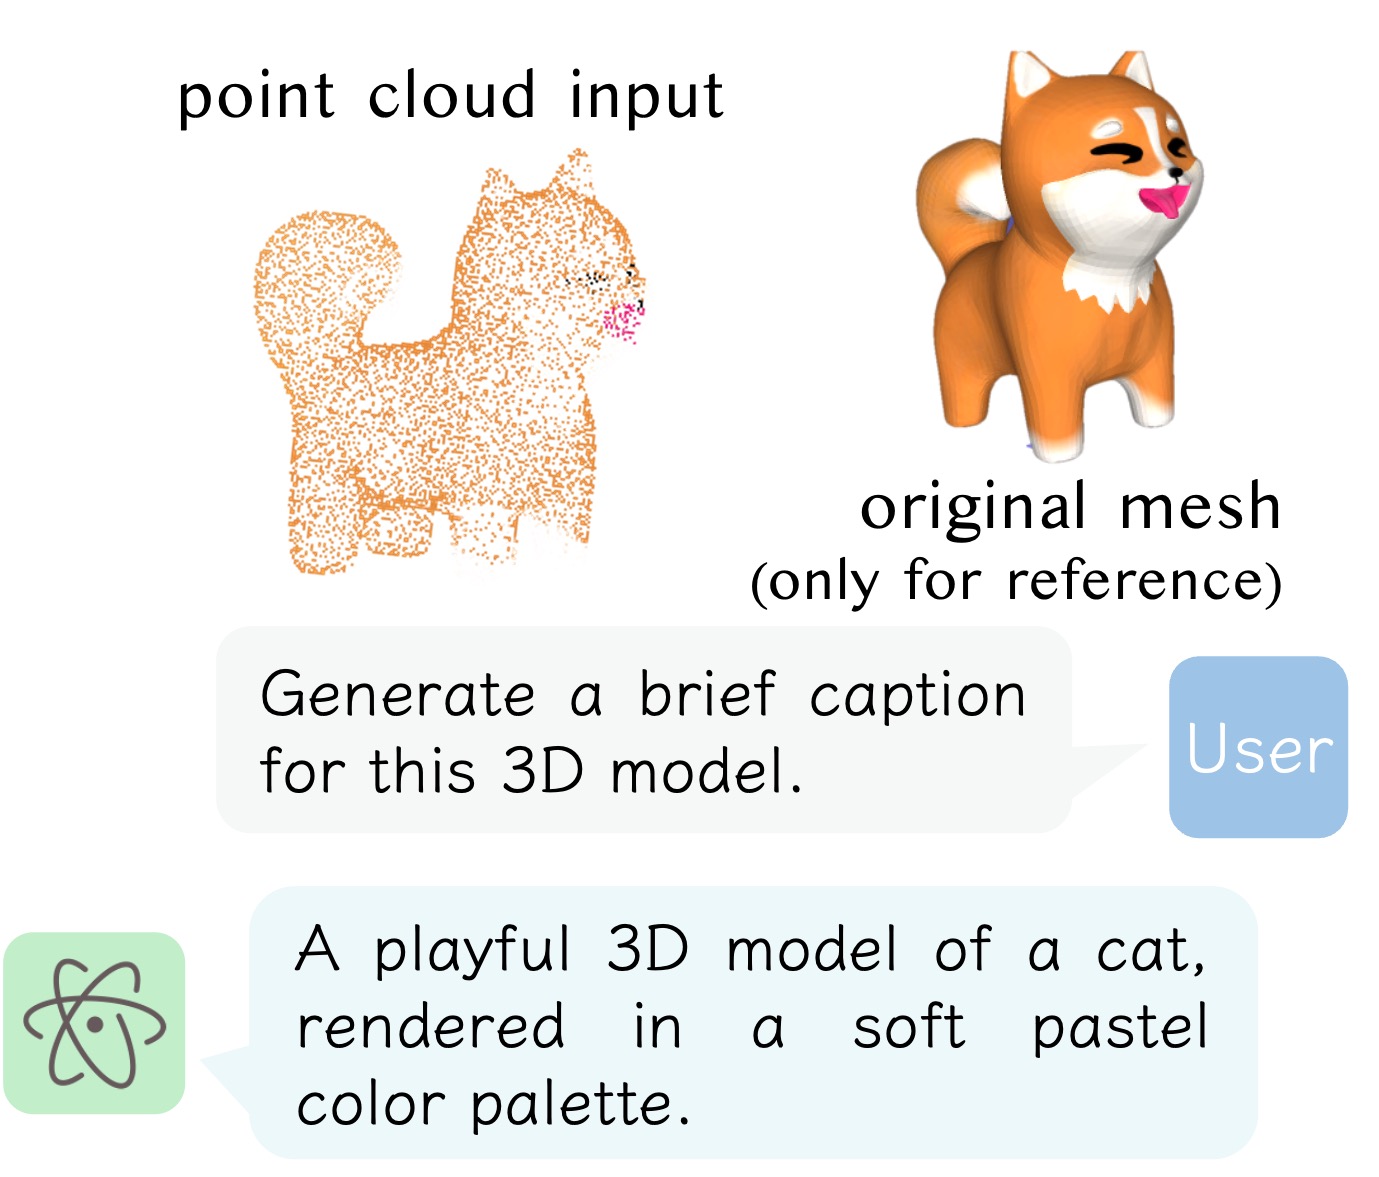
ShapeLLM: Universal 3D Object Understanding for Embodied Interaction
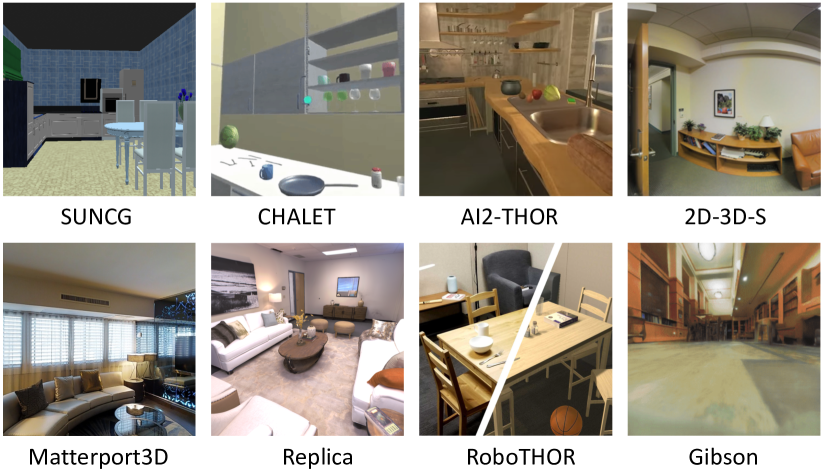
[2108.04097] Deep Learning for Embodied Visual Navigation Research: A ...
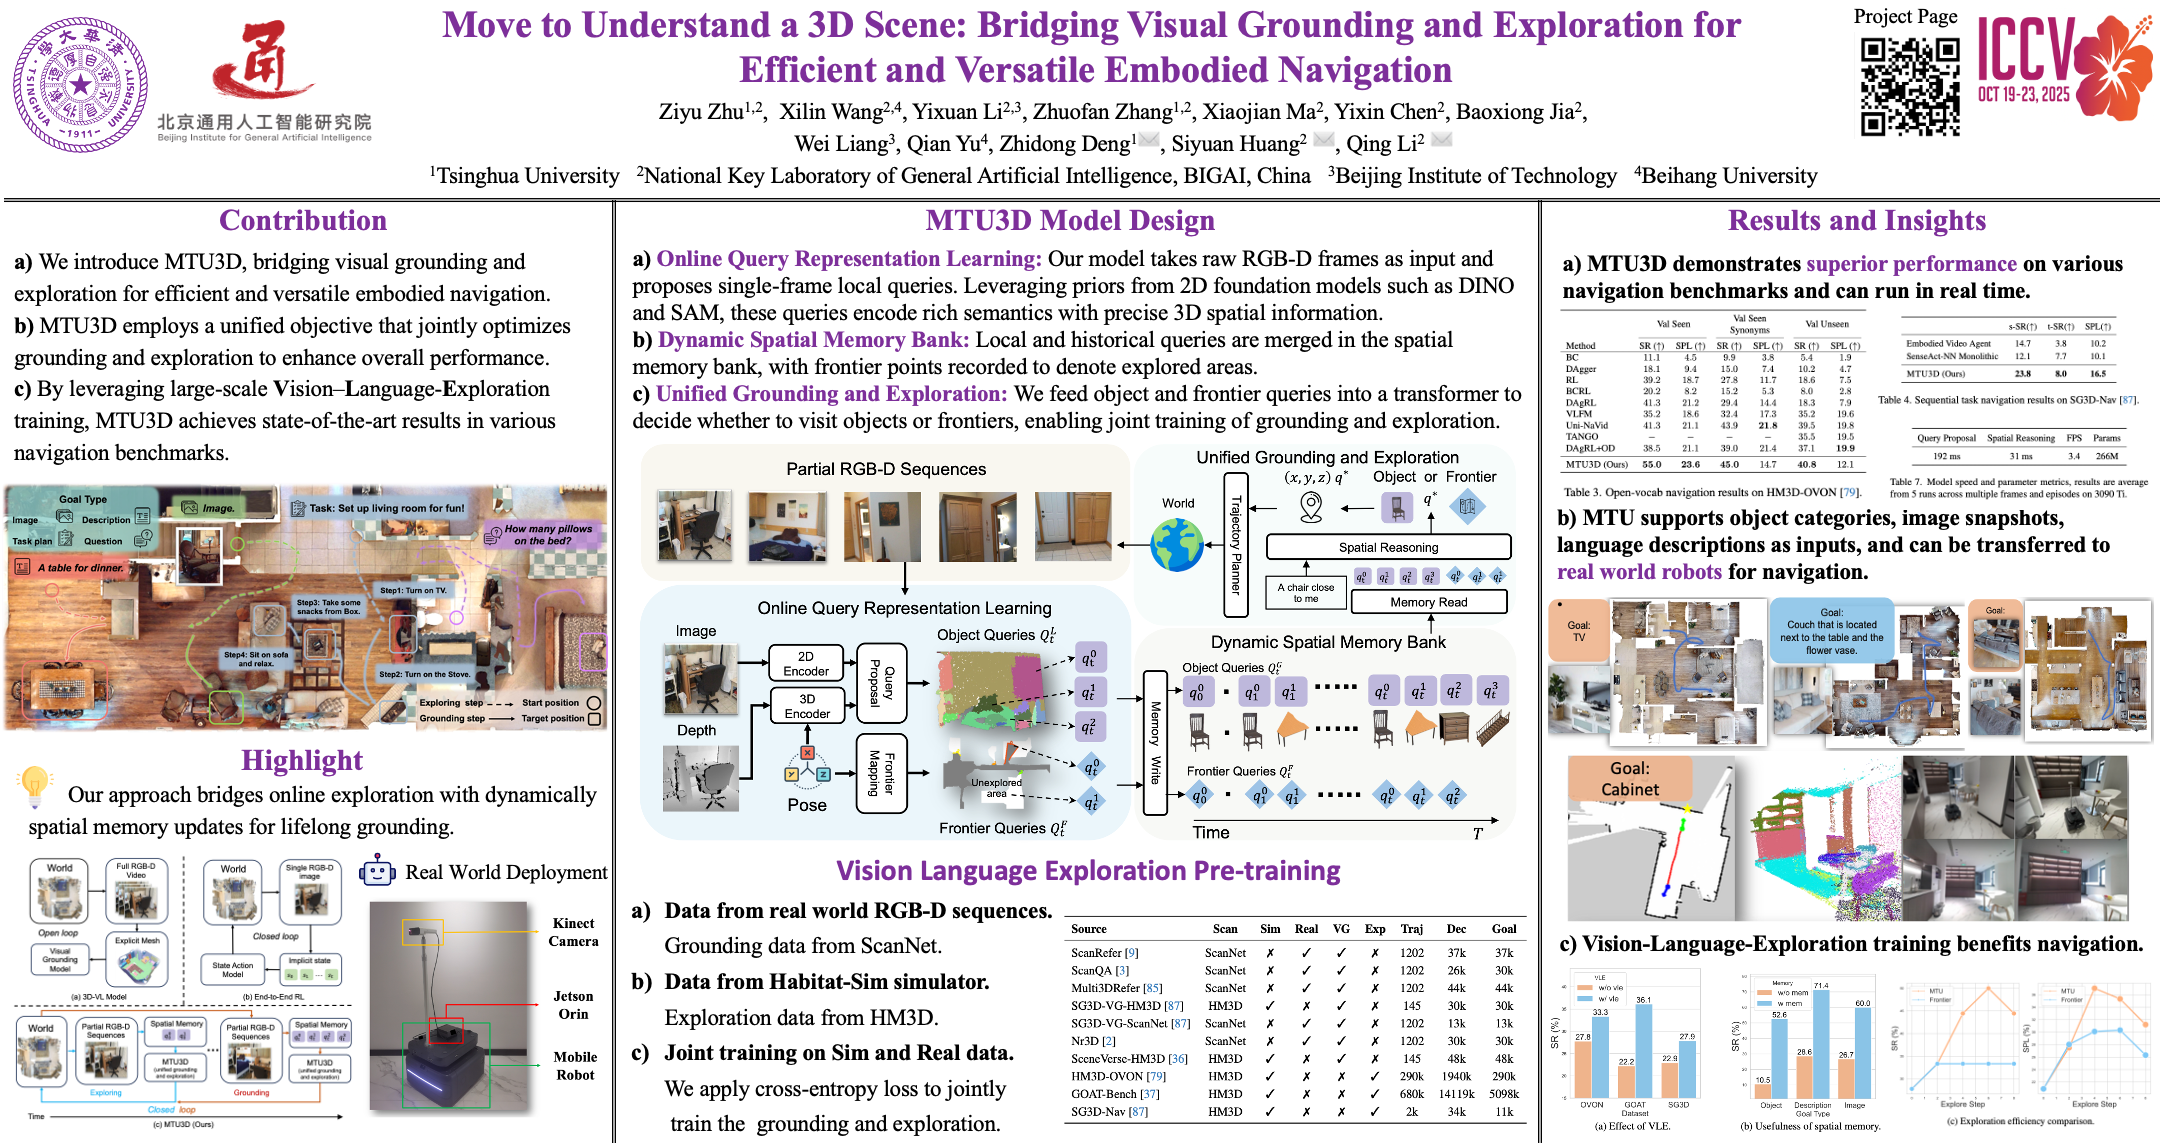
ICCV Poster Move to Understand a 3D Scene: Bridging Visual Grounding ...

[2306.07279] Scalable 3D Captioning with Pretrained Models