
Figure 1 From Explore And Tell Embodied Visual Captioning In 3d

Table 1 from Explore and Tell: Embodied Visual Captioning in 3D ...
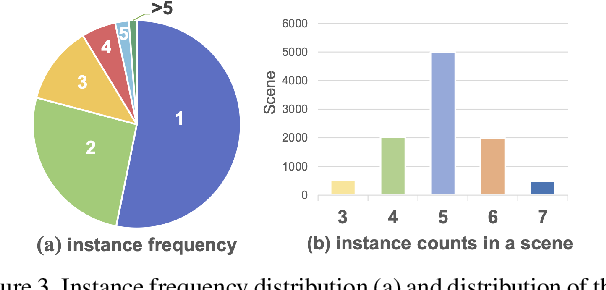
Figure 3 from Explore and Tell: Embodied Visual Captioning in 3D ...
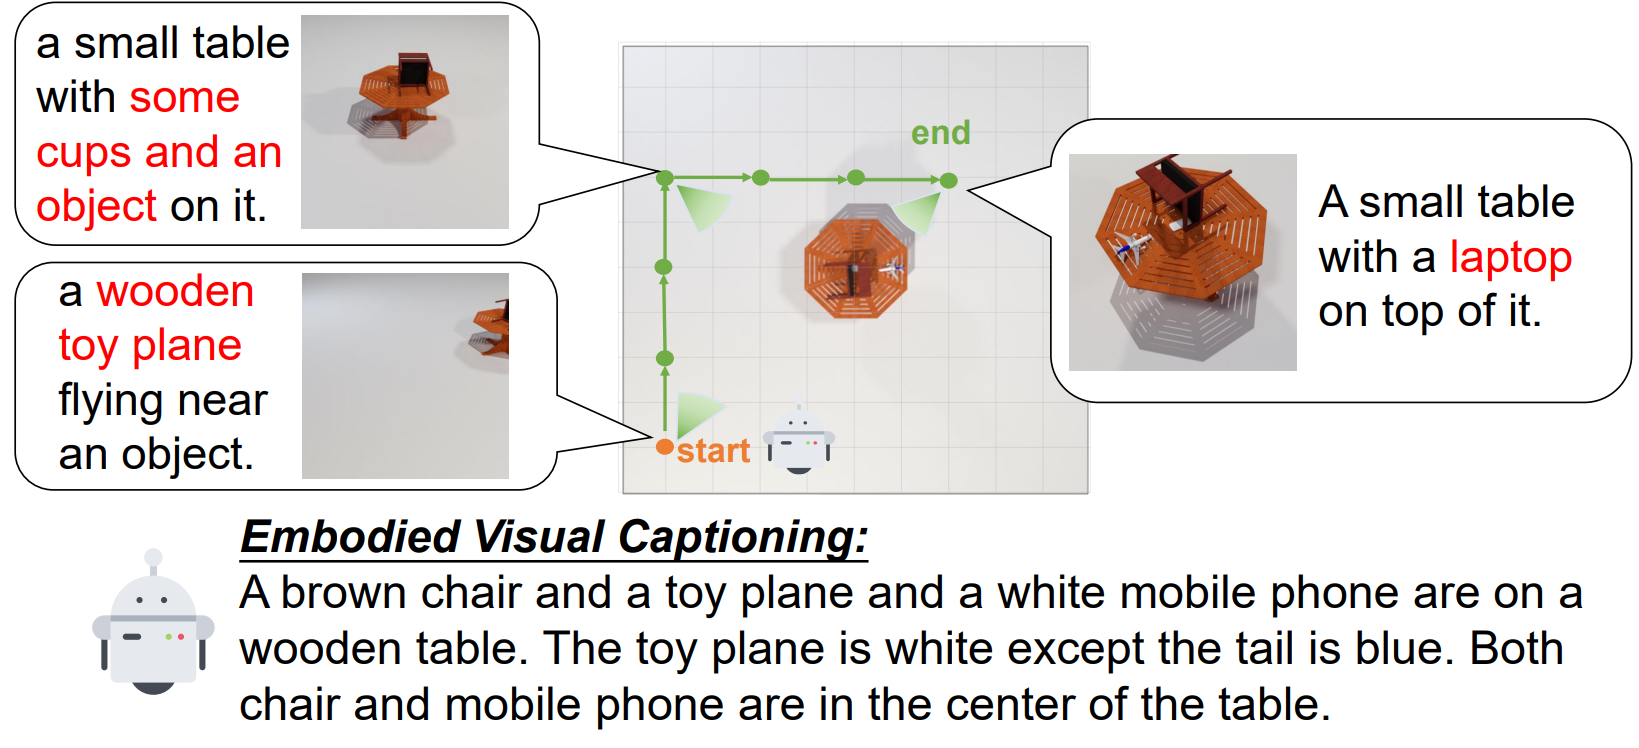
Explore and Tell: Embodied Visual Captioning in 3D Environments

Figure 1 from Rethinking 3D Dense Caption and Visual Grounding in A ...

Explore and Tell: Embodied Visual Captioning in 3D Environments

Explore and Tell: Embodied Visual Captioning in 3D Environments

Figure 1 from Rethinking 3D Dense Caption and Visual Grounding in A ...
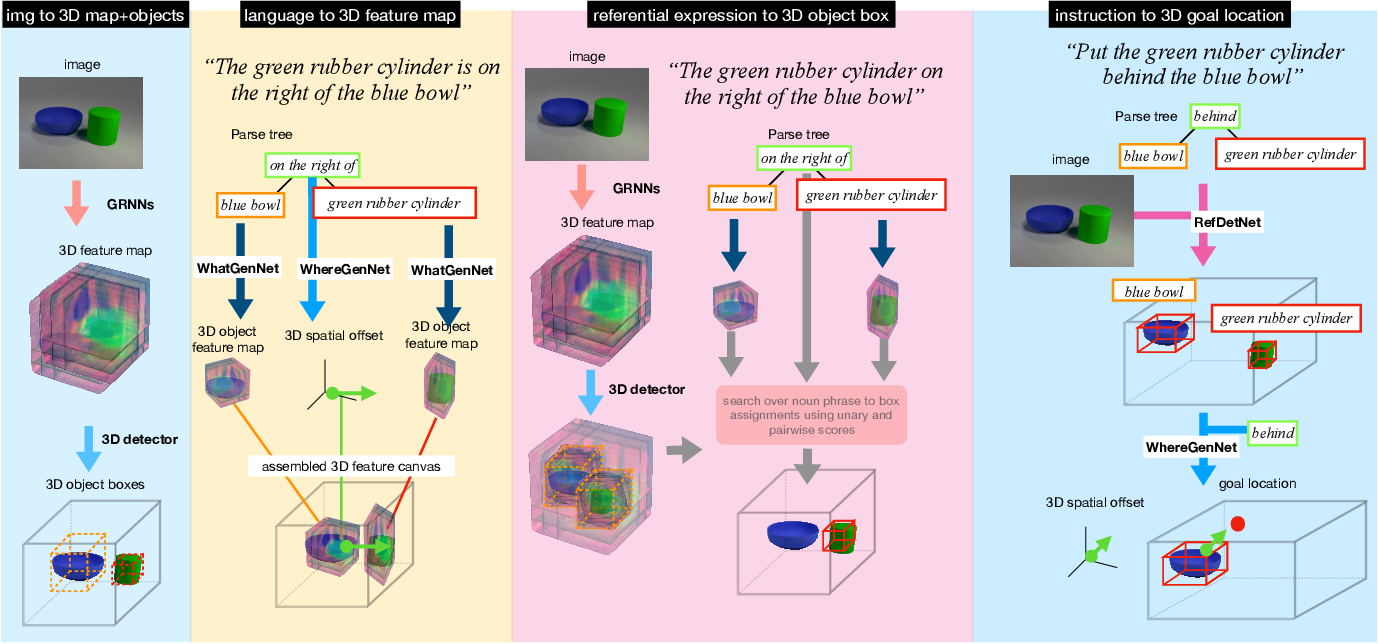
Figure 1 from Embodied Language Grounding With 3D Visual Feature ...

Figure 1 from 3D Change Localization and Captioning from Dynamic Scans ...

Figure 1 from Improving Image Captioning through Visual and Semantic ...
Advertisement Space (300x250)

Figure 1 from Affective Image Captioning for Visual Artworks Using ...

Figure 1.1 from Dense Captioning Objects in 3D Environments using ...

Figure 3.2 from Dense Captioning Objects in 3D Environments using ...
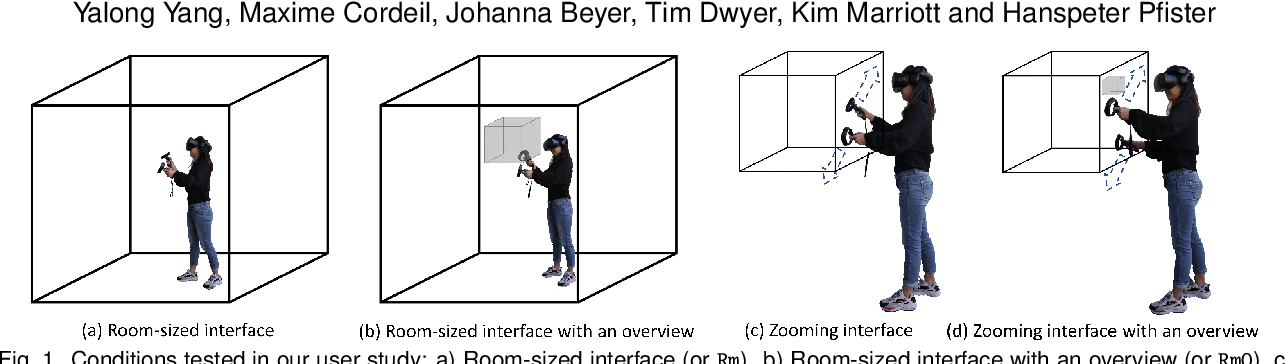
Figure 1 from Embodied Navigation in Immersive Abstract Data ...
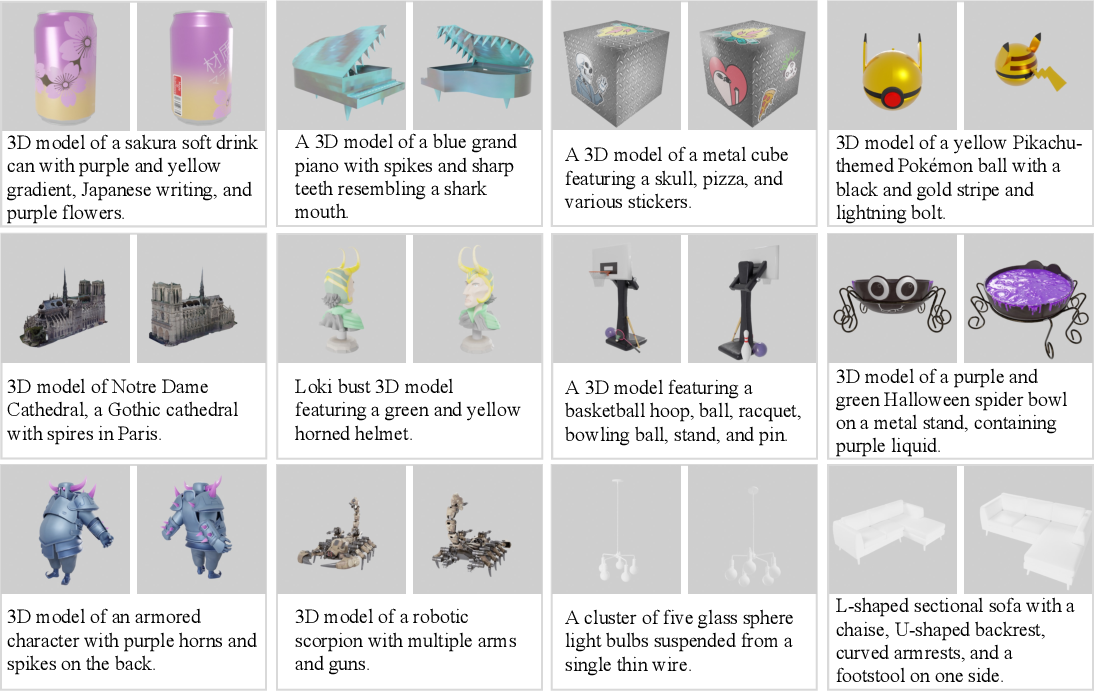
Figure 1 from Scalable 3D Captioning with Pretrained Models | Semantic ...

Figure 3.1 from Dense Captioning Objects in 3D Environments using ...
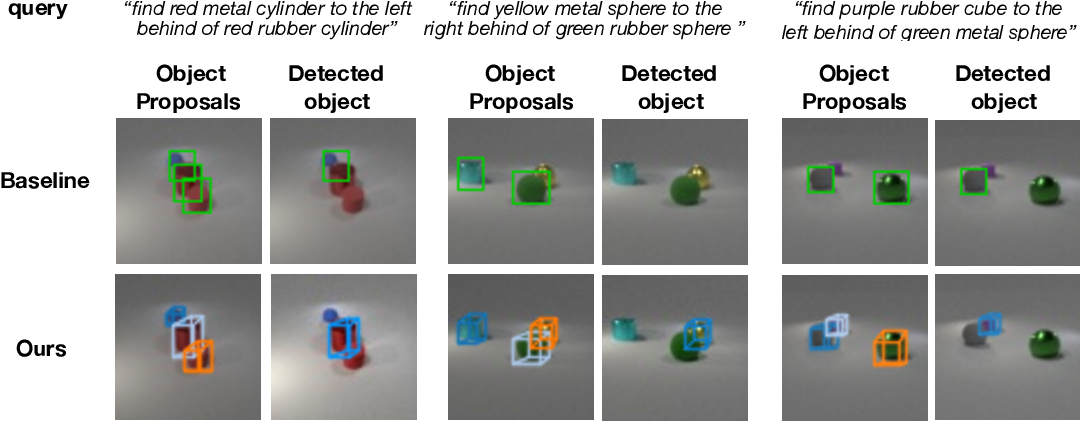
Figure 3 from Embodied Language Grounding with Implicit 3D Visual ...

Figure 1 from Contextual Modeling for 3D Dense Captioning on Point ...

Figure 4.1 from Dense Captioning Objects in 3D Environments using ...

Figure 1 from Towards Local Visual Modeling for Image Captioning ...
Advertisement Space (336x280)

Figure 4.6 from Dense Captioning Objects in 3D Environments using ...

Figure 1 from A Comprehensive Survey of 3D Dense Captioning: Localizing ...
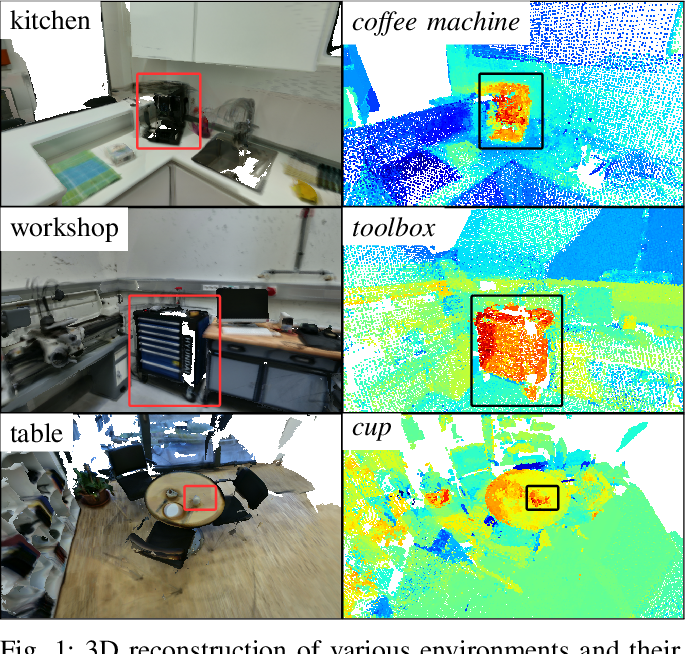
Figure 1 from Real-Time 3D Vision-Language Embedding Mapping | Semantic ...

Figure 1 from From Show to Tell: A Survey on Image Captioning ...

Figure 1 from An interactive 3D exploration narrative interface for ...

Figure 1 from Semantic Abstraction: Open-World 3D Scene Understanding ...

UniT3D: A Unified Transformer for 3D Dense Captioning and Visual Grounding

Figure 26 from Scalable 3D Captioning with Pretrained Models | Semantic ...
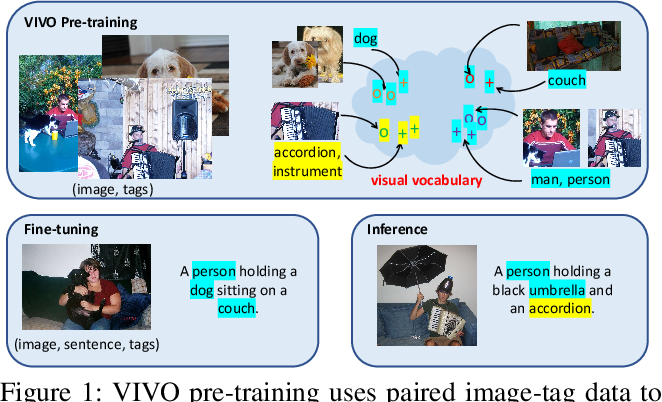
Figure 1 from VIVO: Visual Vocabulary Pre-Training for Novel Object ...

Figure 2 from Guide3D: Create 3D Avatars from Text and Image Guidance ...
Advertisement Space (336x280)
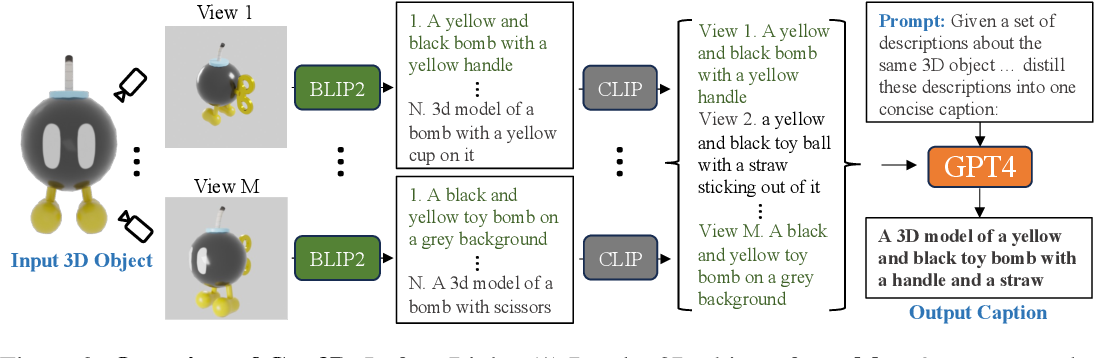
Figure 2 from Scalable 3D Captioning with Pretrained Models | Semantic ...

Figure 1 from Unifying 3D Vision-Language Understanding via Promptable ...

Figure 1 from Exploring Visual Relationships via Transformer-based ...

UniT3D: A Unified Transformer for 3D Dense Captioning and Visual Grounding

Figure 10 from A Comprehensive Survey of 3D Dense Captioning ...
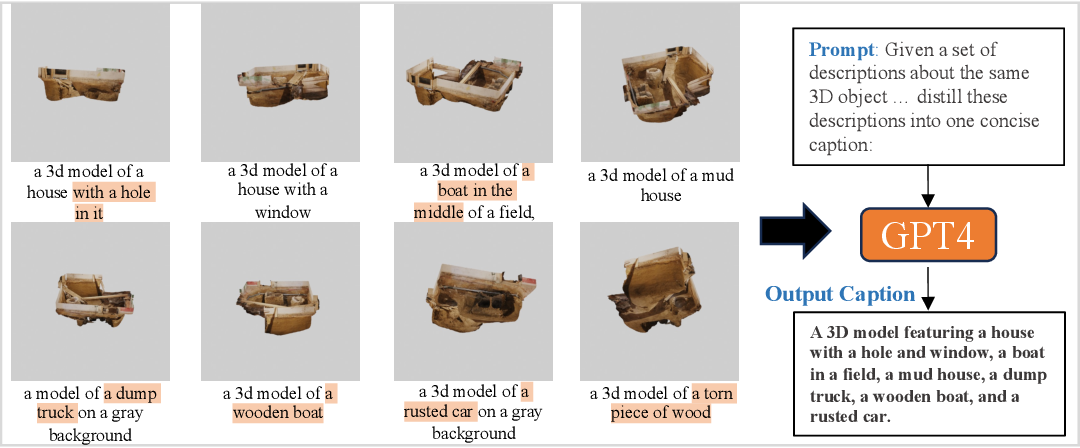
Figure 23 from Scalable 3D Captioning with Pretrained Models | Semantic ...