
Extremely Low Bit Transformer Quantization For On Device Neural Machine
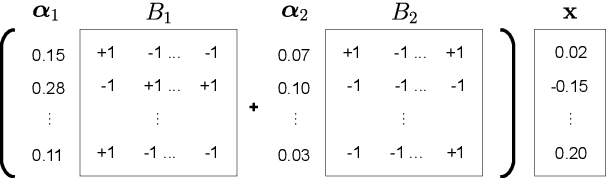
Extremely Low Bit Transformer Quantization for On-Device Neural Machine ...

Extremely Low Bit Transformer Quantization for On-Device Neural Machine ...
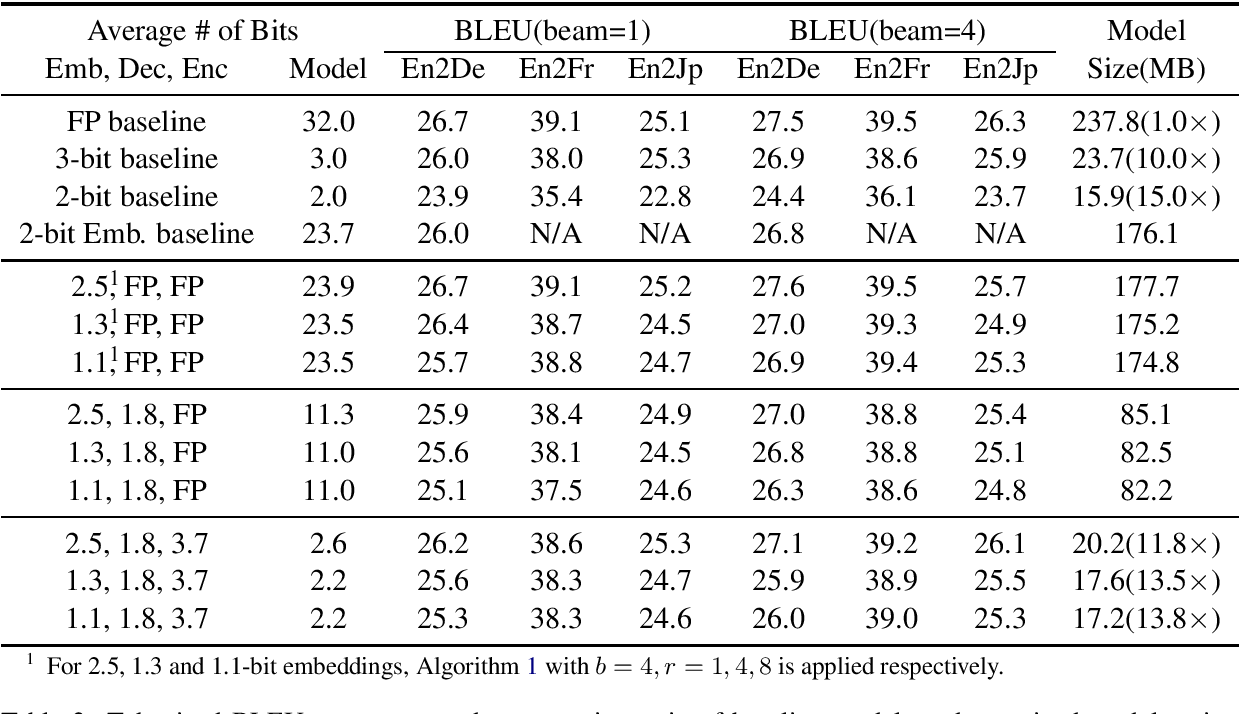
Extremely Low Bit Transformer Quantization for On-Device Neural Machine ...

Extremely Low Bit Transformer Quantization for On-Device Neural Machine ...

Extremely Low Bit Transformer Quantization for On-Device Neural Machine ...
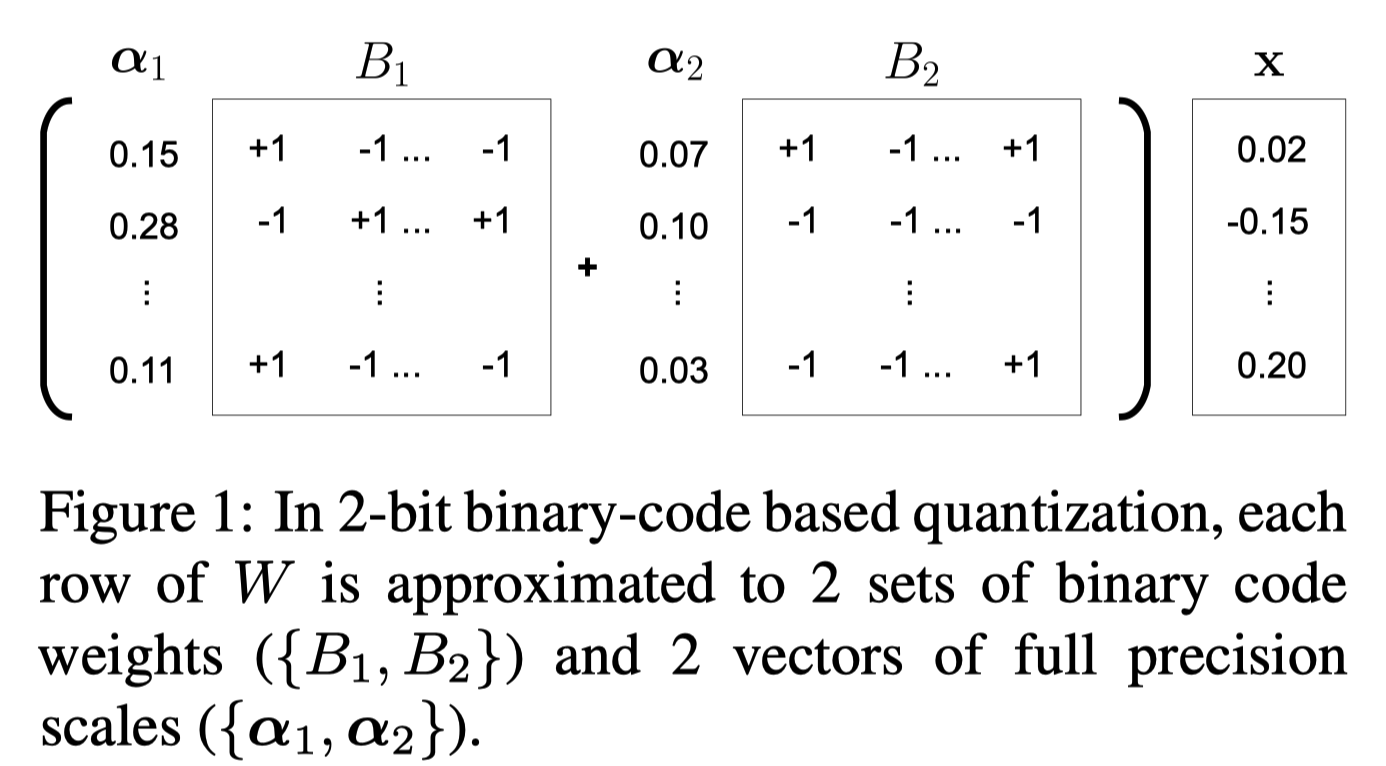
[NLP 논문 리뷰] Extremely Low Bit Transformer Quantization for On-Device ...
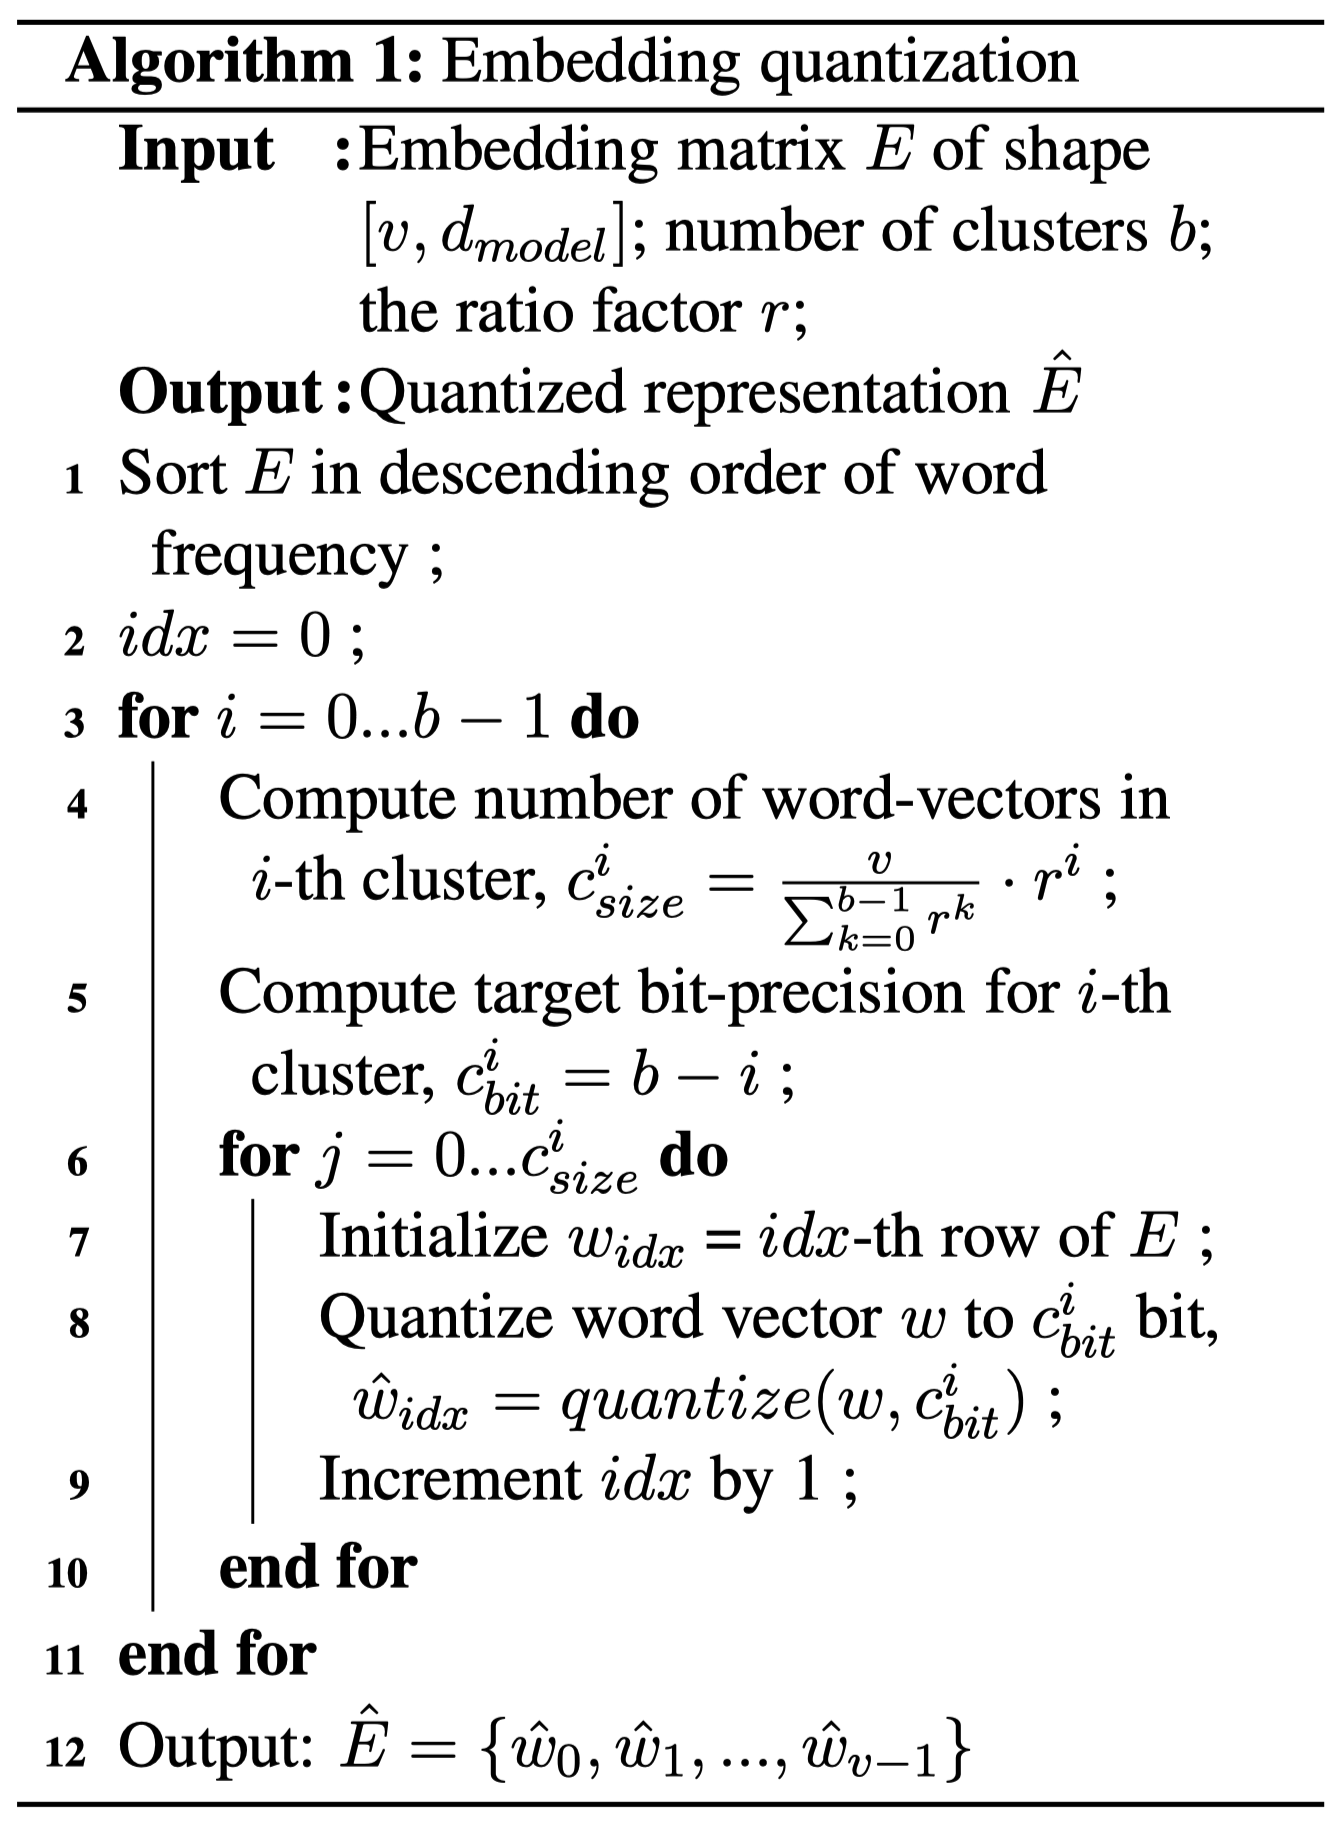
[NLP 논문 리뷰] Extremely Low Bit Transformer Quantization for On-Device ...
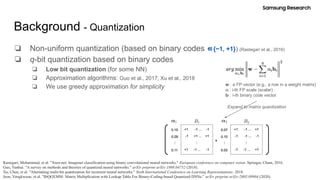
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
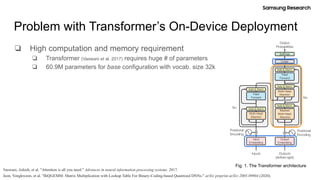
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
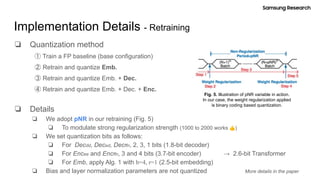
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
Advertisement Space (300x250)
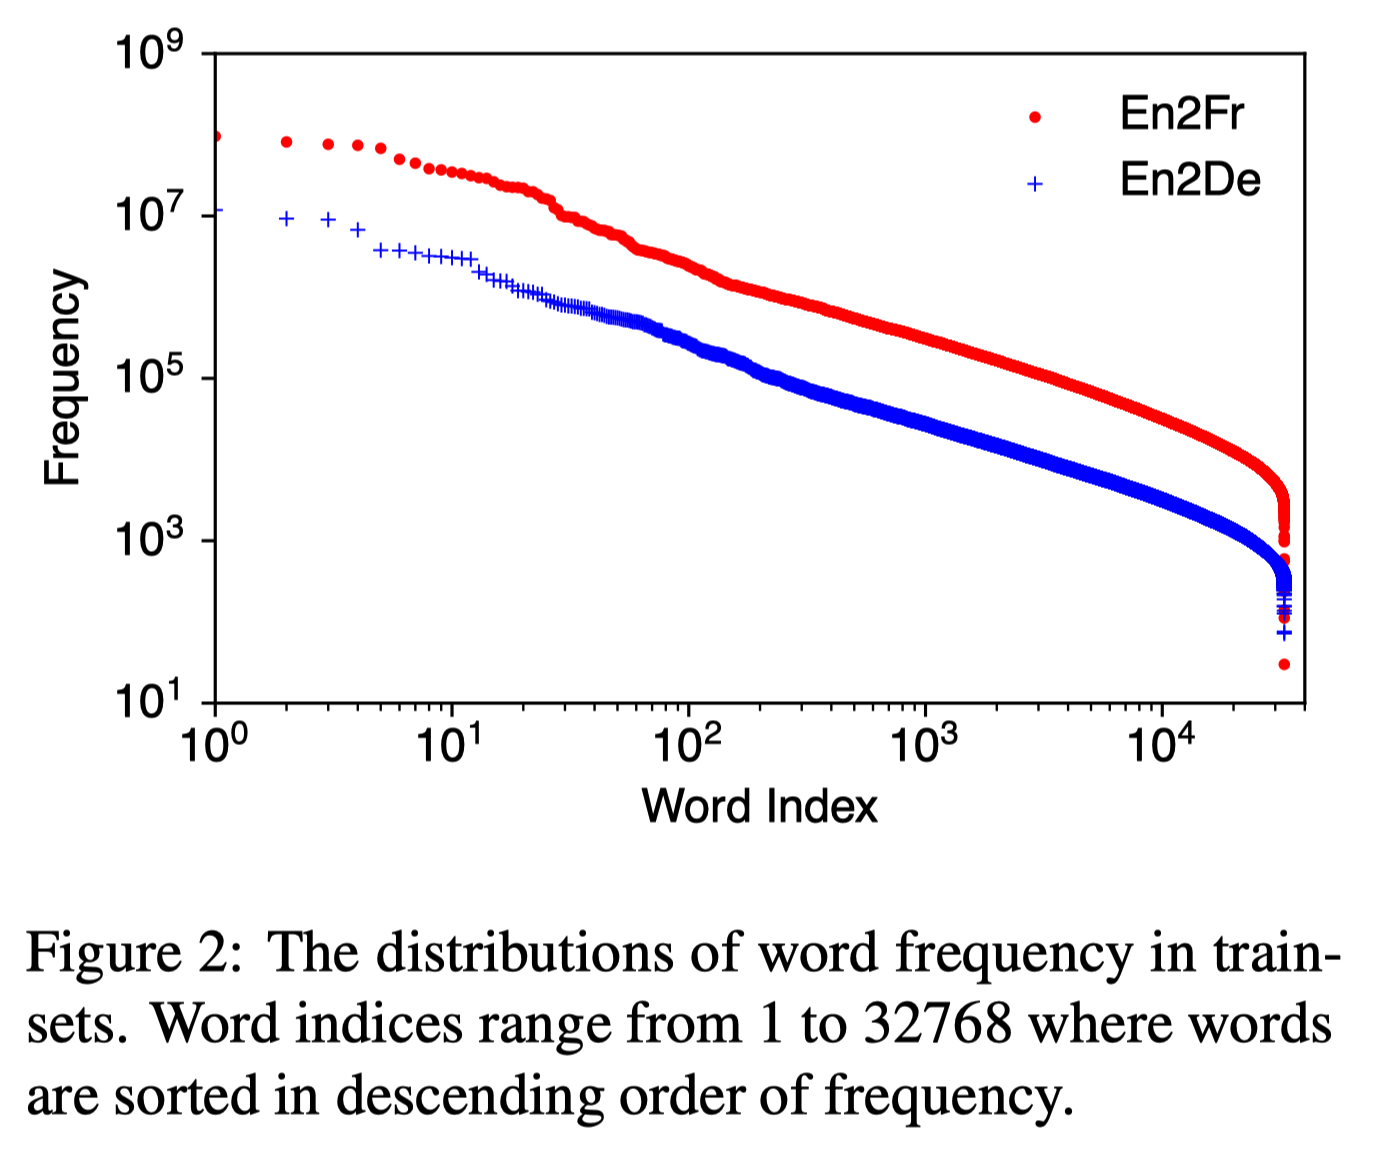
[NLP 논문 리뷰] Extremely Low Bit Transformer Quantization for On-Device ...

[2009.07453] Extremely Low Bit Transformer Quantization for On-Device ...
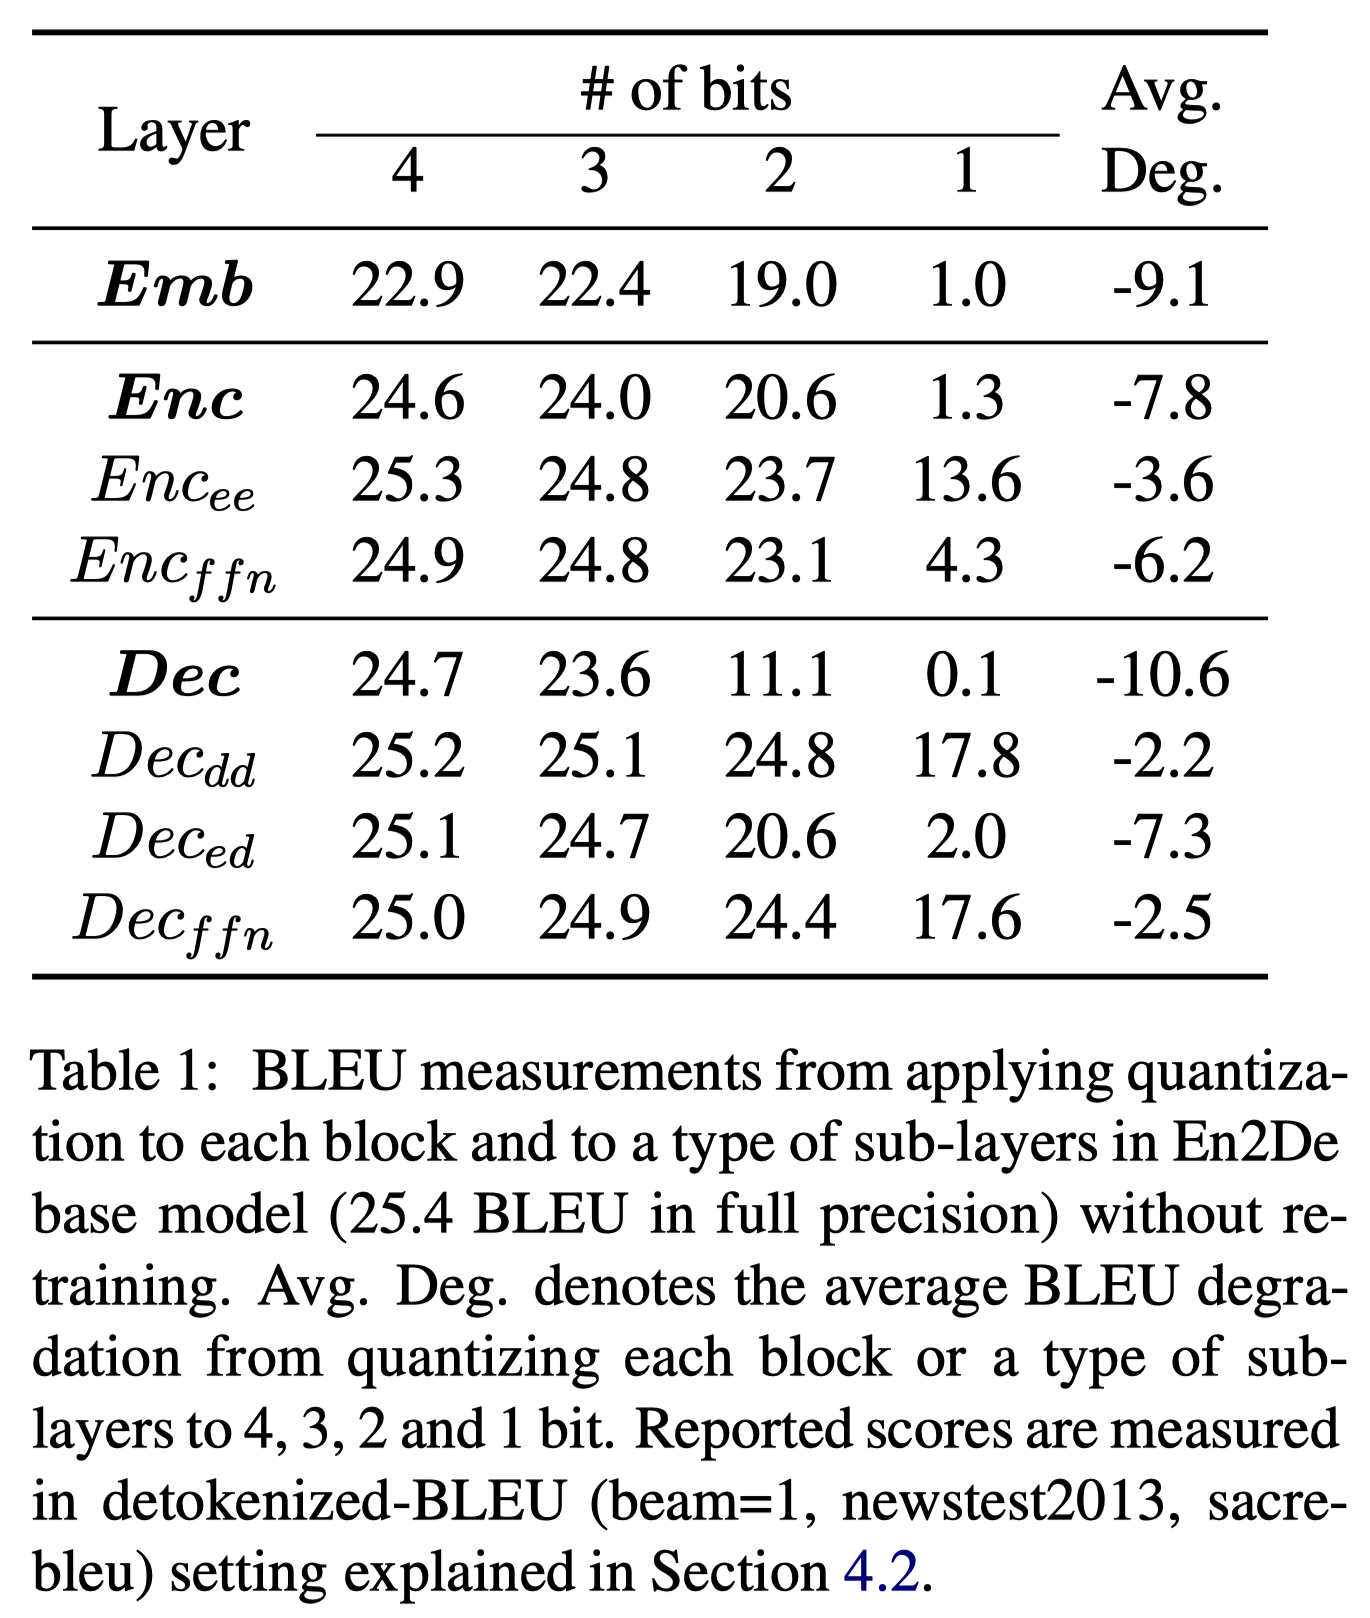
[NLP 논문 리뷰] Extremely Low Bit Transformer Quantization for On-Device ...
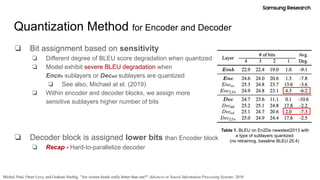
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
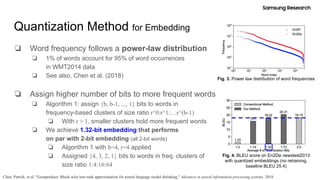
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
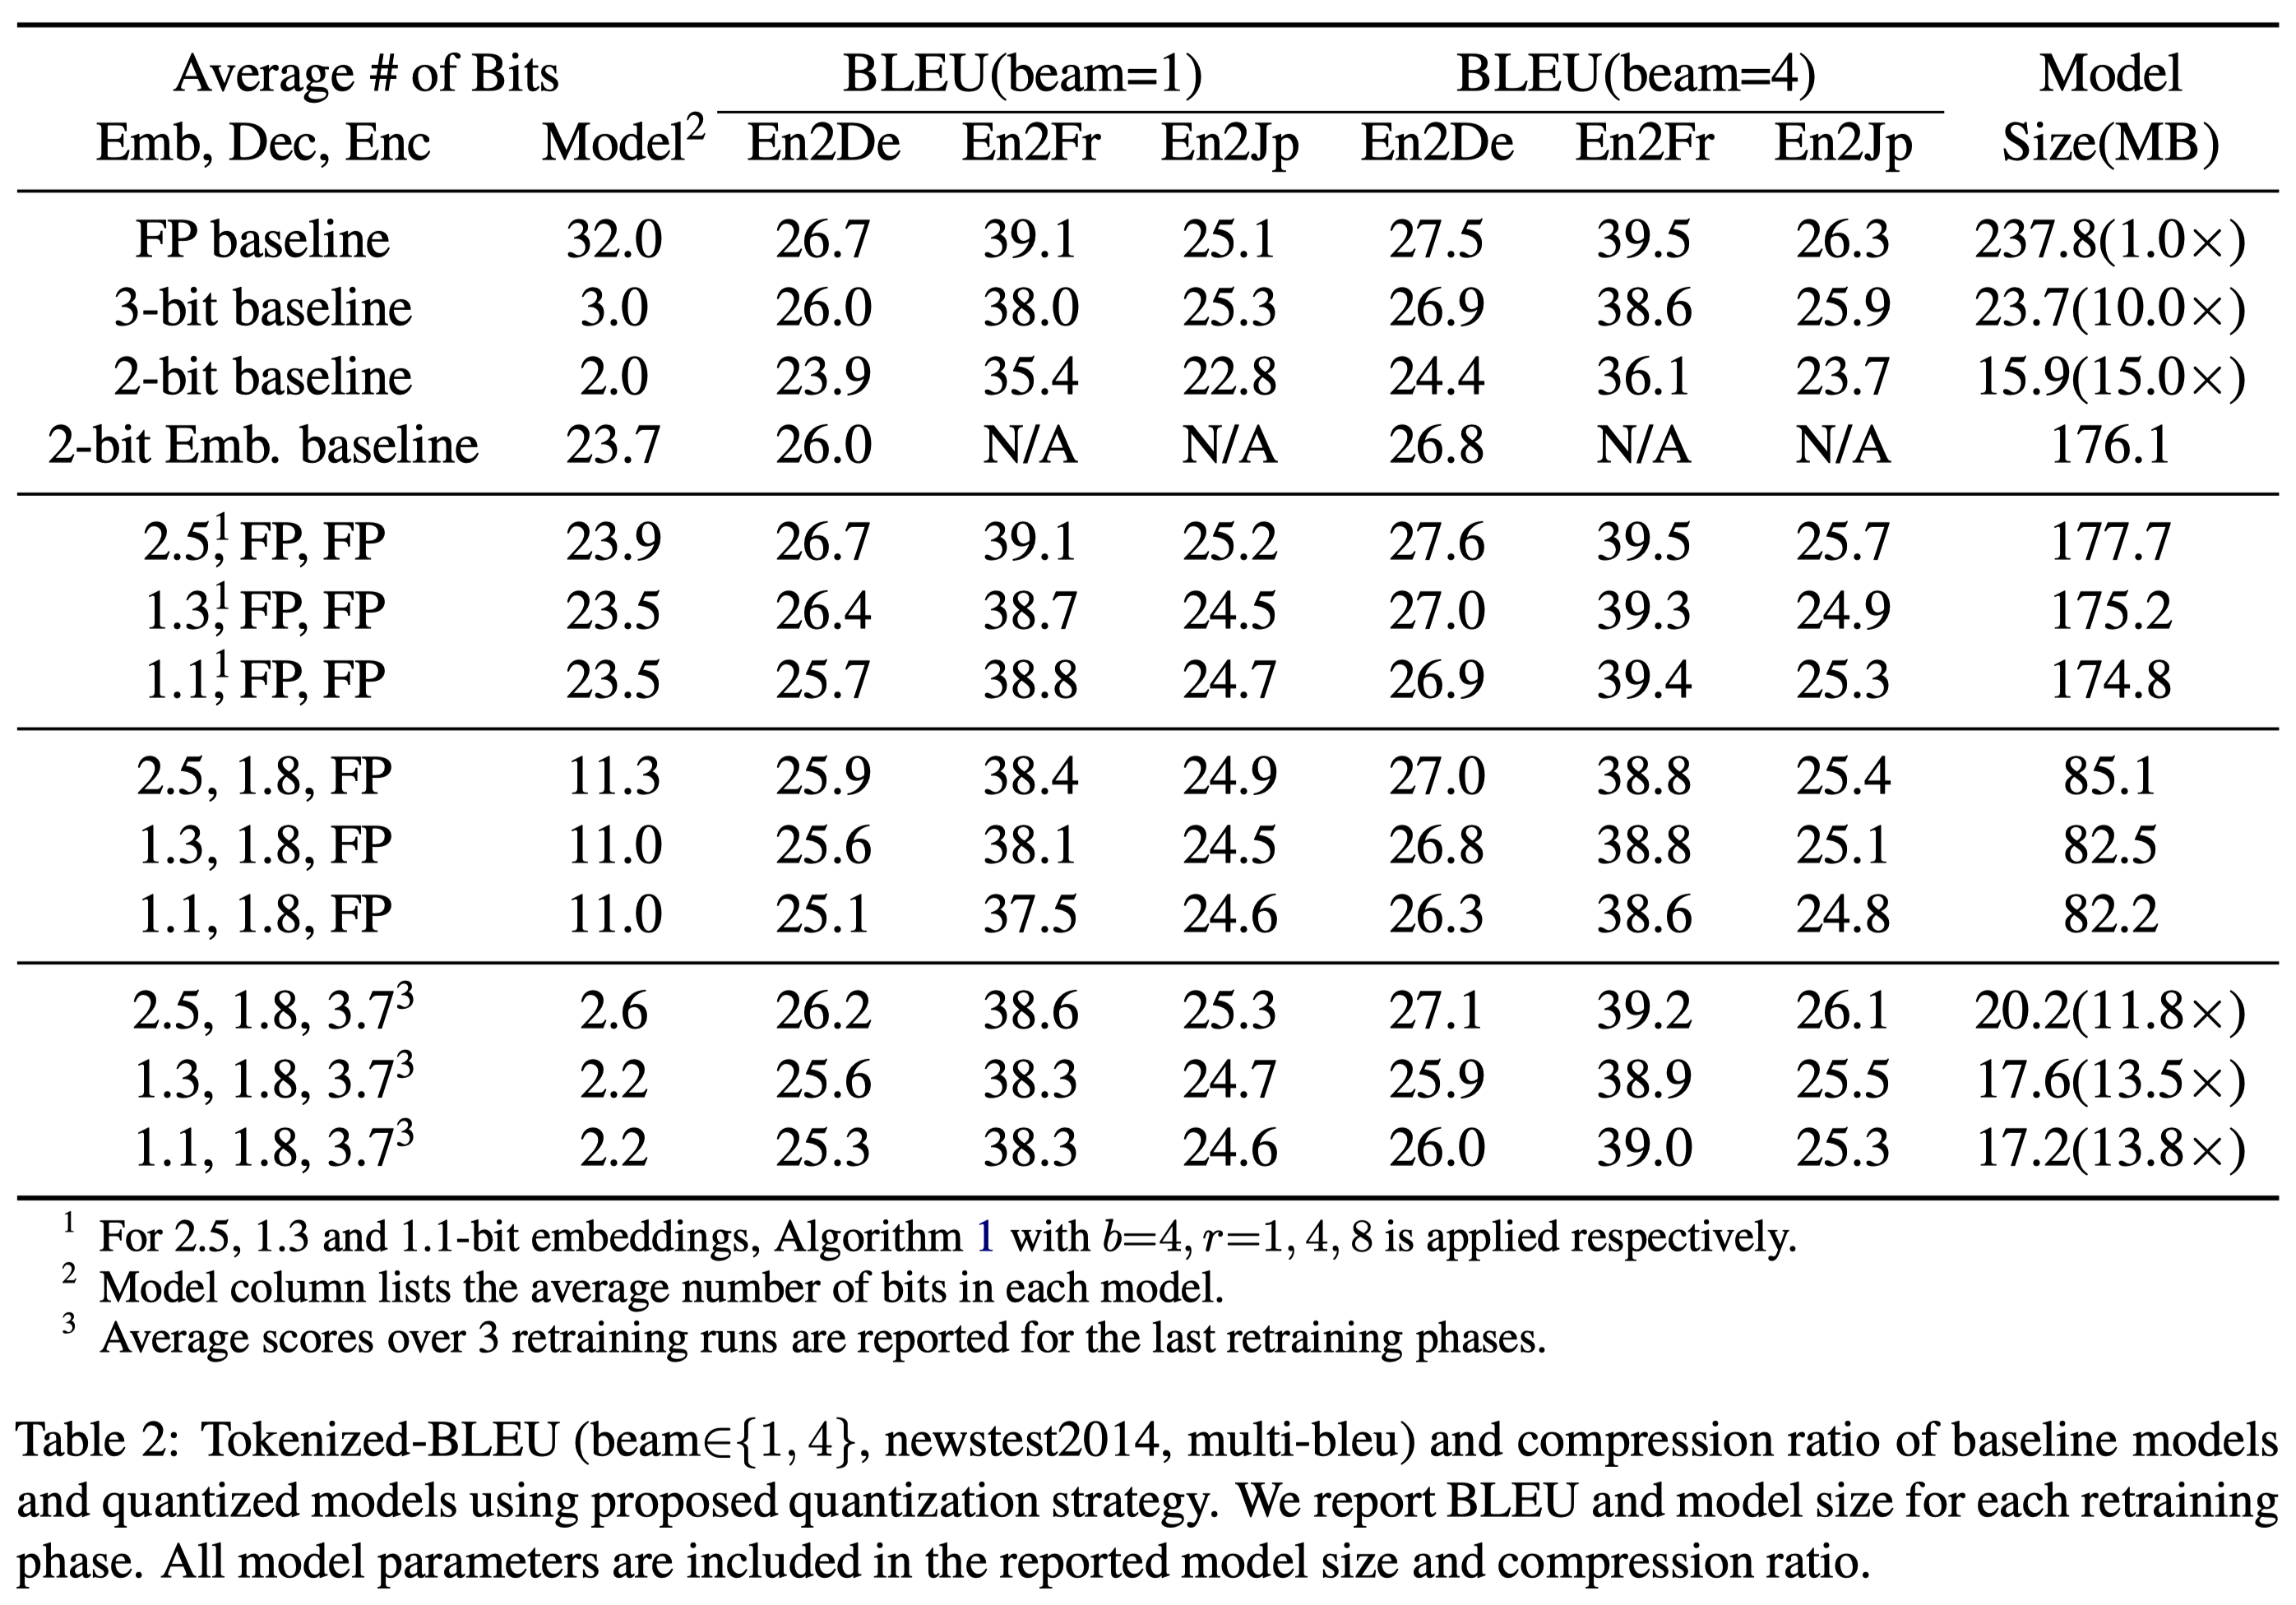
[NLP 논문 리뷰] Extremely Low Bit Transformer Quantization for On-Device ...
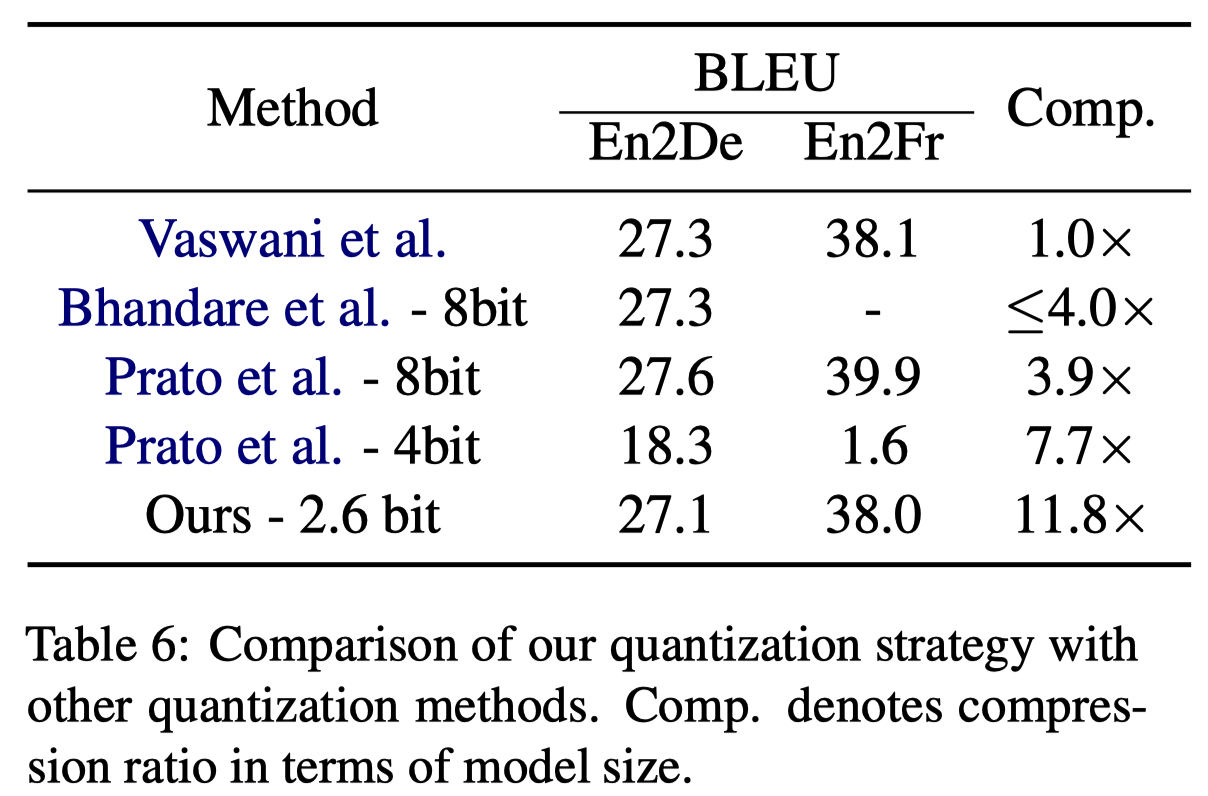
[NLP 논문 리뷰] Extremely Low Bit Transformer Quantization for On-Device ...
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF

[2009.07453] Extremely Low Bit Transformer Quantization for On-Device ...
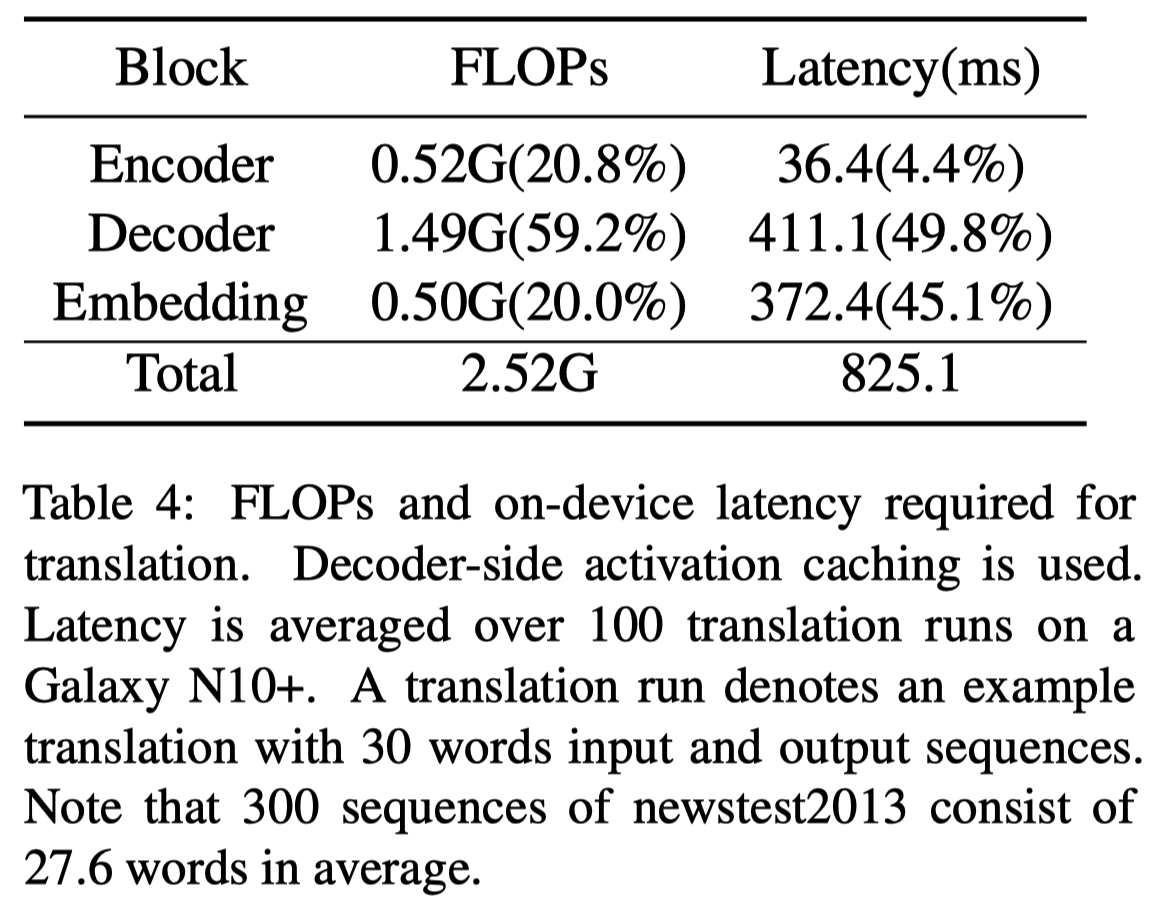
[NLP 논문 리뷰] Extremely Low Bit Transformer Quantization for On-Device ...
Advertisement Space (336x280)
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
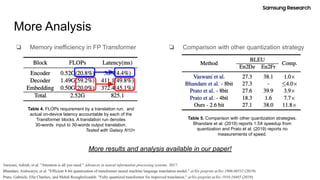
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF
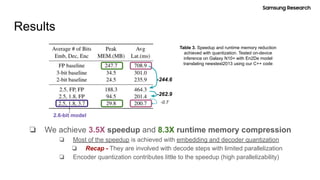
Extremely Low Bit Transformer Quantization for On-Device NMT | PDF

[논문 리뷰] Mixed-Precision Graph Neural Quantization for Low Bit Large ...

Mixed-Precision Graph Neural Quantization for Low Bit Large Language Models

Figure 1 from Residual Quantization for Low Bit-Width Neural Networks ...
Optimization of Linear Quantization for General and Effective Low Bit ...

Efficient 8-Bit Quantization of Transformer Neural Machine Language ...
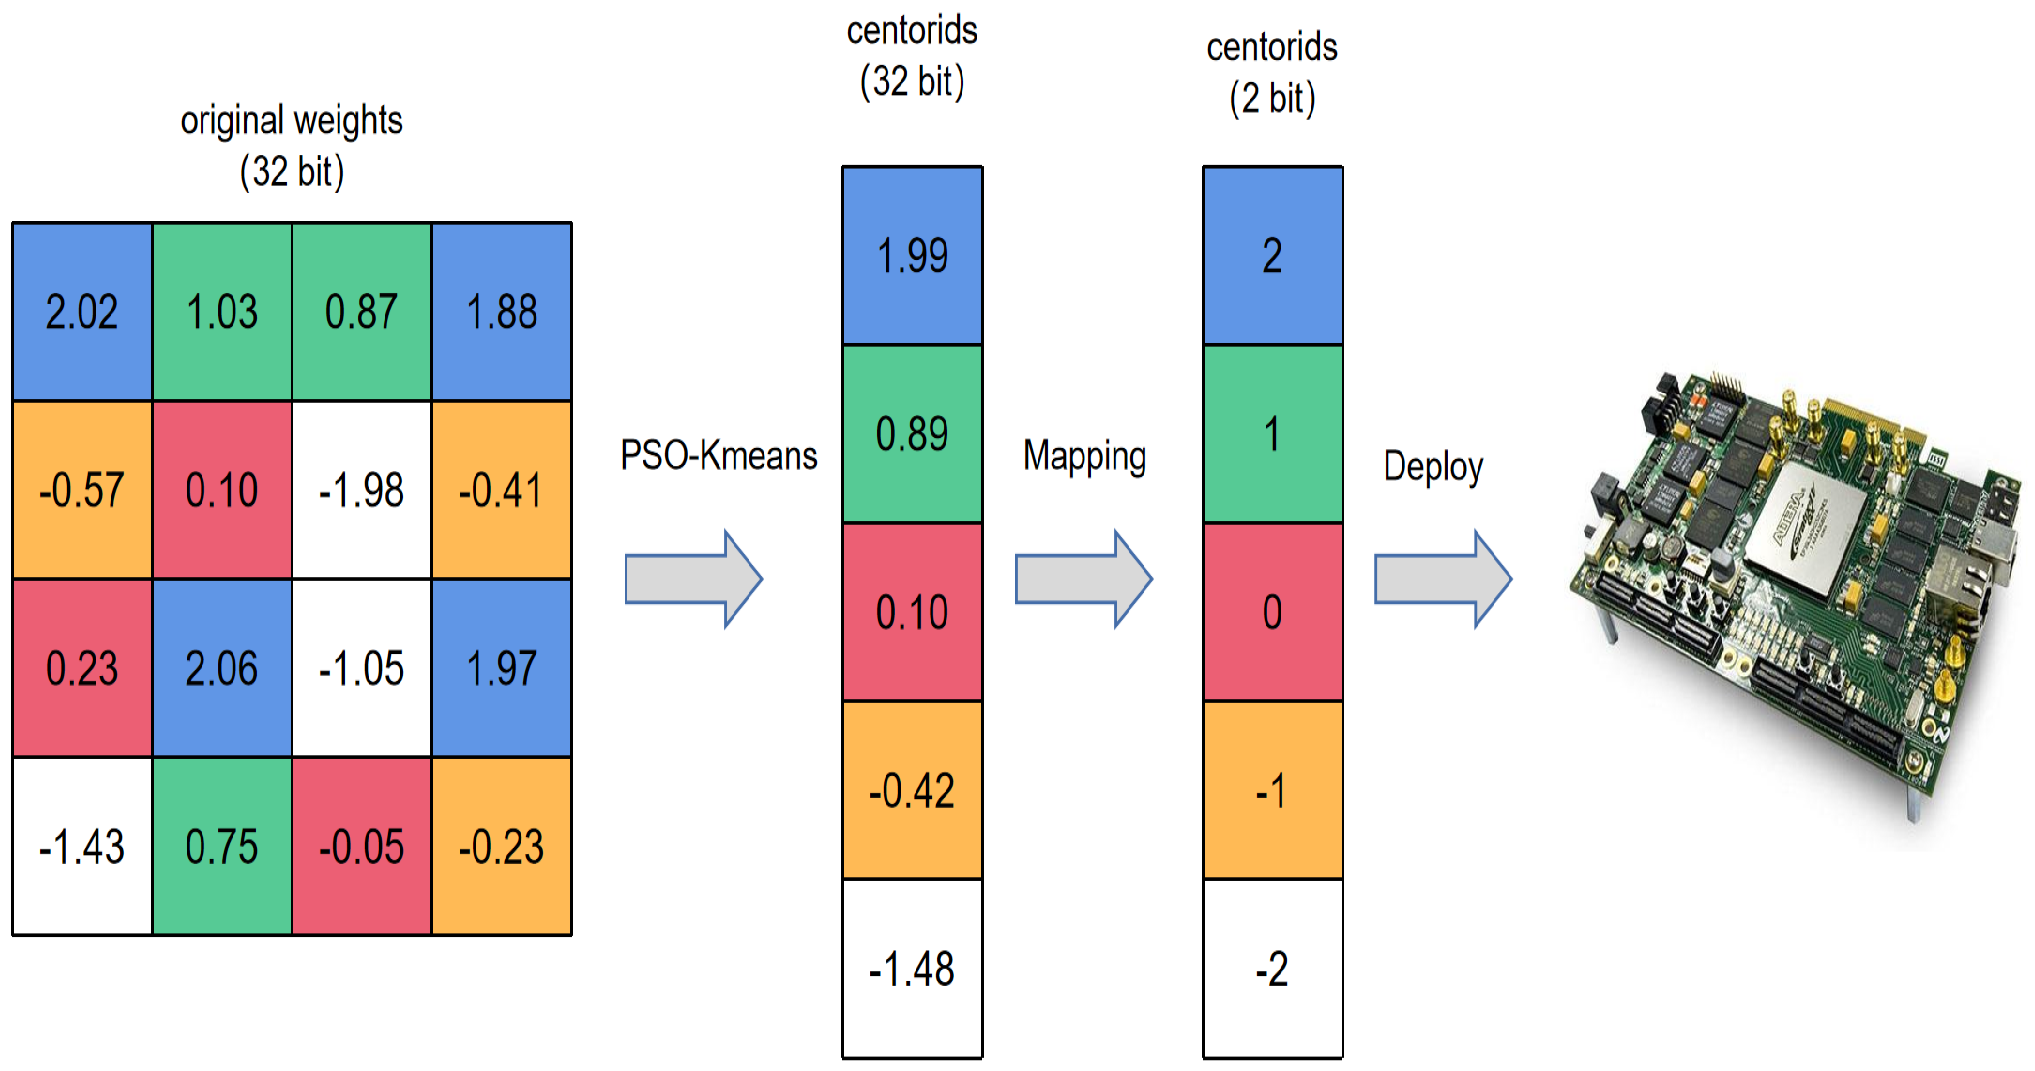
Optimization of Linear Quantization for General and Effective Low Bit ...
Advertisement Space (336x280)
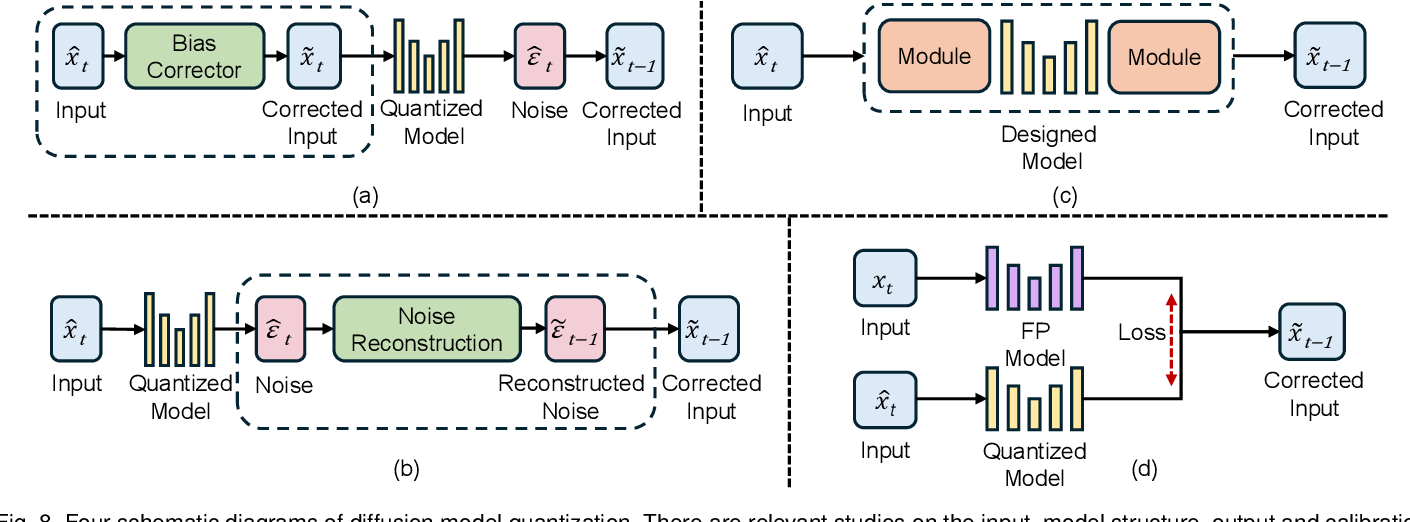
Figure 8 from Low-bit Model Quantization for Deep Neural Networks: A ...
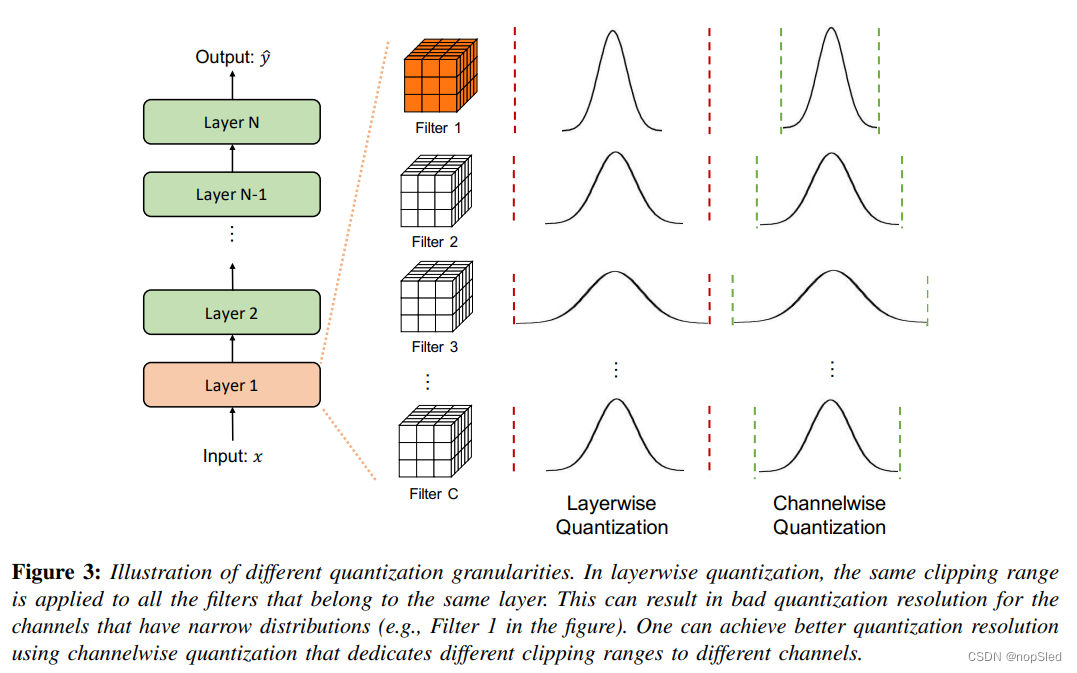
A Survey of Quantization Methods for Efficient Neural Network Inference ...
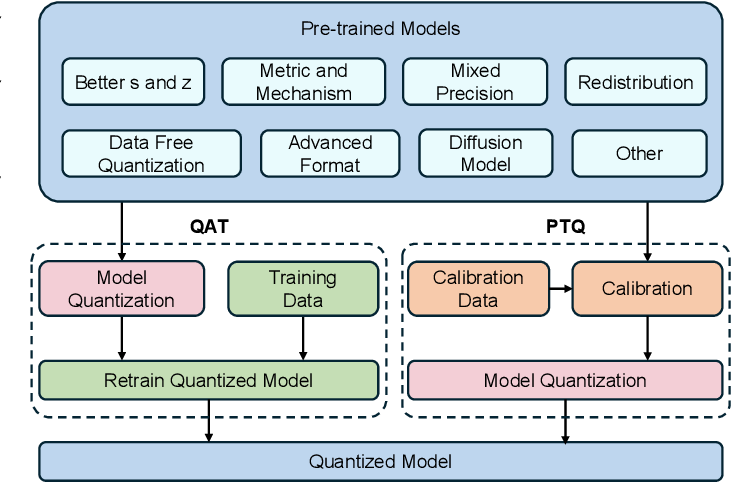
Figure 2 from Low-bit Model Quantization for Deep Neural Networks: A ...

Low-bit Model Quantization for Deep Neural Networks: A Survey | AI ...

tinyML Asia 2021 Dongsoo Lee: Extremely low-bit quantization for ...
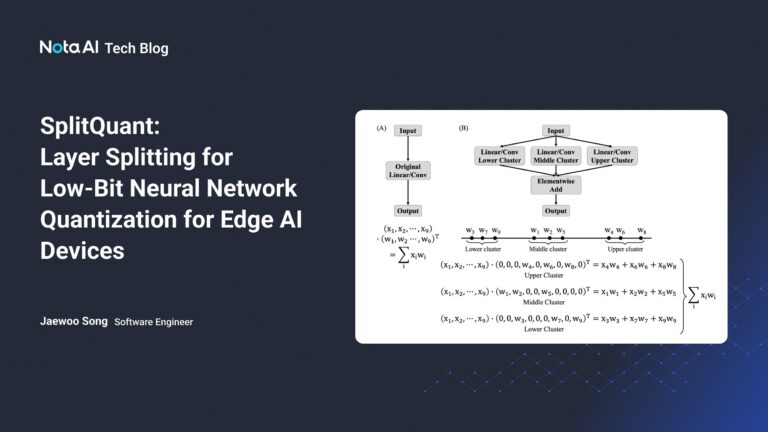
SplitQuant: Layer Splitting for Low-bit Neural Network Quantization for ...