
Figure 1 From A Data Efficient Vision Transformer For Robust Human

Figure 1 from A Data Efficient Vision Transformer for Robust Human ...

Figure 3 from A Data Efficient Vision Transformer for Robust Human ...

Figure 2 from A Data Efficient Vision Transformer for Robust Human ...

Figure 4 from A Data Efficient Vision Transformer for Robust Human ...

Table I from A Data Efficient Vision Transformer for Robust Human ...
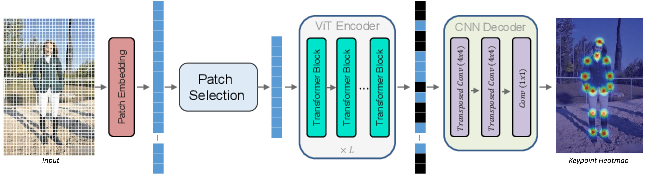
Figure 1 from Efficient Vision Transformer for Human Pose Estimation ...
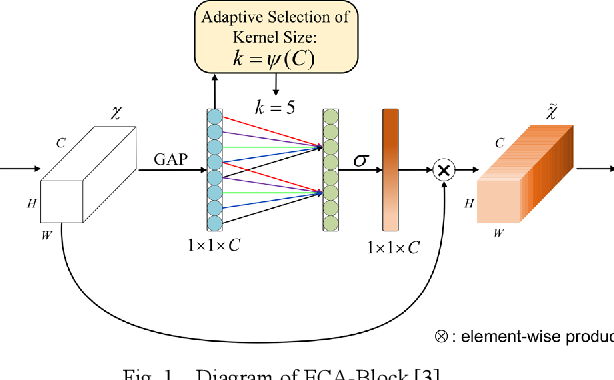
Figure 1 from Data & Channel Efficient Vision Transformer | Semantic ...
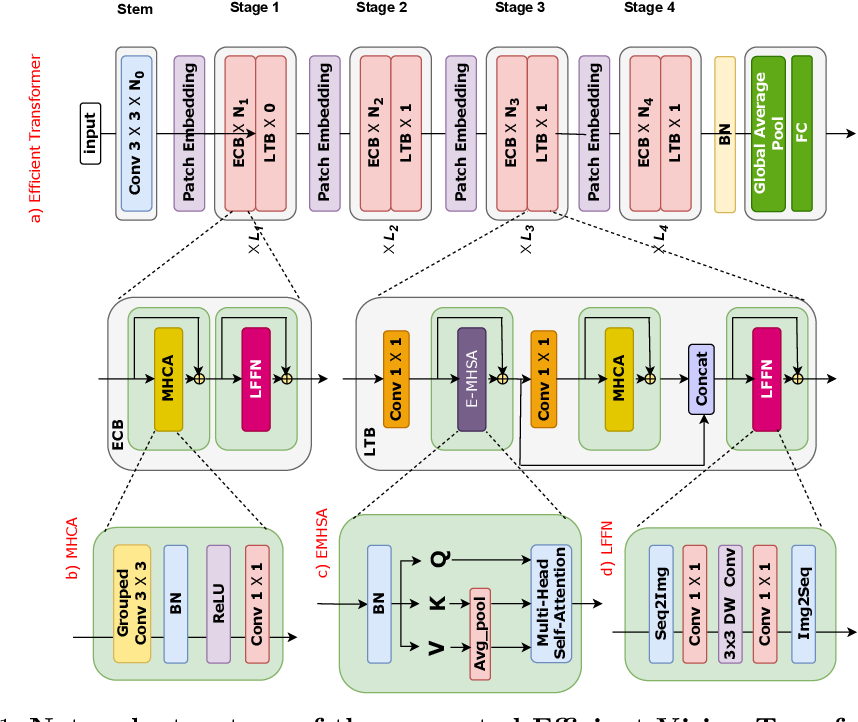
Figure 1 from Efficient Vision Transformer for Accurate Traffic Sign ...

Figure 2 from A Hybrid Visual Transformer for Efficient Deep Human ...

Figure 1 from A Lightweight Convolution and Vision Transformer ...
Advertisement Space (300x250)

Figure 1 from Vision Transformers for Robust Analysis of Satellite ...

Figure 1 from Dynamic Spatial Sparsification for Efficient Vision ...

Figure 1 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 2 from Efficient Vision Transformer for Human-Centric AIoT ...
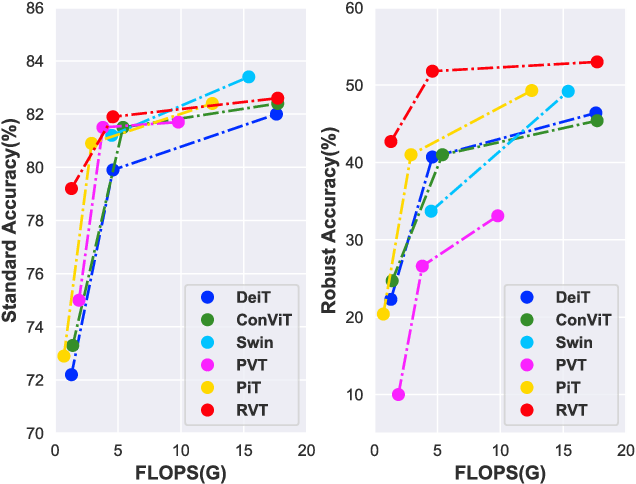
Figure 1 from Towards Robust Vision Transformer | Semantic Scholar

Figure 1 from A Survey on Efficient Vision Transformers: Algorithms ...

Figure 1 from Evaluating Vision Transformer Methods for Deep ...
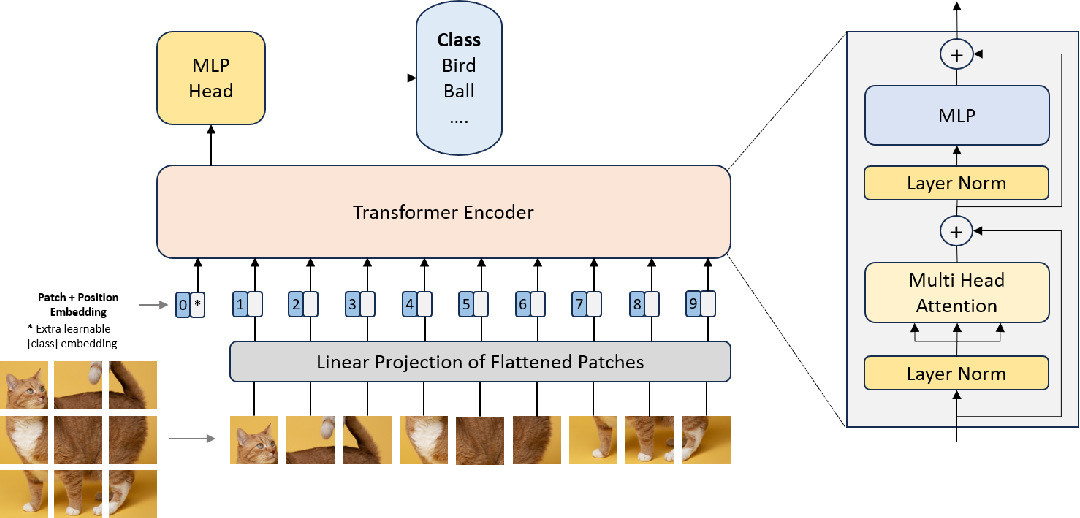
Figure 1 from Sparse then Prune: Toward Efficient Vision Transformers ...

Figure 1 from Efficiency 360: Efficient Vision Transformers | Semantic ...

Figure 1 from Predicting Token Impact Towards Efficient Vision ...
Advertisement Space (336x280)

Table I from Efficient Vision Transformer for Human-Centric AIoT ...

MedViT: A Robust Vision Transformer for Generalized Medical Image ...

Figure 2 from A Survey on Efficient Vision Transformers: Algorithms ...
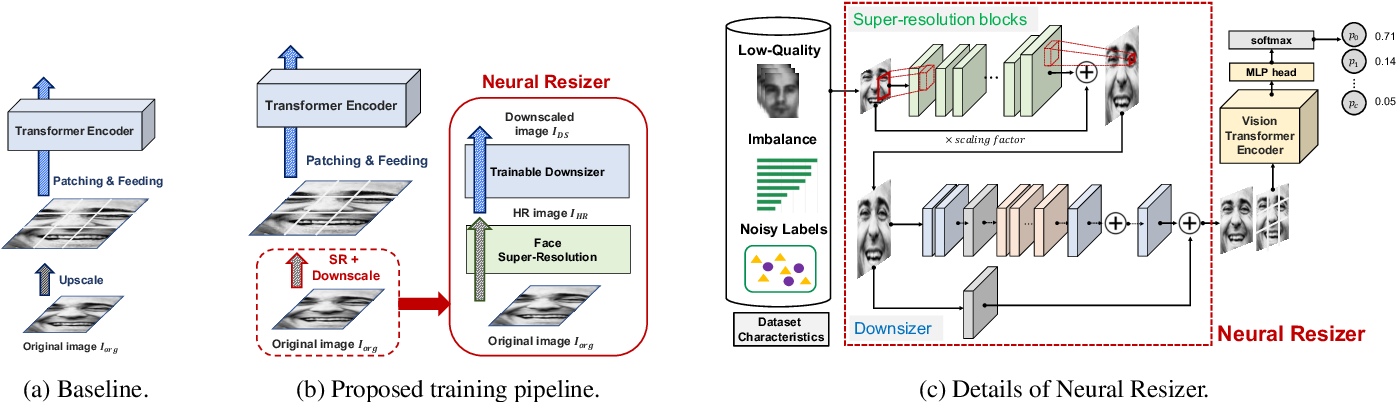
Figure 1 from Vision Transformer Equipped With Neural Resizer On Facial ...

Figure 1 from Learning Efficient Vision Transformers via Fine-Grained ...

Figure 1 from DualToken-ViT: Position-aware Efficient Vision ...
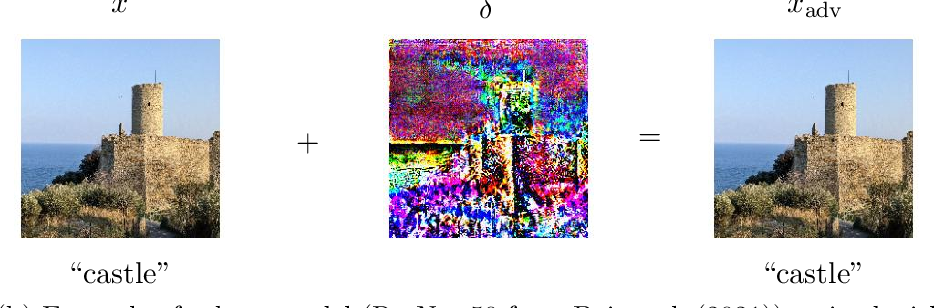
Figure 1 from Adversarially Robust Vision Transformers | Semantic Scholar
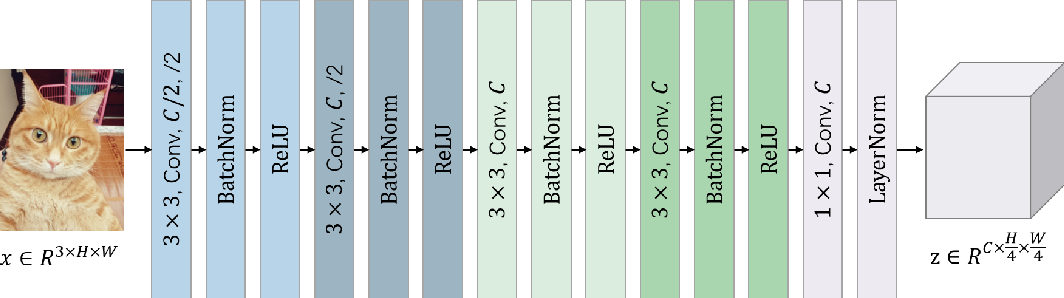
Figure I from Orthogonal Transformer: An Efficient Vision Transformer ...

Figure 2 from Dynamic Spatial Sparsification for Efficient Vision ...

Figure 1 from DiffRate : Differentiable Compression Rate for Efficient ...
Advertisement Space (336x280)

(PDF) MedViT: A Robust Vision Transformer for Generalized Medical Image ...

Vision Transformer and Deep Sequence Learning for Human Activity ...

CVPR2023 Making Vision Transformers Efficient from A Token ...

Figure 1 from Low-Bit Integerization of Vision Transformers Using ...

(PDF) Data-Efficient Vision Transformer Models for Robust ...

Efficient Vision Transformer YOLOv5 for Accurate and Fast Traffic Sign ...