
Table I From A Data Efficient Vision Transformer For Robust Human

Table I from A Data Efficient Vision Transformer for Robust Human ...
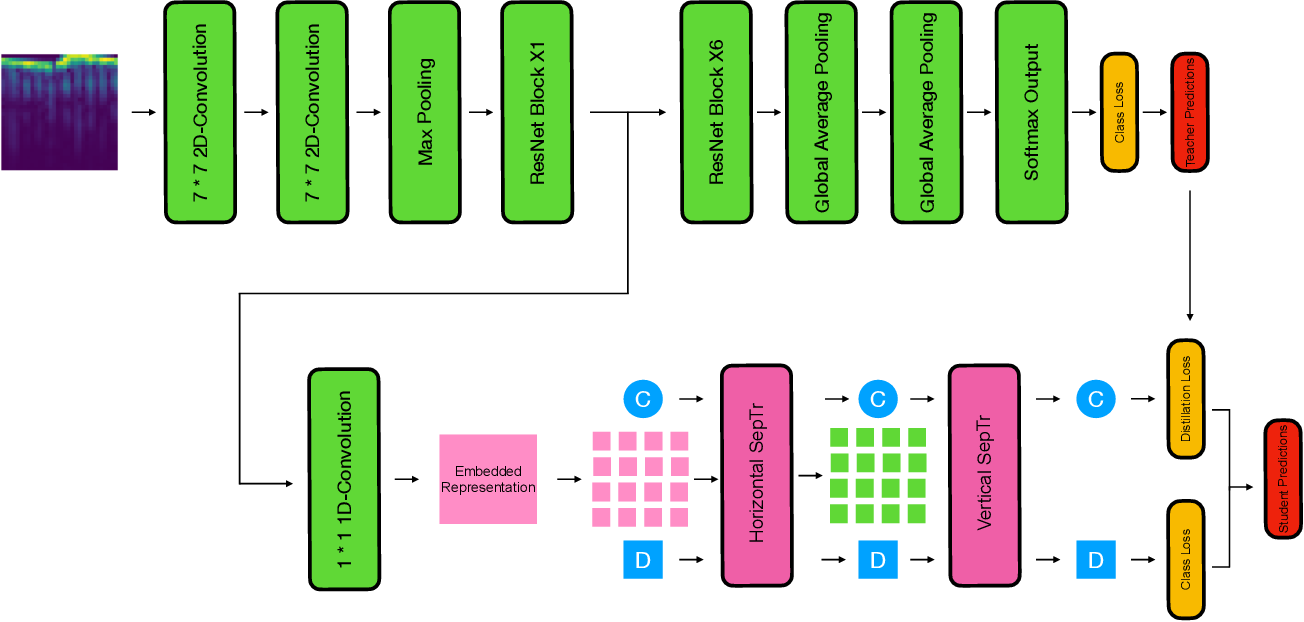
Figure 3 from A Data Efficient Vision Transformer for Robust Human ...

Figure 4 from A Data Efficient Vision Transformer for Robust Human ...
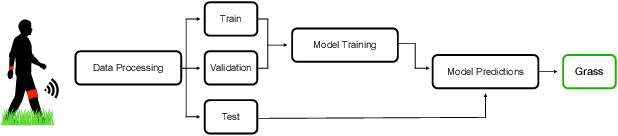
Figure 1 from A Data Efficient Vision Transformer for Robust Human ...

Figure 2 from A Data Efficient Vision Transformer for Robust Human ...

Table I from Efficient Vision Transformer for Human-Centric AIoT ...

Table 1 from Efficient Vision Transformer for Human Pose Estimation via ...
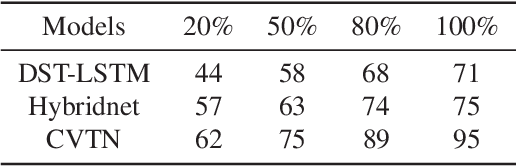
Table 1 from A Hybrid Visual Transformer for Efficient Deep Human ...
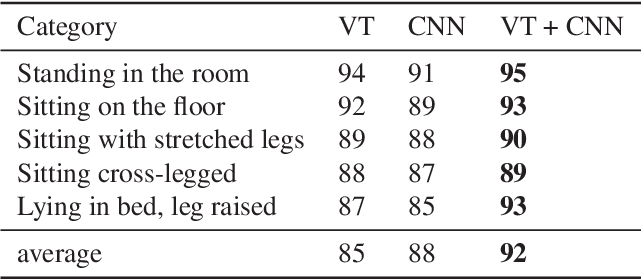
Table 2 from A Hybrid Visual Transformer for Efficient Deep Human ...

Table VIII from Efficient Vision Transformer for Human-Centric AIoT ...
Advertisement Space (300x250)
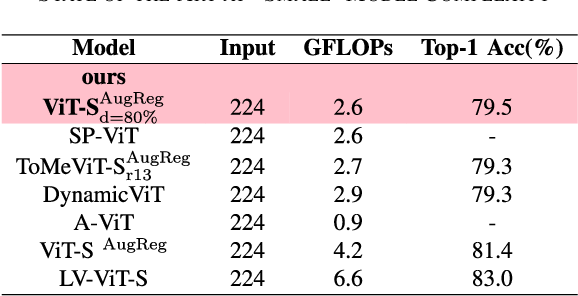
Table V from Efficient Vision Transformer for Human-Centric AIoT ...

Table VI from Efficient Vision Transformer for Human-Centric AIoT ...

Table I from Distilling Efficient Vision Transformers from CNNs for ...
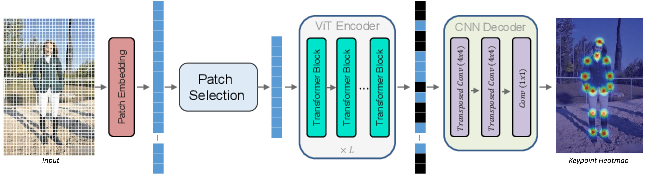
Figure 1 from Efficient Vision Transformer for Human Pose Estimation ...
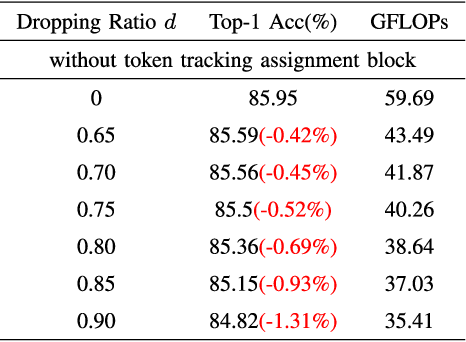
Table IV from Efficient Vision Transformer for Human-Centric AIoT ...

Figure 2 from A Hybrid Visual Transformer for Efficient Deep Human ...
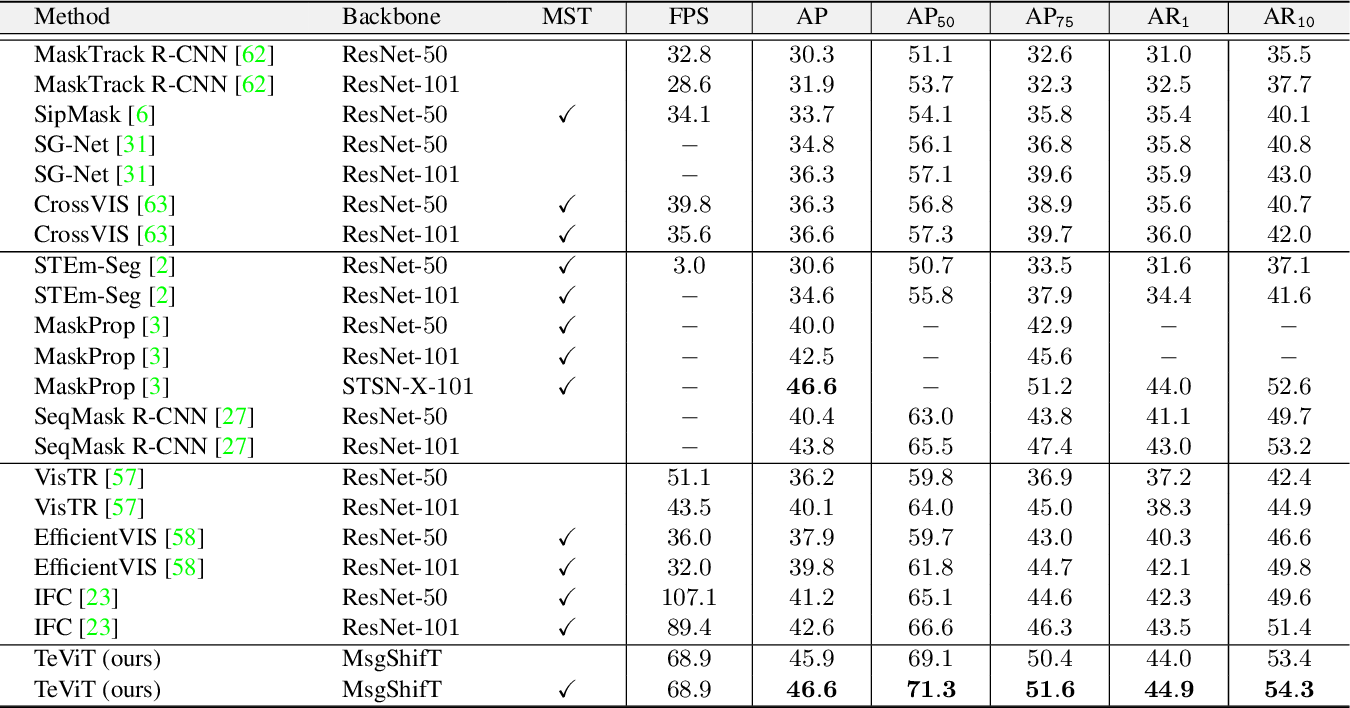
Table 1 from Temporally Efficient Vision Transformer for Video Instance ...

Table I from Efficient Vision Transformers Optimized with Pruning and ...
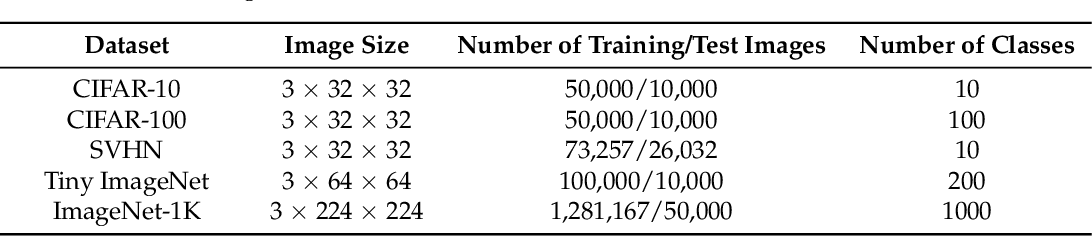
Table 1 from EEViT: Efficient Enhanced Vision Transformer Architectures ...
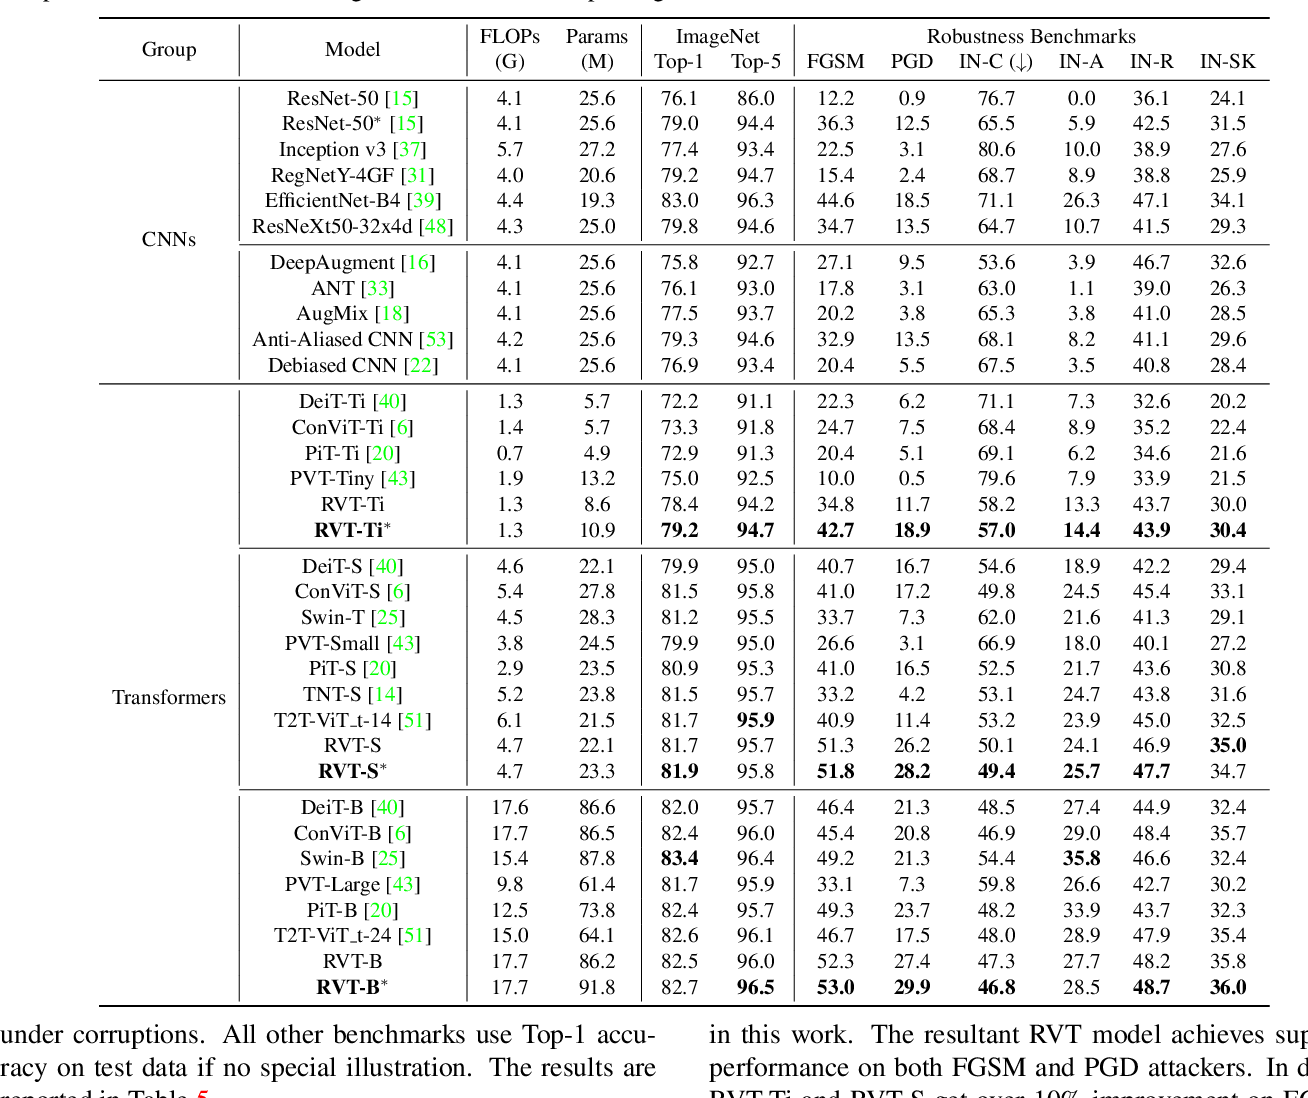
Table 5 from Towards Robust Vision Transformer | Semantic Scholar
Advertisement Space (336x280)

Figure 2 from Efficient Vision Transformer for Human-Centric AIoT ...
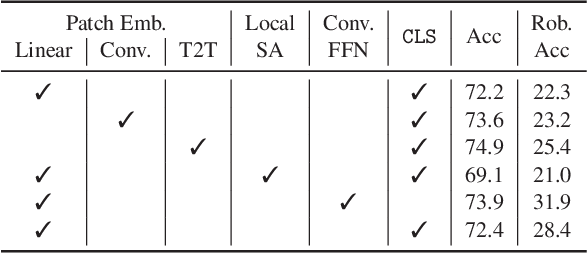
Table 2 from Towards Robust Vision Transformer | Semantic Scholar

Figure 4 from Efficient Vision Transformer for Human-Centric AIoT ...

Efficient Vision Transformer for Human Pose Estimation via Patch Selection
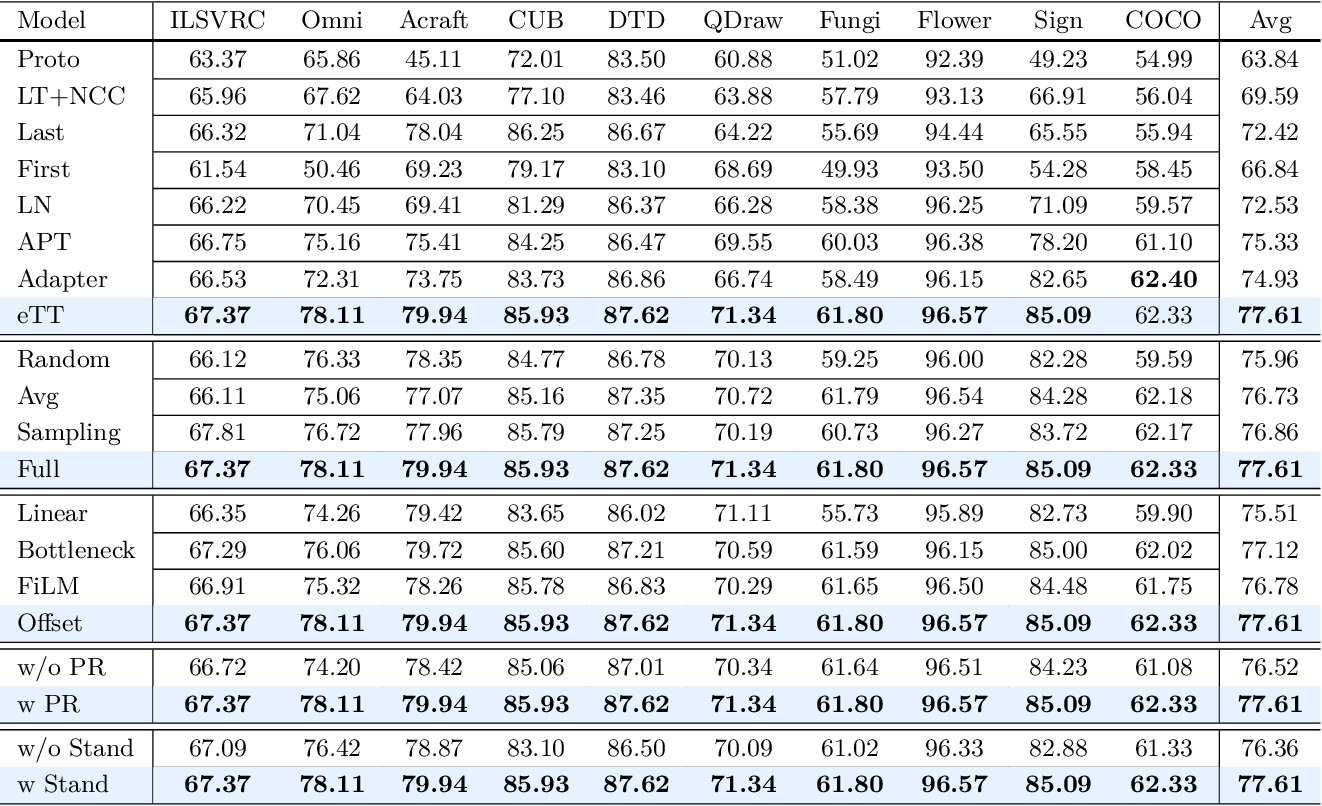
Table 3 from Exploring Efficient Few-shot Adaptation for Vision ...
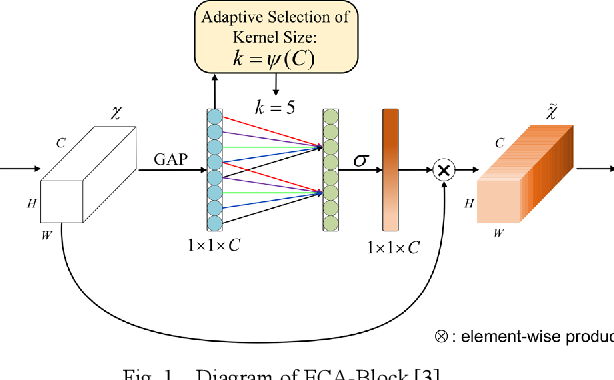
Figure 1 from Data & Channel Efficient Vision Transformer | Semantic ...
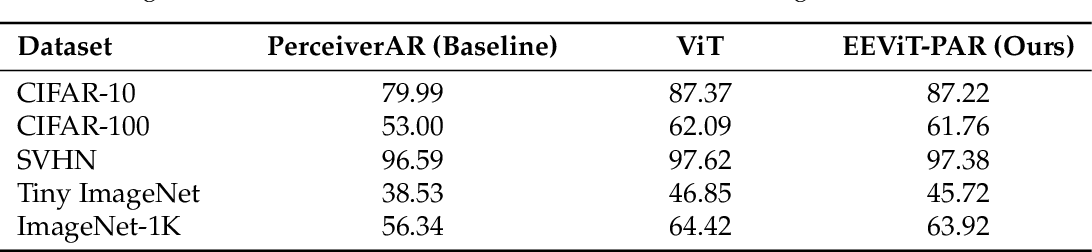
Table 3 from EEViT: Efficient Enhanced Vision Transformer Architectures ...

Table 1 from Dynamic Spatial Sparsification for Efficient Vision ...

Figure 4 from Efficient Vision Transformer for Human-Centric AIoT ...

MedViT: A Robust Vision Transformer for Generalized Medical Image ...
Advertisement Space (336x280)
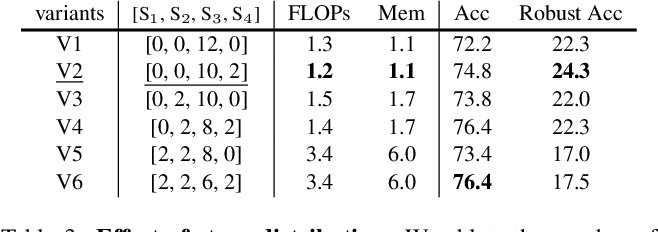
Table 3 from Towards Robust Vision Transformer | Semantic Scholar

Table 1 from A Lightweight Convolution and Vision Transformer ...

Figure 3 from Efficient Vision Transformer for Human-Centric AIoT ...
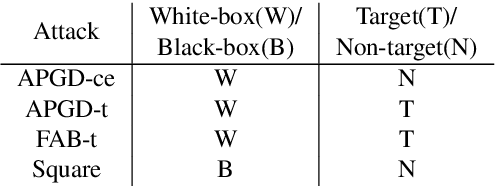
Table 1 from A Random Ensemble of Encrypted Vision Transformers for ...

Table 1 from Predicting Token Impact Towards Efficient Vision ...
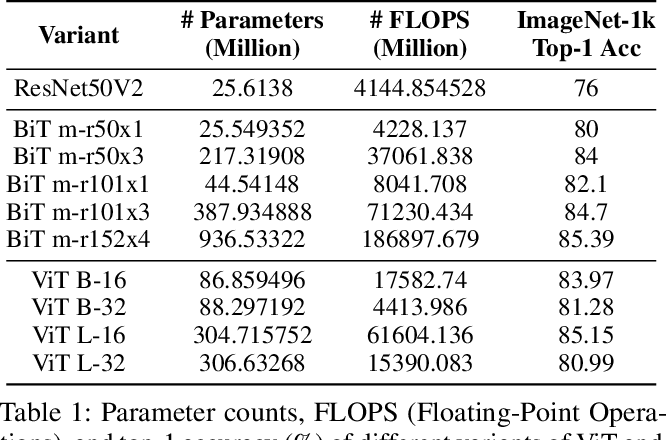
Table 1 from Vision Transformers are Robust Learners | Semantic Scholar