
Figure 1 From A Multi Task Vision Transformer For Segmentation And

Figure 1 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 4 from A Multi-Task Vision Transformer for Segmentation and ...

Table 1 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 3 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 16 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 15 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 1 from MVT: Multi-view Vision Transformer for 3D Object ...
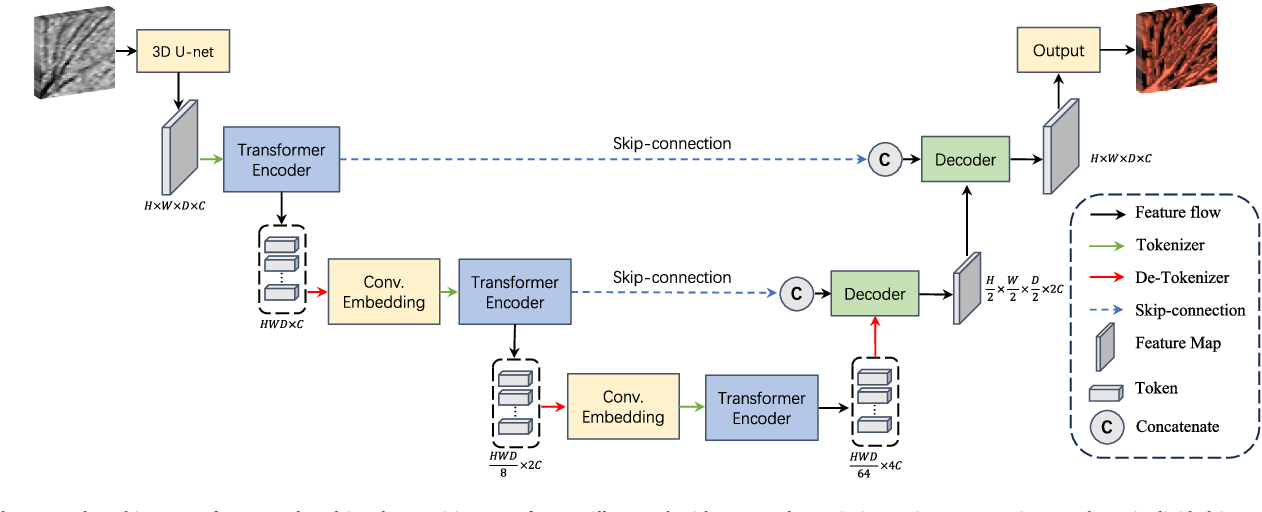
Figure 1 from Multi-scale Knowledge Transfer Vision Transformer for 3D ...

(PDF) A Multi-Task Vision Transformer for Segmentation and Monocular ...

Figure 1 from Adversarial Vision Transformer for Medical Image Semantic ...
Advertisement Space (300x250)
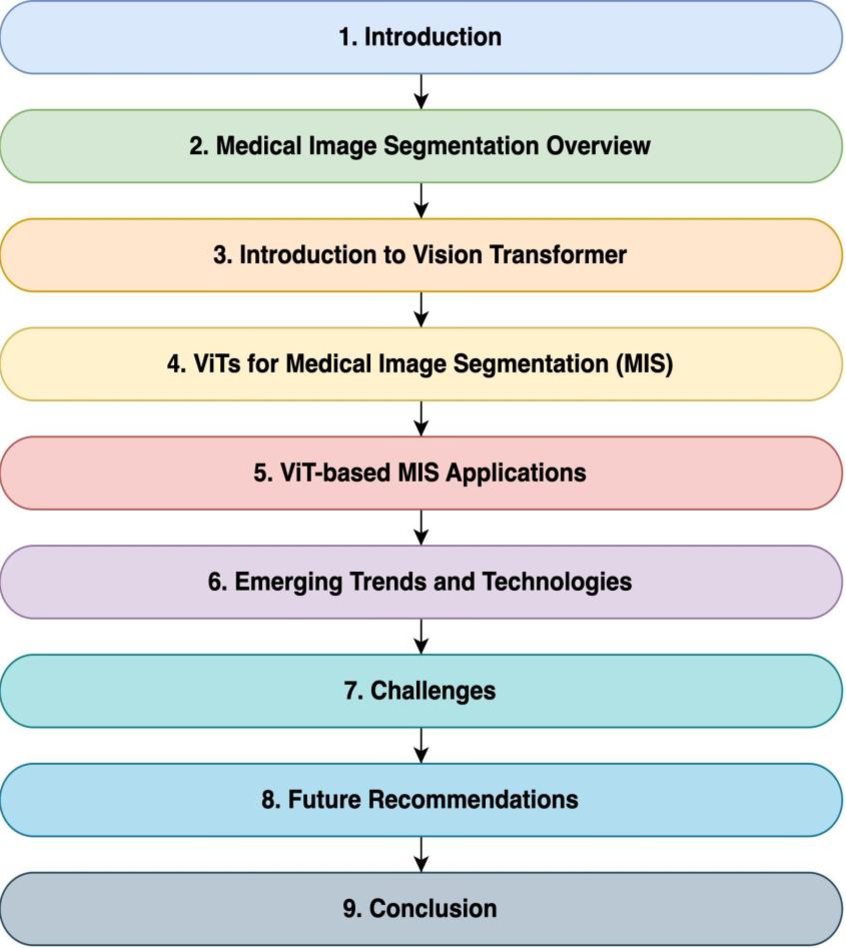
Figure 1 from A Recent Survey of Vision Transformers for Medical Image ...
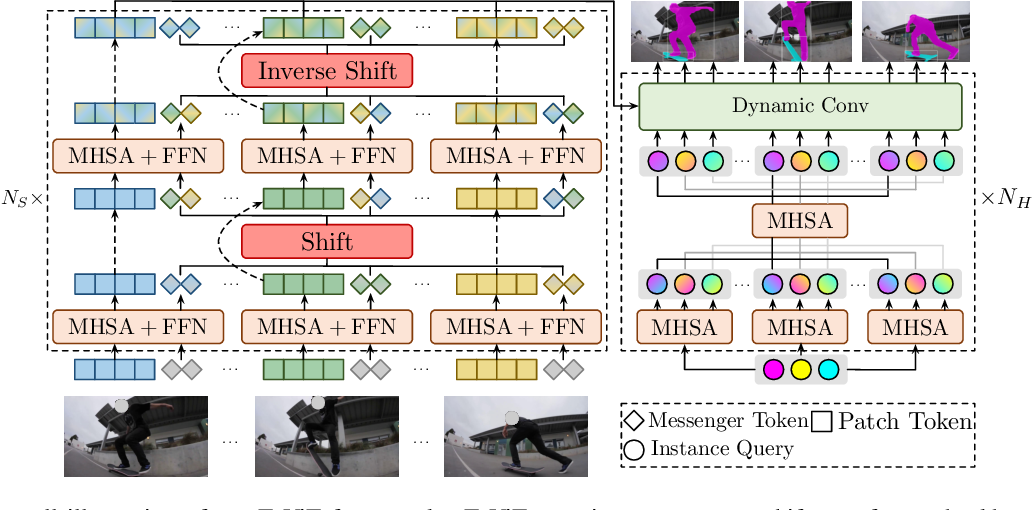
Figure 1 from Temporally Efficient Vision Transformer for Video ...

Figure 1 from Exploring Vision Transformer Layer Choosing for Semantic ...

Figure 1 from MAT-VIT:A Vision Transformer with MAE-Based Self ...
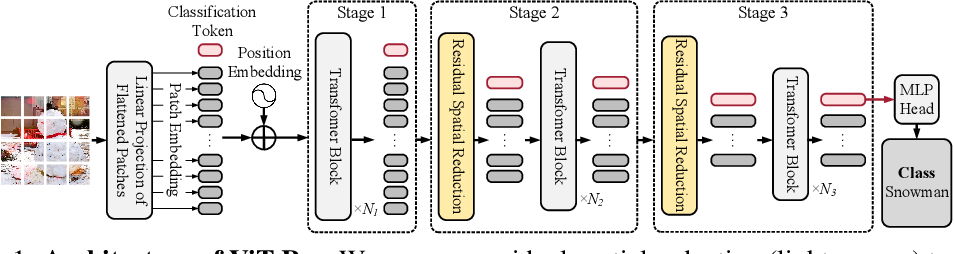
Figure 1 from Searching for Efficient Multi-Stage Vision Transformers ...
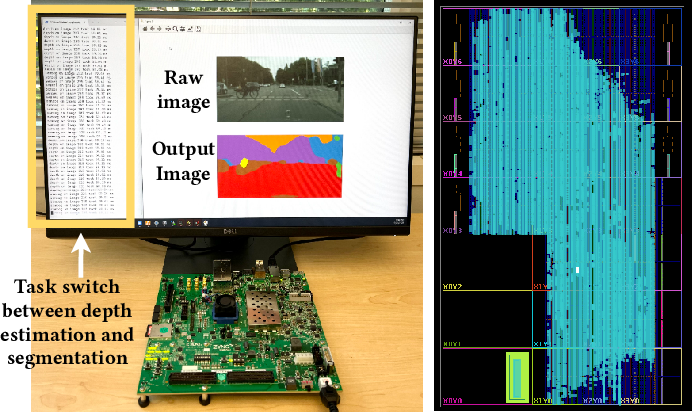
Figure 1 from Edge-MoE: Memory-Efficient Multi-Task Vision Transformer ...

Figure 1 from Multi-Task Distributed Learning Using Vision Transformer ...

Figure 1 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 1 from Multiscale Vision Transformer With Deep Clustering-Guided ...

Figure 1 from Multi-Task Transformer with Relation-Attention and Type ...
Advertisement Space (336x280)
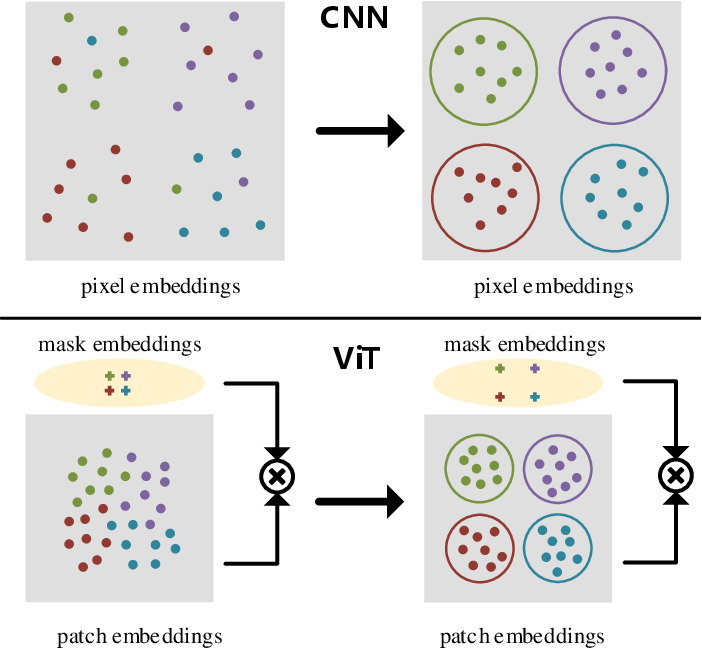
Figure 1 from Representation Separation for Semantic Segmentation with ...

Figure 1 from CellViT: Vision Transformers for Precise Cell ...

Figure 1 from A Transformer-Based Multi-Task Learning Framework for ...

Figure 1 from Cutransnet: Transformers to Make Strong Encoders for ...

A multitask classification framework based on vision transformer for ...

Proposed multi-task Vision Transformer model for diagnosis and severity ...

Figure 1 from Revisiting Audio-Visual Segmentation with Vision-Centric ...

Proposed multi-task Vision Transformer model for diagnosis and severity ...

Figure 1 from Multi-Scale Hybrid Attention Integrated with Vision ...
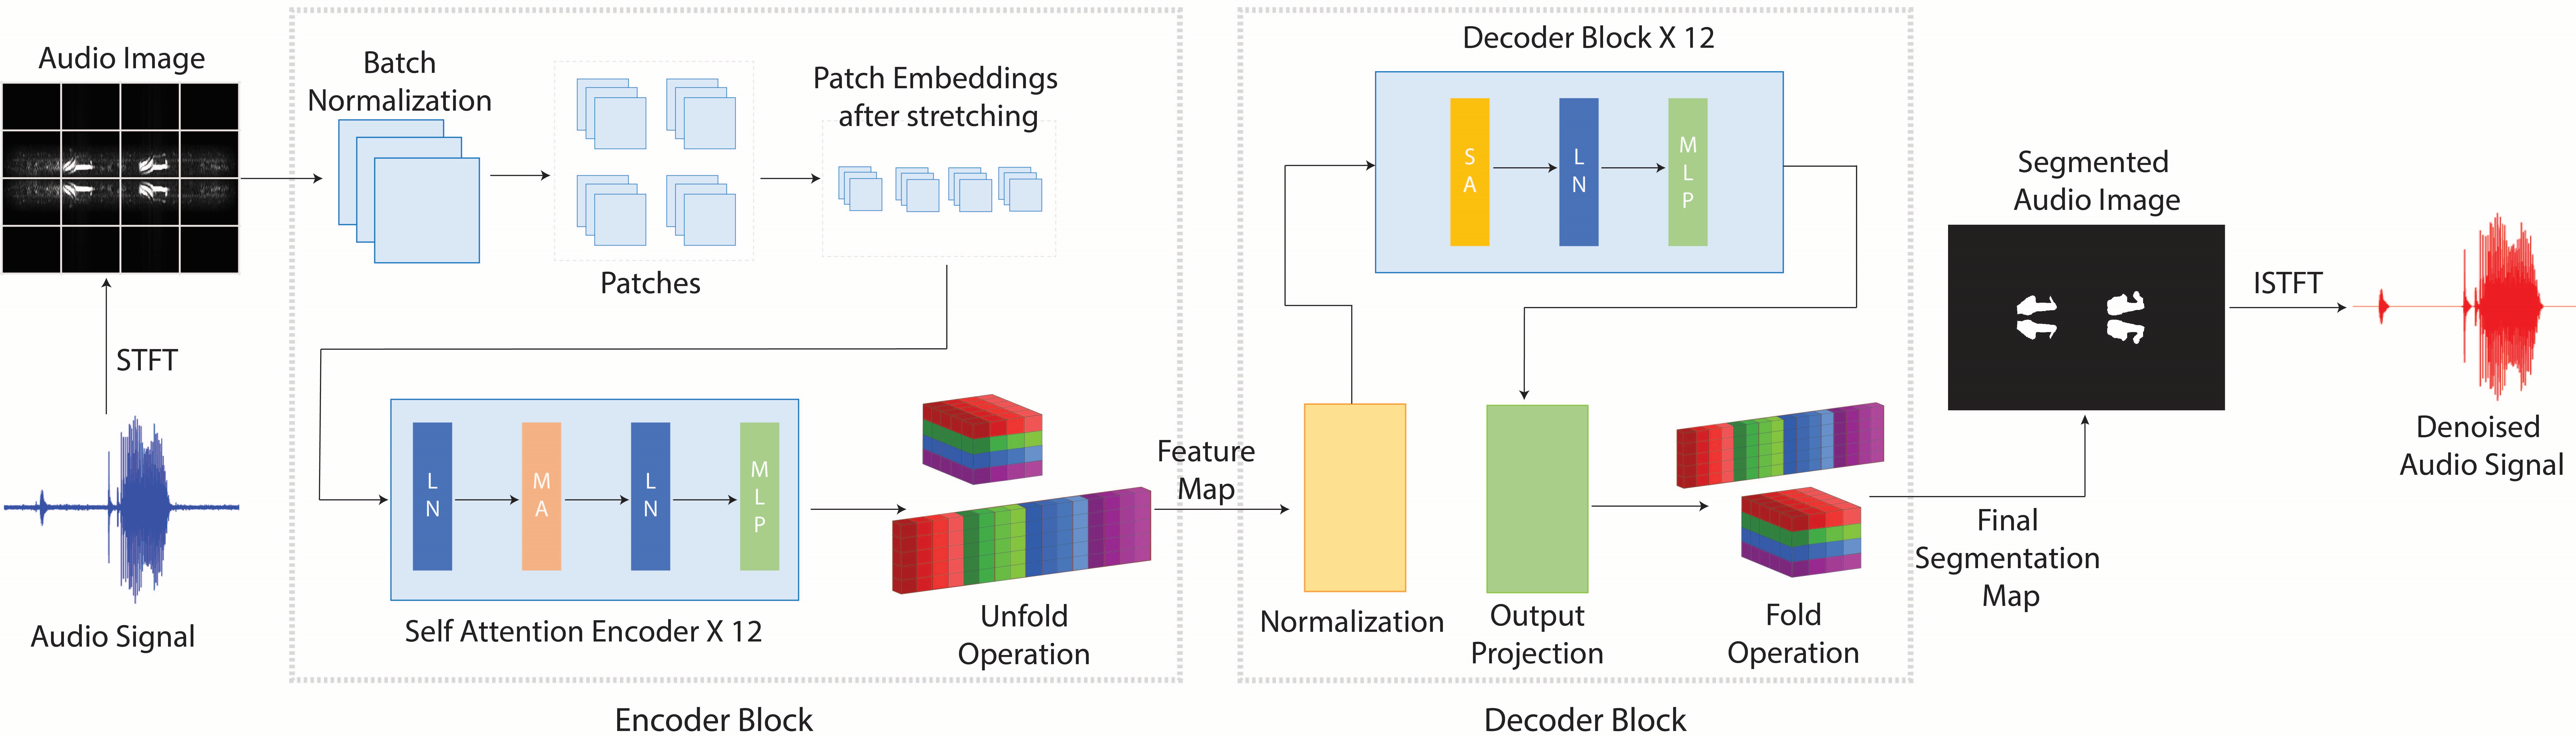
[2406.09167] Vision Transformer Segmentation for Visual Bird Sound ...
Advertisement Space (336x280)

Figure 1 from Multi-dimension Transformer with Attention-based ...

Illustration of the vision transformer (ViT) and multi self-attention ...

Figure 1 from Self-Supervised Vision Transformers Are Efficient ...

Figure 3 from An Efficient and Effective Transformer Decoder-Based ...

Vision Transformer Customized for Environment Detection and Collision ...
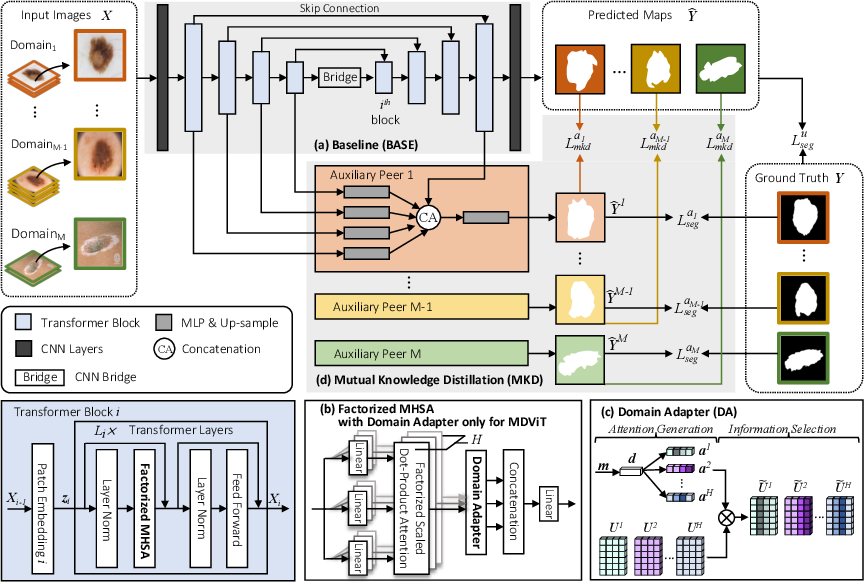
MDViT: Multi-domain Vision Transformer for Small Medical Image ...