
Figure 15 From A Multi Task Vision Transformer For Segmentation And

Figure 15 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 1 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 3 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 4 from A Multi-Task Vision Transformer for Segmentation and ...

Figure 16 from A Multi-Task Vision Transformer for Segmentation and ...

Table 1 from A Multi-Task Vision Transformer for Segmentation and ...

(PDF) A Multi-Task Vision Transformer for Segmentation and Monocular ...
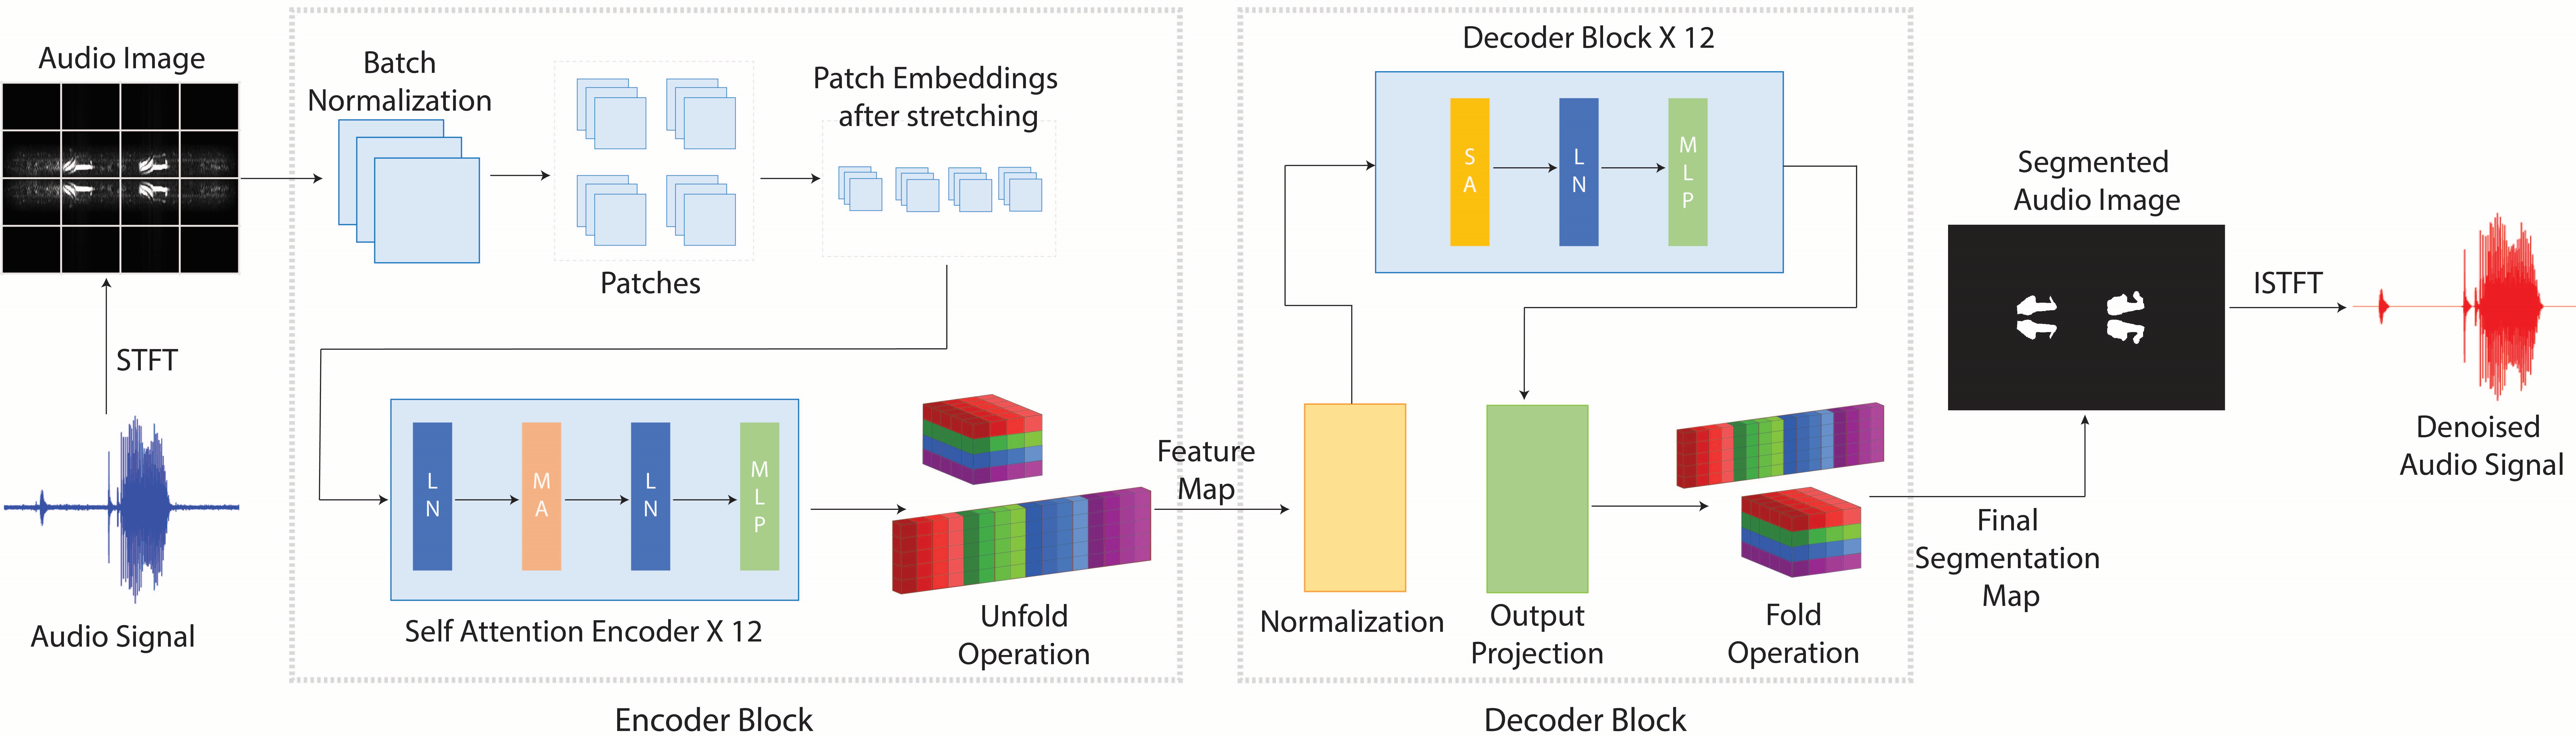
[2406.09167] Vision Transformer Segmentation for Visual Bird Sound ...

Proposed multi-task Vision Transformer model for diagnosis and severity ...

Proposed multi-task Vision Transformer model for diagnosis and severity ...
Advertisement Space (300x250)

A multitask classification framework based on vision transformer for ...

Illustration of the vision transformer (ViT) and multi self-attention ...

Figure 1 from Multi-Task Distributed Learning Using Vision Transformer ...

A Comparative Analysis of U-Net and Vision Transformer Architectures in ...
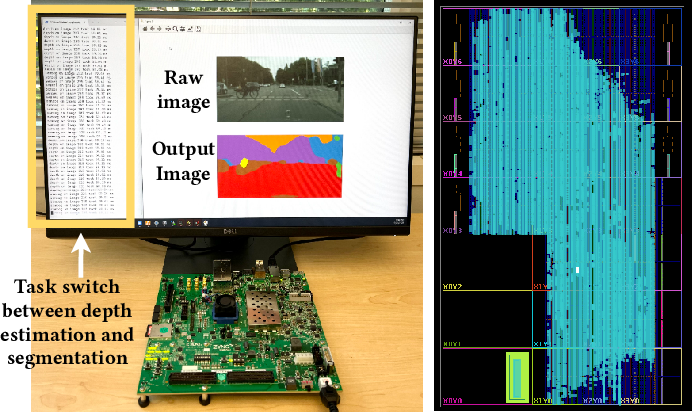
Figure 1 from Edge-MoE: Memory-Efficient Multi-Task Vision Transformer ...
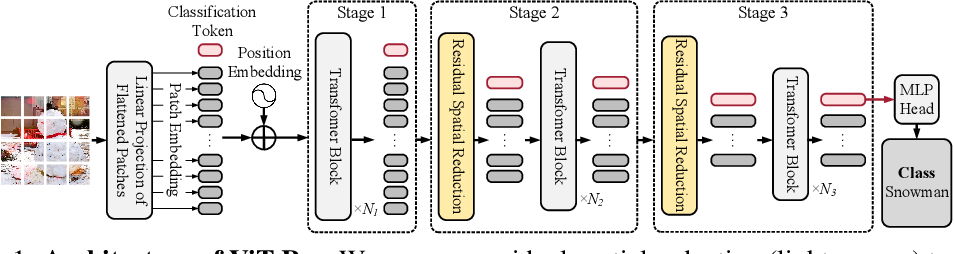
Figure 1 from Searching for Efficient Multi-Stage Vision Transformers ...

Vision Transformer Customized for Environment Detection and Collision ...

Figure 3 from An Efficient and Effective Transformer Decoder-Based ...

Task optimized vision transformer for diabetic retinopathy detection ...
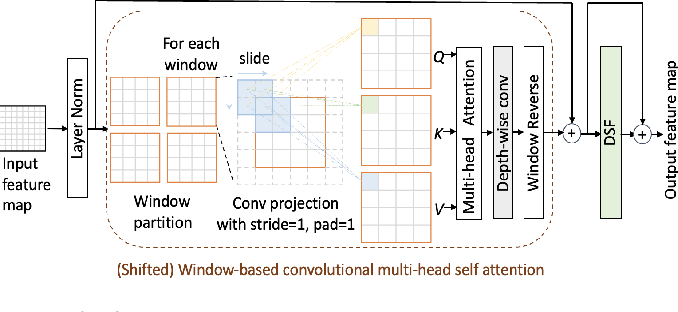
Figure 2 from Optimizing Vision Transformers for Medical Image ...
Advertisement Space (336x280)

3 -The vision transformer that Wu et al. (2020) proposed for either ...

論文紹介:Semantic segmentation using Vision Transformers: A survey | PDF

Framework of Vision Transformer segmentation model; 512 Â 512 images ...

Vision Transformer Adapters for Generalizable Multitask Learning
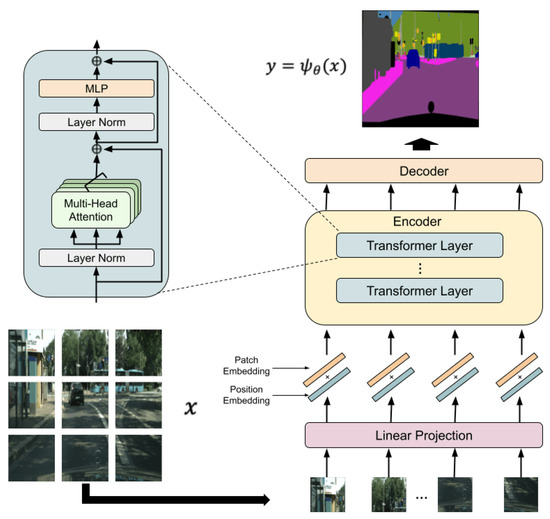
Privacy-Preserving Semantic Segmentation Using Vision Transformer

Automatic Medical Image Segmentation with Vision Transformer

Semantic Segmentation Using Vision Transformers: A Survey – DYML

Vision Transformer Adapters for Generalizable Multitask Learning | DeepAI

Figure 1 from Cutransnet: Transformers to Make Strong Encoders for ...

Vision Transformer Adapters for Generalizable Multitask Learning
Advertisement Space (336x280)

Figure 2 from Scene Text Segmentation via Multi-Task Cascade ...
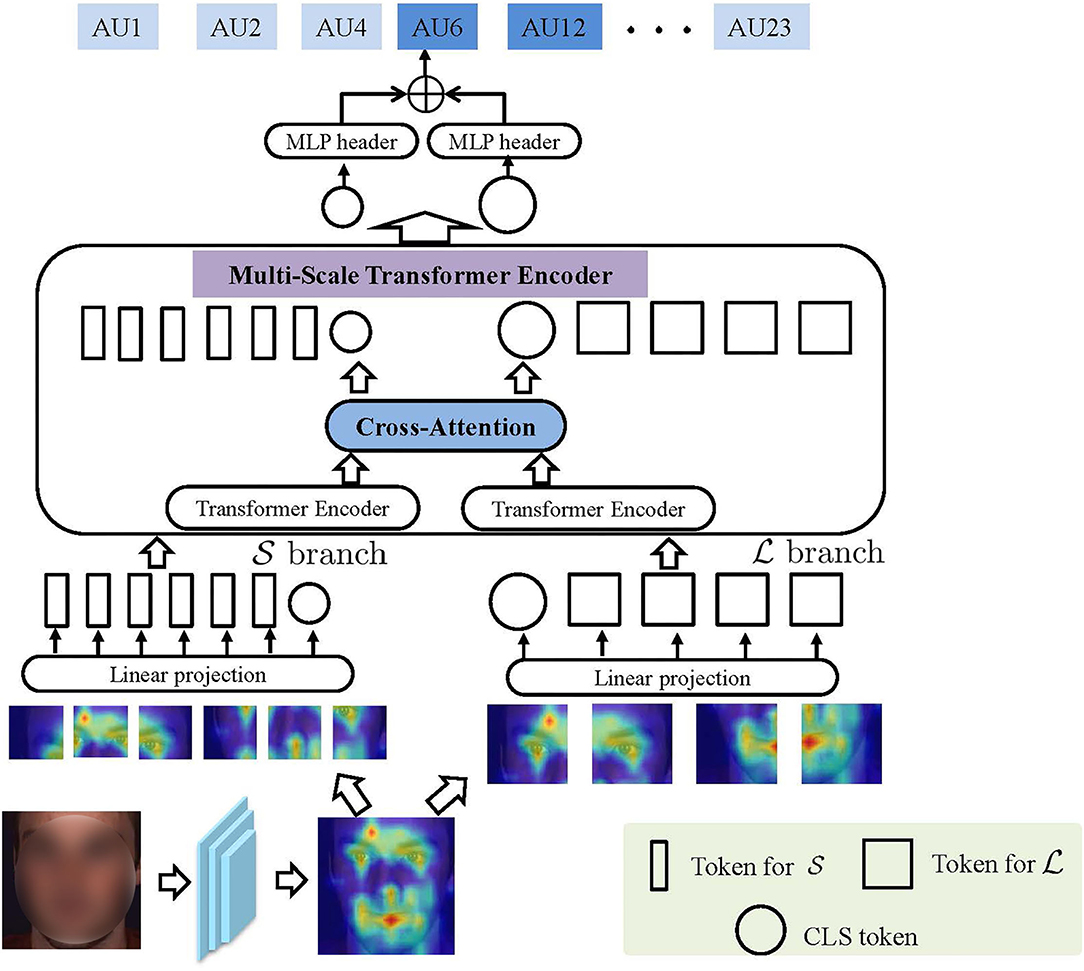
Frontiers | Progressive Multi-Scale Vision Transformer for Facial ...

Vision Transformers for Image Classification: A Comparative Survey
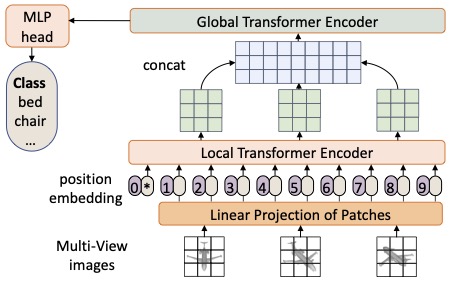
MVT: Multi-view Vision Transformer for 3D Object Recognition | VIS Lab
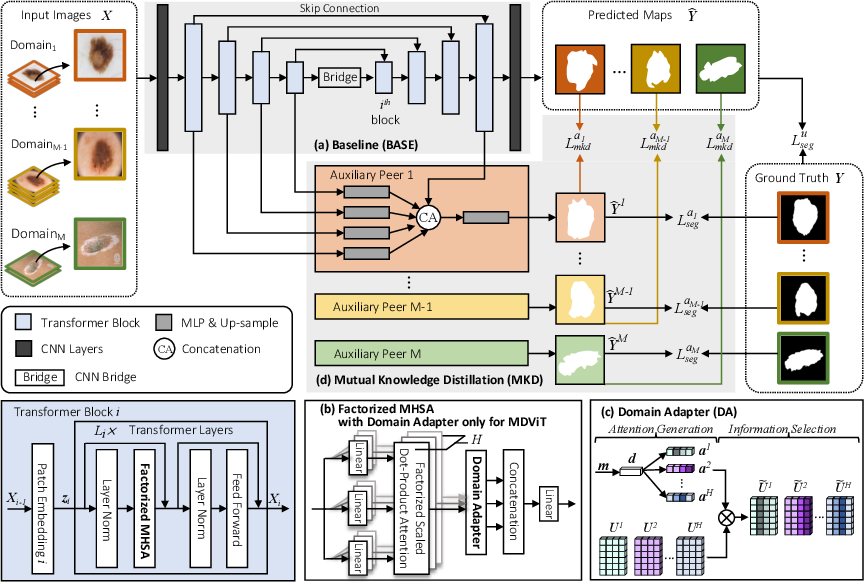
MDViT: Multi-domain Vision Transformer for Small Medical Image ...

Automatic Medical Image Segmentation with Vision Transformer