
Figure 1 From Augmenting Vision Language Pretraining By Learning

Figure 1 from Augmenting Vision Language Pretraining by Learning ...

Augmenting Vision Language Pretraining by Learning Codebook with Visual ...

Figure 1 from Mixture of Prompt Learning for Vision Language Models ...

Figure 1 from Retrieval-based Knowledge Augmented Vision Language Pre ...
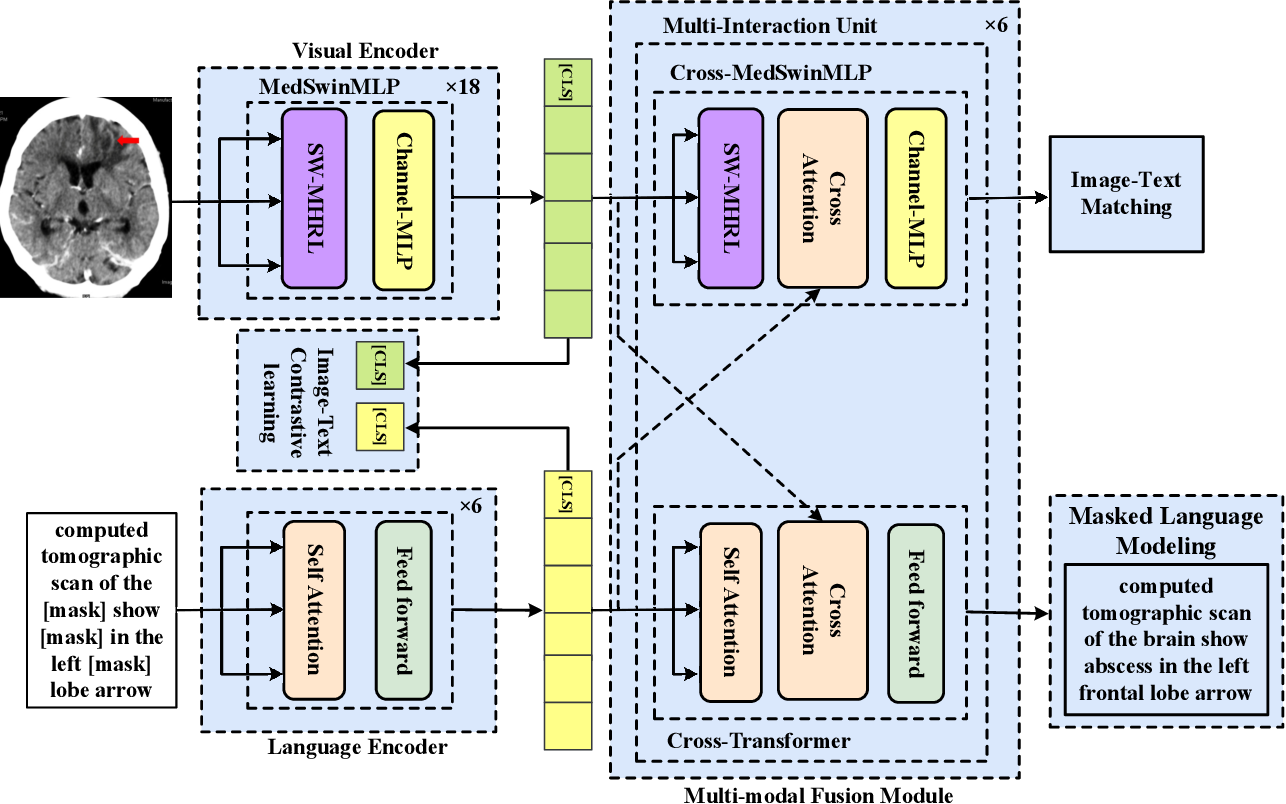
Figure 1 from MLP-Based Vision Language Pre-Training for Medical Visual ...

Figure 1 from Class Incremental Learning with Pre-trained Vision ...

Figure 1 from Language Reward Modulation for Pretraining Reinforcement ...

Figure 1 from Relation Enhanced Vision Language Pre-Training | Semantic ...
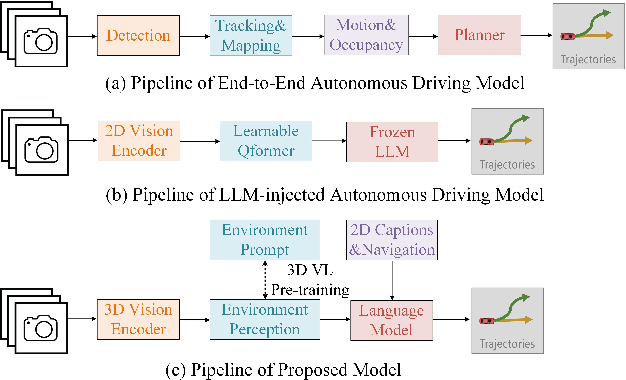
Figure 1 from Generative Planning with 3D-vision Language Pre-training ...

Figure 1 from Efficient Vision-Language Pretraining with Visual ...
Advertisement Space (300x250)
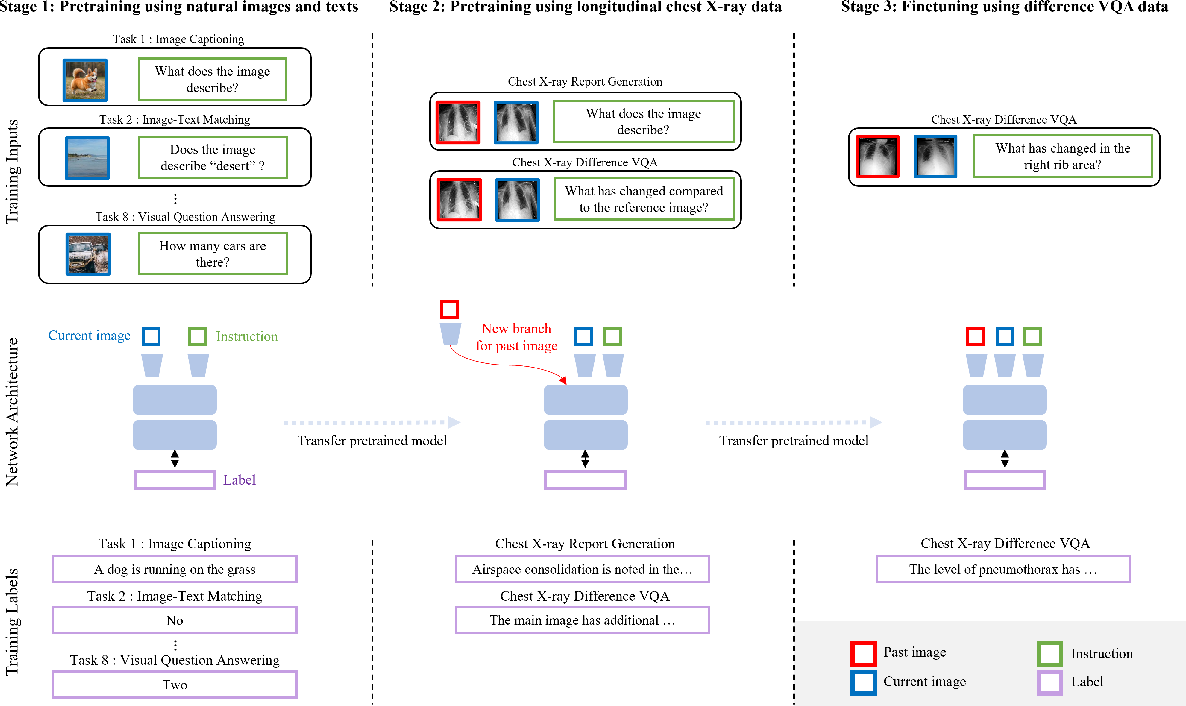
Figure 1 from Pretraining Vision-Language Model for Difference Visual ...
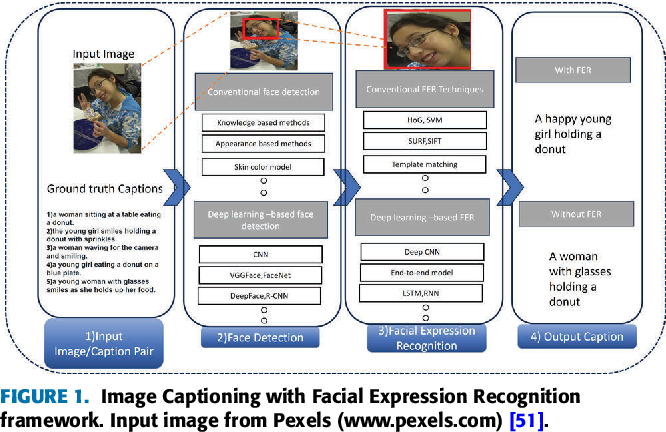
Figure 1 from Vision–Language Pretraining for Image Captioning Using ...

Figure 1 from VAuLT: Augmenting the Vision-and-Language Transformer ...

Figure 1 from Scalable Vision-Language-Action Model Pretraining for ...

Figure 1 from Knowledge Boosting: Rethinking Medical Contrastive Vision ...

Figure 1 from Knowledge Boosting: Rethinking Medical Contrastive Vision ...

Figure 1 from Efficient Vision-Language Pretraining with Visual ...
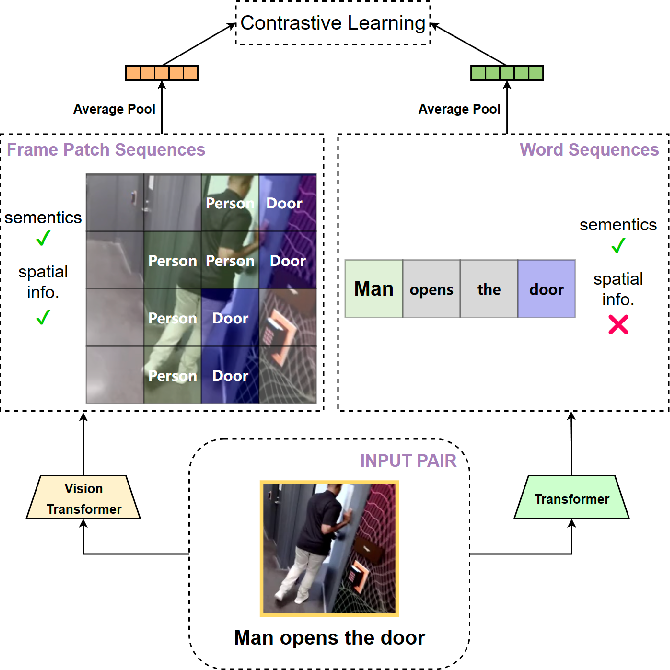
Figure 1 from SpaceCLIP: A Vision-Language Pretraining Framework With ...

Figure 1 from Generative Text-Guided 3D Vision-Language Pretraining for ...
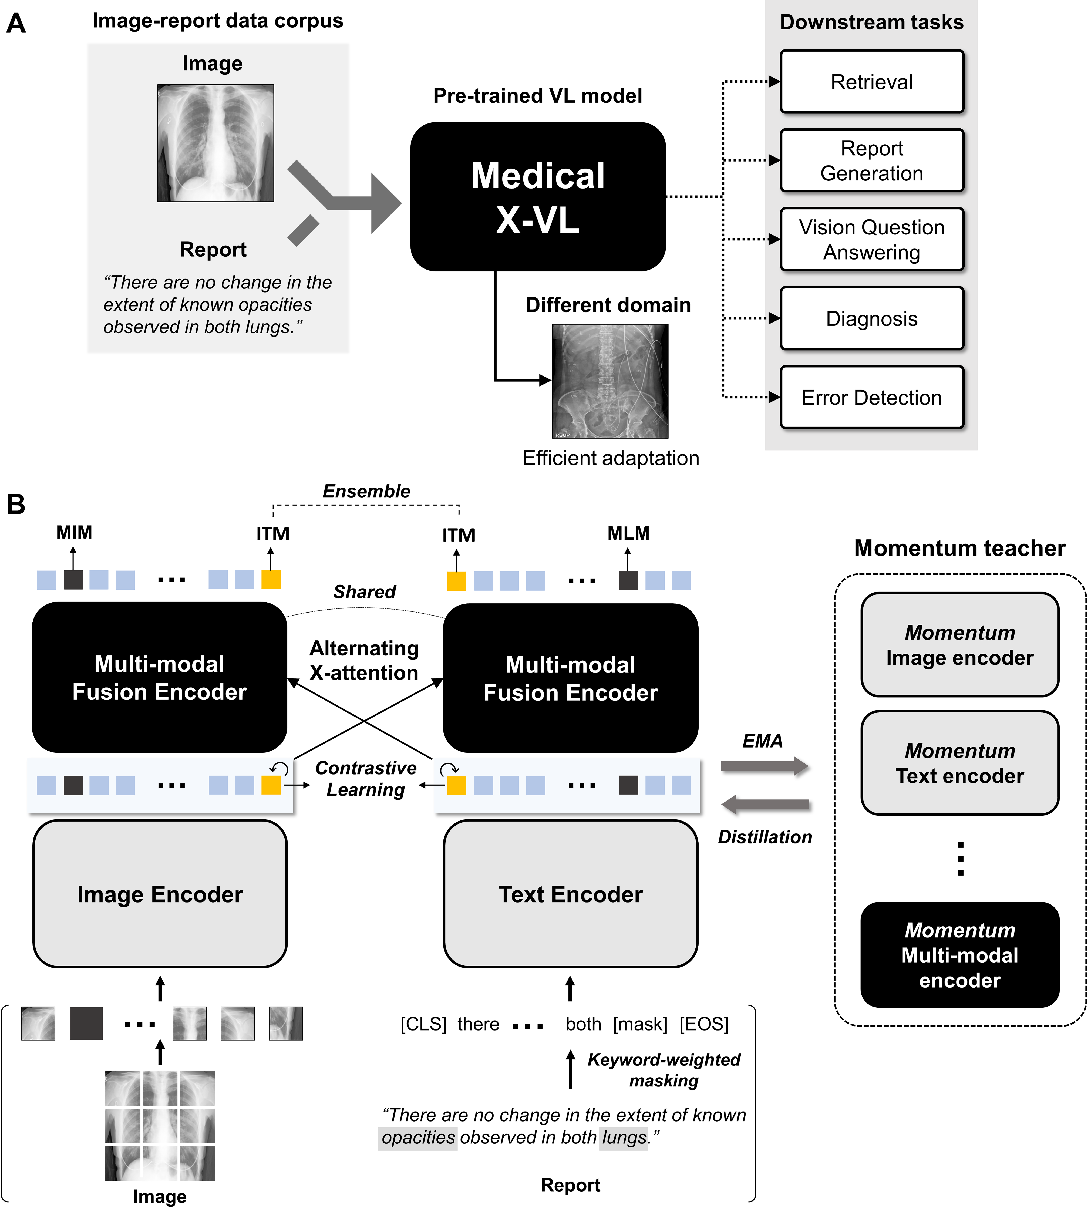
Figure 1 from Vision-Language Pretraining Enables Radiographs and ...
Advertisement Space (336x280)

Figure 1 from Boosting Continual Learning of Vision-Language Models via ...

Figure 1 from Vision-Language Pre-training with Object Contrastive ...
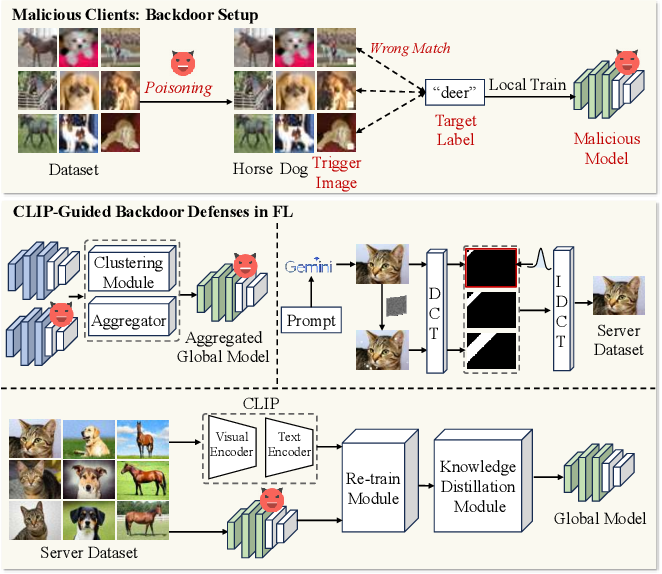
Figure 1 from A Vision-Language Pre-training Model-Guided Approach for ...

Figure 1 from A Vision-Language Pre-training model based on Cross ...

Figure 1 from Improved baselines for vision-language pre-training ...

Figure 1 from Unified Vision-Language Pre-Training for Image Captioning ...

Figure 1 from Incorporating Structured Representations into Pretrained ...

Figure 1 from Instruction-Following Agents with Jointly Pre-Trained ...
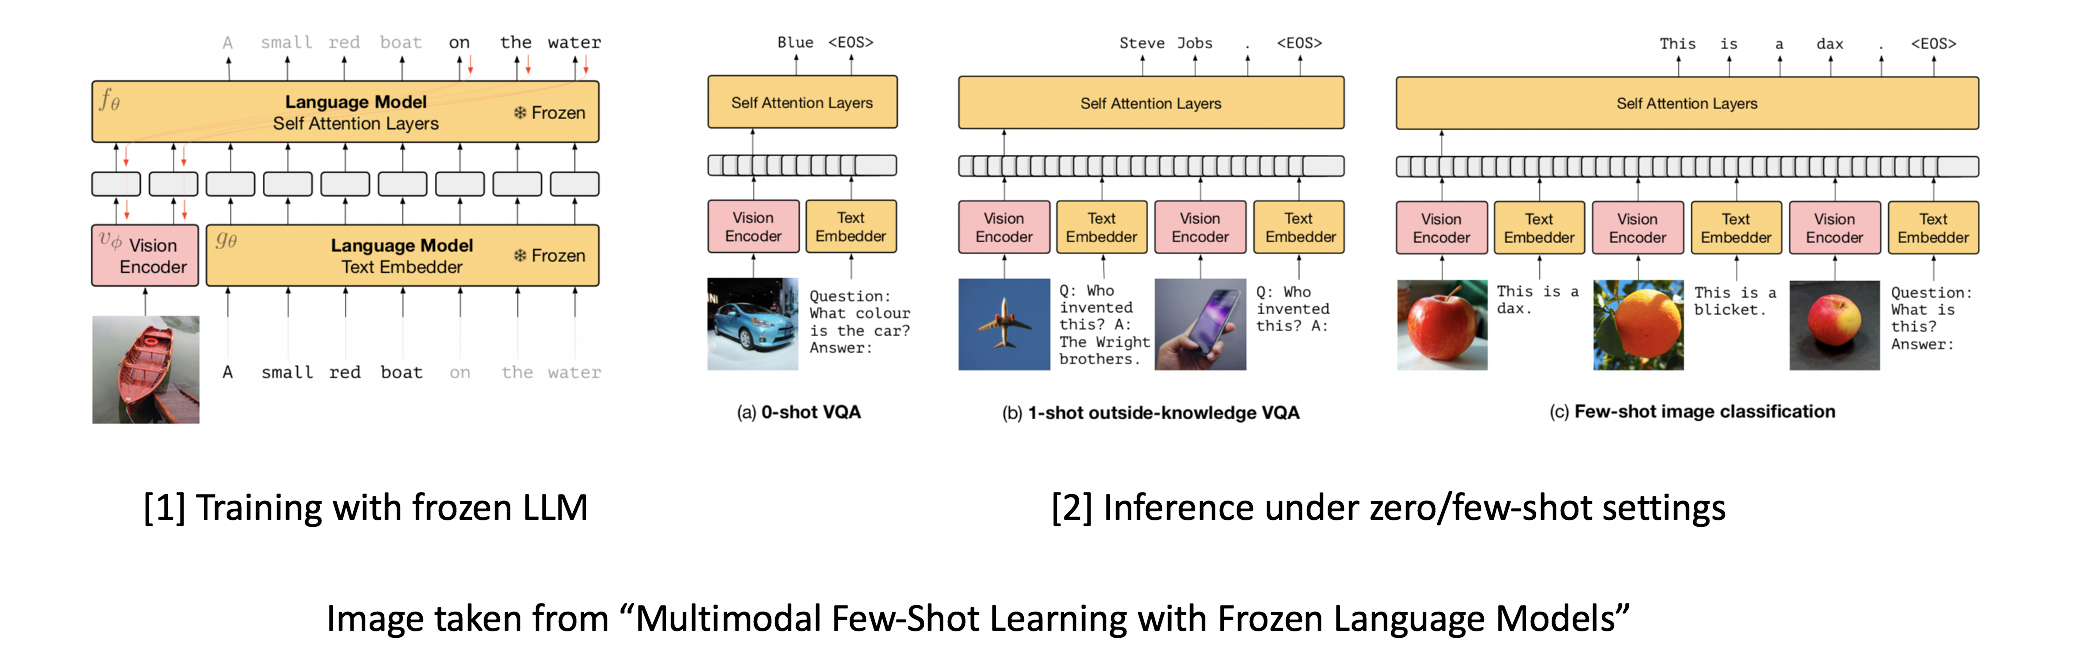
Vision Language Pretraining

Vision Language Pretraining
Advertisement Space (336x280)

Figure 1 from Enhancing Vision-Language Pre-Training with Jointly ...

Figure 1 from Enhancing Vision-Language Pre-Training with Jointly ...

Figure 1 from Vision-Language Pre-Training for Boosting Scene Text ...

Figure 1 from Instruction-Following Agents with Jointly Pre-Trained ...
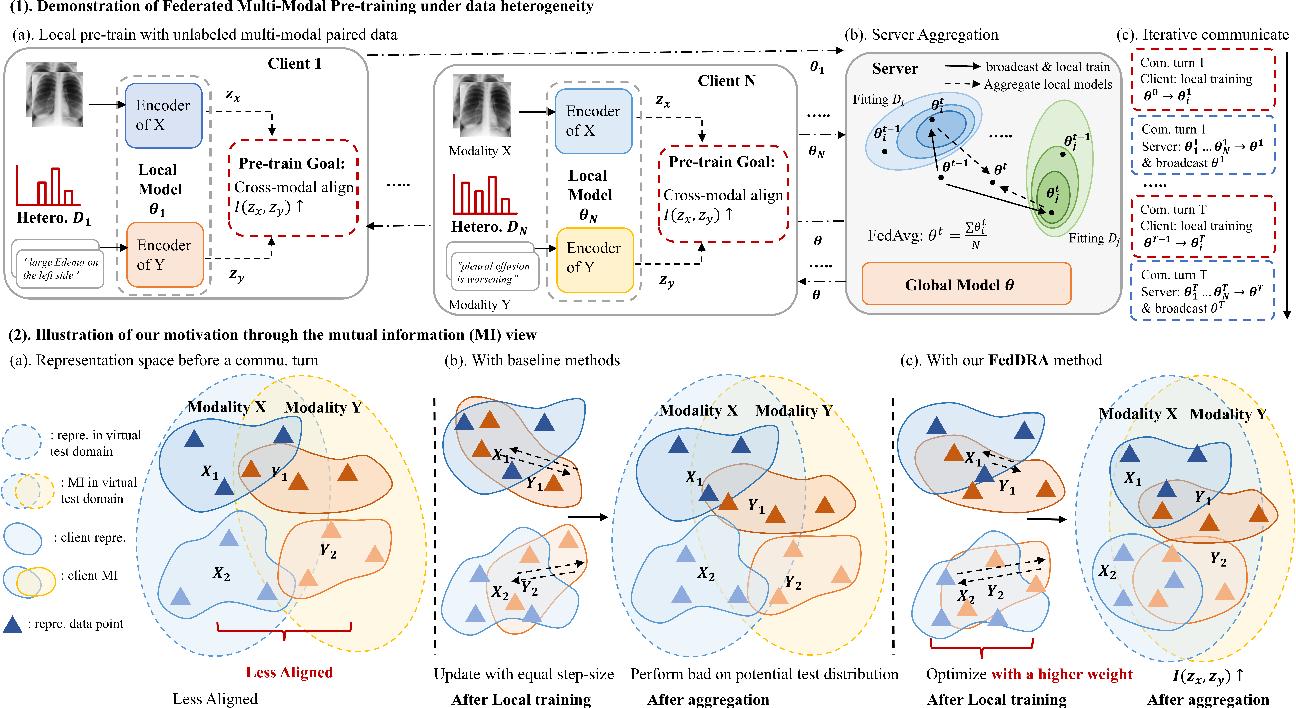
Figure 1 from Distributionally Robust Alignment for Medical Federated ...
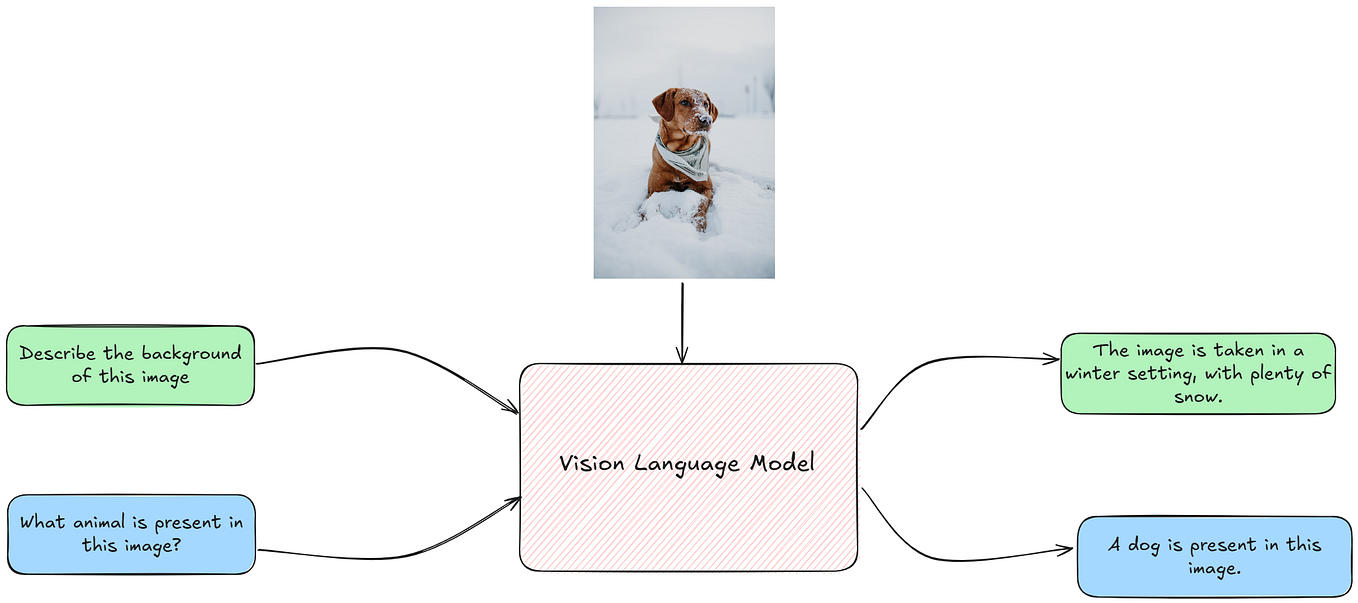
Building A Simple Custom Vision Language Model with Hugging Face🤗 | by ...