
Figure 1 From Beyond Single Bugs Benchmarking Large Language Models
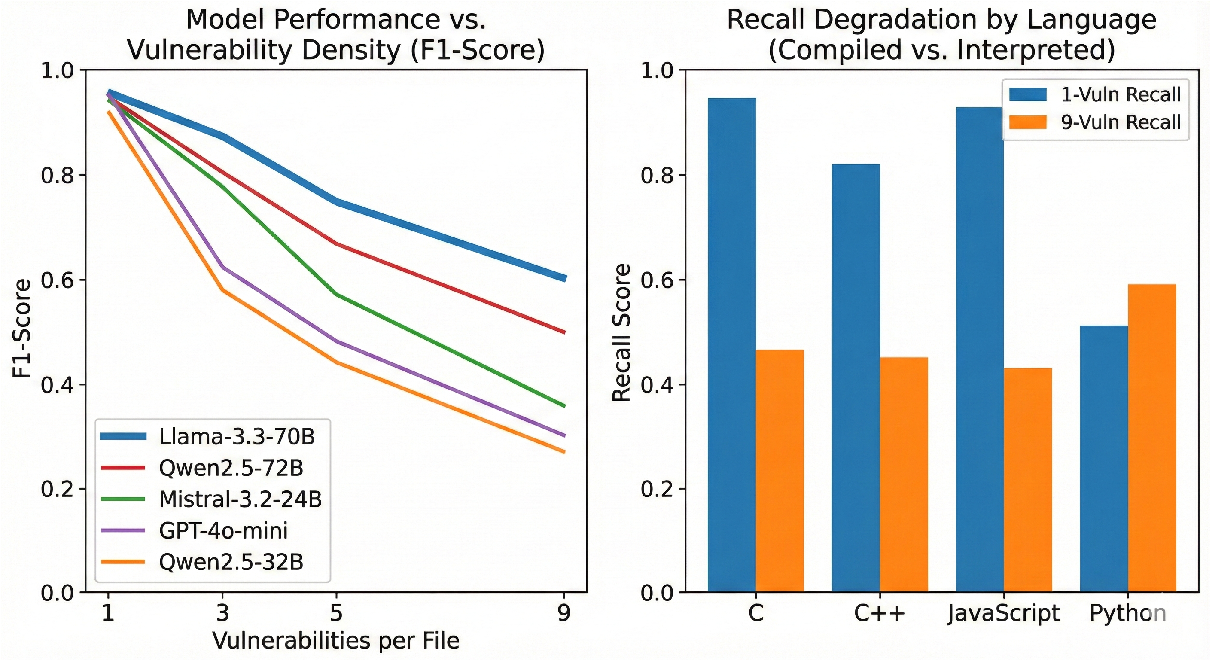
Figure 1 from Beyond Single Bugs: Benchmarking Large Language Models ...
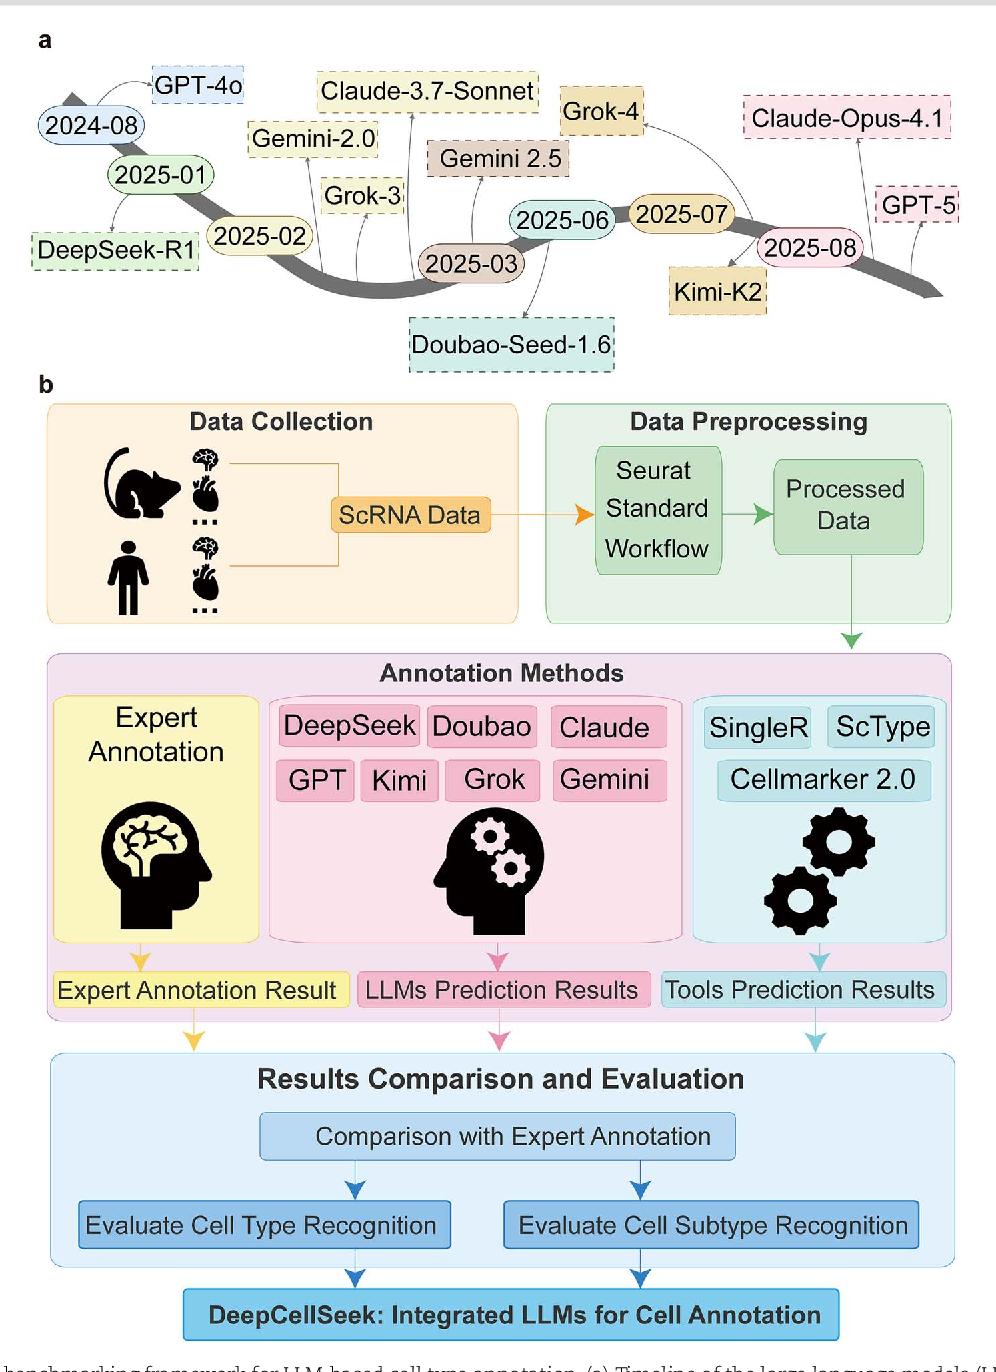
Figure 1 from Benchmarking large language models for cell typing in ...

Figure 1 from GPT-Fathom: Benchmarking Large Language Models to ...

Figure 1 from Benchmarking Large Language Models for Personalized ...
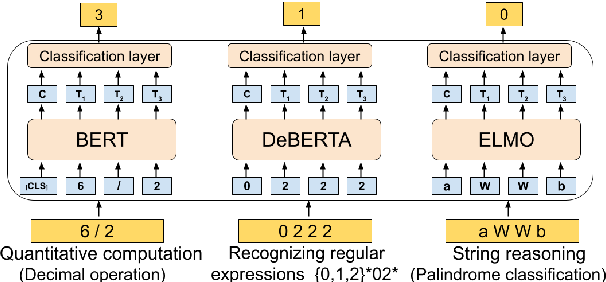
Figure 1 from What do Large Language Models Learn beyond Language ...

Table 2 from Beyond Single Bugs: Benchmarking Large Language Models for ...

Beyond Single Bugs: Benchmarking Large Language Models for Multi ...

Figure 1 from Large Language Models are Few-shot Testers: Exploring LLM ...

Figure 1 from Benchmarking Knowledge Boundary for Large Language Model ...
Beyond Single Bugs: Benchmarking Large Language Models for Multi ...
Advertisement Space (300x250)
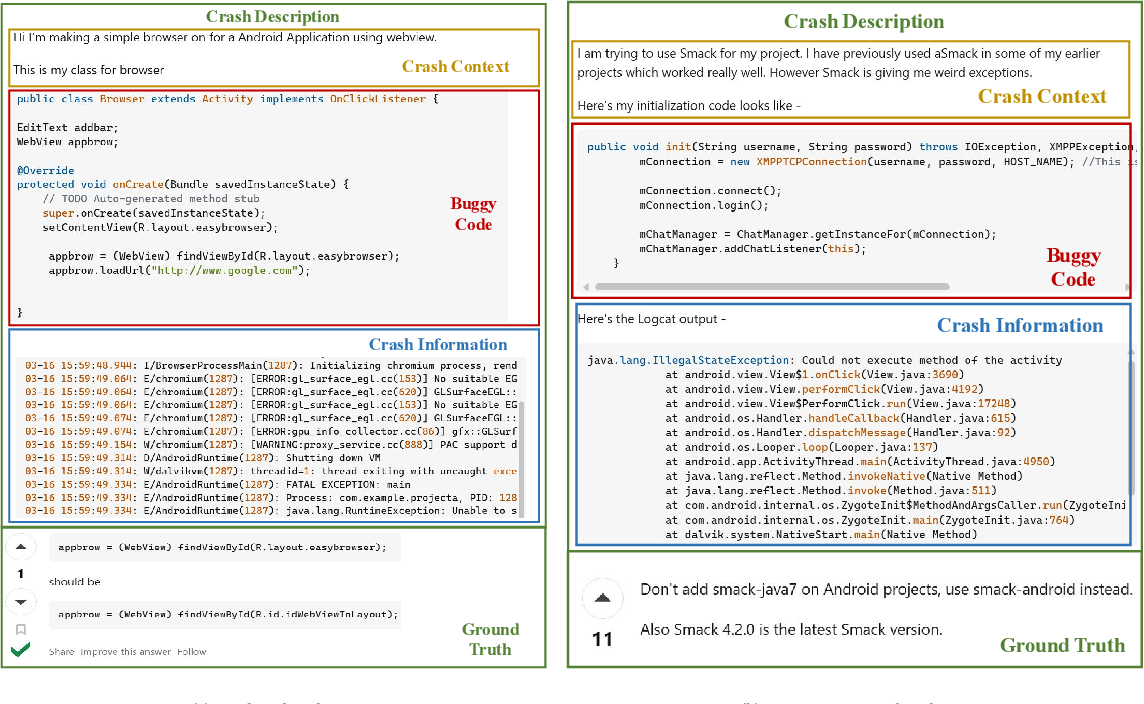
Figure 1 from Exploring Large Language Models in Resolving Environment ...
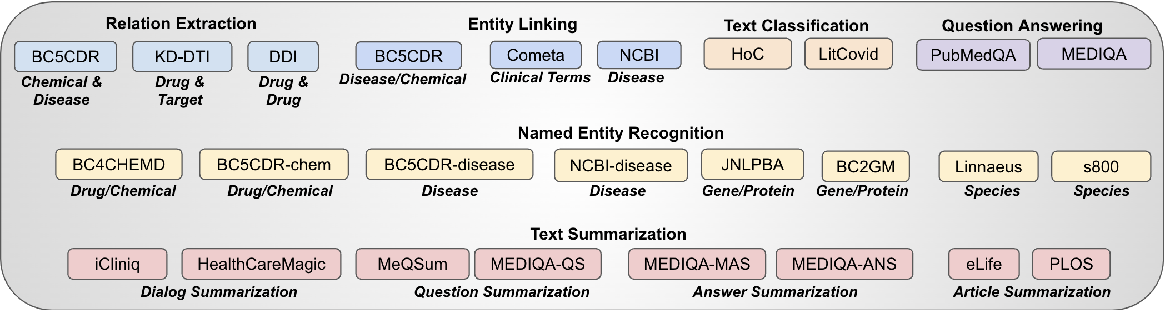
Figure 1 from A Comprehensive Evaluation of Large Language Models on ...
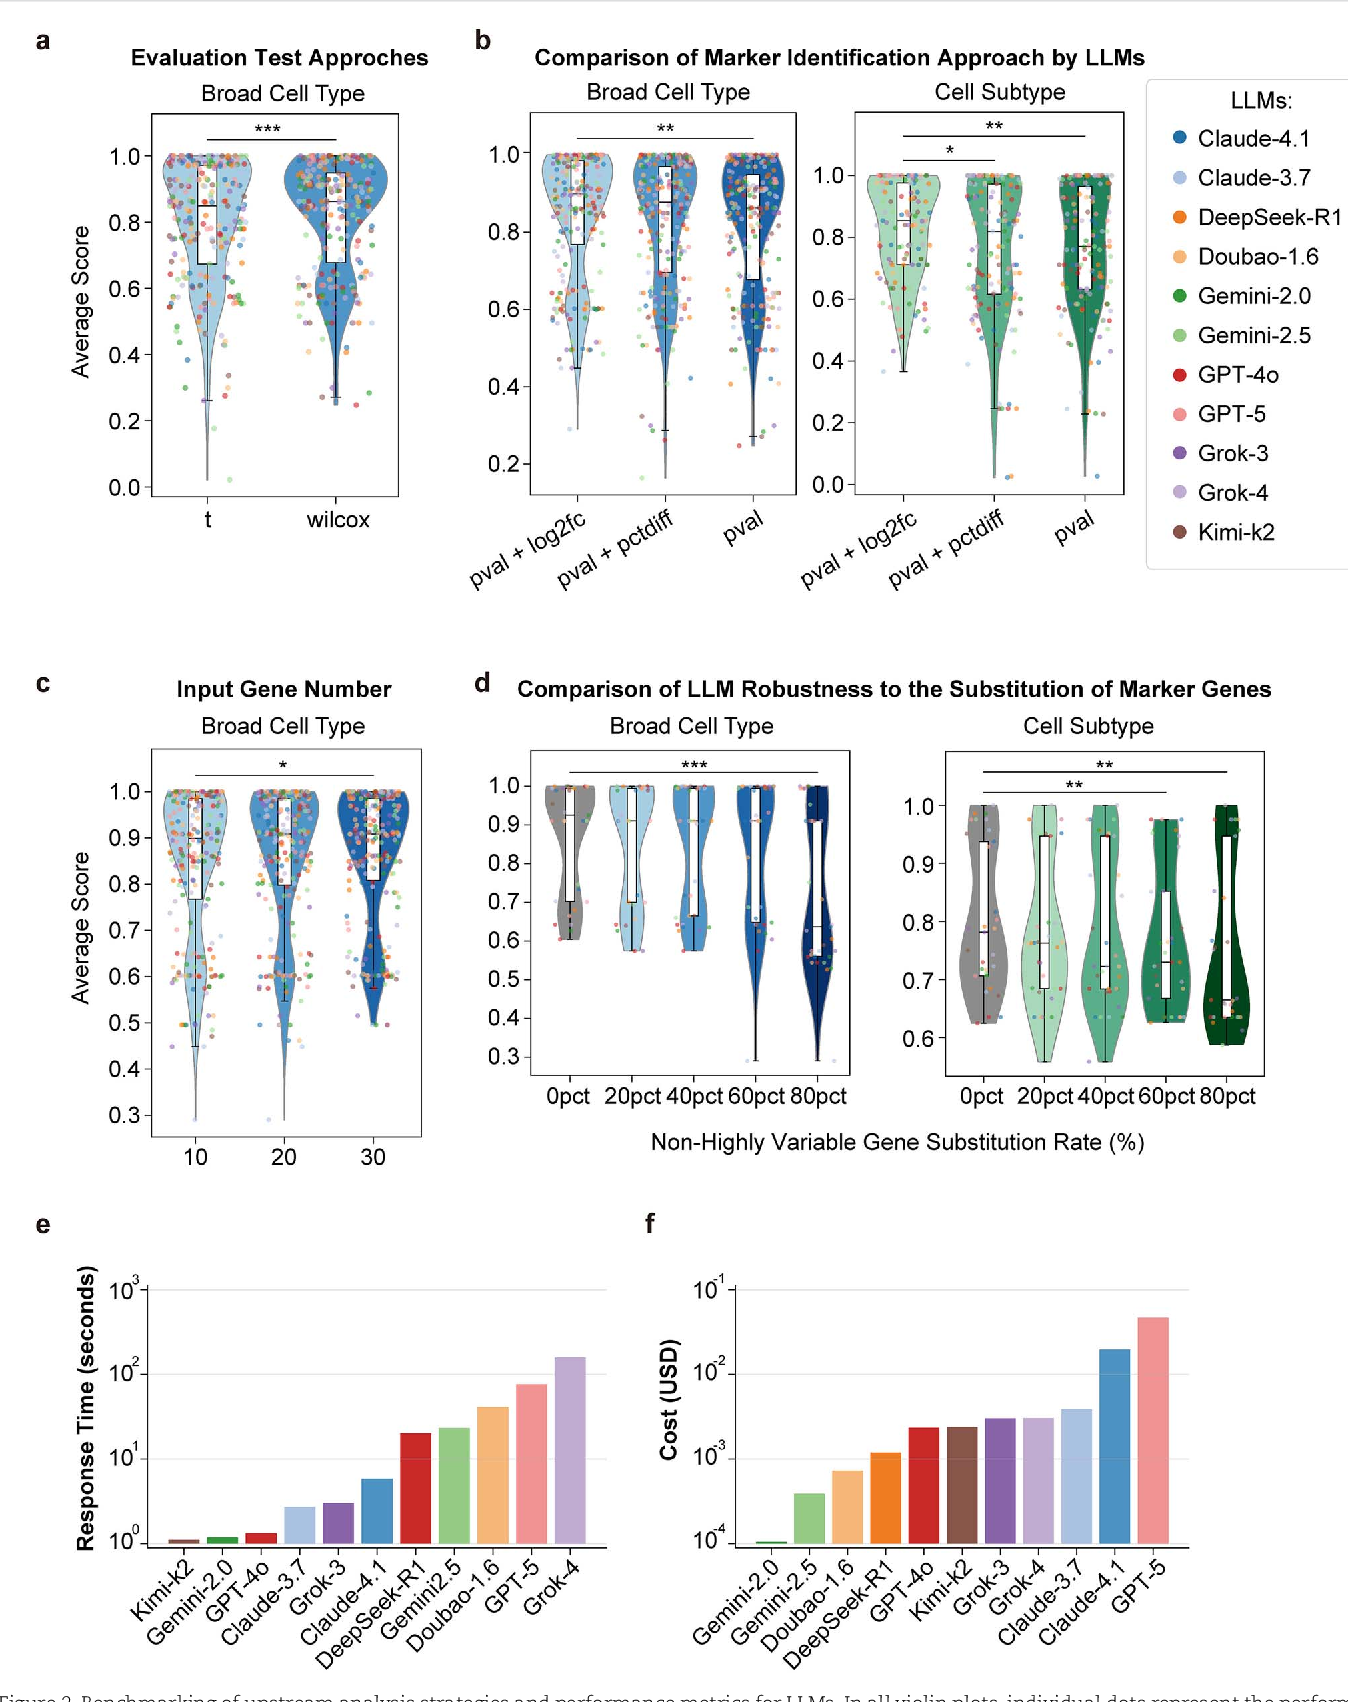
Figure 2 from Benchmarking large language models for cell typing in ...
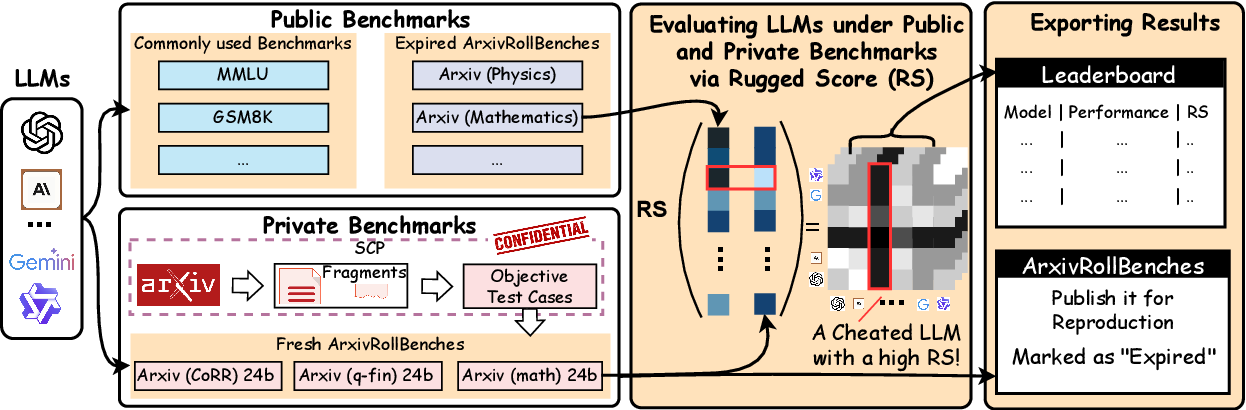
Figure 1 from How Much Do Large Language Model Cheat on Evaluation ...
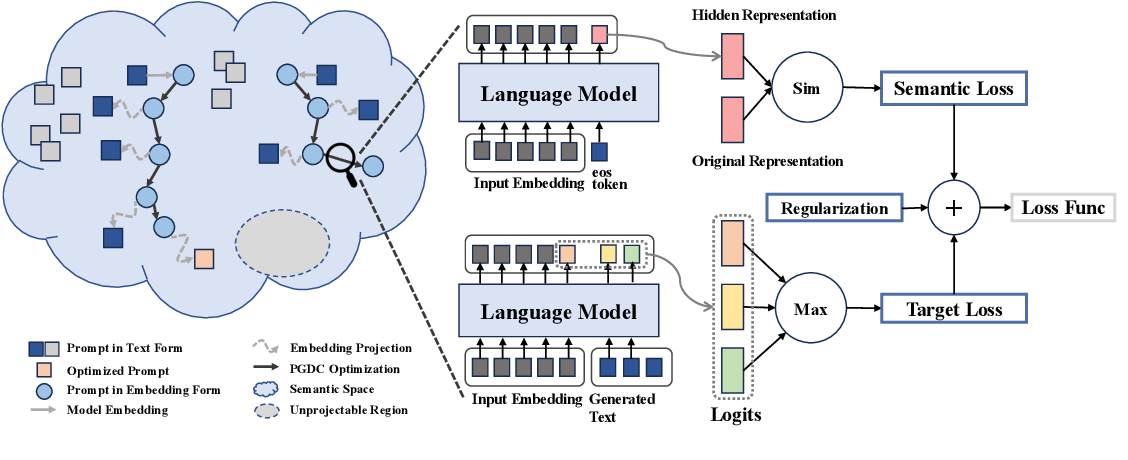
Figure 2 from Benchmarking Knowledge Boundary for Large Language Model ...

Figure 6 from A Deep Dive into Large Language Models for Automated Bug ...

Benchmarking Large Language Models from Open and Closed Source Models ...

Figure 1 from Lost in Benchmarks? Rethinking Large Language Model ...

BUFFET: Benchmarking Large Language Models for Cross-lingual Few-shot ...
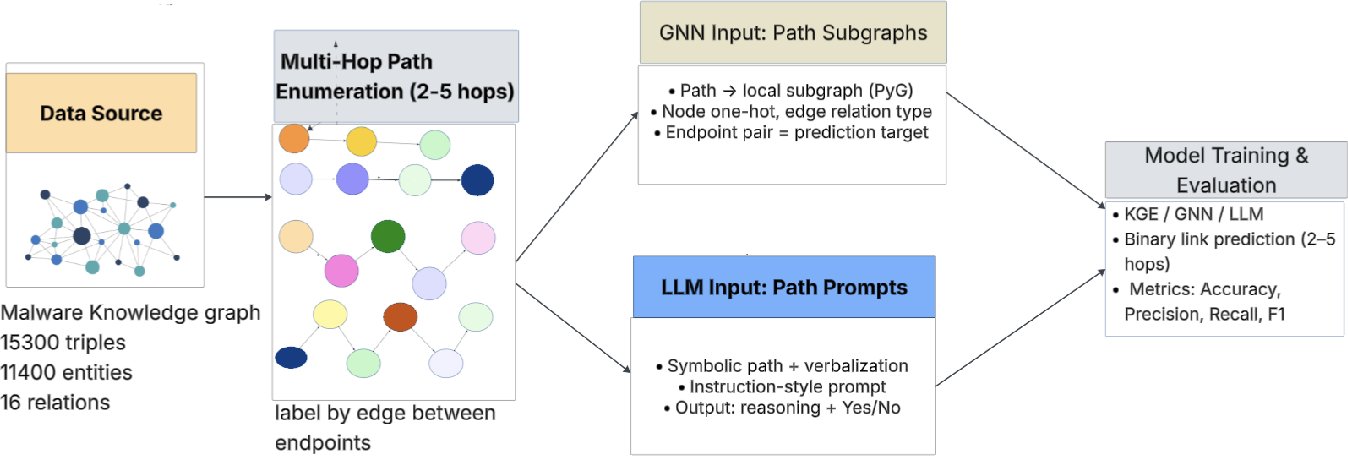
Figure 1 from Beyond Single-Hop: Link Prediction Through Multi-Hop ...
Advertisement Space (336x280)
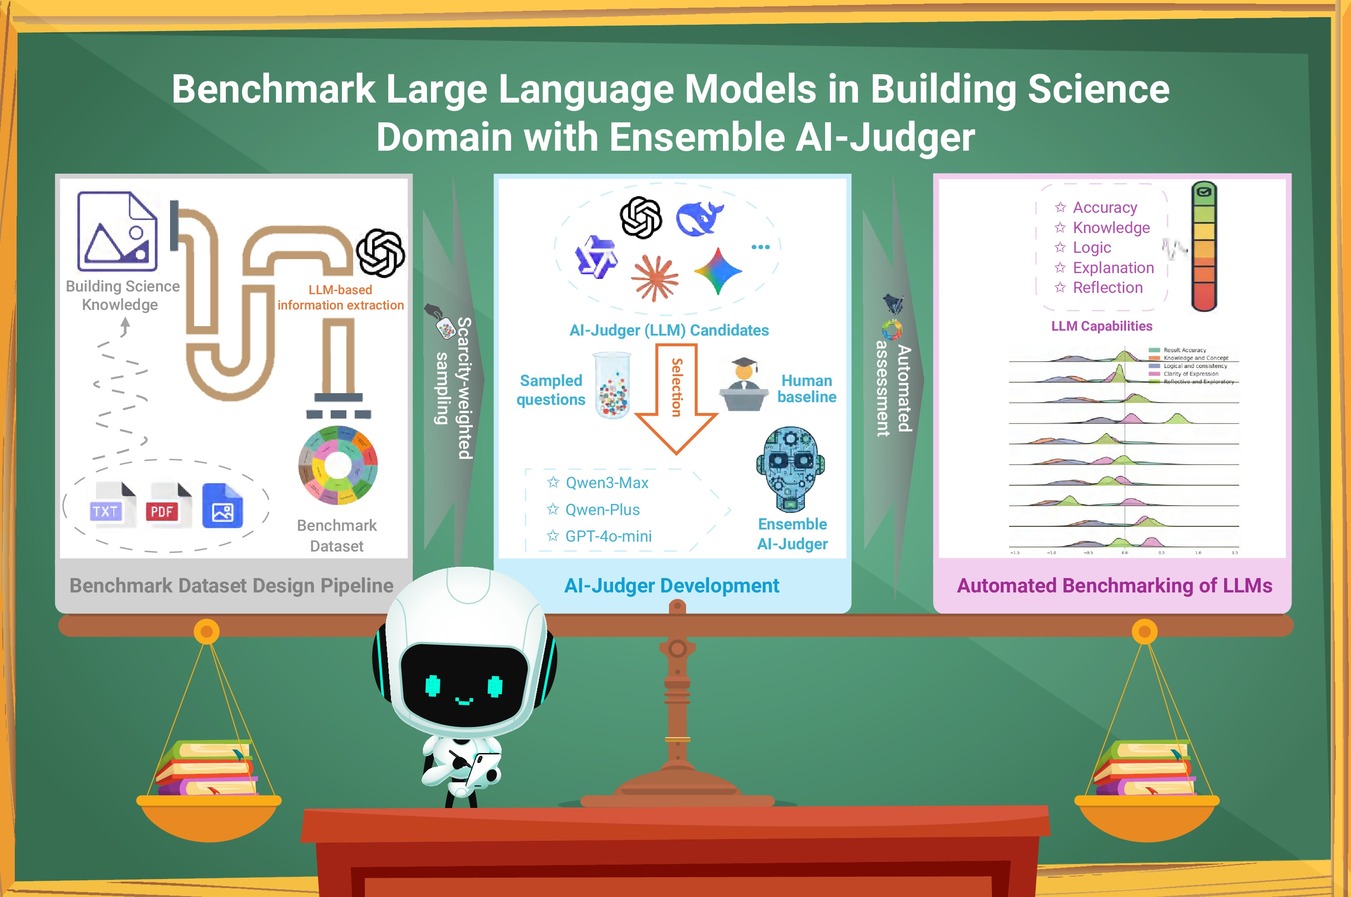
Benchmarking Knowledge and Capability of Large Language Models in ...

[논문 리뷰] Beyond Words: Evaluating Large Language Models in ...

Benchmarking Large Language Models with a Unified Performance Ranking ...

Paper page - Benchmarking Benchmark Leakage in Large Language Models

Benchmarking Prompt Sensitivity in Large Language Models | AI Research ...

Bugs in Large Language Models Generated Code: An Empirical Study

(PDF) Benchmarking Large Language Models for News Summarization

Benchmarking Large Language Models for Automated Verilog RTL Code ...

Beyond Prompts: Dynamic Conversational Benchmarking of Large Language ...

Figure 1 from Why Stop at One Error? Benchmarking LLMs as Data Science ...
Advertisement Space (336x280)
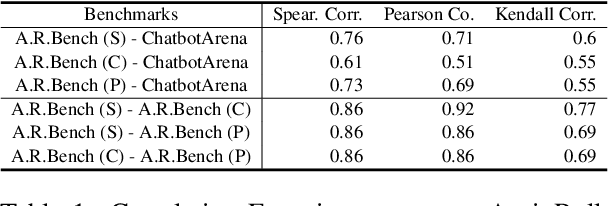
Table 1 from How Much Do Large Language Model Cheat on Evaluation ...
Human-Level and Beyond: Benchmarking Large Language Models Against ...
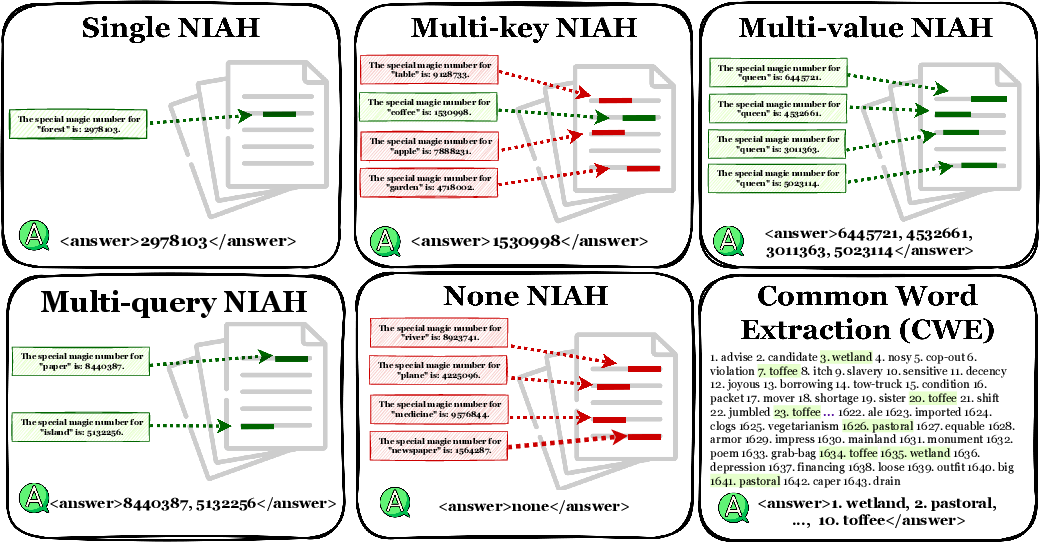
Figure 1 from One ruler to measure them all: Benchmarking multilingual ...

Benchmarking Large Language Models As AI Research Agents

Benchmarking Large Language Models on Controllable Generation under ...

Benchmarking large language models on safety risks in scientific ...