
Table 2 From Beyond Single Bugs Benchmarking Large Language Models For

Table 2 from Beyond Single Bugs: Benchmarking Large Language Models for ...
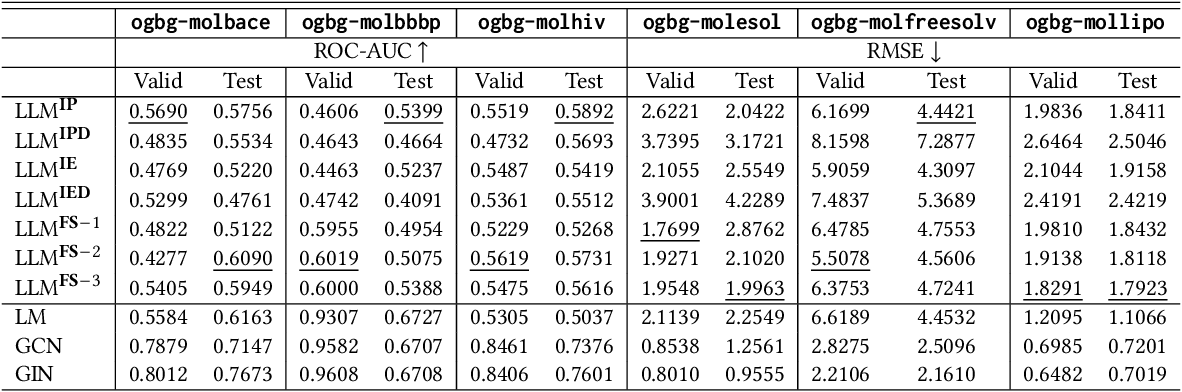
Table 2 from Benchmarking Large Language Models for Molecule Prediction ...
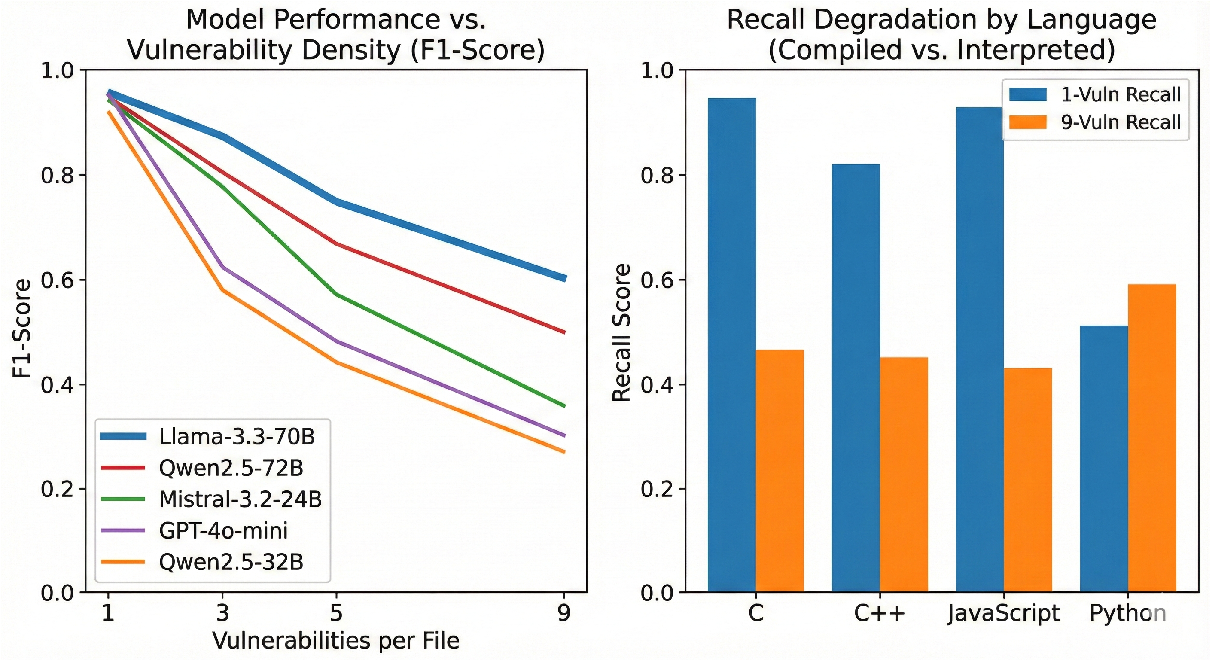
Figure 1 from Beyond Single Bugs: Benchmarking Large Language Models ...
Beyond Single Bugs: Benchmarking Large Language Models for Multi ...

Beyond Single Bugs: Benchmarking Large Language Models for Multi ...

Table 2 from Benchmarking Large Language Model Capabilities for ...

Table 2 from Benchmarking Large Language Models in Retrieval-Augmented ...
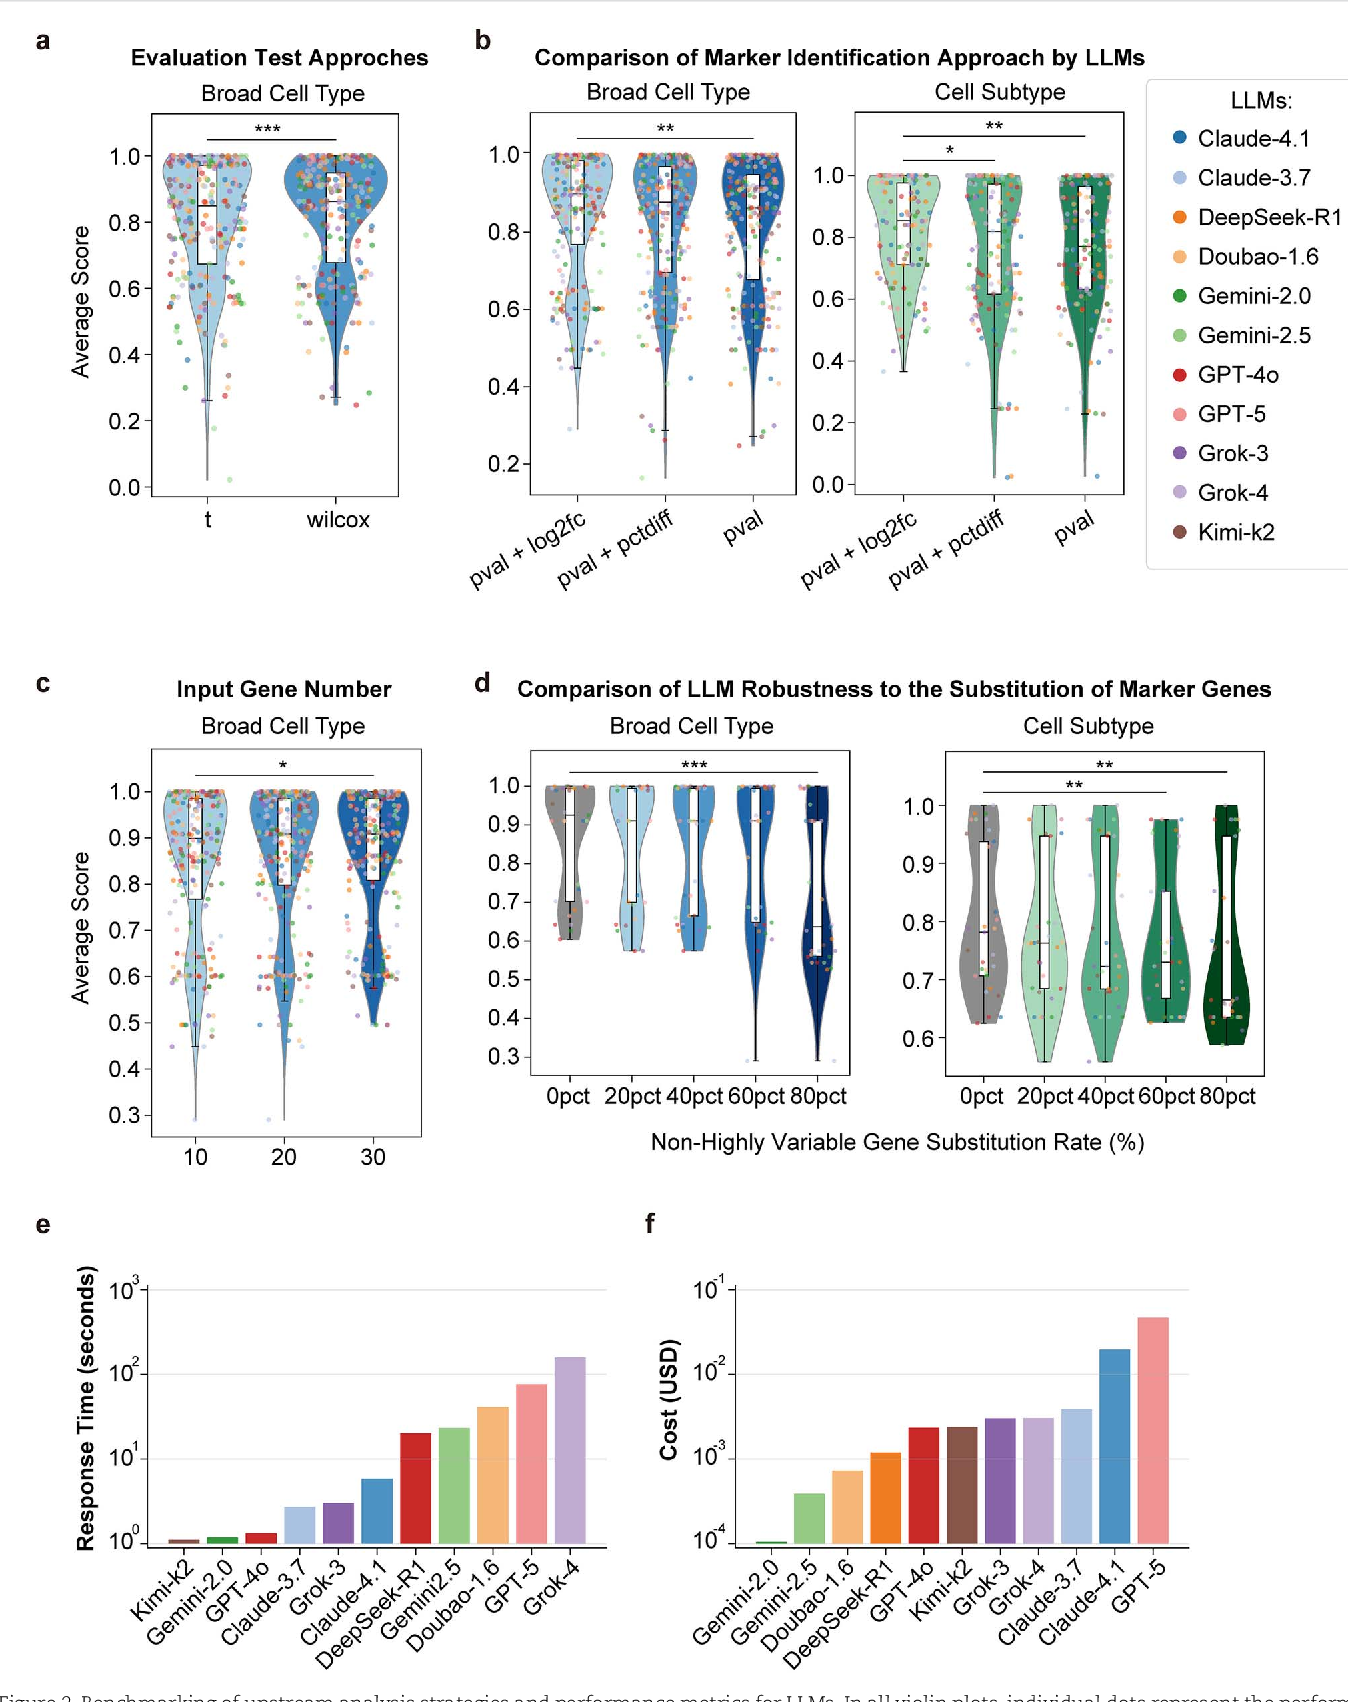
Figure 2 from Benchmarking large language models for cell typing in ...
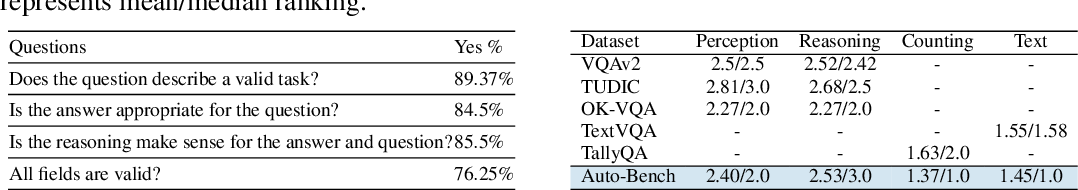
Table 2 from Large Language Models as Automated Aligners for ...

Table 1 from BUFFET: Benchmarking Large Language Models for Few-shot ...
Advertisement Space (300x250)
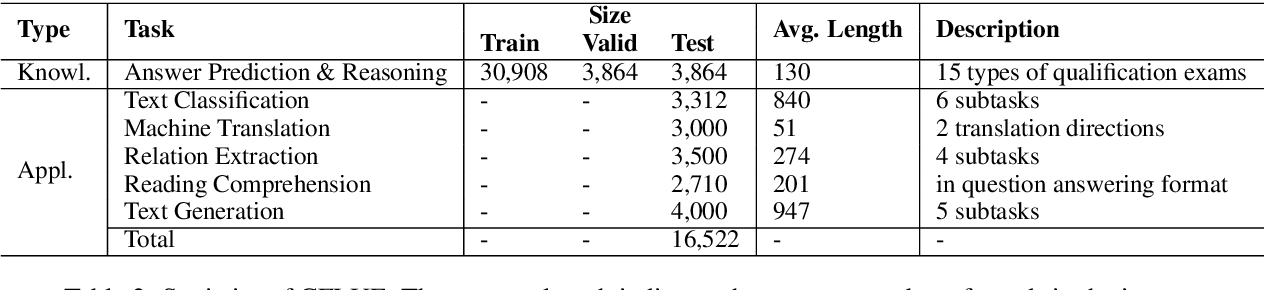
Table 2 from Benchmarking Large Language Models on CFLUE - A Chinese ...
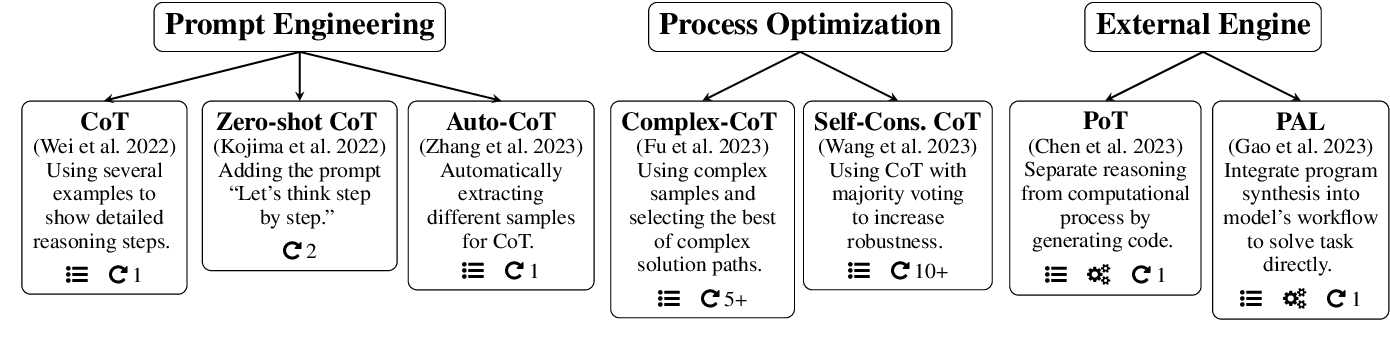
Figure 2 from Benchmarking Large Language Models for Math Reasoning ...
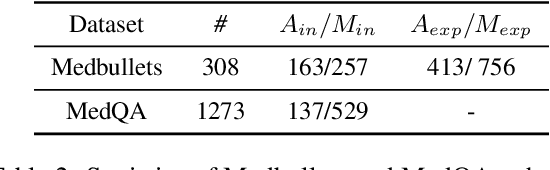
Table 2 from Benchmarking Large Language Models on Answering and ...

Table 2 from SEED-Bench-2: Benchmarking Multimodal Large Language ...

Table 2 from Large Language Model for Multi-Domain Translation ...
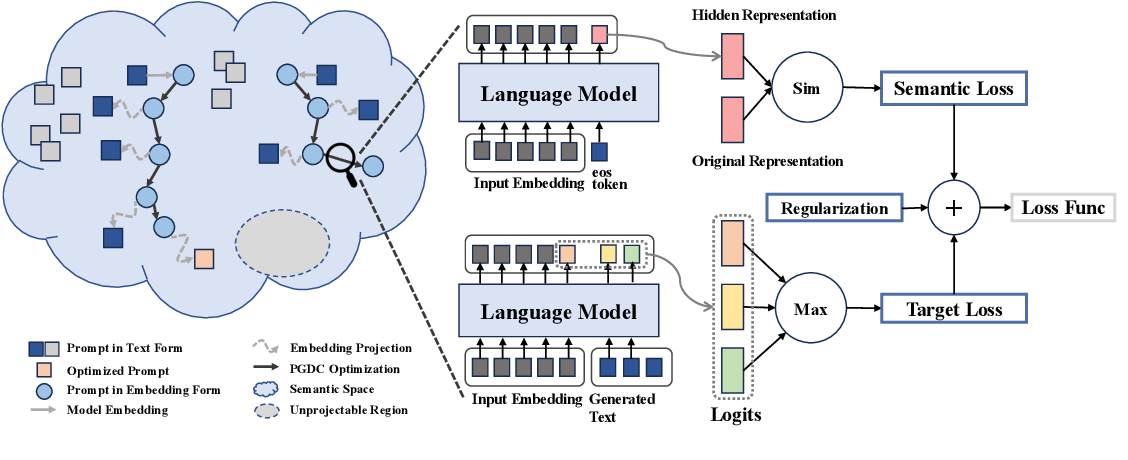
Figure 2 from Benchmarking Knowledge Boundary for Large Language Model ...
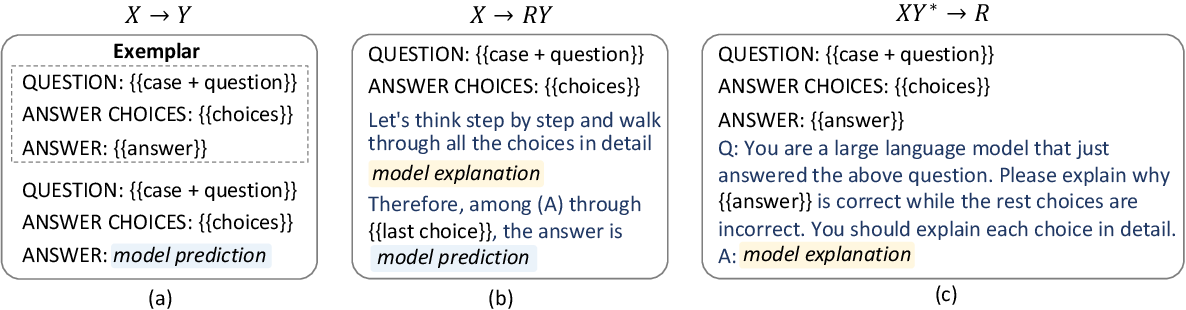
Figure 2 from Benchmarking Large Language Models on Answering and ...

Table 1 from Benchmarking Large Language Model Capabilities for ...

Table 3 from Large Language Models as Automated Aligners for ...

Table 1 from Benchmarking Knowledge Boundary for Large Language Model ...
Advertisement Space (336x280)

Table 1 from Benchmarking Hallucination in Large Language Models Based ...

Benchmarking Large Language Models for News Summarization

Benchmarking Multimodal Large Language Models for Missing Modality ...
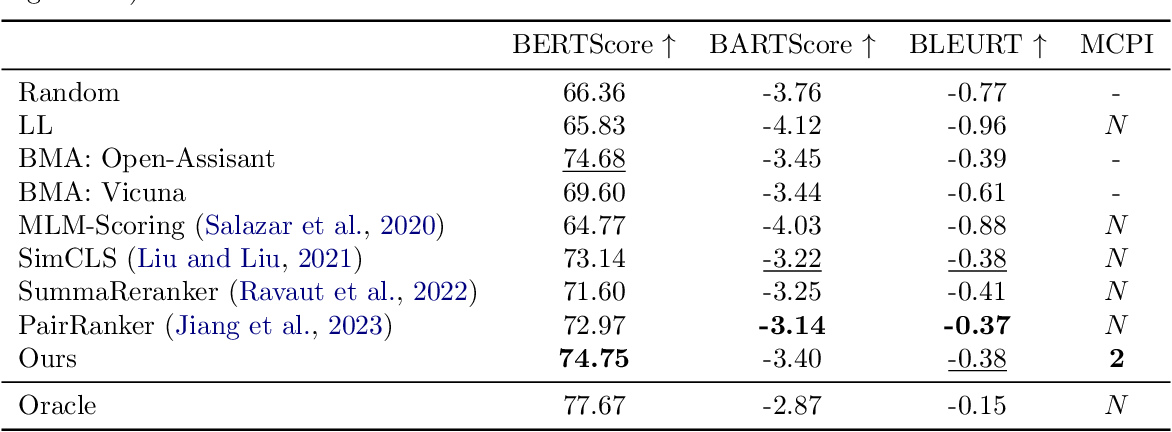
Table 2 from Large Language Model Routing with Benchmark Datasets ...

(PDF) Benchmarking Causal Study to Interpret Large Language Models for ...

Figure 2 from Synergizing Large Language Models and Task-specific ...

Paper page - TaskBench: Benchmarking Large Language Models for Task ...

(PDF) Benchmarking Large Language Models for Replication of Guideline ...

Benchmarking Large Language Models for Automated Verilog RTL Code ...

[2502.18993] MEBench: Benchmarking Large Language Models for Cross ...
Advertisement Space (336x280)

(PDF) Benchmarking Large Language Models for News Summarization

IdeaBench: Benchmarking Large Language Models for Research Idea Generation

Benchmarking Large Language Models from Open and Closed Source Models ...

[논문 리뷰] Benchmarking Large Language Models for Knowledge Graph Validation

Paper page - Benchmarking Large Language Models for Multi-Language ...

Table 1 from An Ensemble Method for Bug Triaging Using Large Language ...