
Figure 1 From Bottleneck Transformers For Visual Recognition Semantic
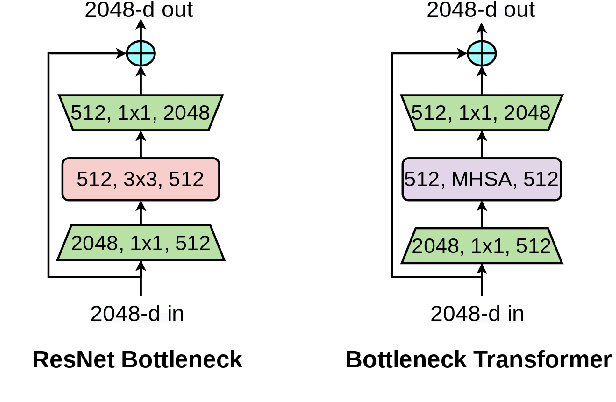
Figure 1 from Bottleneck Transformers for Visual Recognition | Semantic ...
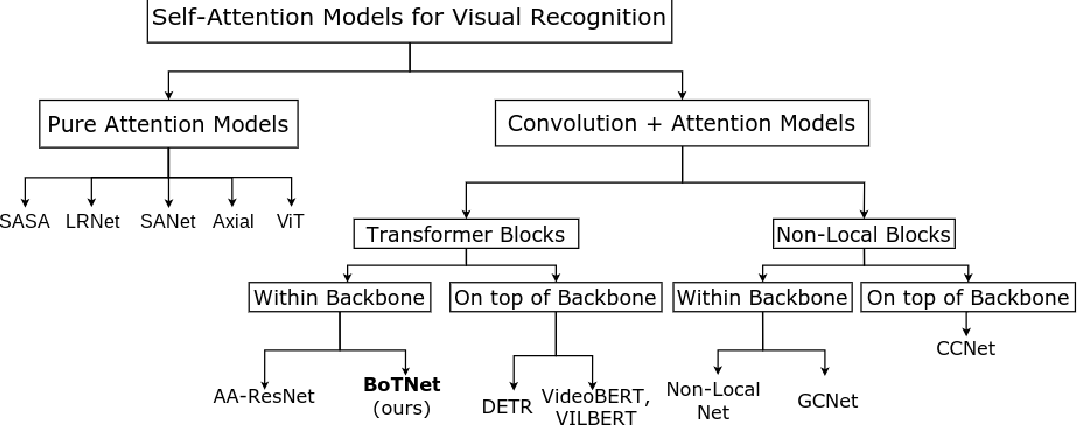
Figure 2 from Bottleneck Transformers for Visual Recognition | Semantic ...

Figure 1 from HAT: A Visual Transformer Model for Image Recognition ...

Figure 1 from Regressing Transformers for Data-efficient Visual Place ...
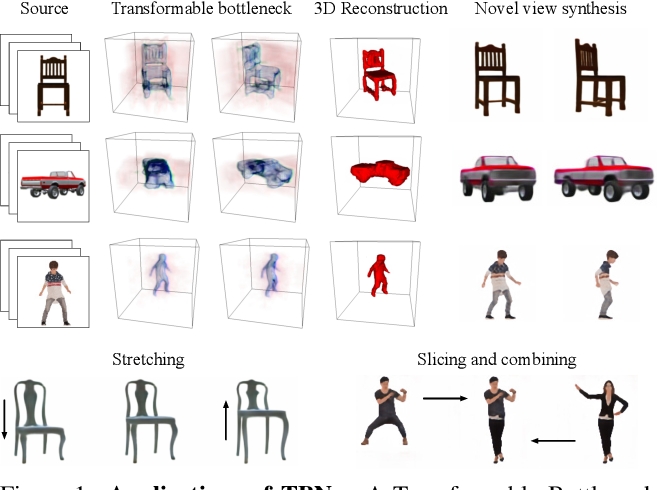
Figure 1 from Transformable Bottleneck Networks | Semantic Scholar

Figure 1 from Multi-scale Bottleneck Transformer for Weakly Supervised ...
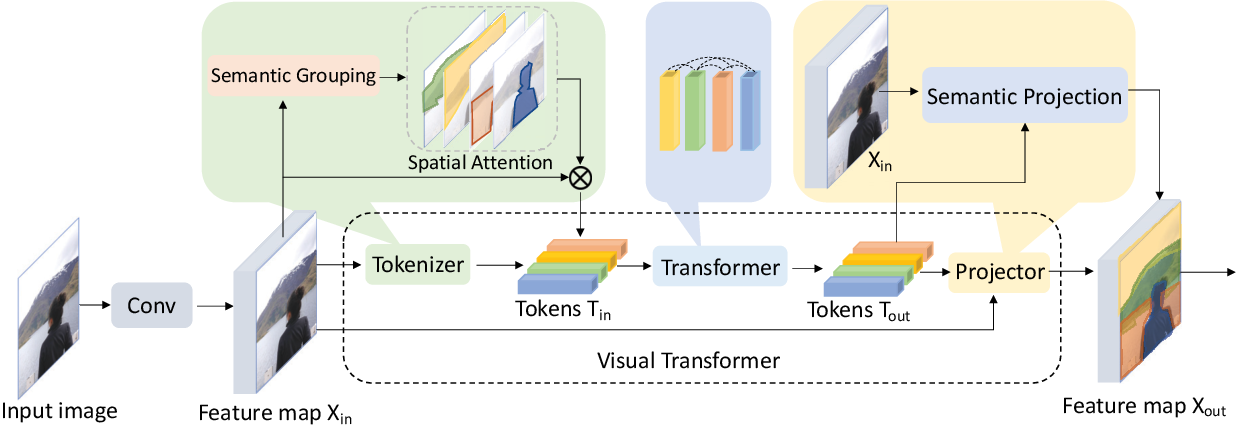
Figure 1 from Visual Transformers: Where Do Transformers Really Belong ...

Figure 1 from Learning Bottleneck Transformer for Event Image-Voxel ...

Bottleneck Transformers for Visual Recognition 阅读 - 知乎

Paper page - Bottleneck Transformers for Visual Recognition
Advertisement Space (300x250)

Bottleneck Transformers for Visual Recognition

Figure 1 from Efficient Training for Visual Tracking with Deformable ...

Figure 1 from Emotion Recognition Using Transformers with Masked ...

Figure 1 from VVGT: Visual Volume-Grounded Transformer | Semantic Scholar

Figure 1 from A Transformer-Based Framework for Scene Text Recognition ...

Figure 1 from Visual-Semantic Transformer for Scene Text Recognition ...
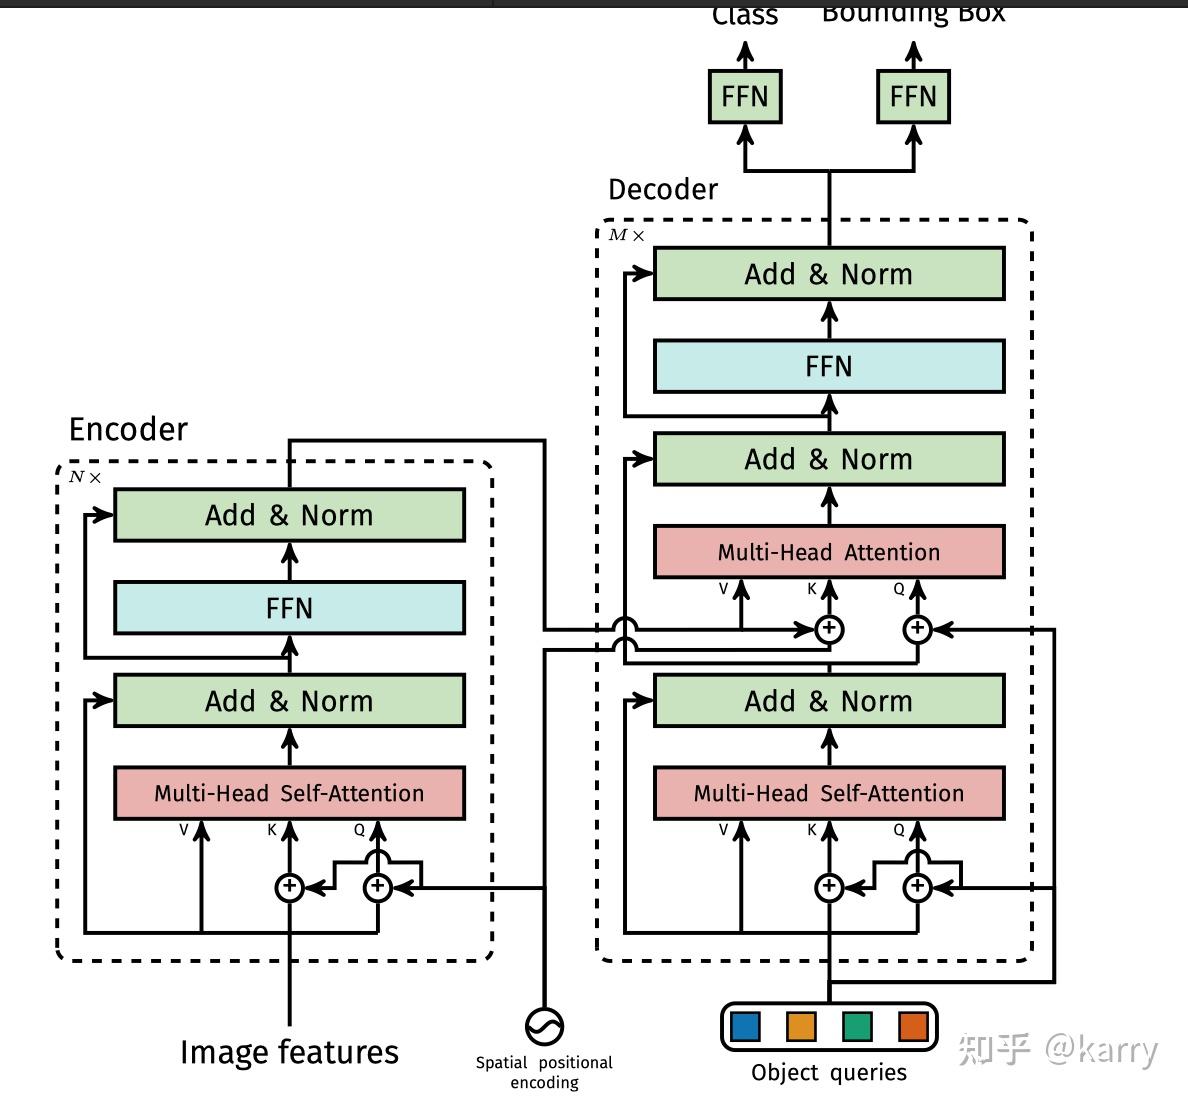
Bottleneck Transformers for Visual Recognition 阅读 - 知乎

Figure 1 from High-Precision Transformer-Based Visual Servoing for ...
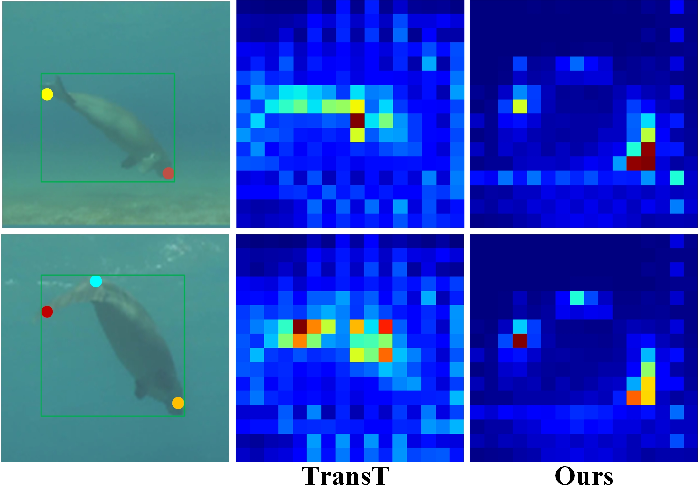
Figure 1 from Learning Spatial-Frequency Transformer for Visual Object ...

[2101.11605] Bottleneck Transformers For Visual Recognition – ZKRJU
Advertisement Space (336x280)

Figure 1 from Learning to Mask and Permute Visual Tokens for Vision ...

Bottleneck Transformers for Visual Recognition / bottleneck ...

Figure 1 from Language Bottleneck Models for Qualitative Knowledge ...

Figure 1 from A Transformer-Based Framework for Scene Text Recognition ...

Figure 1 from Language Guided Concept Bottleneck Models for ...

Figure 1 from Exploring Vision Transformer Layer Choosing for Semantic ...

Figure 1 from Group-wise Contrastive Bottleneck for Weakly-Supervised ...
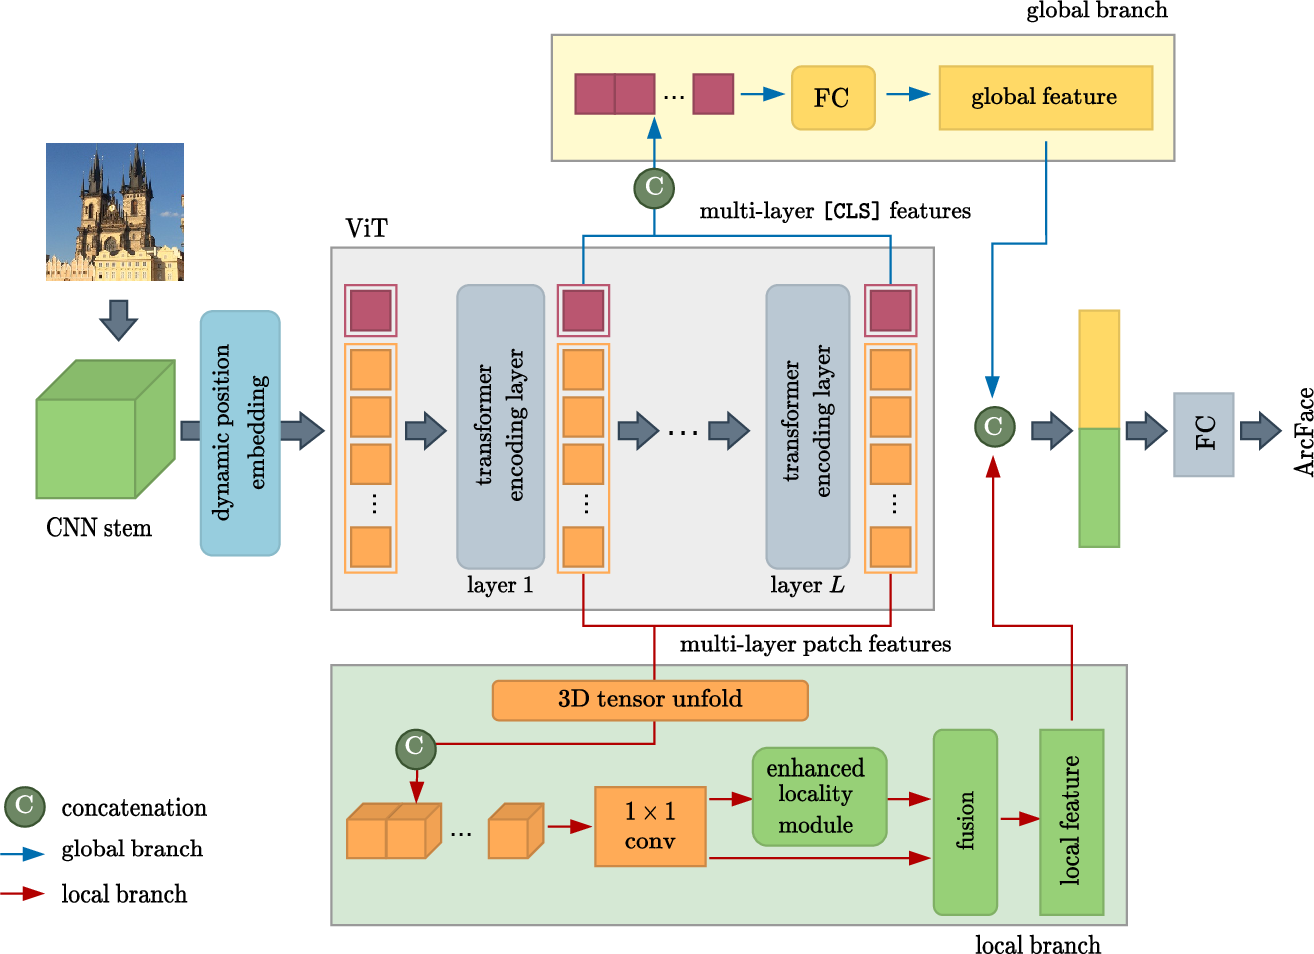
Figure 1 from Boosting vision transformers for image retrieval ...

Bottleneck Transformers for Visual Recognition | DeepAI

Figure 1 from Interactive Concept Bottleneck Models | Semantic Scholar
Advertisement Space (336x280)

Figure 1 from Pedestrian Multi-Object Tracking with Bottleneck ...

BottleneckTransformers:Bottleneck Transformers for Visual Recognition ...

BoTNet:Bottleneck Transformers for Visual Recognition - 知乎

Figure 1 from Vision Transformers are Parameter-Efficient Audio-Visual ...

Figure 1 from Semantic-visual Guided Transformer for Few-shot Class ...

Figure 1 from Video Relation Detection via Tracklet based Visual ...