
Figure 1 From Cross Document Annotation For Multimedia Retrieval
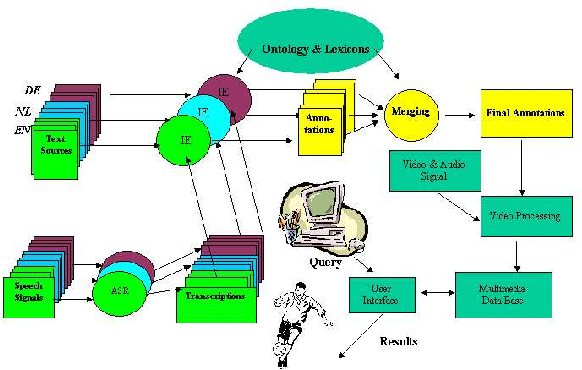
Figure 1 from Cross document annotation for multimedia retrieval ...
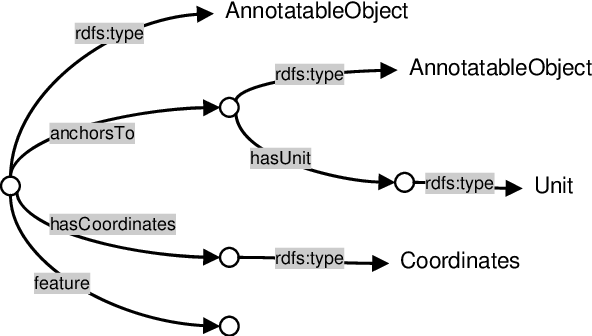
Figure 1 from A Common Multimedia Annotation Framework for Cross ...
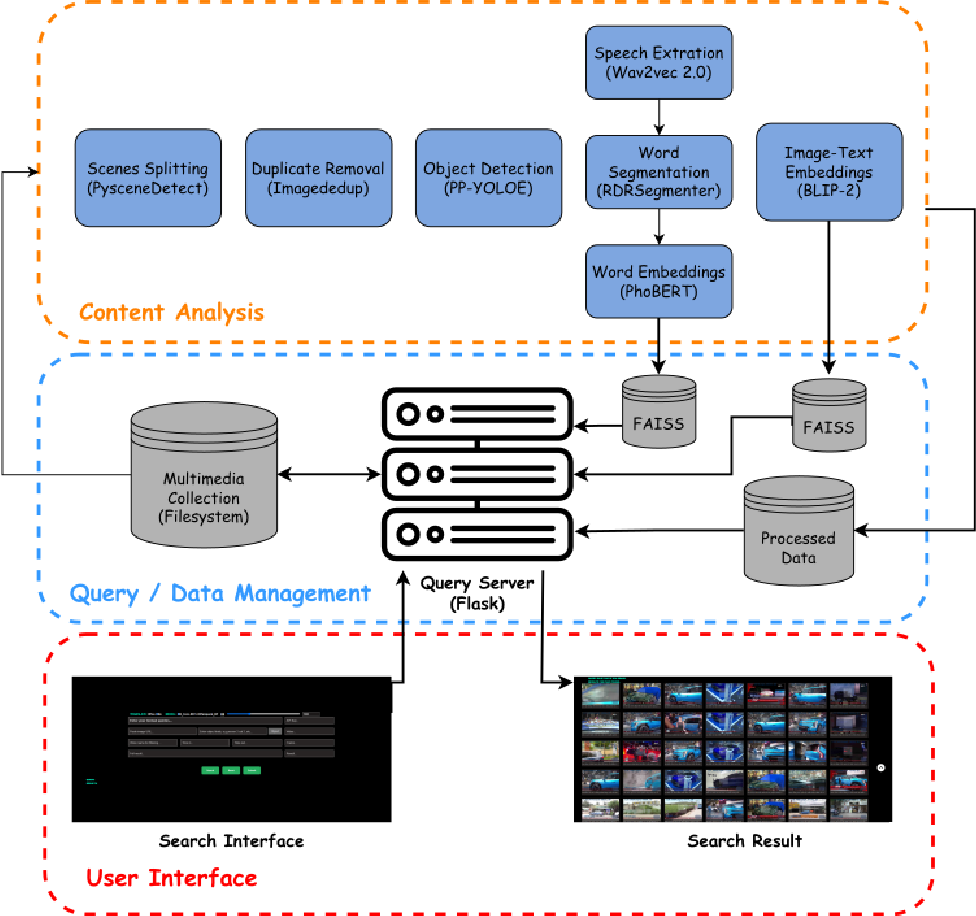
Figure 1 from An Interactive System for Multimedia Retrieval in Video ...
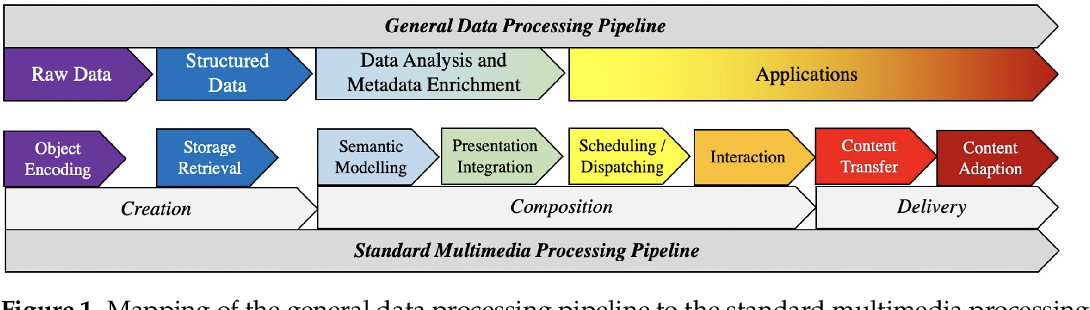
Figure 1 from AI-Based Semantic Multimedia Indexing and Retrieval for ...
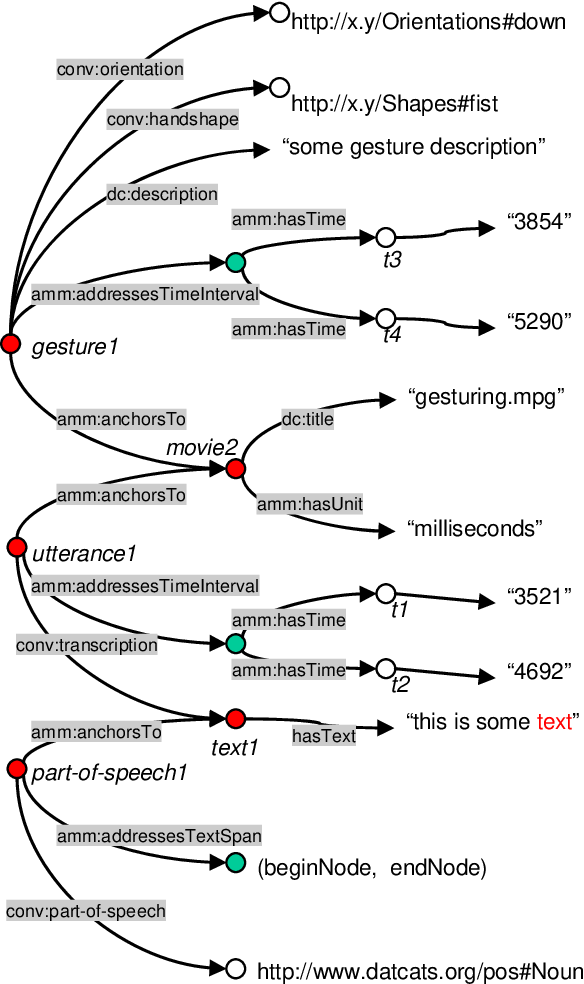
Figure 3 from A Common Multimedia Annotation Framework for Cross ...
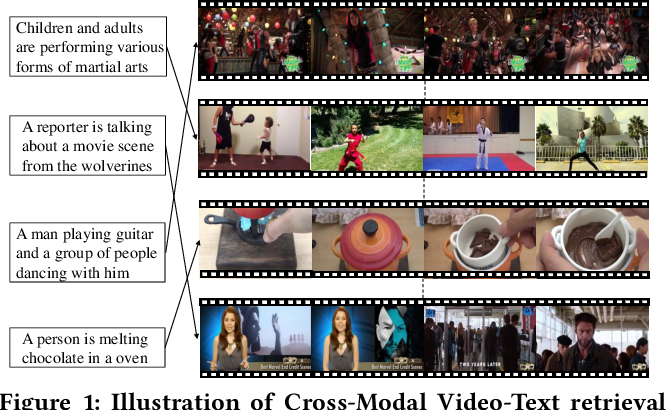
Figure 1 from Learning Joint Embedding with Multimodal Cues for Cross ...

Figure 1 from Active learning in multimedia annotation and retrieval: A ...

Figure 1 from A new approach to cross-modal multimedia retrieval ...

Figure 1 from Unifying Multimodal Retrieval via Document Screenshot ...

Figure 1 from Combining Multimedia Retrieval and Text Retrieval to ...
Advertisement Space (300x250)

Figure 1 from A Knowledge-Driven Multimedia Retrieval System Based on ...

Figure 1 from Content-based Multimedia Indexing and Retrieval ...

Figure 1 from Multimedia Retrieval of Historical Materials | Semantic ...
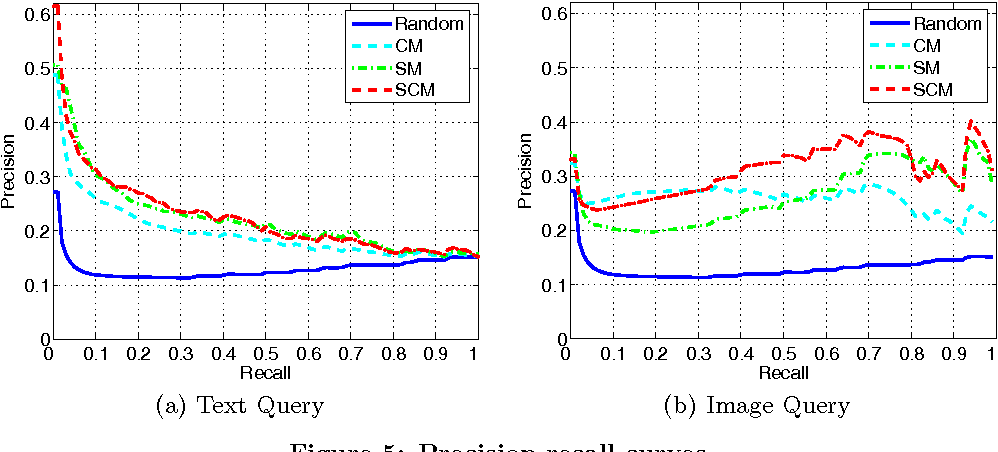
Figure 1 from A new approach to cross-modal multimedia retrieval ...
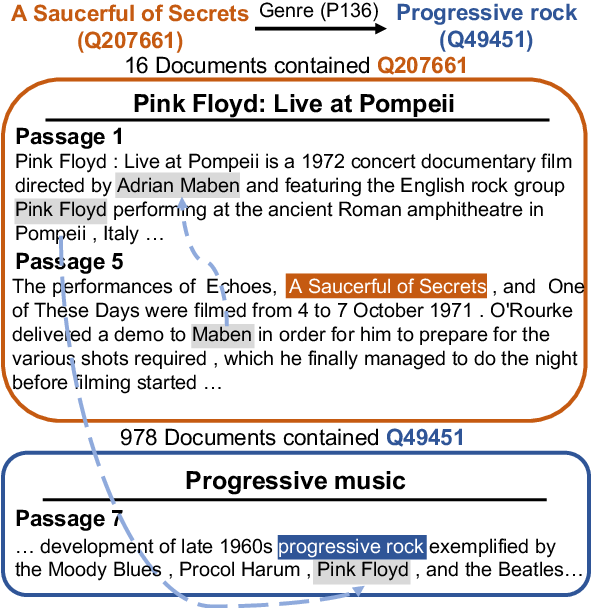
Figure 1 from Multi-hop Evidence Retrieval for Cross-document Relation ...

Figure 1 from Machine Learning and Content-Based Multimedia Retrieval ...

Figure 1 from A new approach to cross-modal multimedia retrieval ...
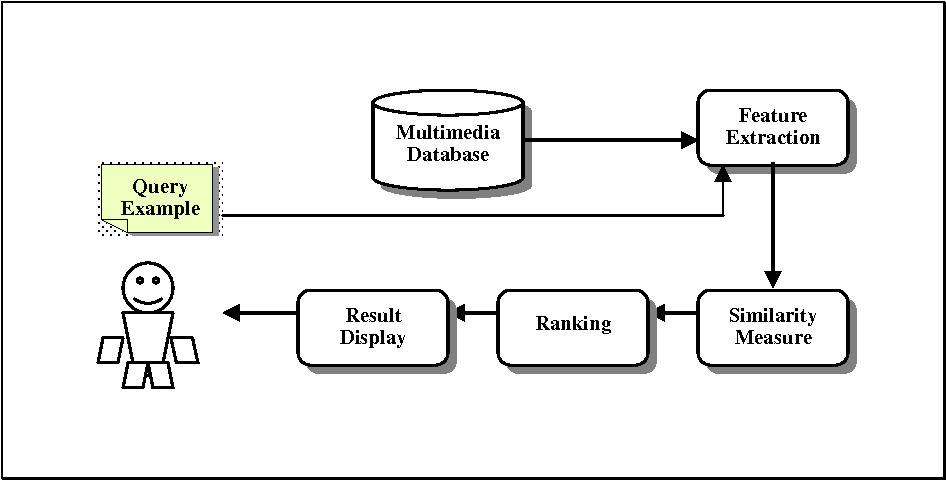
Figure 1 from Design of Content-based Multimedia Retrieval | Semantic ...

Figure 1 from Multi Document Summarization: A Cross Document Structure ...
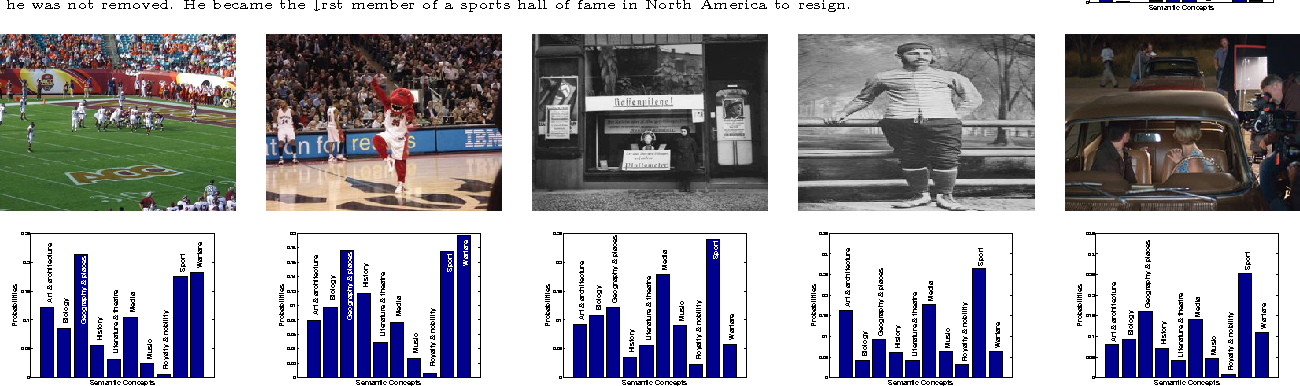
Figure 1 from A new approach to cross-modal multimedia retrieval ...
Advertisement Space (336x280)

Figure 1 from Multi-View Document Representation Learning for Open ...
Figure 1 from A new approach to cross-modal multimedia retrieval ...

Figure 1 from Annotation of Multimedia data using Semantic Metadata ...
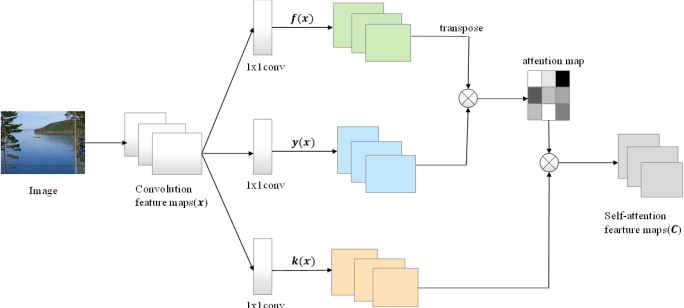
Figure 1 from Cross-Media Retrieval Based on Two-Level Similarity and ...
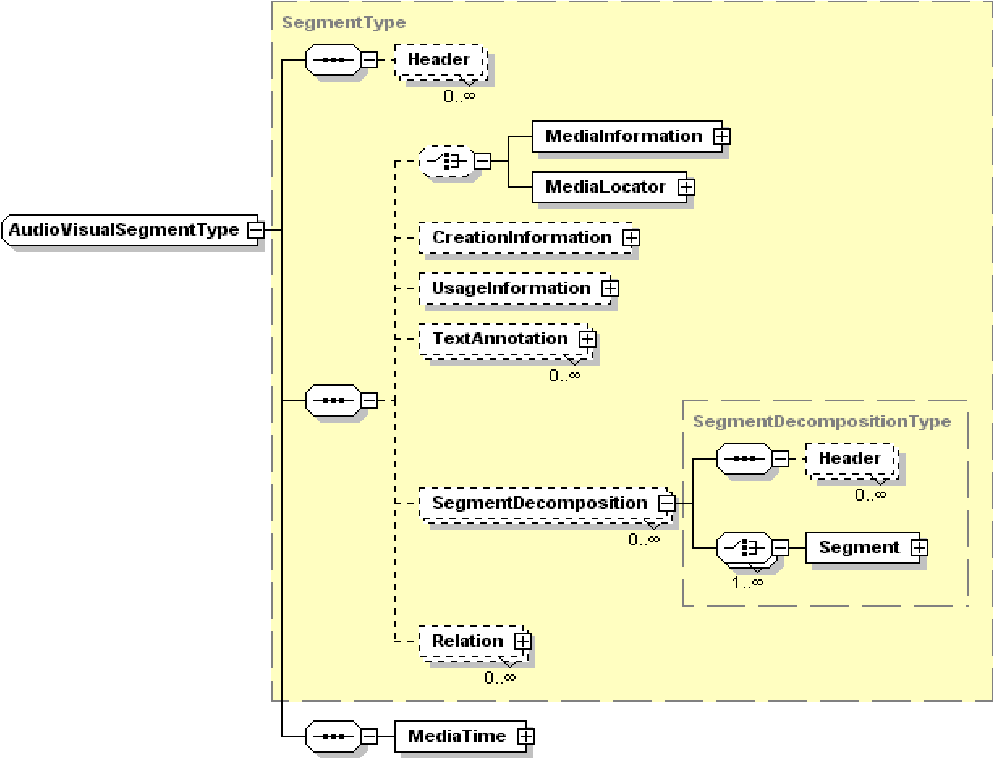
Figure 1 from How to retrieve multimedia documents described by MPEG-7 ...
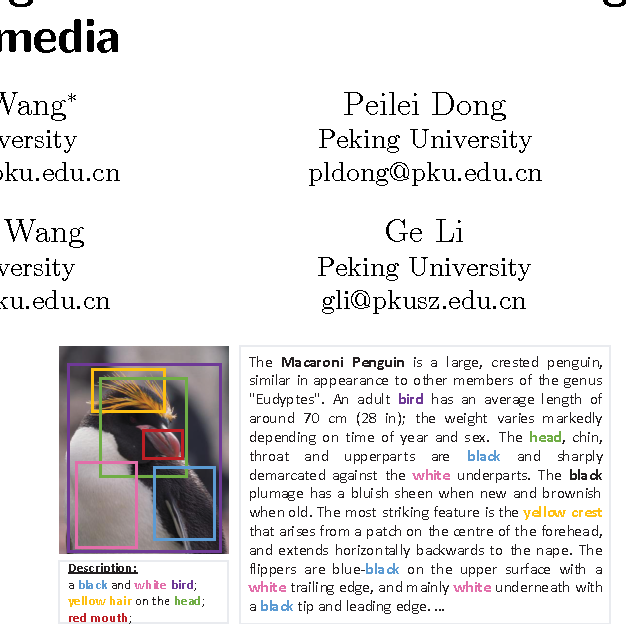
Figure 1 from Cross-media Retrieval by Learning Rich Semantic ...

Figure 1 from CodRED: A Cross-Document Relation Extraction Dataset for ...

Figure 1 from A Method of Annotation Extraction from Paper Documents ...

Figure 1 from AToMiC: An Image/Text Retrieval Test Collection to ...

Figure 1 from CMMT: Cross-Modal Meta-Transformer for Video-Text ...
Advertisement Space (336x280)
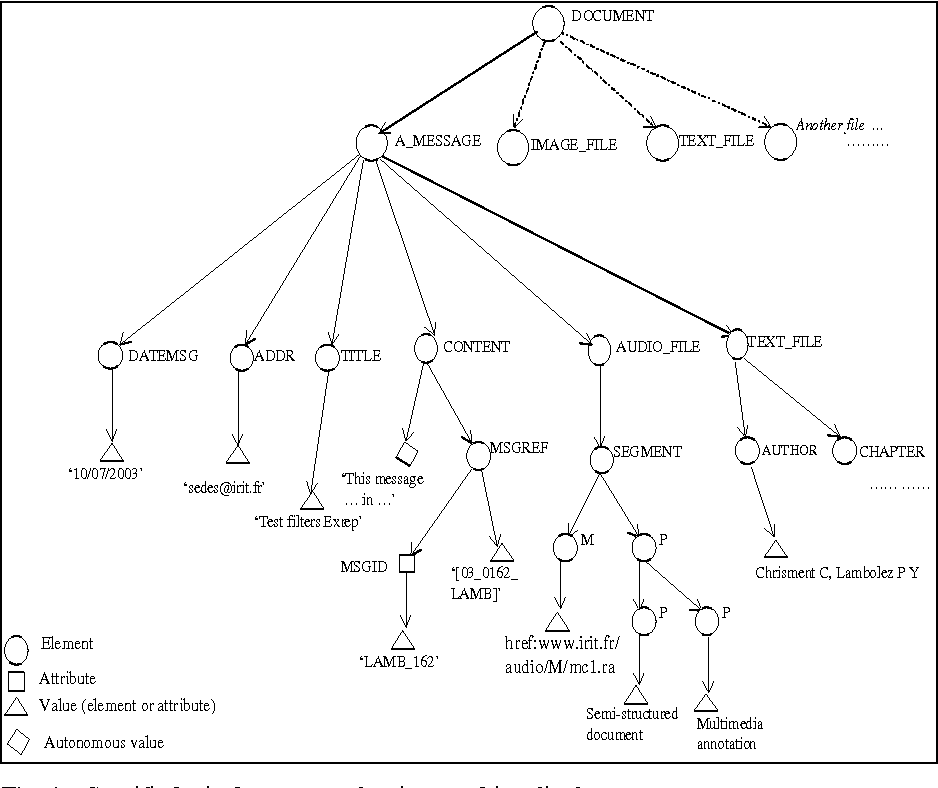
Figure 1 from A CONTRIBUTION TO M ULTIM EDIA DOCUM ENT ANNOTATION AND ...

Figure 1 from WEB INFORMATION RETRIEVAL USING AUTOMATIC MULTI-DOCUMENT ...

Figure 1 from Multi-granularity Separation Network for Text-Based ...

Figure 1 from How Good is a Recommender in Machine-Assisted Cross ...

(PDF) On Annotation of Video Content for Multimedia Retrieval and Sharing
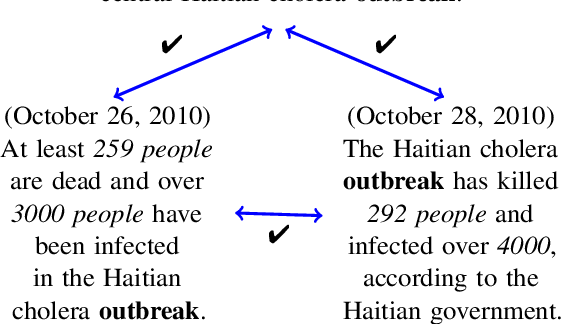
Figure 1 from Cross-document Event Identity via Dense Annotation ...