
Figure 1 From Learning Joint Embedding With Multimodal Cues For Cross
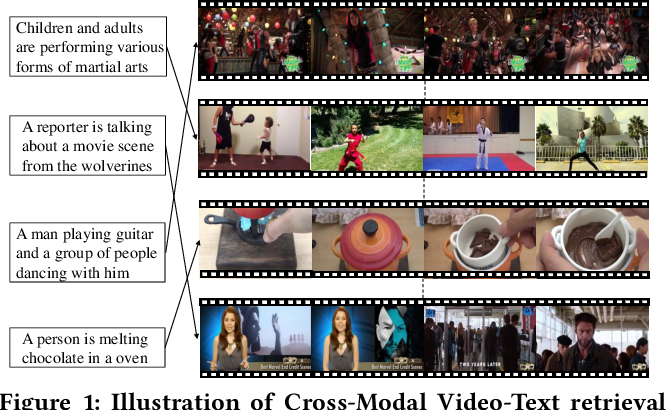
Figure 1 from Learning Joint Embedding with Multimodal Cues for Cross ...

Figure 1 from Joint Embedding with Multi-Task Learning for Multi-Label ...

Figure 1 from Learning Text-image Joint Embedding for Efficient Cross ...

Figure 1 from Learning Joint Embedding for Cross-Modal Retrieval ...
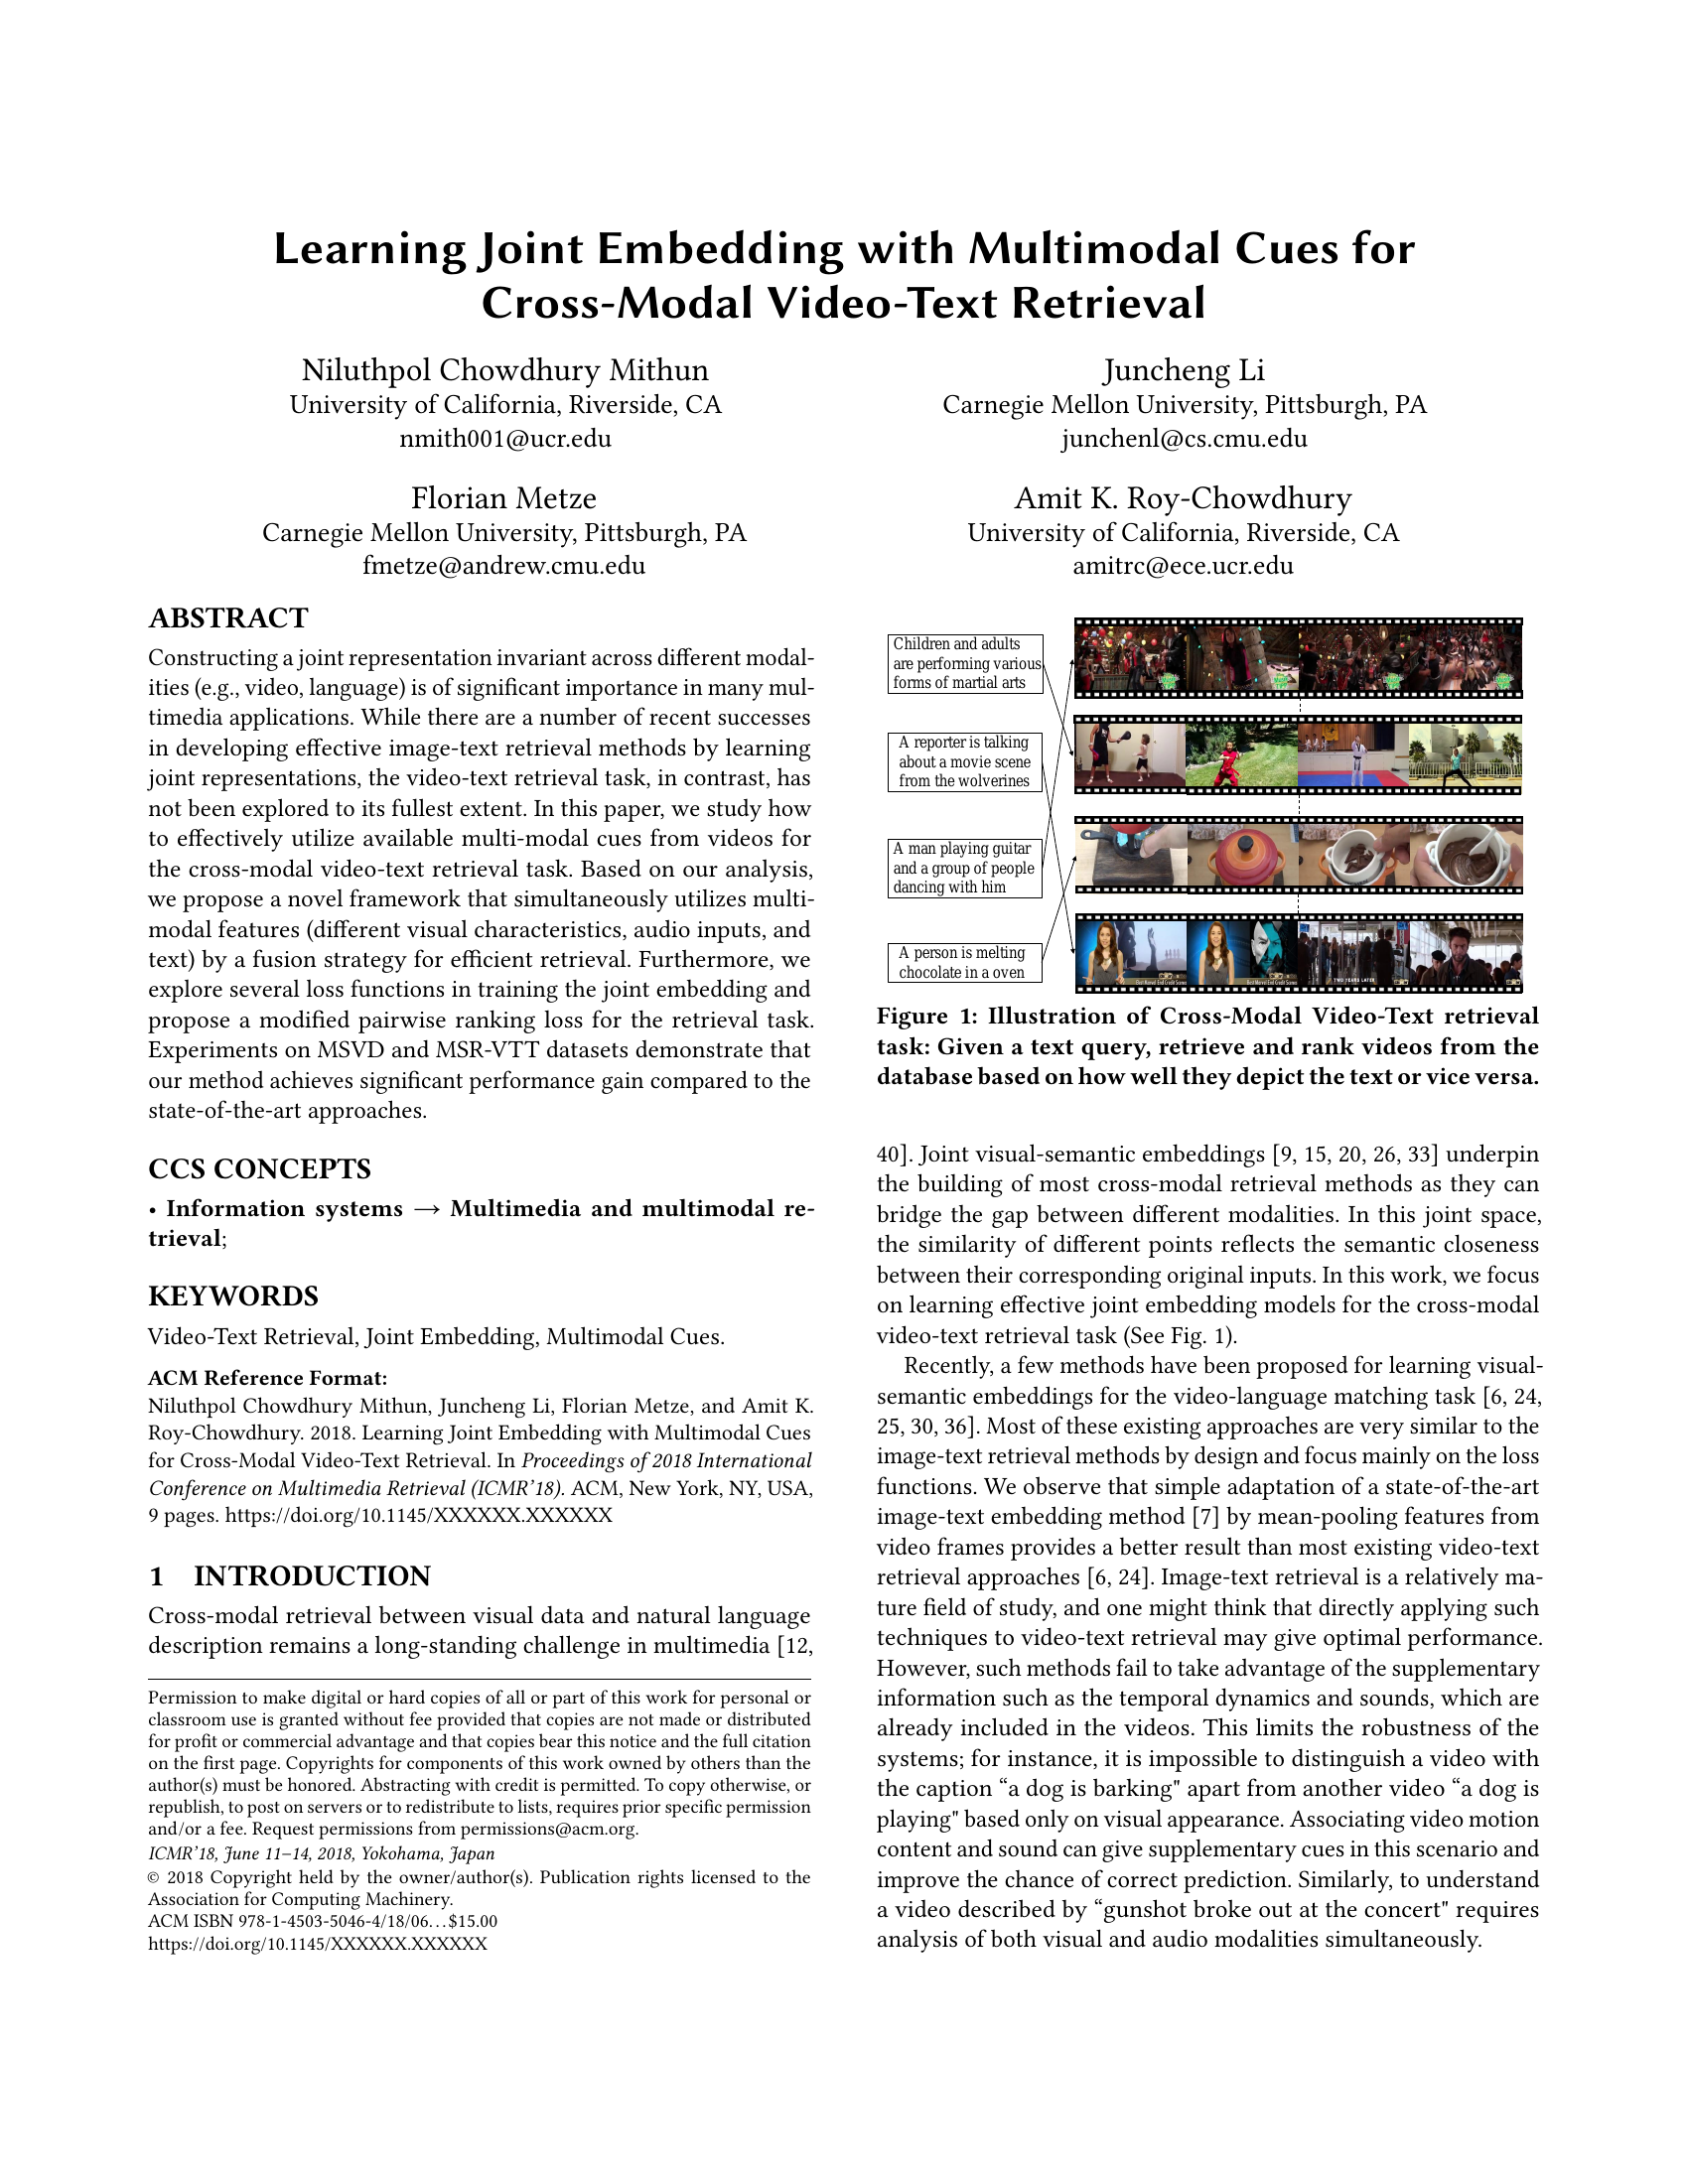
Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...

Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...

Figure 1 from Multi-Task Joint Learning for Embedding Aware Audio ...
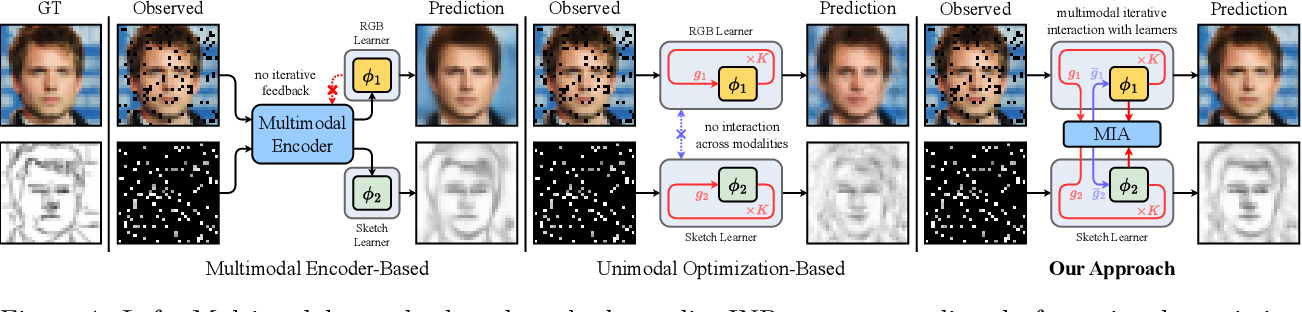
Figure 1 from Meta-Learning Approach for Joint Multimodal Signals with ...
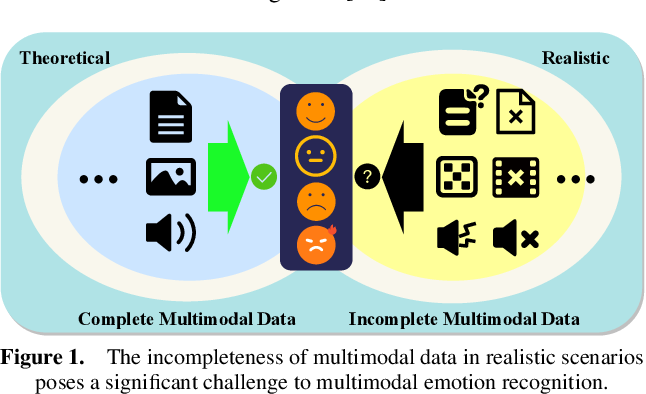
Figure 1 from Learning Noise-Robust Joint Representation for Multimodal ...

Figure 1 from A Multi-View Joint Learning Framework for Embedding ...
Advertisement Space (300x250)

Figure 1 from Multimodal Reinforcement Learning for Embedding Networks ...
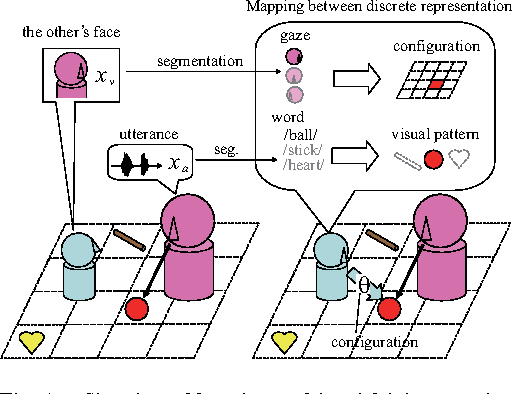
Figure 1 from Multimodal joint attention through cross facilitative ...

Figure 1 from Appearance Codes using Joint Embedding Learning of ...
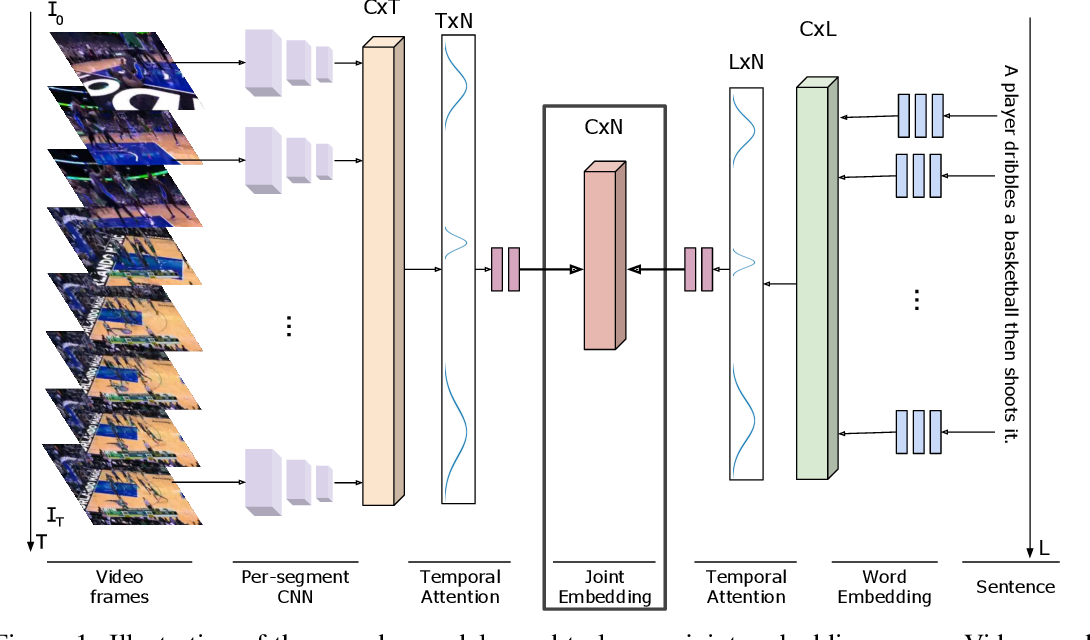
Figure 1 from Learning Shared Multimodal Embeddings with Unpaired Data ...
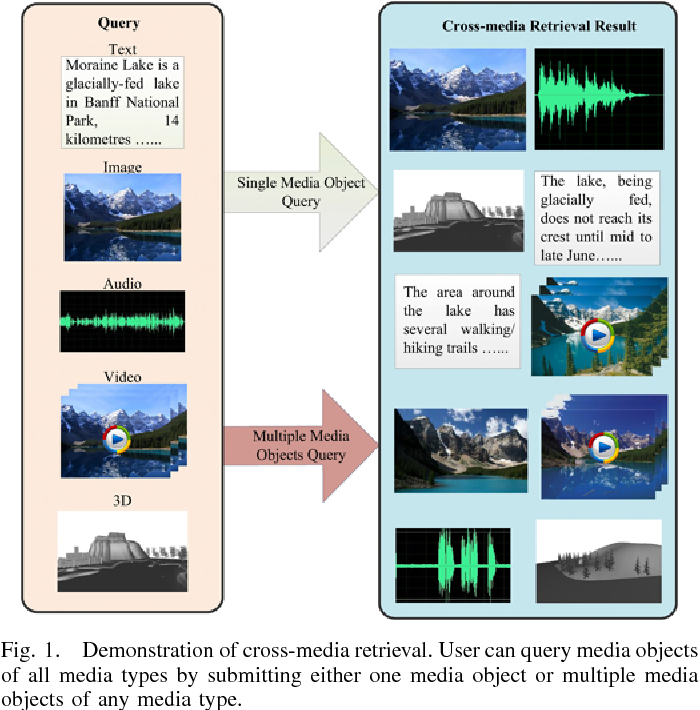
Figure 1 from Learning Cross-Media Joint Representation With Sparse and ...

Figure 1 from Joint Multimodal Transformer for Dimensional Emotional ...
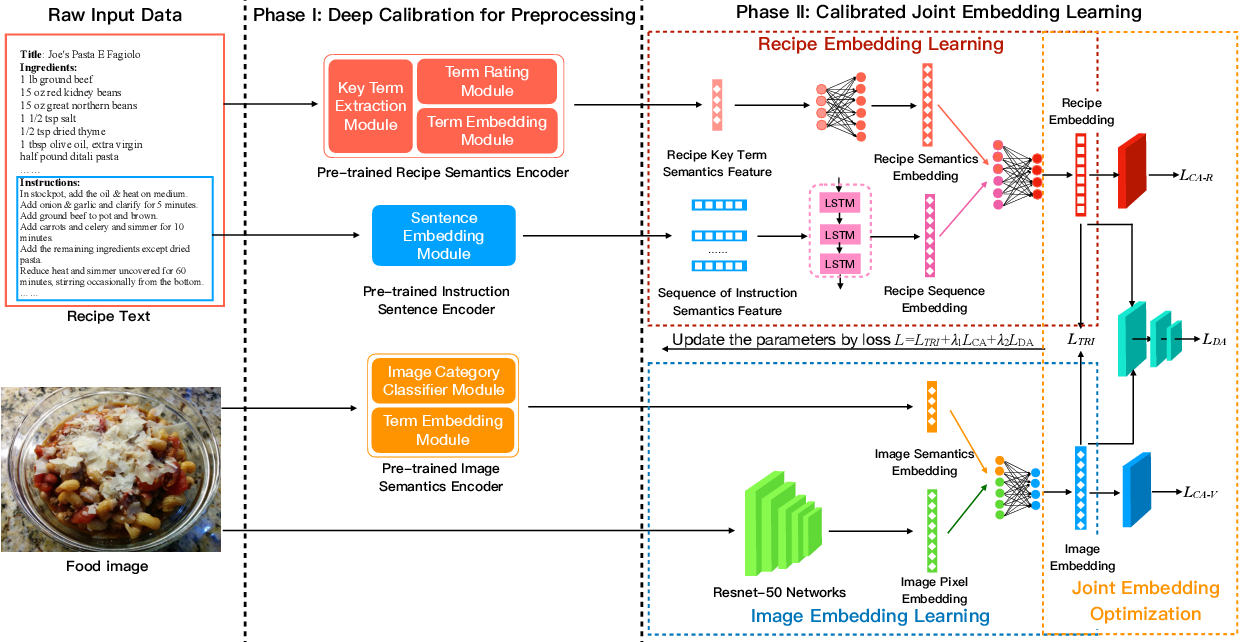
Figure 1 from Efficient Deep Feature Calibration for Cross-Modal Joint ...

Figure 1 from CMJRT: Cross-Modal Joint Representation Transformer for ...

Figure 1 from Communication-Efficient Multimodal Federated Learning ...

Figure 1 from Dense Graph Convolutional With Joint Cross-Attention ...
Advertisement Space (336x280)

Figure 1 from Missing Modality Prediction for Unpaired Multimodal ...

(PDF) Joint embeddings with multimodal cues for video-text retrieval

Figure 1 from Cross-Linked Unified Embedding for cross-modality ...
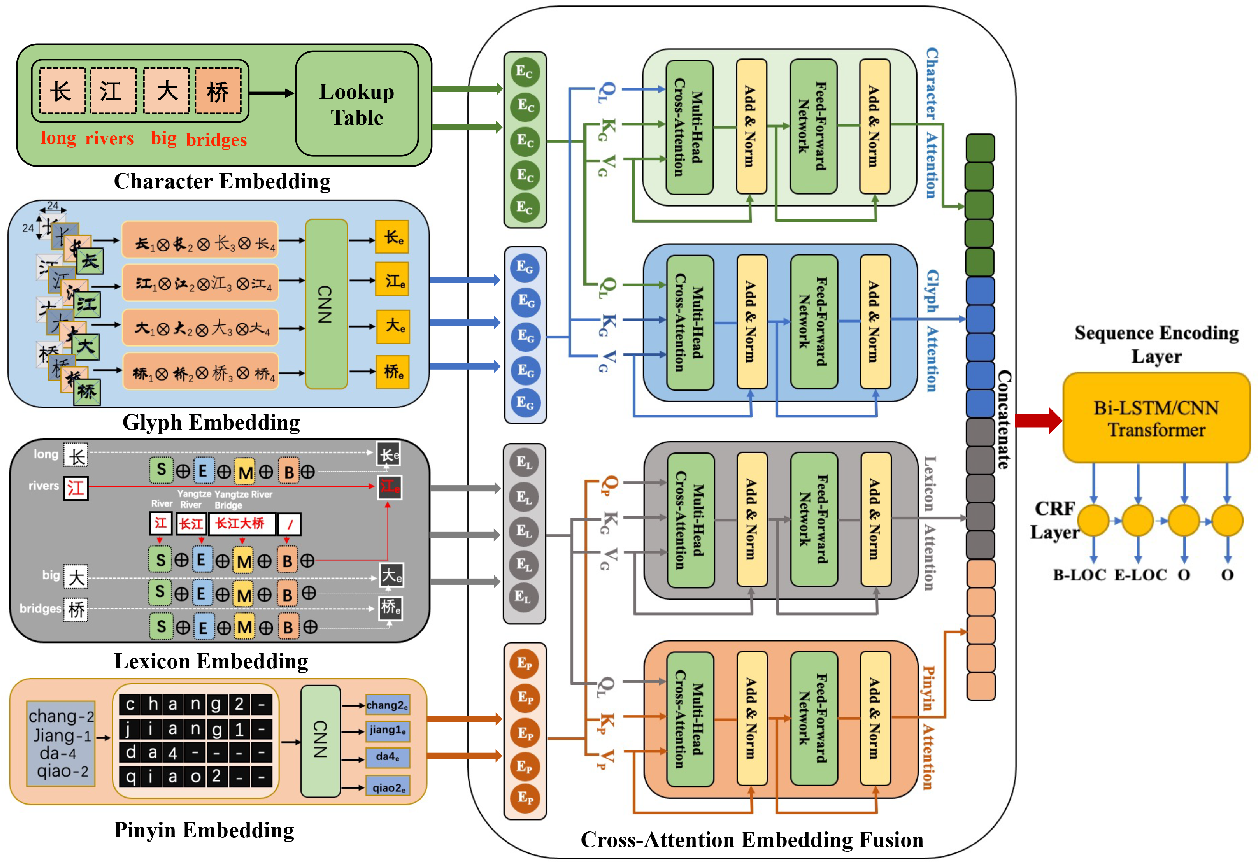
Figure 1 from CLGP: Multi-Feature Embedding based Cross-Attention for ...

Figure 1 from MultiSense: Cross Labelling and Learning Human Activities ...

Figure 2 from Cross Model Attention based Deep Learning for Multi Modal ...

Figure 1 from Cross-Modal Mutual Learning for Audio-Visual Speech ...
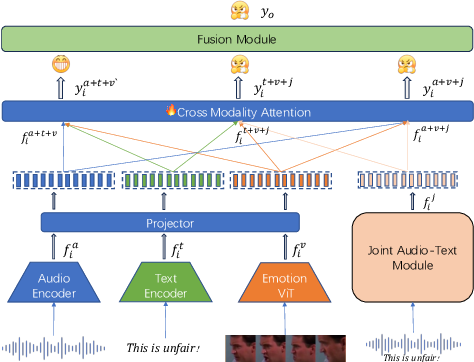
Figure 1 from Early Joint Learning of Emotion Information Makes ...

Figure 6 from Learning Multimodal Cues of Children’s Uncertainty ...
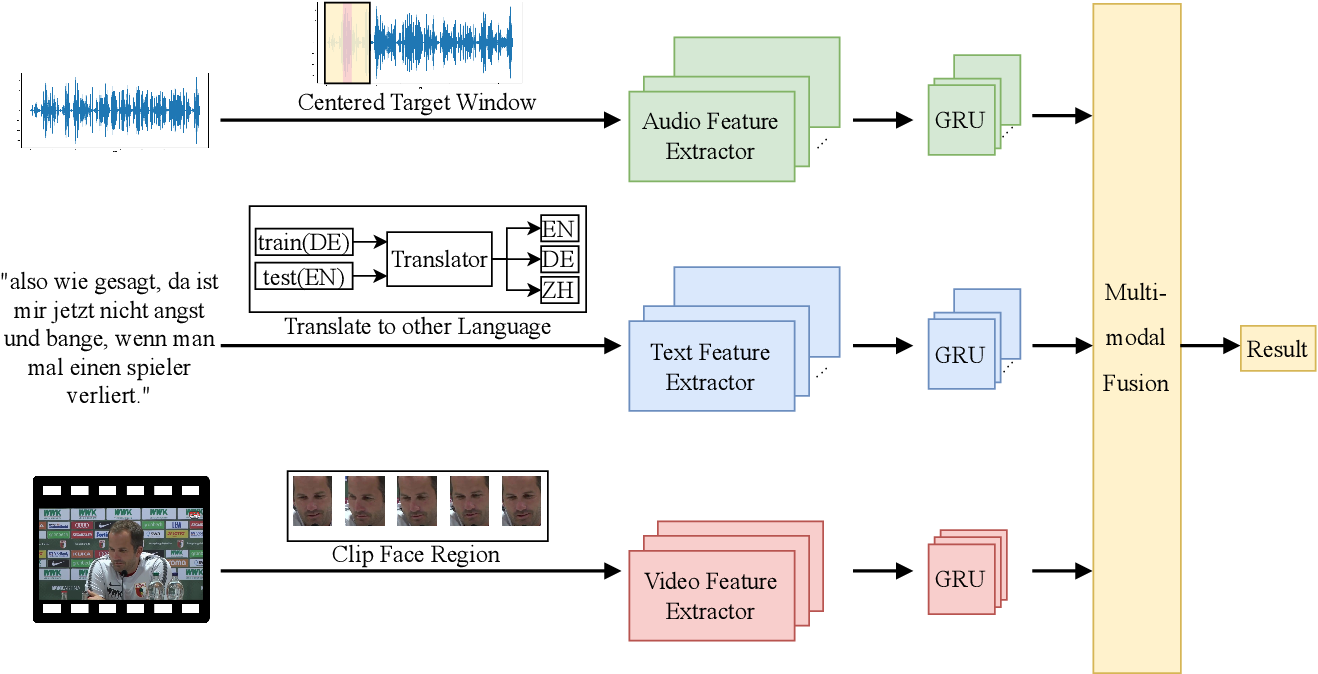
Figure 1 from Multimodal Cross-Lingual Features and Weight Fusion for ...
Advertisement Space (336x280)

Figure 1 from CEmb-SAM: Segment Anything Model with Condition Embedding ...

(PDF) Learning Joint Embedding for Cross-Modal Retrieval

Embedding Alignment for Multimodal Learning | AI Tutorial | Next ...

Learning TFIDF Enhanced Joint Embedding for Recipe-Image Cross-Modal ...

Joint Multimodal Contrastive Learning for Robust Spoken Term Detection ...

PianoBind: A Multimodal Joint Embedding Model for Pop-piano Music | AI ...