
Figure 1 From Cross Modality Pyramid Alignment For Visual Intention

Figure 1 from Cross-Modality Pyramid Alignment for Visual Intention ...

Figure 1 from A Universal Model for Cross Modality Mapping by ...

Figure 1 from Learning Modality Knowledge Alignment for Cross-Modality ...

Figure 1 from Fusional Modality and Distribution Alignment Learning for ...

Figure 1 from Prototype-guided Cross-modal Completion and Alignment for ...

Figure 1 from Improving Cross-modal Alignment for Text-Guided Image ...

Figure 1 from CA_DeepSC: Cross-Modal Alignment for Multi-Modal Semantic ...

Figure 1 from Cross-Modal Translation and Alignment for Survival ...

Figure 1 from Cross-Modal Cross-Domain Moment Alignment Network for ...

Figure 1 from Memory-Based Cross-Modal Semantic Alignment Network for ...
Advertisement Space (300x250)
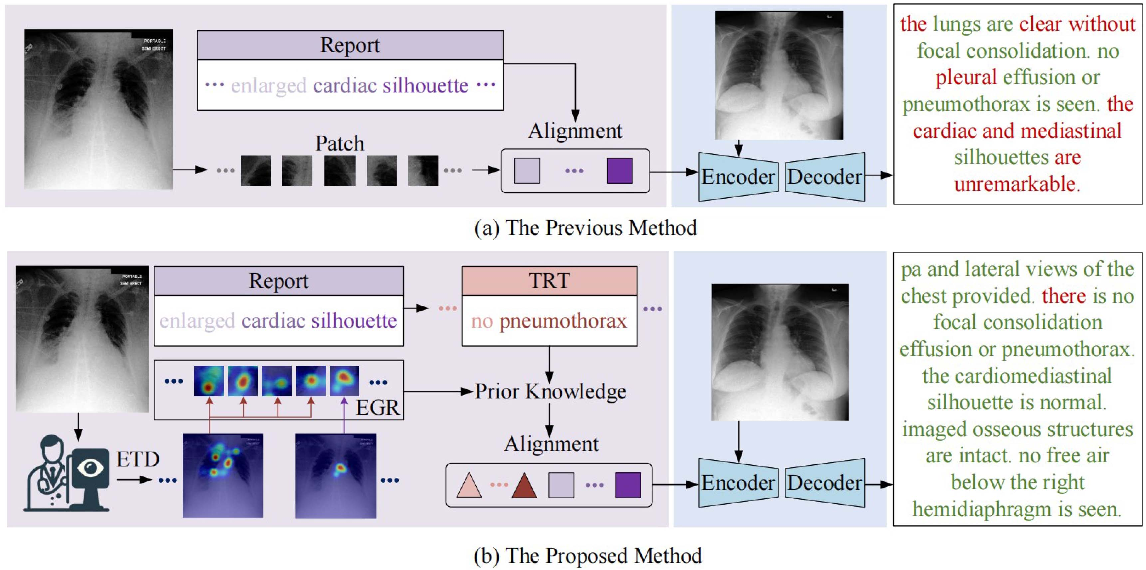
Figure 1 from Eye Gaze Guided Cross-Modal Alignment Network for ...

Figure 1 from Multi-modal Entity Alignment under Imbalanced Visual ...
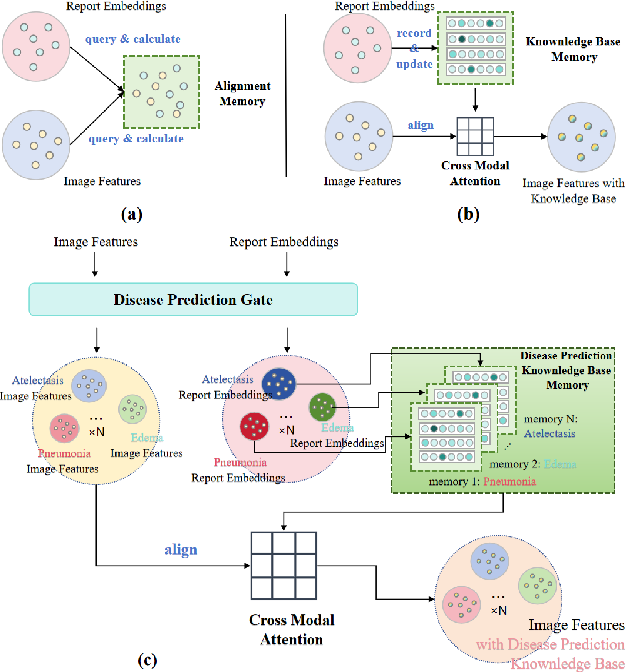
Figure 1 from Adaptive Semantic Alignment for Automated Radiology ...

Figure 1 from Cross-Modal Cross-Domain Dual Alignment Network for RGB ...

Figure 1 from Cross-Modal Global Interaction and Local Alignment for ...

Figure 1 from CAD - Contextual Multi-modal Alignment for Dynamic AVQA ...
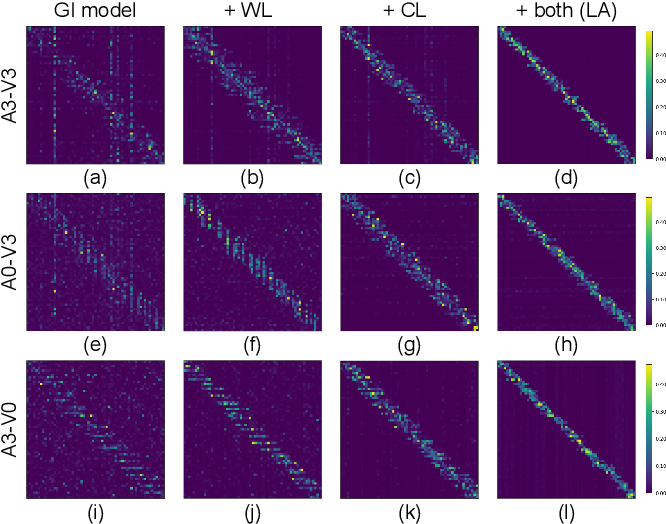
Figure 1 from Cross-Modal Global Interaction and Local Alignment for ...

Figure 2 from Modality Alignment between Deep Representations for ...
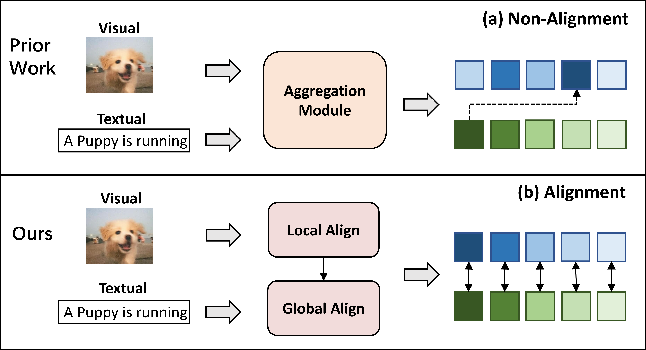
Figure 1 from Modality Alignment with Multi-scale Bilateral Attention ...

Figure 1 from Cross-Modal and Uni-Modal Soft-Label Alignment for Image ...
Advertisement Space (336x280)

Figure 1 from Pose-Guided Modality-Invariant Feature Alignment for ...

Figure 1 from Multi-Modal Cross-Domain Alignment Network for Video ...

Figure 1 from Multi-Prompts Learning with Cross-Modal Alignment for ...

Figure 1 from Multi-level Cross-modal Alignment for Image Clustering ...

Figure 1 from Enhancing Visual-Language Modality Alignment in Large ...

Figure 1 from Modality Alignment with Multi-scale Bilateral Attention ...

Figure 1 from Cross-modal Feature Alignment and Fusion for Composed ...

Figure 1 from Cross-Domain Modality Fusion for Dense Video Captioning ...

Figure 1 from Discrete Joint Semantic Alignment Hashing for Cross-Modal ...
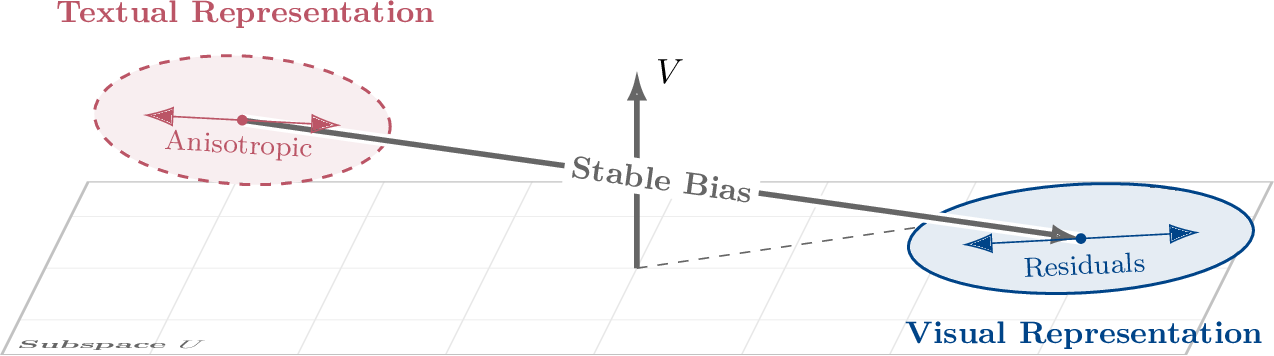
Figure 1 from Modality Gap-Driven Subspace Alignment Training Paradigm ...
Advertisement Space (336x280)

Figure 4 from Multi-level Alignment Network for Domain Adaptive Cross ...

Figure 1 from Unbiased Embodied Visual Representation Learning with ...
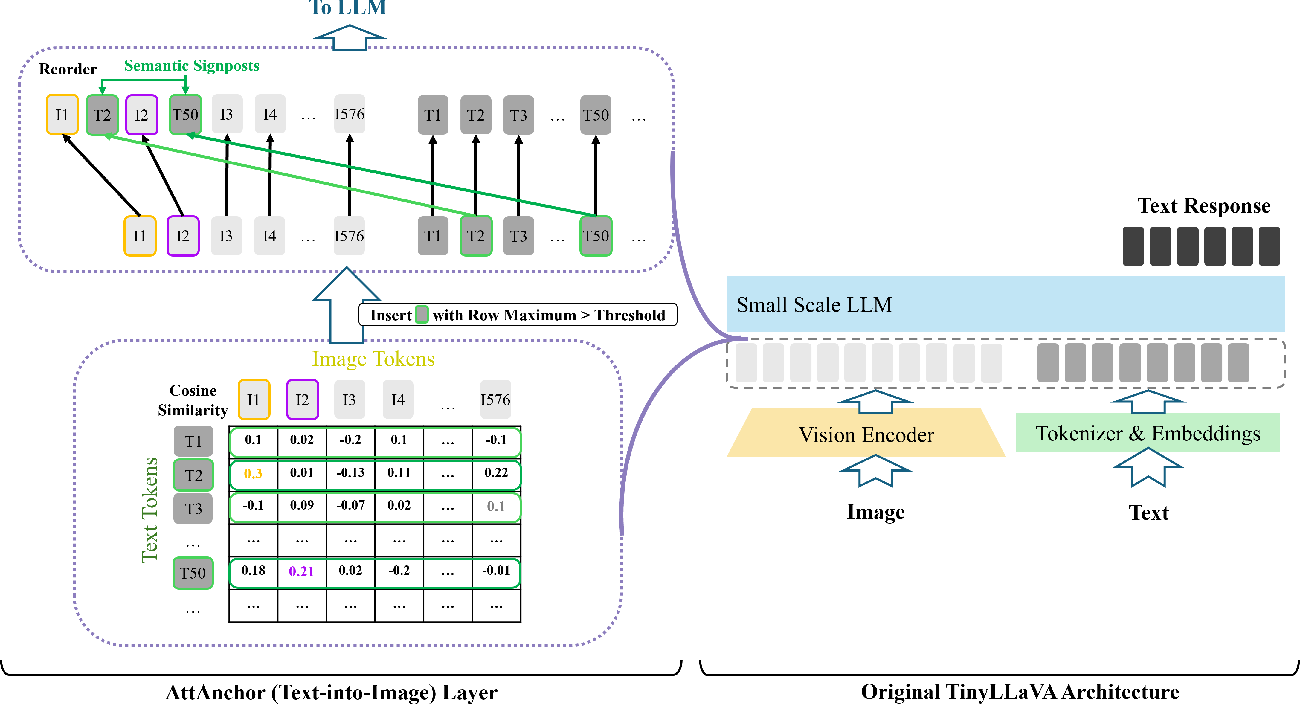
Figure 1 from AttAnchor: Guiding Cross-Modal Token Alignment in VLMs ...
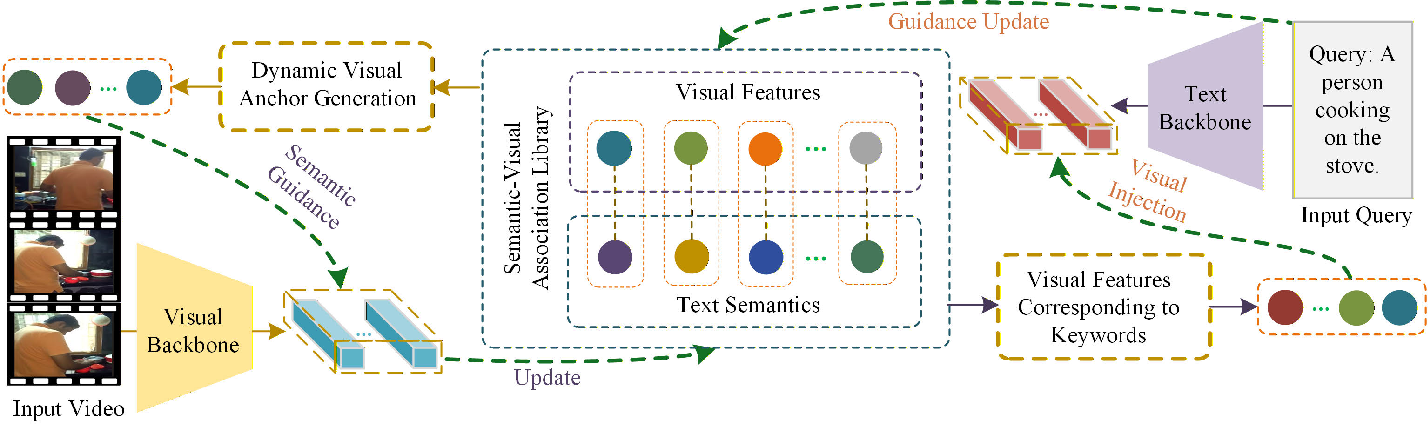
Figure 1 from Bidirectional Cross-Modal Collaborative Alignment via ...

Figure 1 from Brain-Machine Cross-Modal Alignment via Sample Relational ...
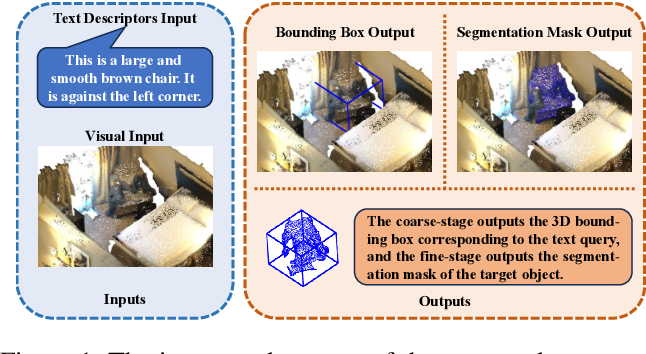
Figure 1 from MR-COSMO: Visual-Text Memory Recall and Direct CrOSs ...