
Figure 1 From Rethinking 3d Dense Caption And Visual Grounding In A

Figure 1 from Rethinking 3D Dense Caption and Visual Grounding in A ...
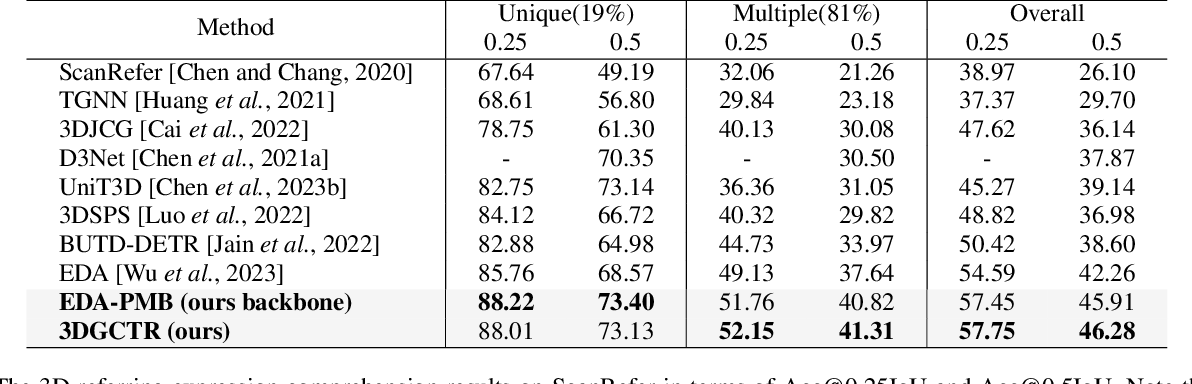
Table 1 from Rethinking 3D Dense Caption and Visual Grounding in A ...

Rethinking 3D Dense Caption and Visual Grounding in A Unified Framework ...
Rethinking 3D Dense Caption and Visual Grounding in A Unified Framework ...

Figure 1 from A Unified Framework for 3D Point Cloud Visual Grounding ...
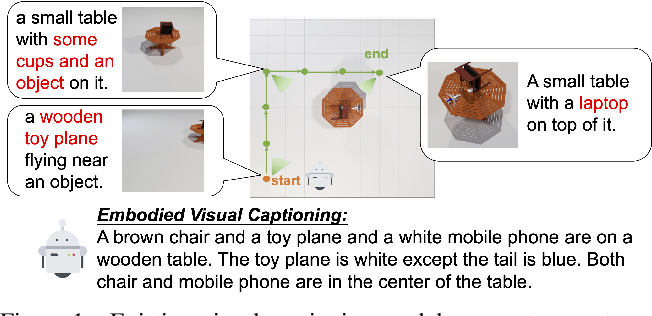
Figure 1 from Explore and Tell: Embodied Visual Captioning in 3D ...
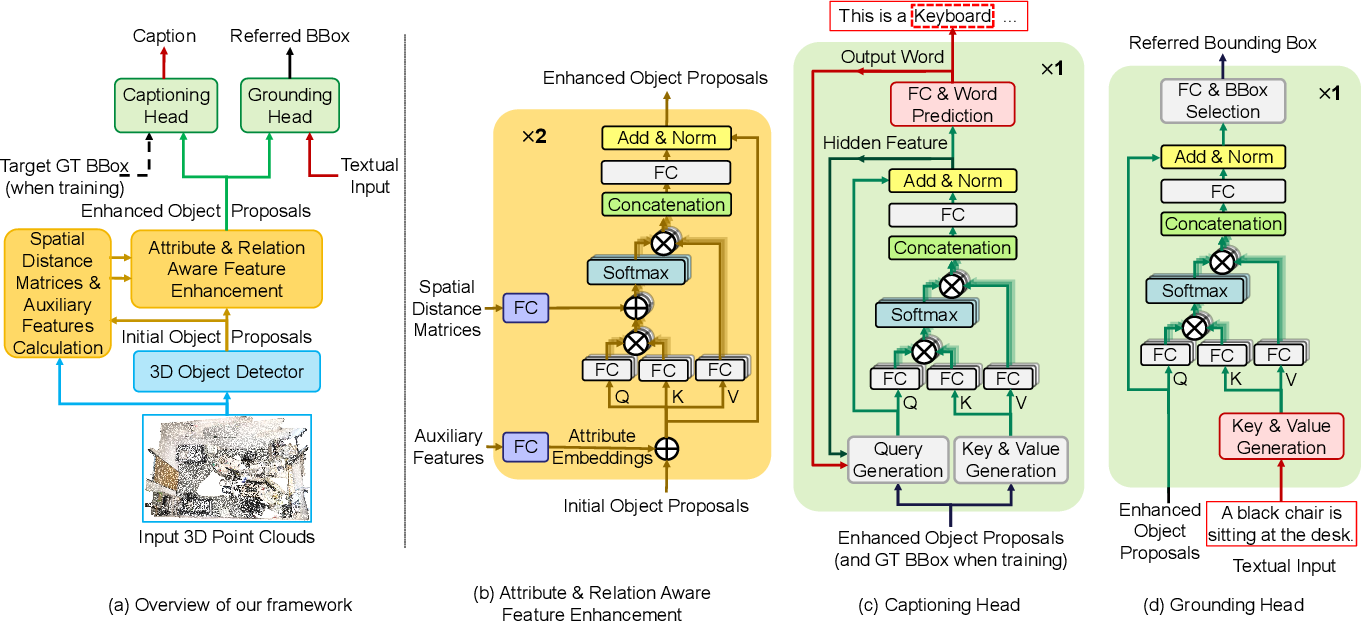
Figure 1 from 3DJCG: A Unified Framework for Joint Dense Captioning and ...

Figure 1 from Toward Explainable and Fine-Grained 3D Grounding through ...

Figure 1 from Cross3DVG: Cross-Dataset 3D Visual Grounding on Different ...

Figure 1 from AugRefer: Advancing 3D Visual Grounding via Cross-Modal ...
Advertisement Space (300x250)

Figure 1 from SeCG: Semantic-Enhanced 3D Visual Grounding via Cross ...

UniT3D: A Unified Transformer for 3D Dense Captioning and Visual Grounding

UniT3D: A Unified Transformer for 3D Dense Captioning and Visual Grounding

Figure 1 from Dense Captioning with Joint Inference and Visual Context ...

Figure 1 from Dense Captioning with Joint Inference and Visual Context ...
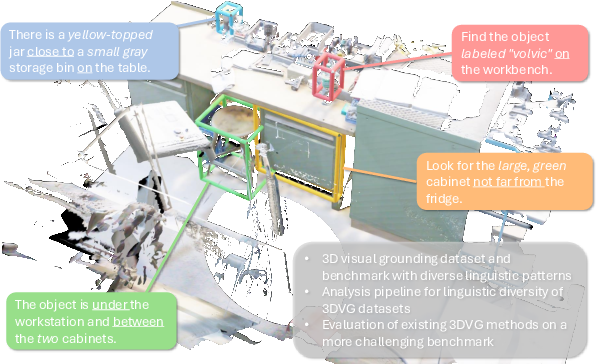
Figure 1 from ViGiL3D: A Linguistically Diverse Dataset for 3D Visual ...

UniT3D: A Unified Transformer for 3D Dense Captioning and Visual Grounding
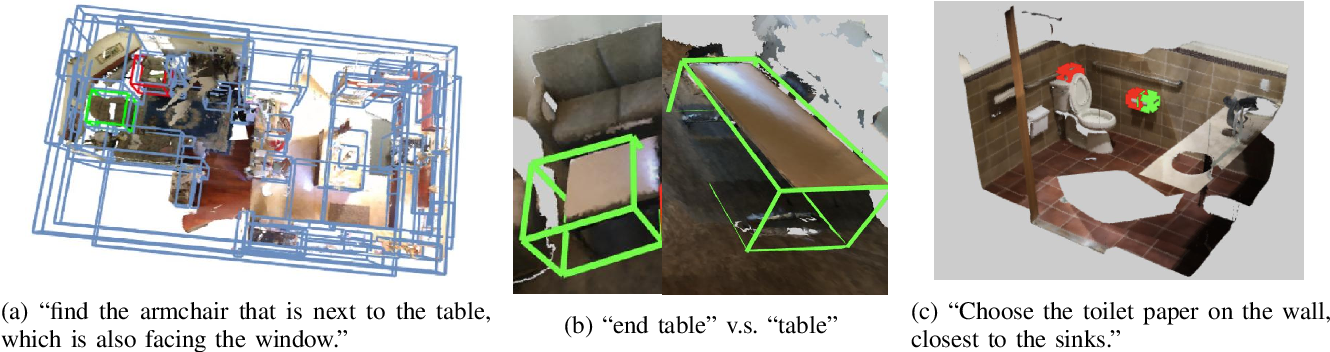
Figure 1 from 3DWG: 3D Weakly Supervised Visual Grounding via Category ...

Figure 1 from Dense Captioning with Joint Inference and Visual Context ...

Figure 1 from A Comprehensive Survey of 3D Dense Captioning: Localizing ...
Advertisement Space (336x280)
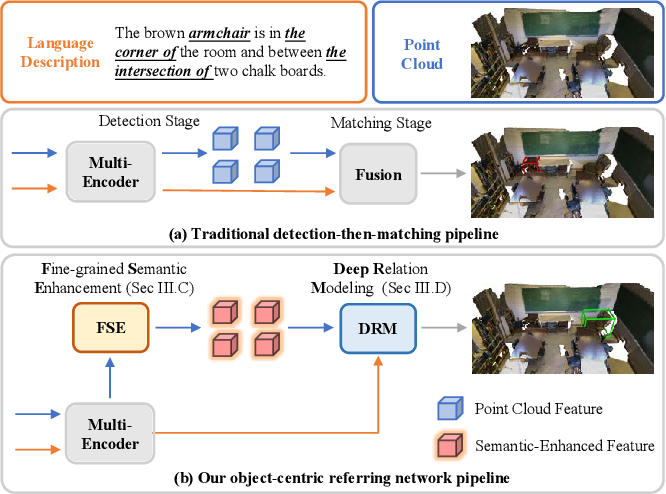
Figure 1 from Boosting 3D Visual Grounding by Object-Centric Referring ...

Figure 1 from ScanReason: Empowering 3D Visual Grounding with Reasoning ...
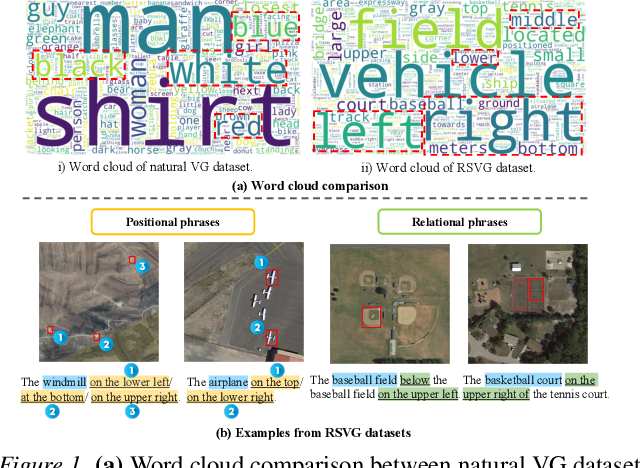
Figure 1 from RSGround-R1: Rethinking Remote Sensing Visual Grounding ...

Figure 1 from A Survey on Text-Guided 3-D Visual Grounding: Elements ...

Figure 1 from Spatiality-guided Transformer for 3D Dense Captioning on ...

Figure 1 from Contextual Modeling for 3D Dense Captioning on Point ...

Table 1 from ScanERU: Interactive 3D Visual Grounding based on Embodied ...

Figure 1 from Visual Question Answering via Dense Captioning | Semantic ...

Figure 4 from Weakly-Supervised 3D Visual Grounding based on Visual ...

Figure 3 from Dense Captioning with Joint Inference and Visual Context ...
Advertisement Space (336x280)

3DSSG-Cap: A Caption Enhanced Dataset for 3D Visual Grounding ...

Figure 1 from End-to-end visual grounding via region proposal networks ...

Figure 1 from CoT3DRef: Chain-of-Thoughts Data-Efficient 3D Visual ...
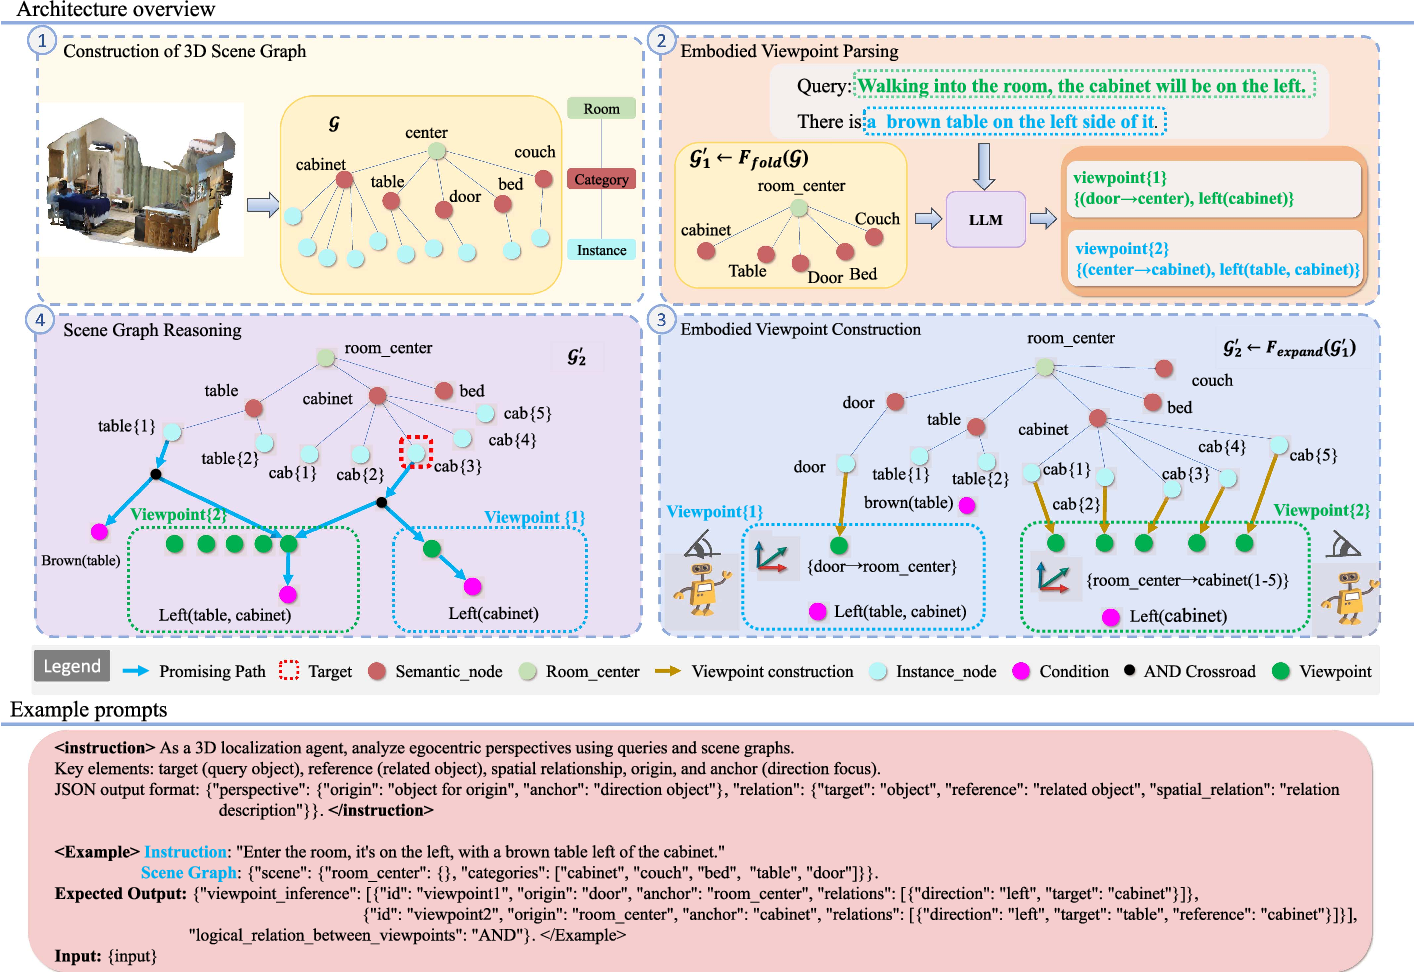
Figure 2 from ViewInfer3D: 3D Visual Grounding Based on Embodied ...

MTU3D:Move to Understand a 3D Scene: Bridging Visual Grounding and ...

Table 1 from Weakly-Supervised 3D Visual Grounding based on Visual ...