
Figure 1 From Joint Semantic And Spatial Feature Learning For Audio

Figure 1 from Joint Semantic and Spatial Feature Learning for Audio ...

Figure 4 from Joint Semantic and Spatial Feature Learning for Audio ...

Figure 3 from Joint Semantic and Spatial Feature Learning for Audio ...

Figure 1 from Spatial and Semantic Consistency Contrastive Learning for ...
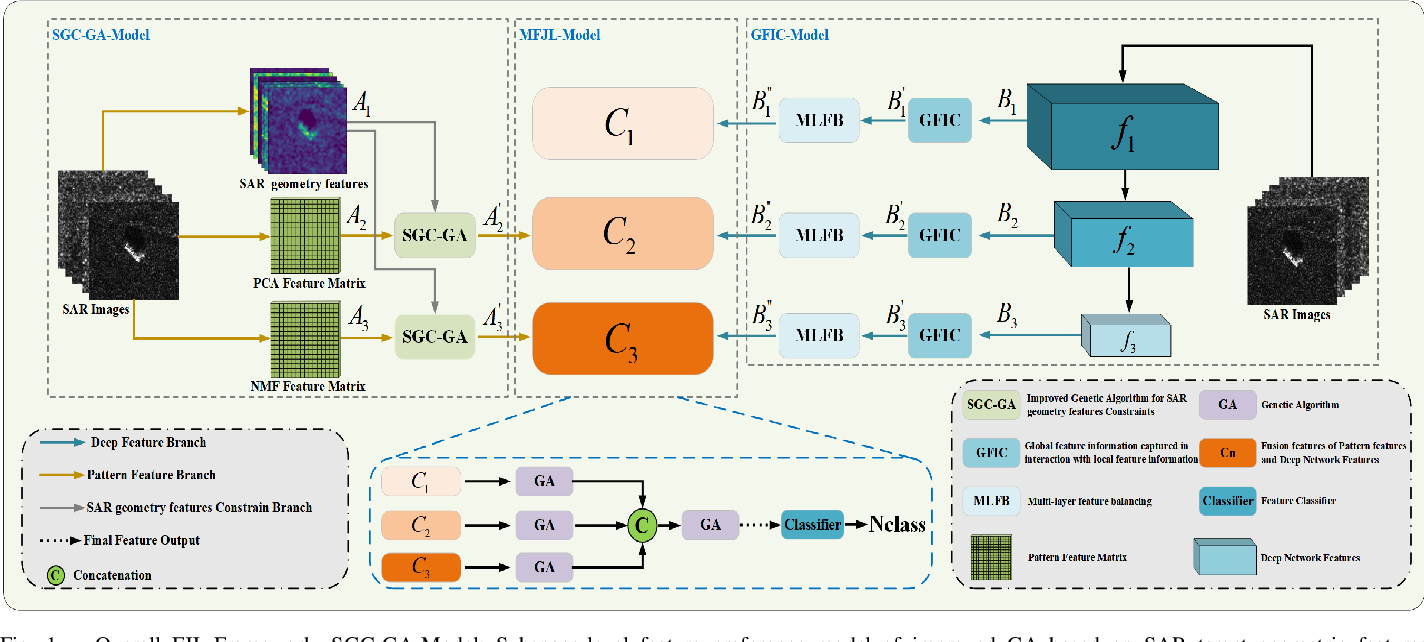
Figure 1 from Feature Joint Learning for SAR Target Recognition ...

Figure 1 from Joint Learning of Semantic Segmentation and Height ...

Figure 1 from Joint Audio and Speech Understanding | Semantic Scholar

Figure 1 from Audio-Visual Event Localization by Learning Spatial and ...
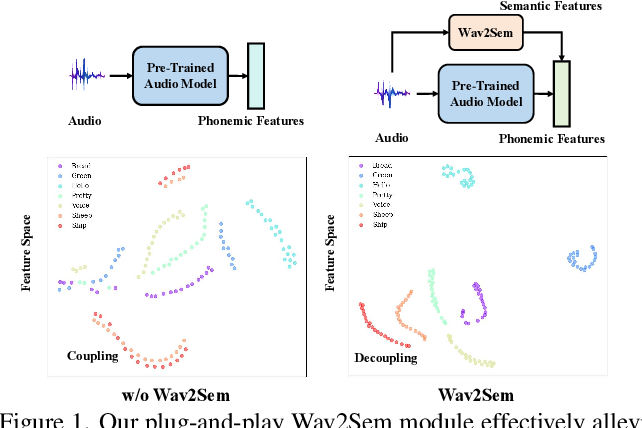
Figure 1 from Wav2Sem: Plug-and-Play Audio Semantic Decoupling for 3D ...
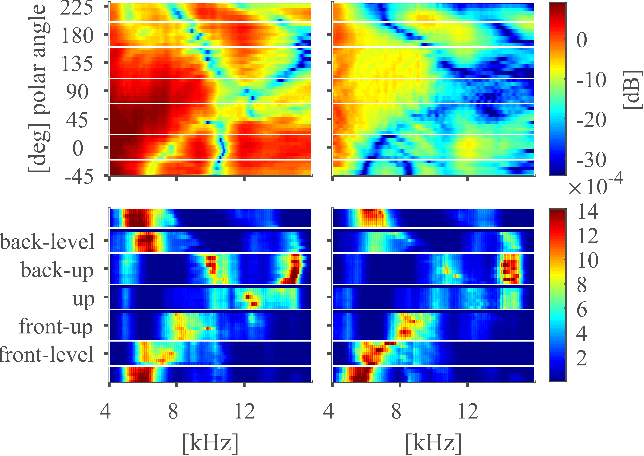
Figure 1 from Spatial Audio Feature Discovery with Convolutional Neural ...
Advertisement Space (300x250)

Figure 1 from Perceptually-Motivated Spatial Audio Codec for Higher ...
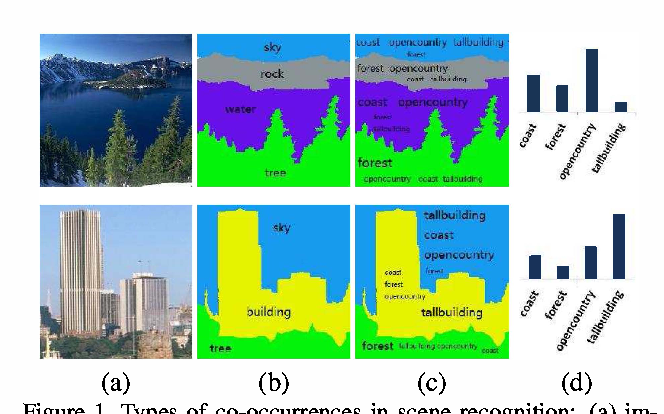
Figure 1 from Joint multi-feature spatial context for scene recognition ...
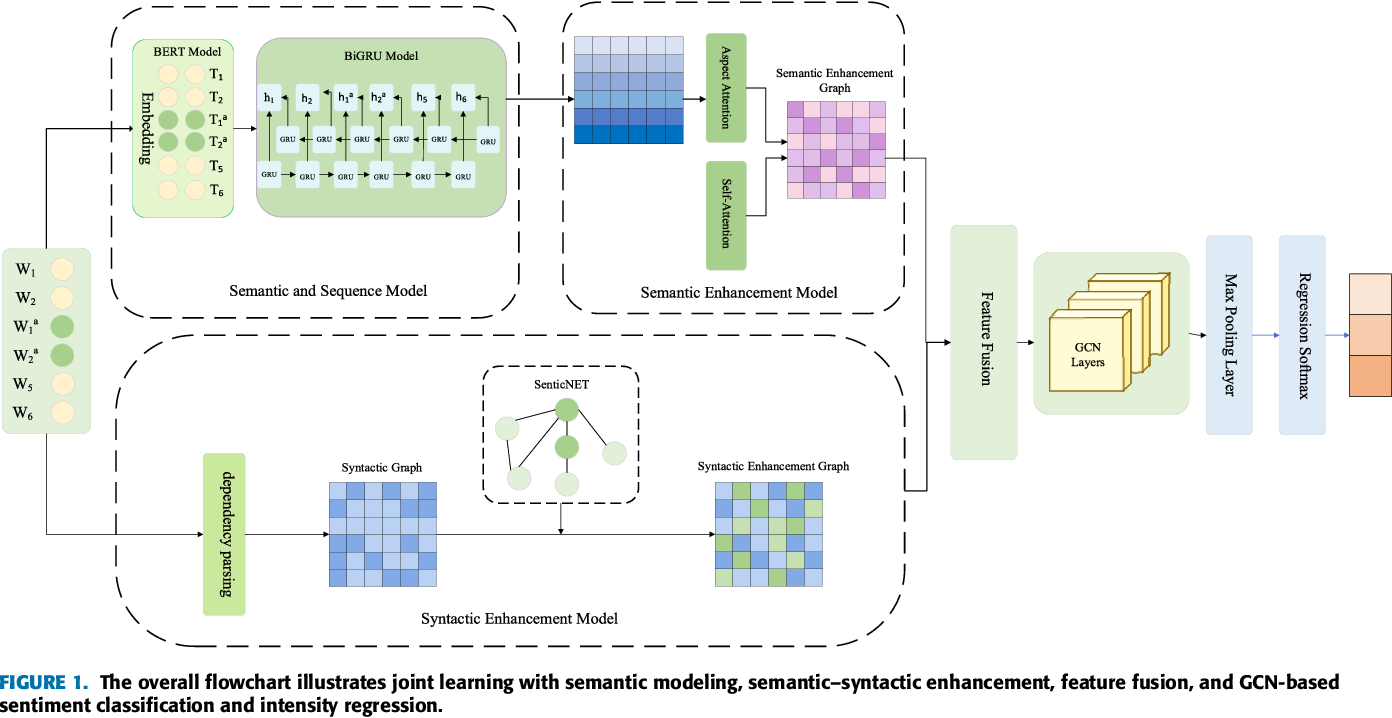
Figure 1 from Joint Semantic and Syntactic Enhancement With Multitask ...

Figure 1 from Discrete Joint Semantic Alignment Hashing for Cross-Modal ...

Figure 1 from A Statistical-Spatial Feature Learning Network for PolSAR ...

Figure 1 from Learning Semantic Alignment Using Global Features and ...

Figure 1 from Self-supervised 3D Semantic Representation Learning for ...

Figure 1 from Joint 2D and 3D Semantic Segmentation with Consistent ...

Figure 1 from Audio-visual speech separation based on joint feature ...

Figure 1 from Learning Spatial Features from Audio-Visual ...
Advertisement Space (336x280)

Figure 1 from Audio-Visual Spatial Integration and Recursive Attention ...

Figure 1 from Learning Representations from Audio-Visual Spatial ...

Figure 1 from First- And Third-Person Video Co-Analysis By Learning ...

Figure 1 from Dense Semantic Forecasting in Video by Joint Regression ...

Figure 1 from Learning Representations from Audio-Visual Spatial ...
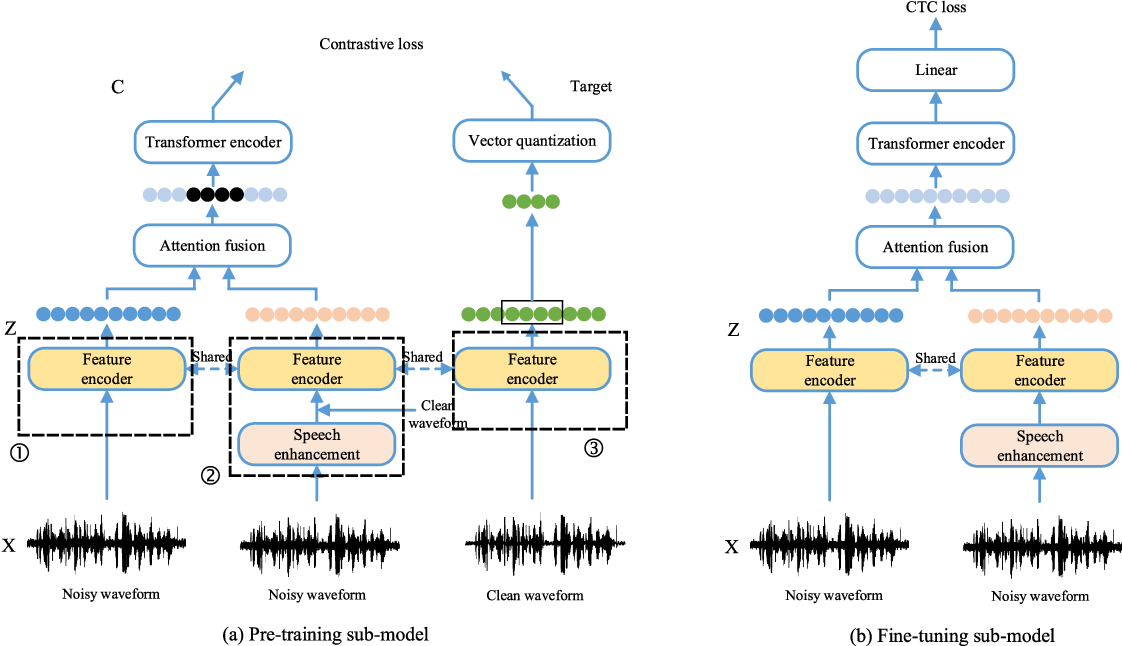
Figure 1 from A Joint Speech Enhancement and Self-Supervised ...

Figure 1 from Self-Supervised Learning of Audio Representations From ...

Figure 1 from Learning Representations from Audio-Visual Spatial ...

We learn a joint semantic feature representation for aerial and ...

Figure 1 from A Feature Fusion-Net Using Deep Spatial Context Encoder ...
Advertisement Space (336x280)
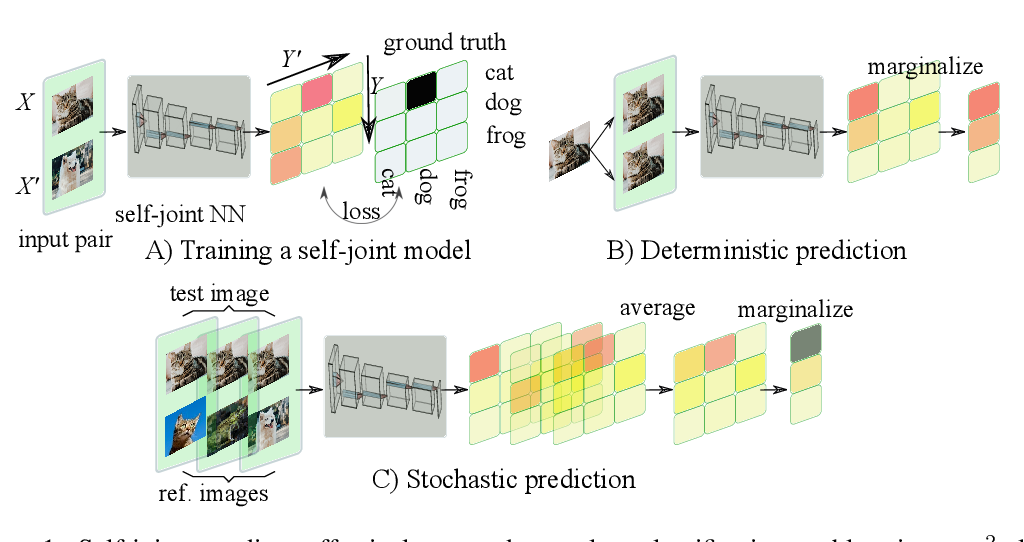
Figure 1 from Self-Joint Supervised Learning | Semantic Scholar
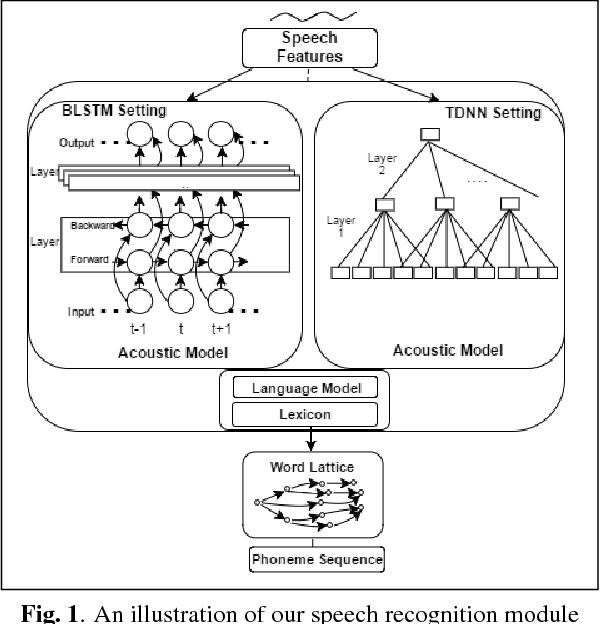
Figure 1 from Joint Audio-Video Driven Facial Animation | Semantic Scholar

A Joint Network of Edge-Aware and Spectral–Spatial Feature Learning for ...

Figure 1 from Simultaneous Speech Detection With Spatial Features for ...

Figure 1 from Learning Audio Concepts from Counterfactual Natural ...

Figure 2 from Audio-Visual Event Localization by Learning Spatial and ...