
Figure 1 From Multi Task Joint Learning For Embedding Aware Audio

Figure 1 from Multi-Task Joint Learning for Embedding Aware Audio ...

Figure 1 from Joint Embedding with Multi-Task Learning for Multi-Label ...

Figure 1 from A Multi-View Joint Learning Framework for Embedding ...
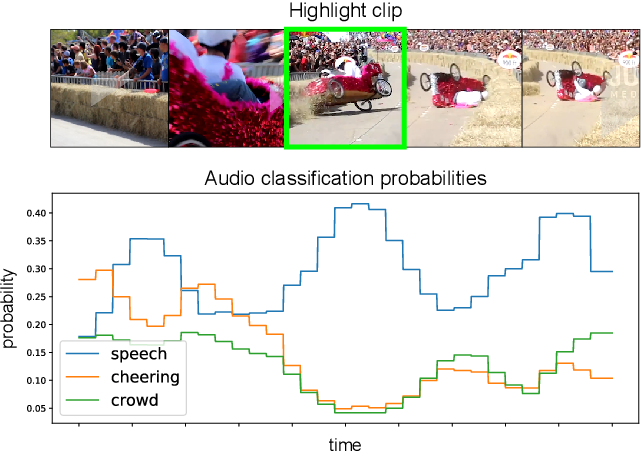
Figure 1 from Joint Visual and Audio Learning for Video Highlight ...

Figure 1 from Channel Invariant Speaker Embedding Learning with Joint ...
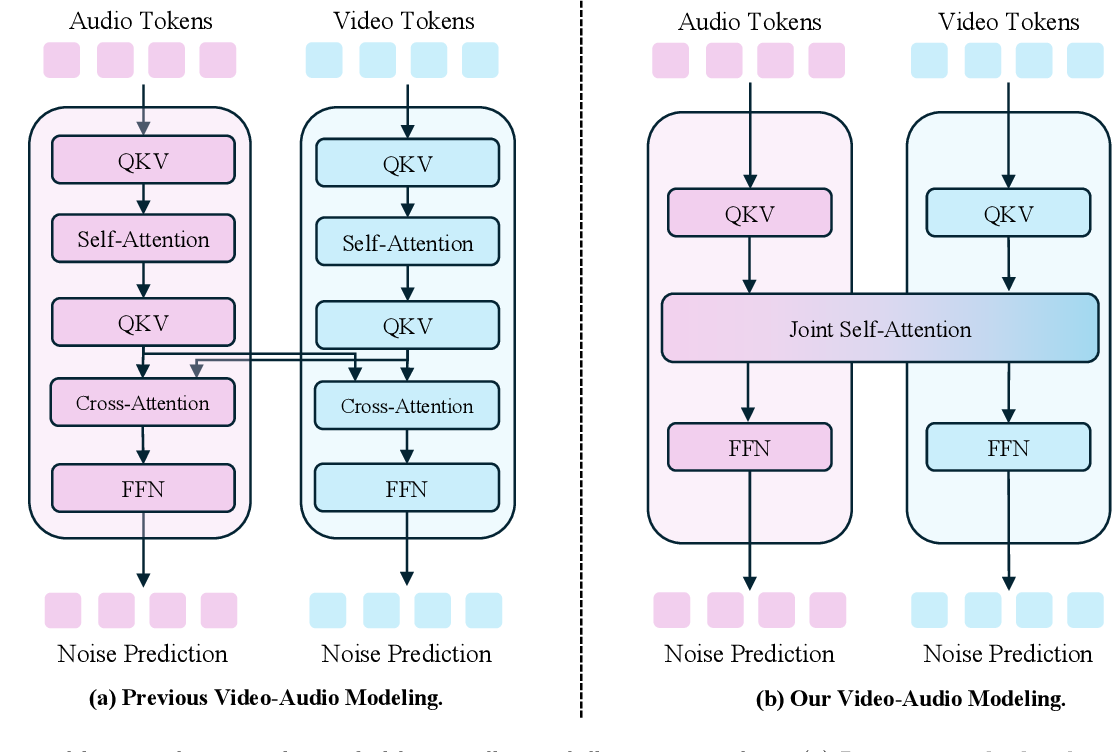
Figure 1 from JoVA: Unified Multimodal Learning for Joint Video-Audio ...

Figure 1 from Appearance Codes using Joint Embedding Learning of ...

Figure 1 from A Multi-Task Joint Learning Framework for Transformer ...
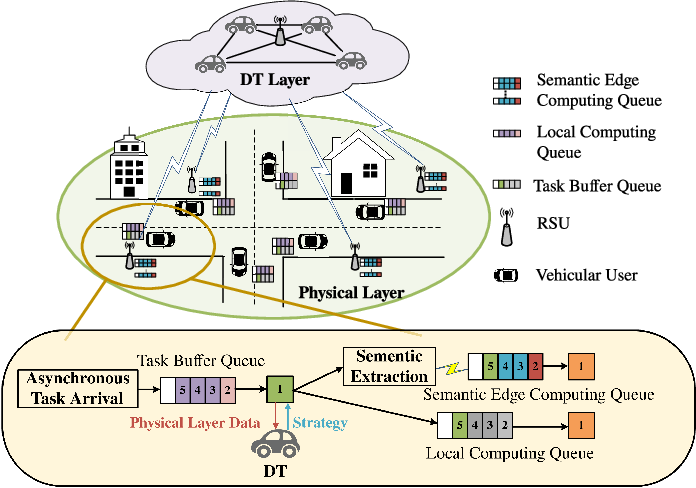
Figure 1 from Joint Task Scheduling and Resource Allocation for ...
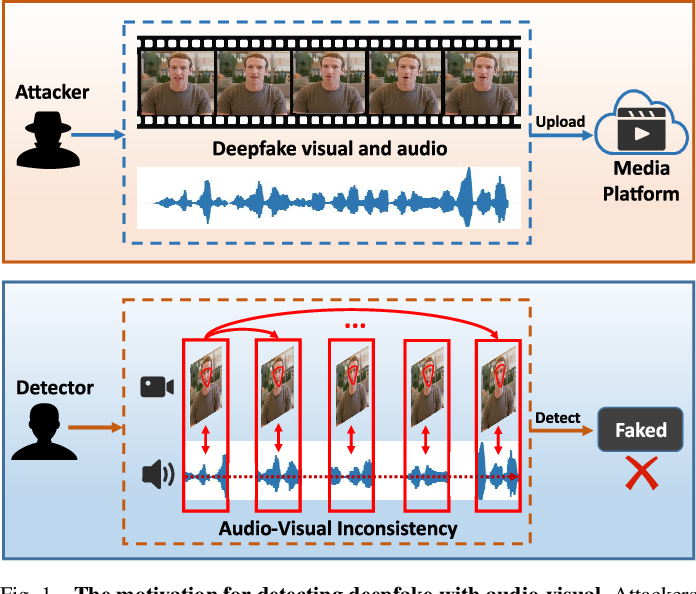
Figure 1 from AVoiD-DF: Audio-Visual Joint Learning for Detecting ...
Advertisement Space (300x250)
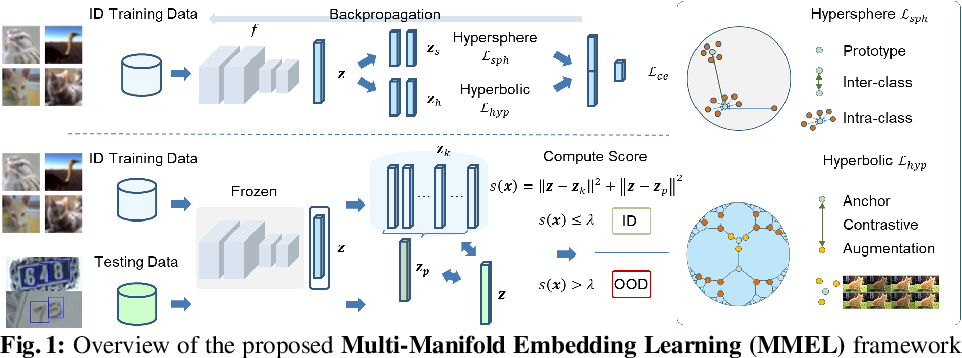
Figure 1 from Learning Multi-Manifold Embedding for Out-Of-Distribution ...

Figure 1 from Multi-task learning of deep neural networks for joint ...
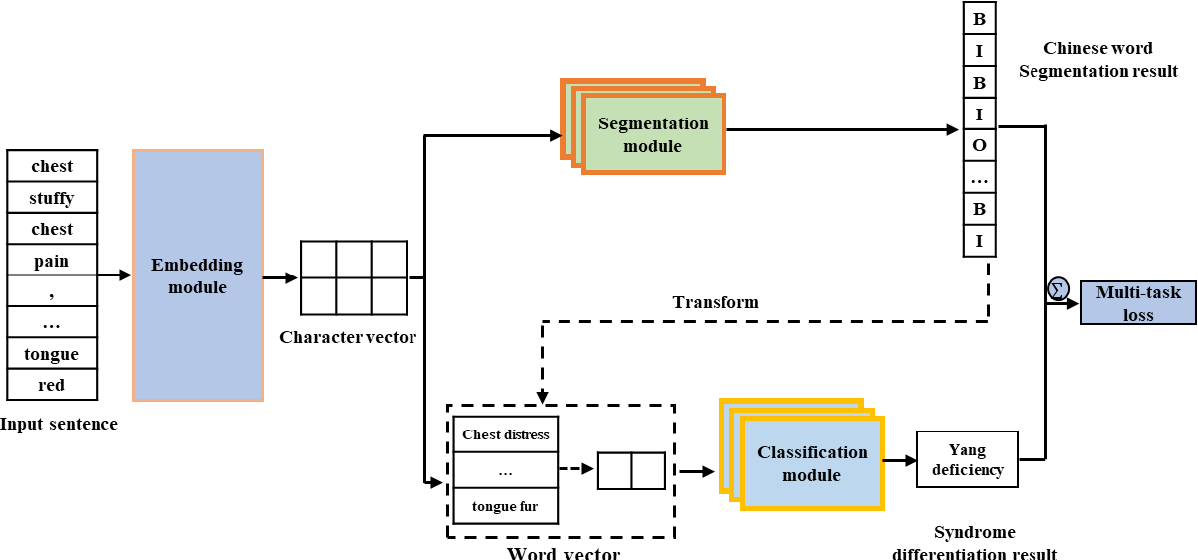
Figure 1 from Multi-Task Joint Learning Model for Chinese Word ...
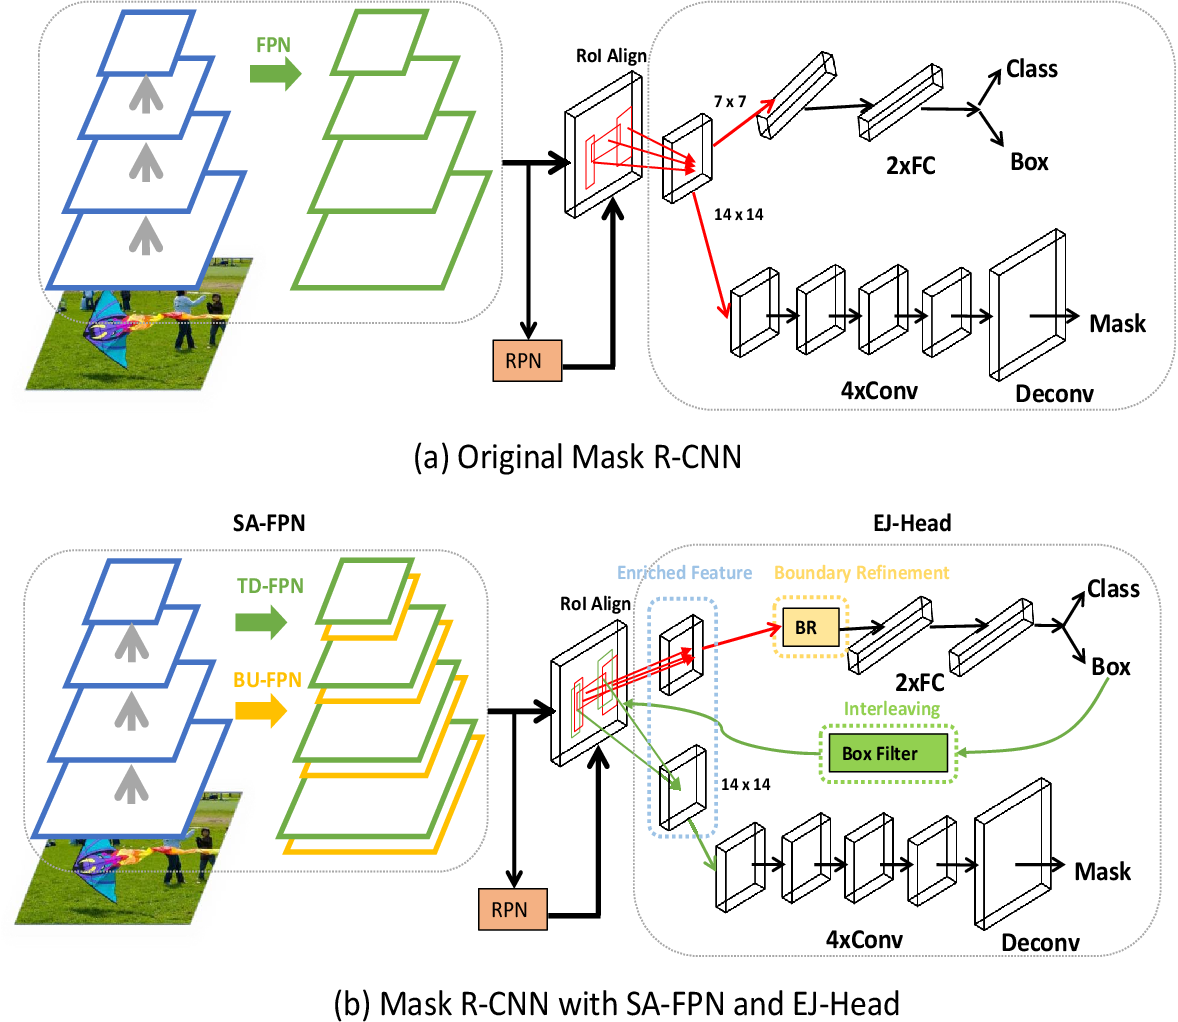
Figure 1 from Multi-Task Learning via Scale Aware Feature Pyramid ...

Figure 1 from Self-Supervised Learning of Audio Representations From ...

Figure 1 from EnCLAP: Combining Neural Audio Codec and Audio-Text Joint ...
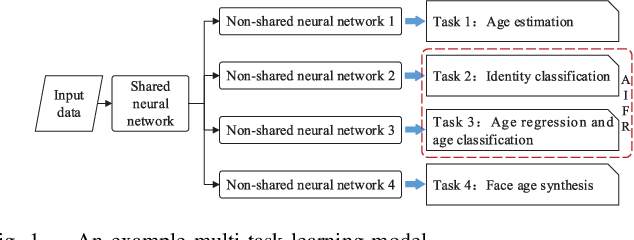
Figure 1 from Share-Aware Joint Model Deployment and Task Offloading ...

Figure 1 from Increasing Importance of Joint Analysis of Audio and ...

Figure 1 from Multi-Task Learning for Interpretable Weakly Labelled ...

Figure 1 from Efficient Multi-task Uncertainties for Joint Semantic ...
Advertisement Space (336x280)
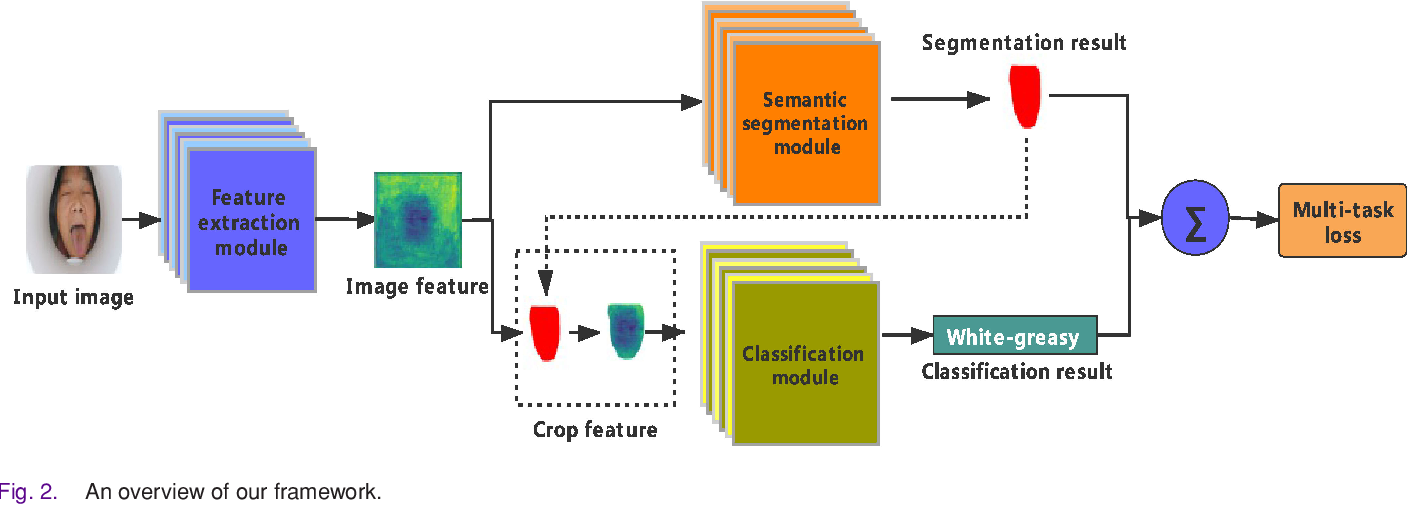
Figure 2 from Multi-Task Joint Learning Model for Segmenting and ...
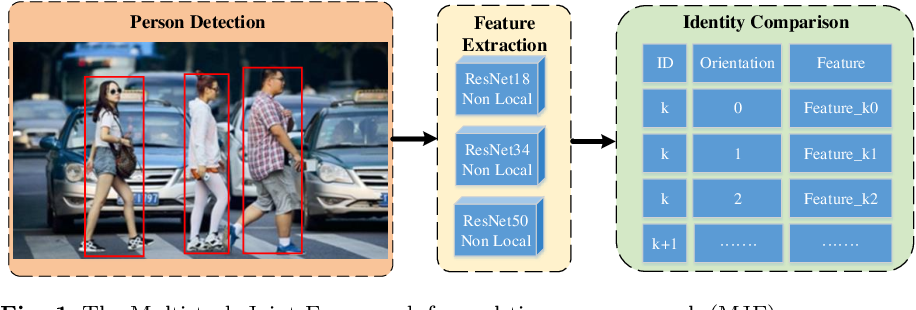
Figure 1 from A Multi-task Joint Framework for Real-time Person Search ...

Figure 4 from Multi-Task Joint Learning Model for Segmenting and ...

Figure 2 from Appearance Codes using Joint Embedding Learning of ...

Figure 1 from Joint Analysis of Acoustic Event and Scene Based on ...

Figure 1 from Decoupling and Interacting Multi-Task Learning Network ...

Figure 1 from Audio-Visual Scene-Aware Dialog and Reasoning Using Audio ...
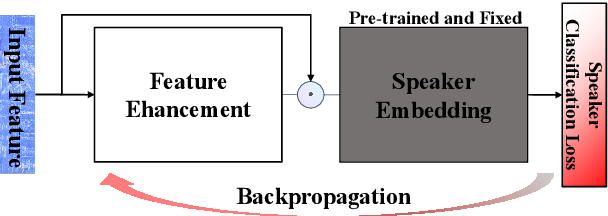
Figure 1 from Joint Feature Enhancement and Speaker Recognition with ...

Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...
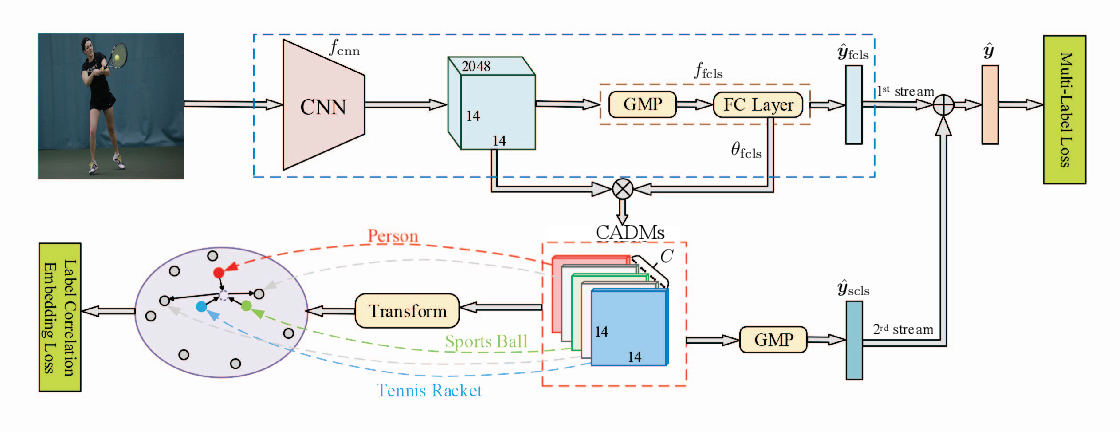
Figure 1 from Multi-Label Image Recognition with Joint Class-Aware Map ...
Advertisement Space (336x280)
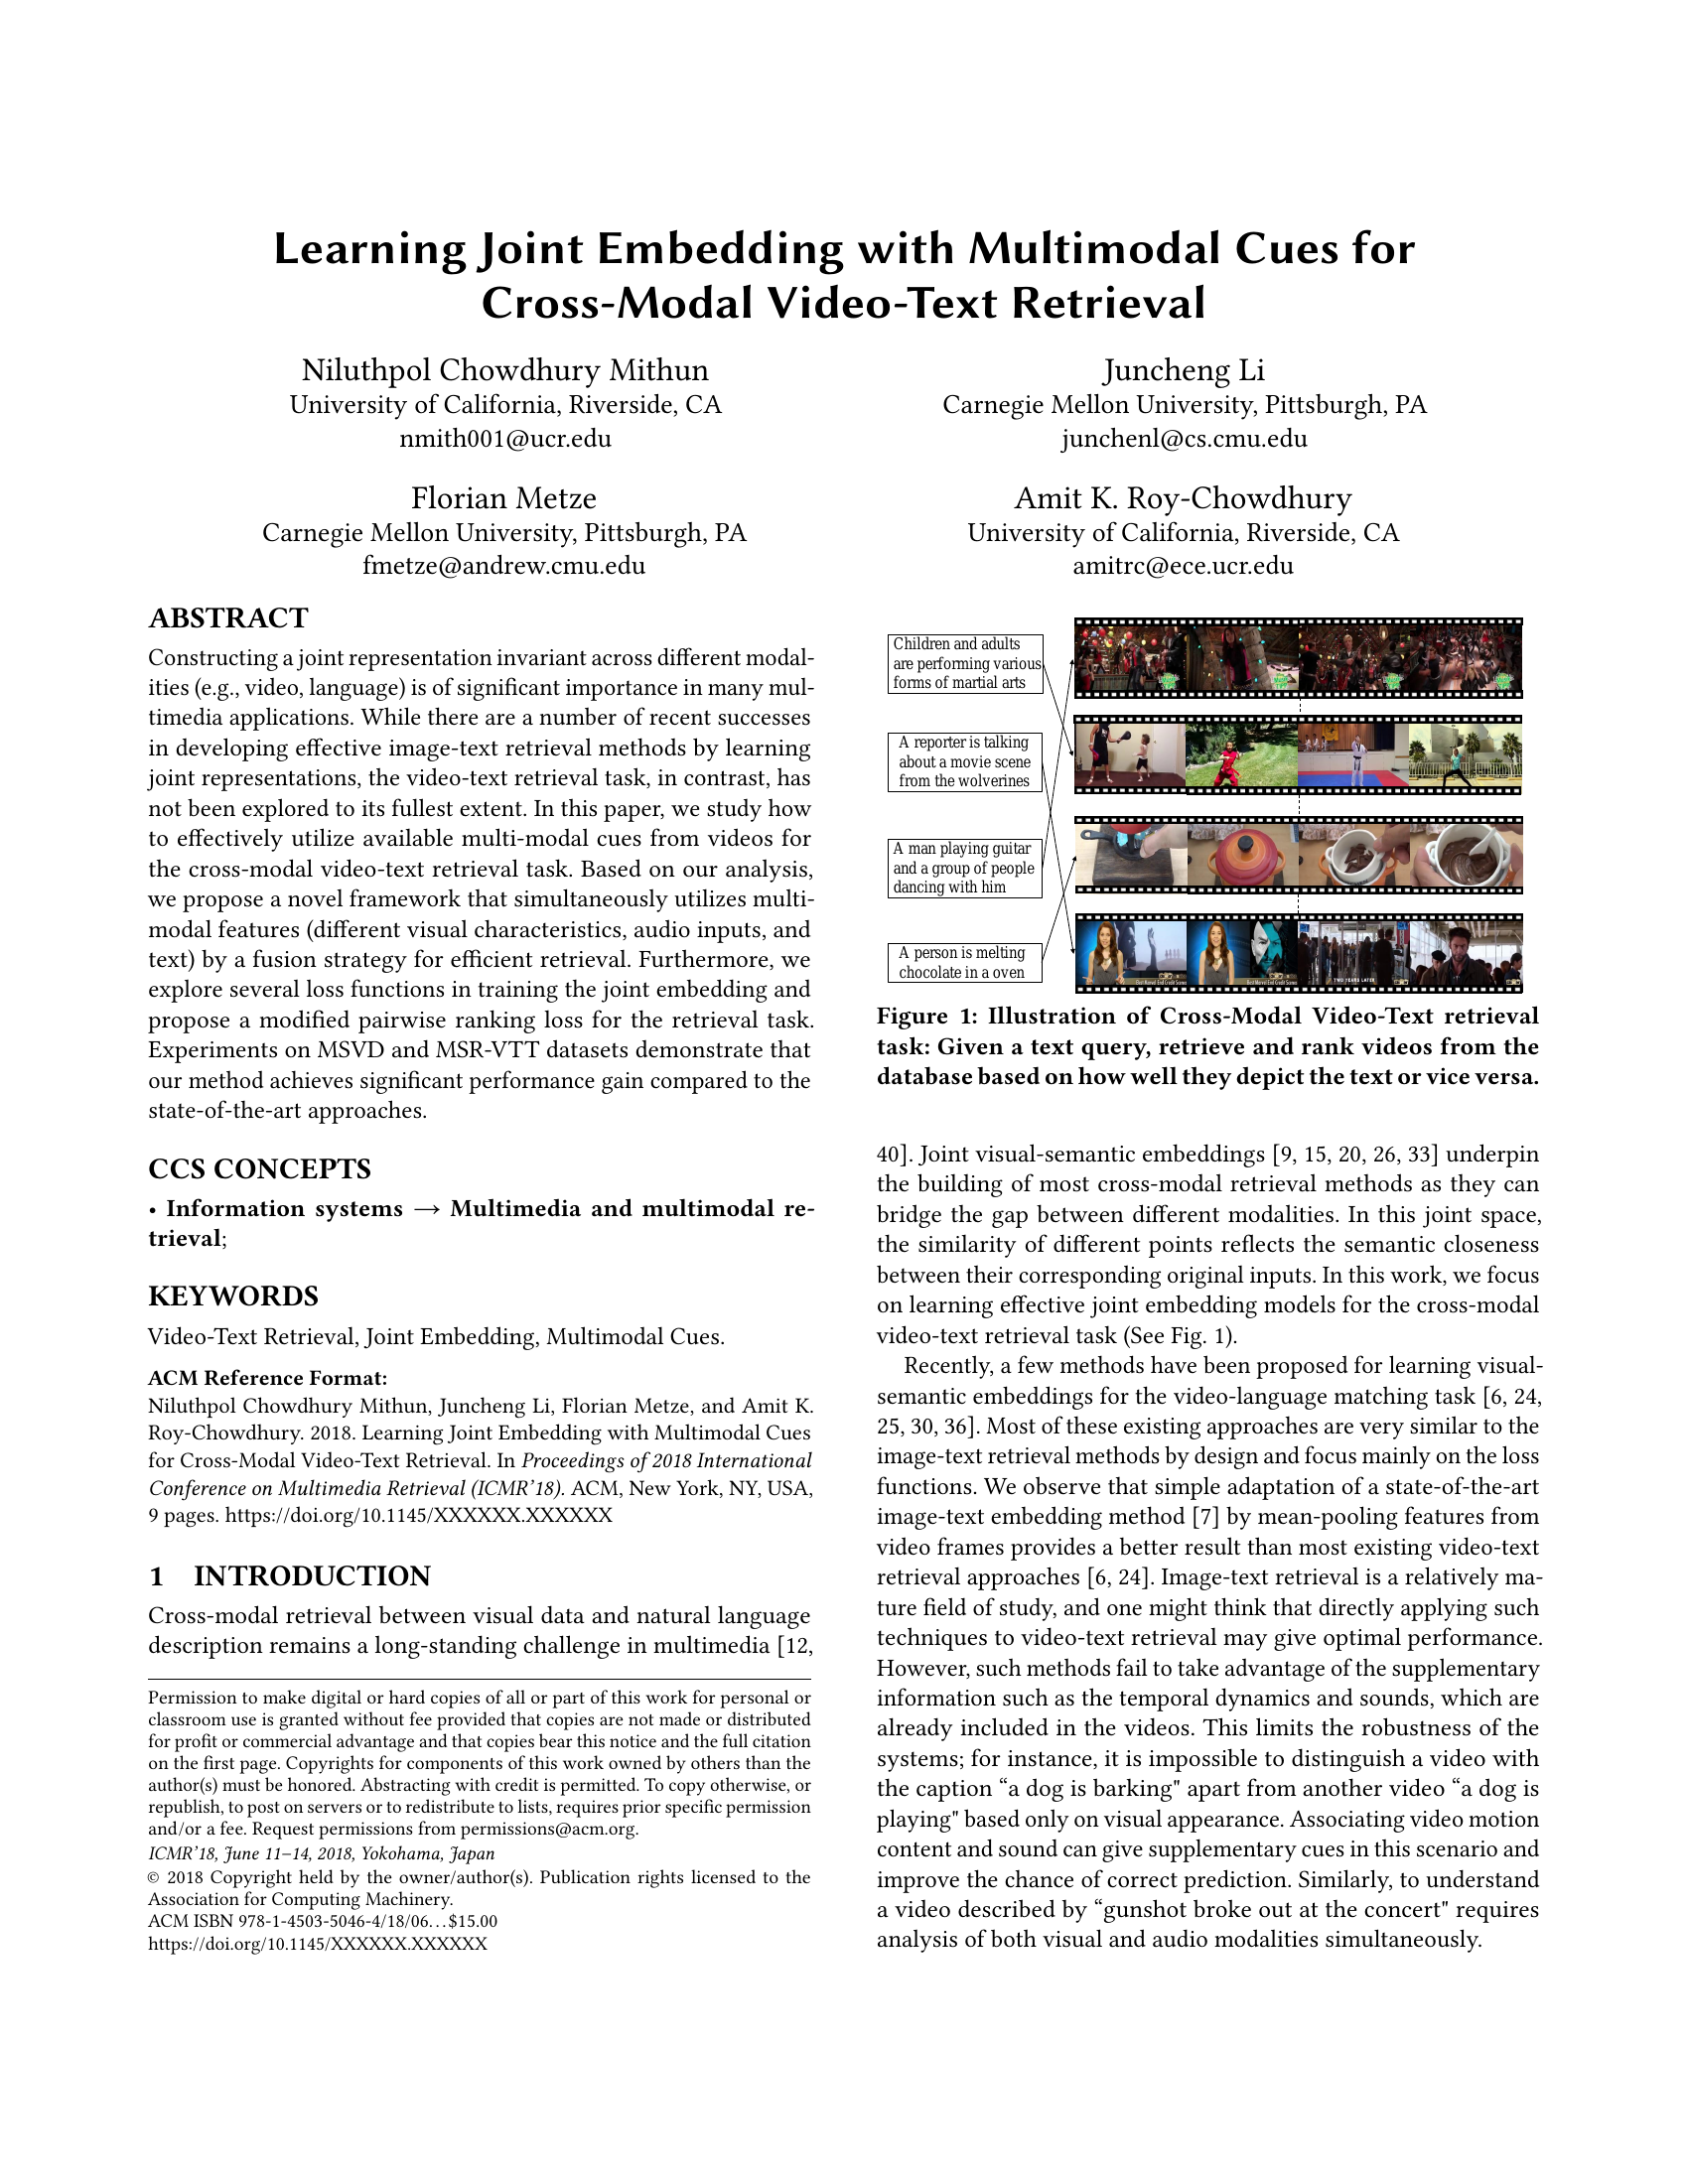
Learning Joint Embedding with Multimodal Cues for Cross-Modal Video ...

Figure 1 from A Word-axis Speaker Embedding Trained with Multi-Speaker ...

Figure 1 from Learning Missing Modal Electronic Health Records with ...

Figure 1 from Joint Speech-Text Embeddings with Disentangled Speaker ...

Figure 1 from Improving Audio Captioning Models with Fine-Grained Audio ...
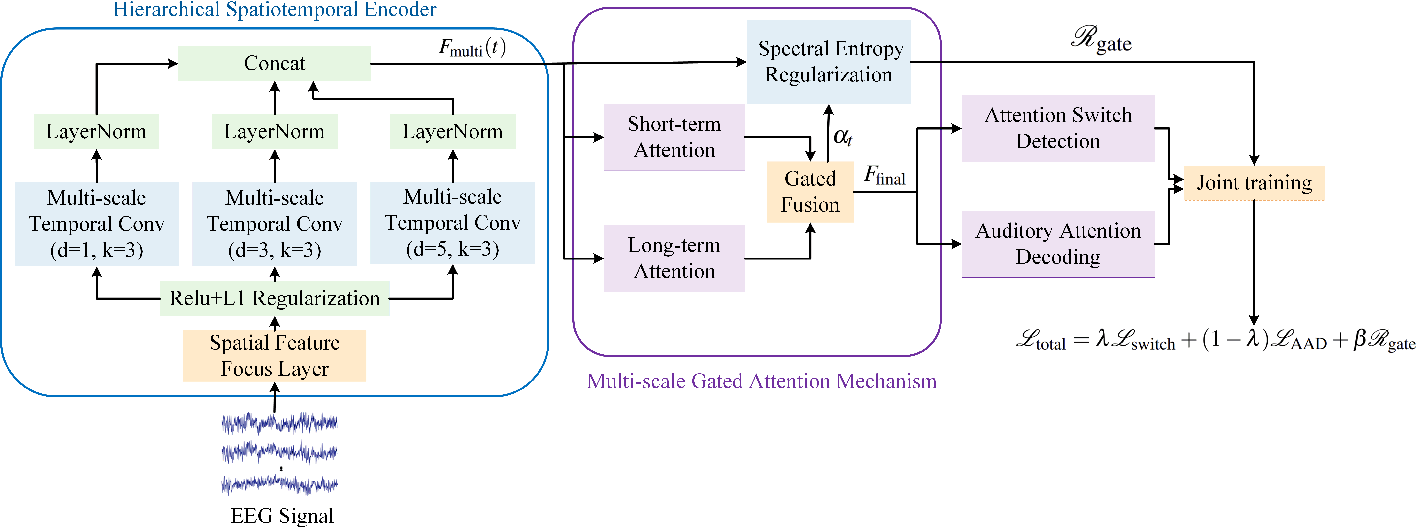
Figure 1 from EEG-based Auditory Attention Switch Detection with Multi ...