
Figure 1 From Lost In Benchmarks Rethinking Large Language Model

Figure 1 from Lost in Benchmarks? Rethinking Large Language Model ...

Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...
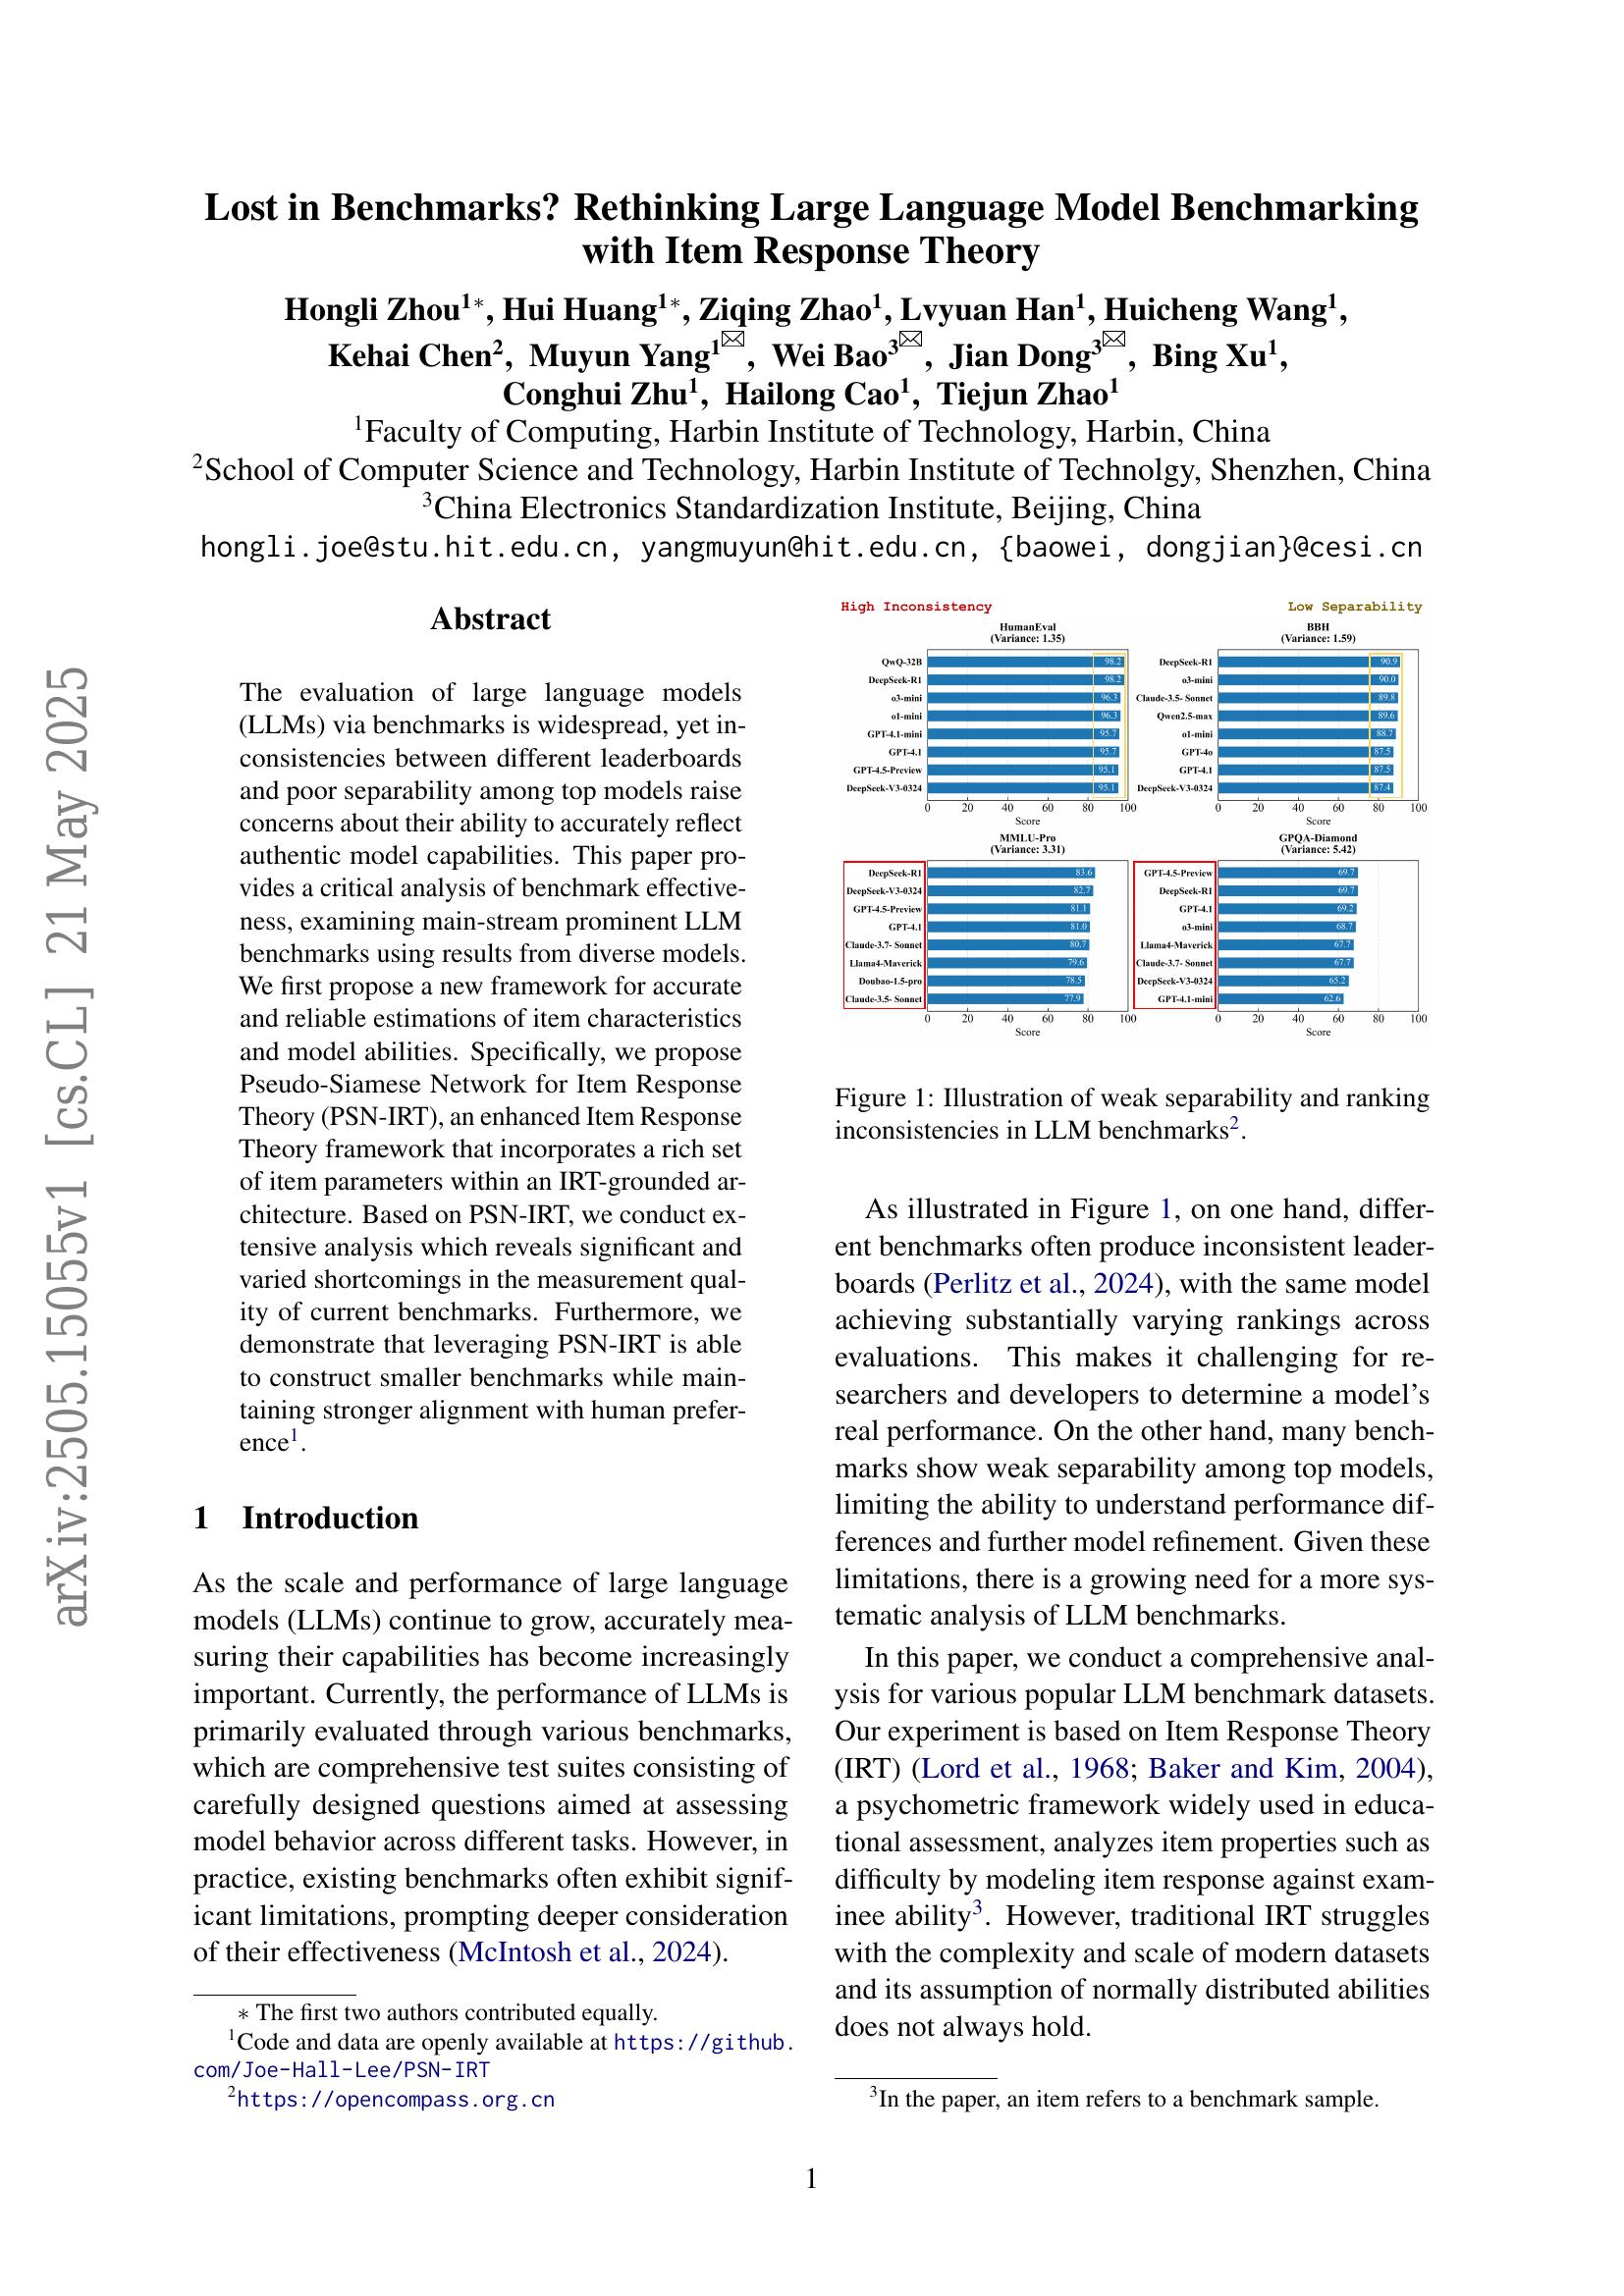
Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...

Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...

Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...
Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...
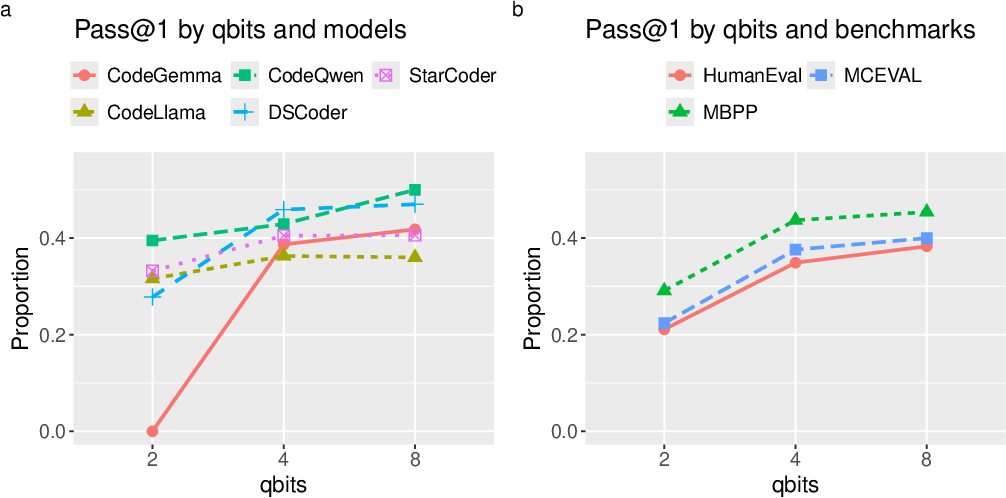
Figure 1 from Evaluating Quantized Large Language Models for Code ...

Figure 1 from Benchmarking Large Language Models for Personalized ...

Figure 1 from Explanations of Large Language Models Explain Language ...

Figure 1 from Enhancing Large Language Models through Transforming ...
Advertisement Space (300x250)

Figure 1 from Rethinking Benchmark and Contamination for Language ...
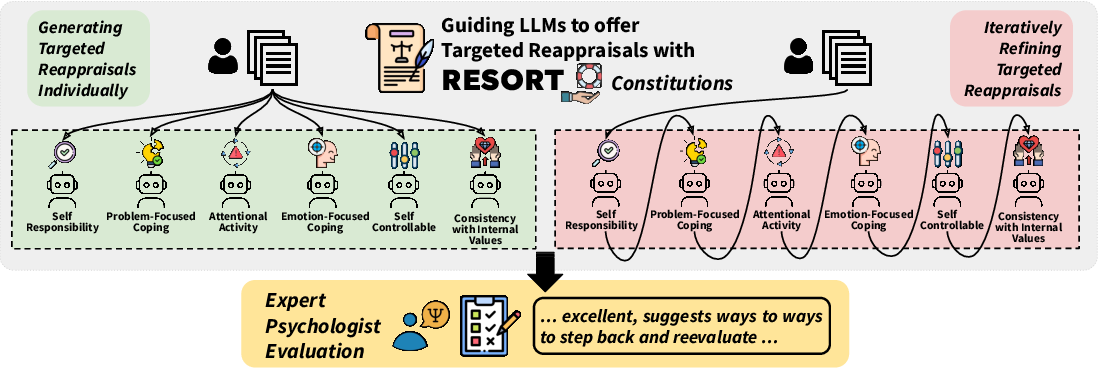
Figure 1 from Large Language Models are Capable of Offering Cognitive ...

Figure 1 from A Survey of Large Language Model-Based Generative AI for ...
Large Language Model Benchmarks | mlcommons/inference_results_v6.0 ...

(PDF) Do Large Language Model Benchmarks Test Reliability?

Figure 1 from ALERT: A Comprehensive Benchmark for Assessing Large ...

Large language model (LLM) — papers and benchmarks | Papers with Code

(PDF) Enterprise Benchmarks for Large Language Model Evaluation

Rethinking with Retrieval: Faithful Large Language Model Inference-CSDN博客

Supervised Learning and Large Language Model Benchmarks on Mental ...
Advertisement Space (336x280)

Rethinking Model Scale for Listwise Reranking, Adapting Large Language ...

A Survey on Large Language Model Benchmarks | AI Research Paper Details

Rethinking with Retrieval Faithful Large Language Model Inference - 馒头 ...

Paper page - A Survey on Large Language Model Benchmarks

Paper page - Do Large Language Model Benchmarks Test Reliability?

Rethinking Generative Large Language Model Evaluation for Semantic ...

Medical Large Language Model Benchmarks Should Prioritize Construct ...

Quantifying construct validity in large language model evaluations | AI ...
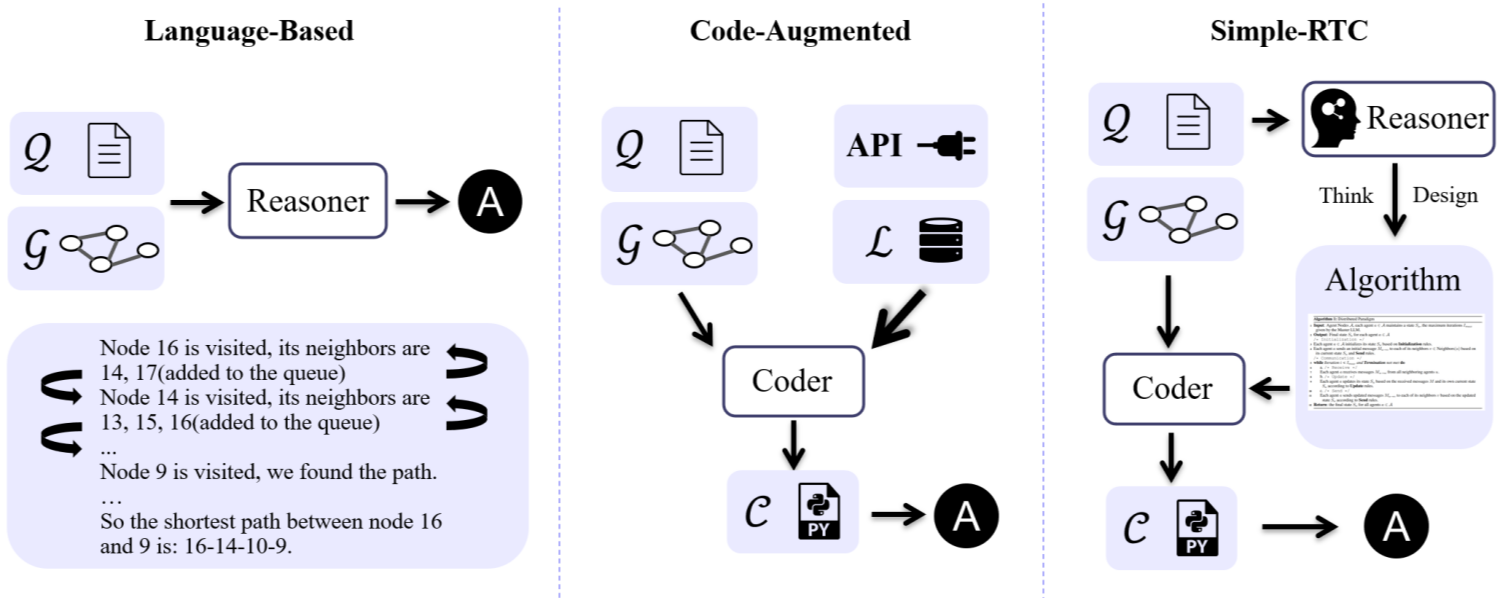
[논문 리뷰] Rethinking and Benchmarking Large Language Models for Graph ...

Benchmarking Large Language Models from Open and Closed Source Models ...
Advertisement Space (336x280)

Developing a Scalable Benchmark for Assessing Large Language Models in ...
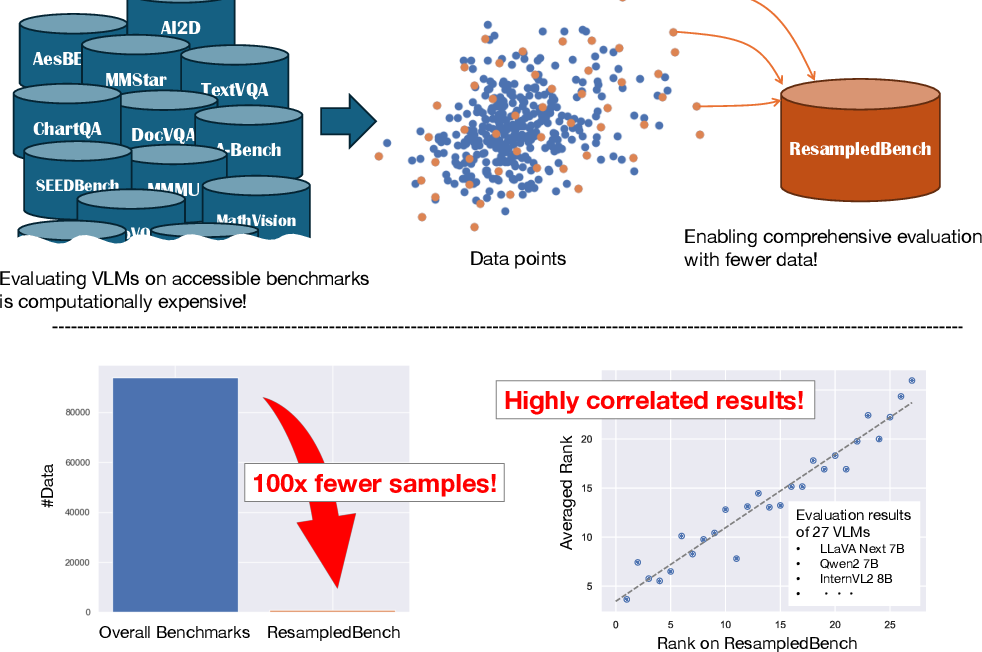
Figure 1 from Resampling Benchmark for Efficient Comprehensive ...

Risk Taxonomy, Mitigation, and Assessment Benchmarks of Large Language ...

Risk Taxonomy, Mitigation, and Assessment Benchmarks of Large Language ...

SOLUTION: Large language model routing with benchmark datasets - Studypool

CPSDbench: a large language model evaluation benchmark and baseline for ...