
Lost In Benchmarks Rethinking Large Language Model Benchmarking With

Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...
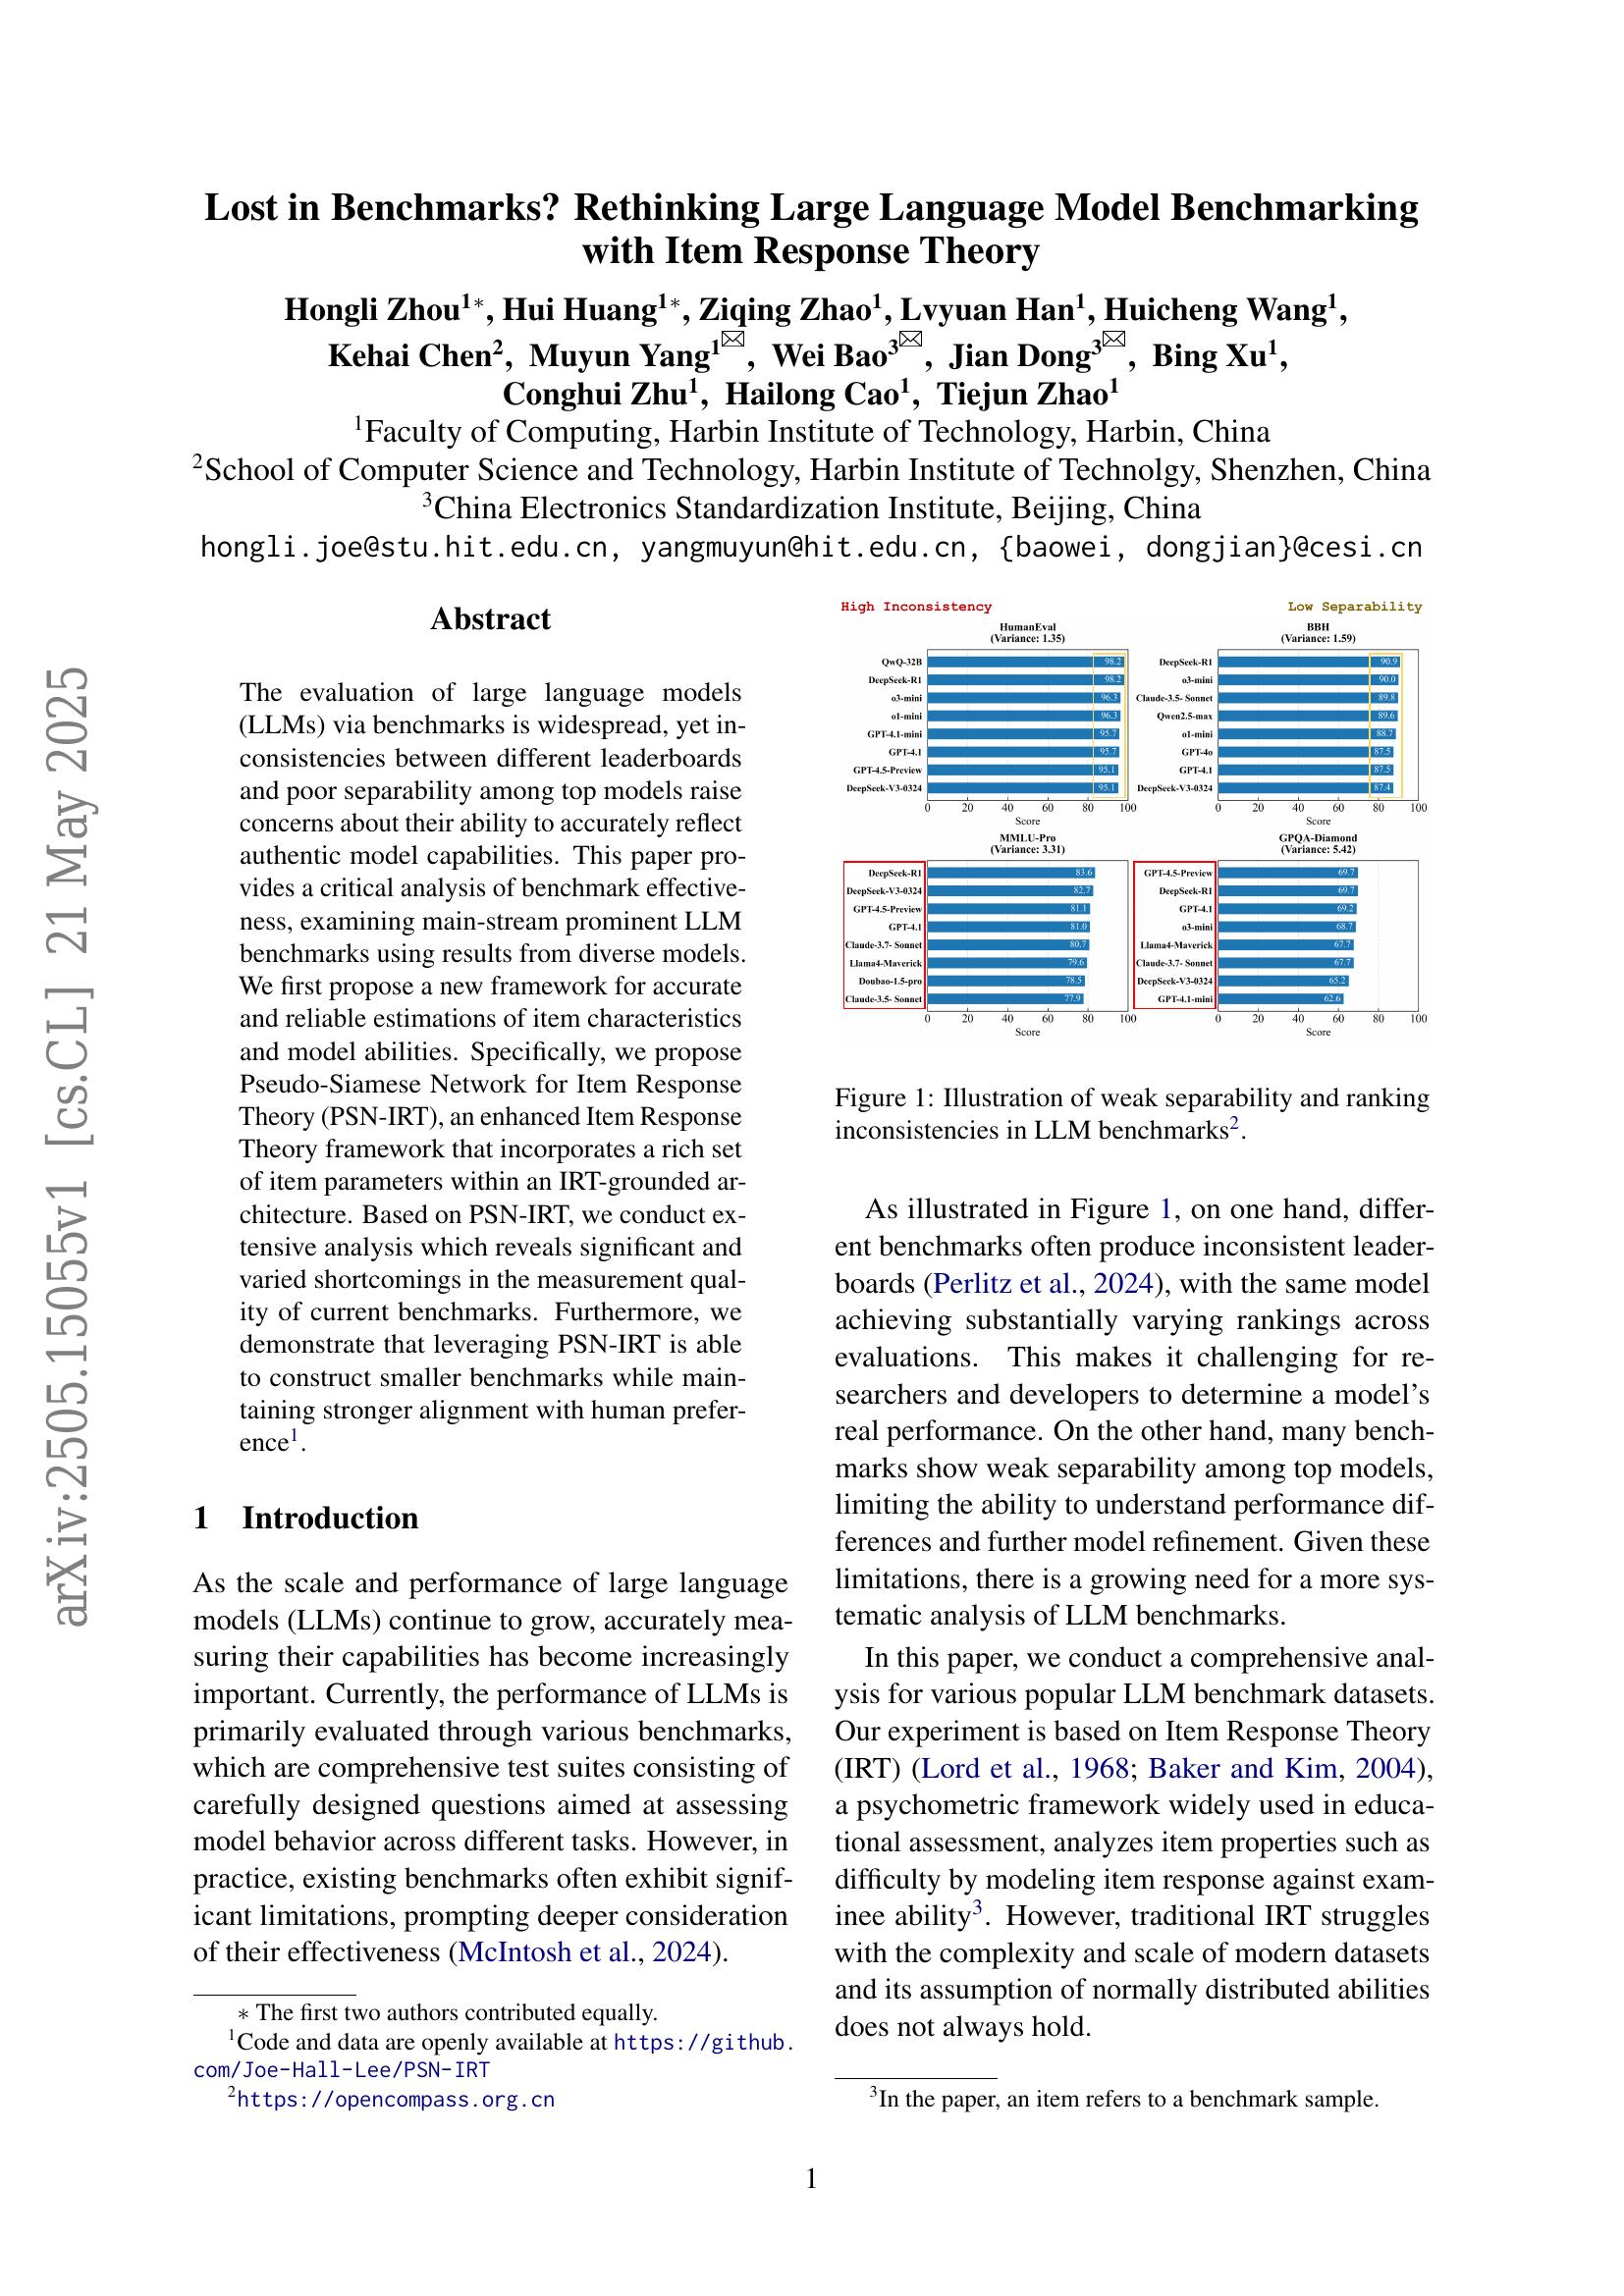
Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...

Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...
Lost in Benchmarks? Rethinking Large Language Model Benchmarking with ...

Figure 1 from Lost in Benchmarks? Rethinking Large Language Model ...

A Survey on Large Language Model Benchmarks | AI Research Paper Details

Paper page - Benchmarking Benchmark Leakage in Large Language Models

LLMCBench: Benchmarking Large Language Model Compression for Efficient ...

Benchmarking Benchmark Leakage in Large Language Models - 智源社区论文
Rethinking and Benchmarking Large Language Models for Graph Reasoning ...
Advertisement Space (300x250)
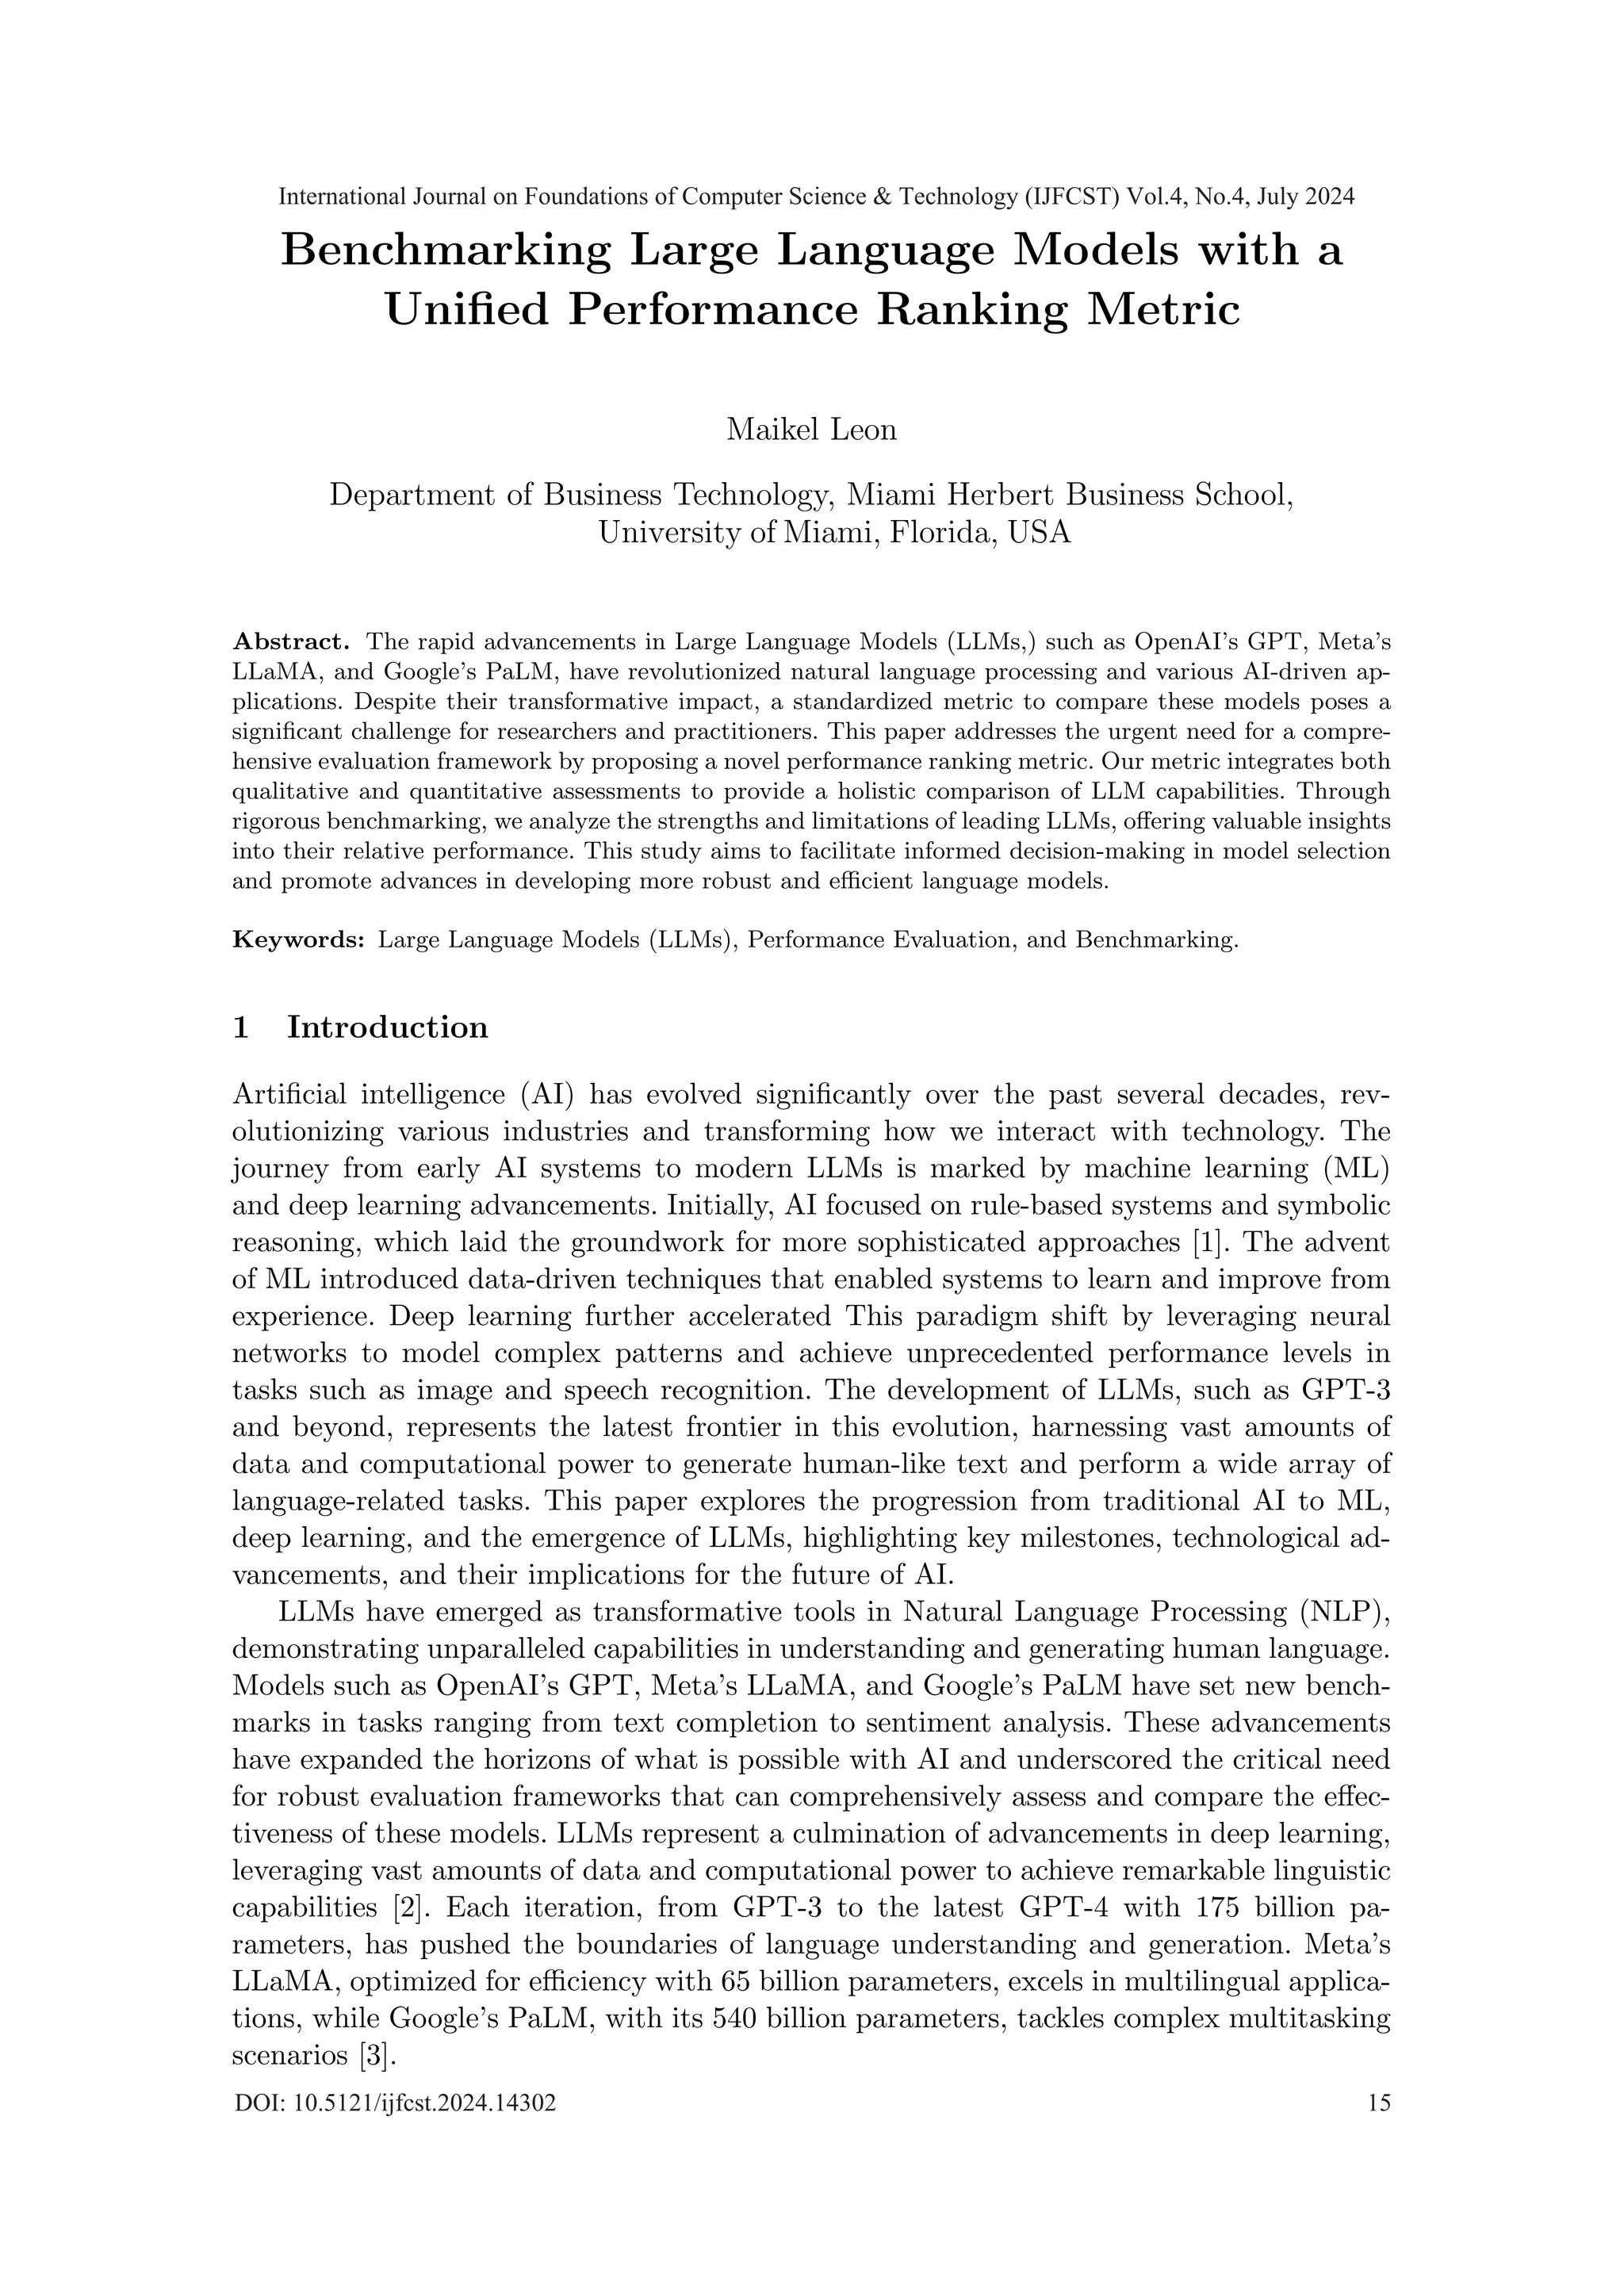
Benchmarking Large Language Models with a Unified Performance Ranking ...
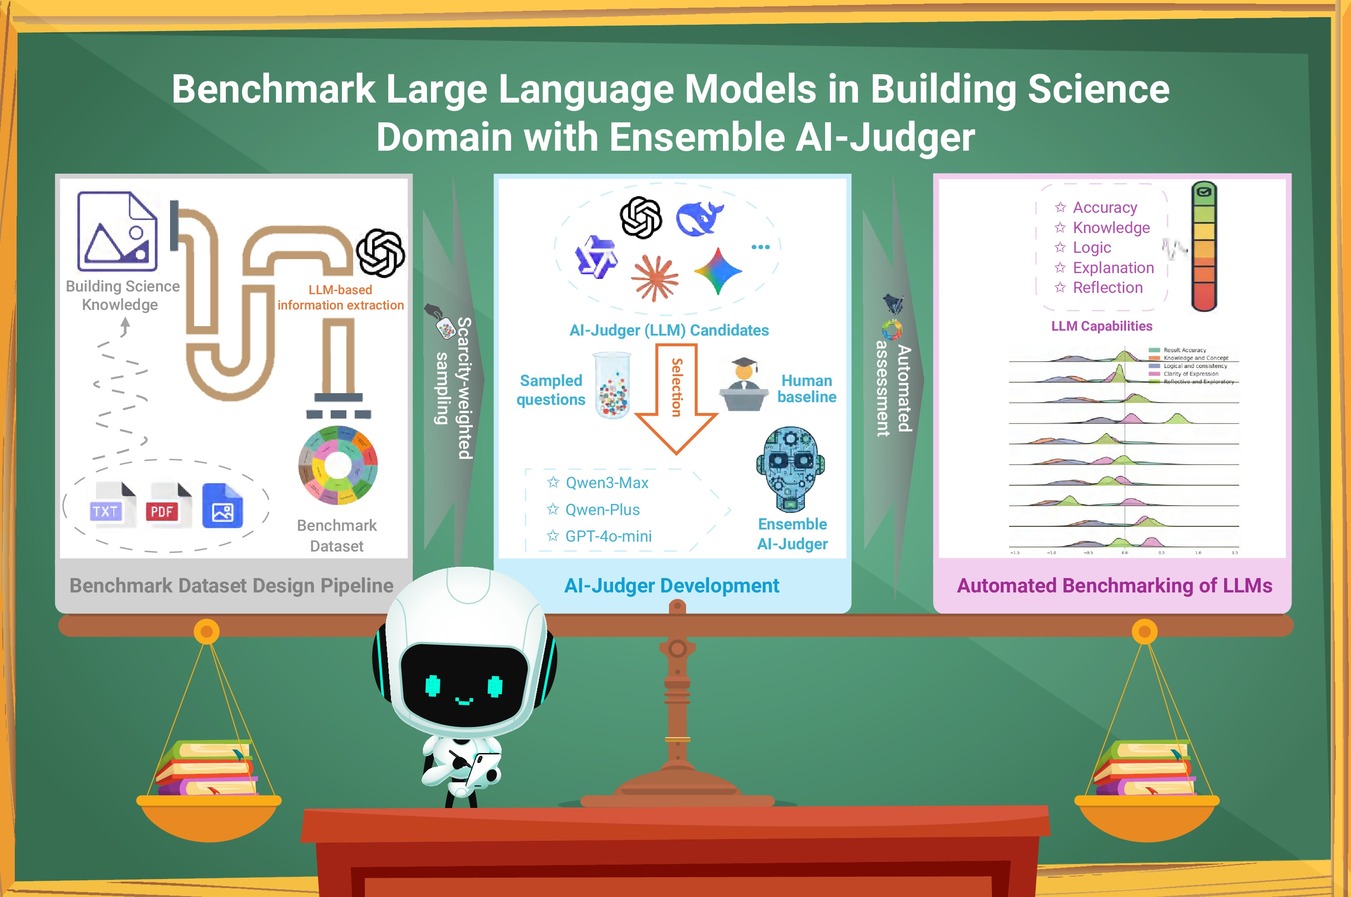
Benchmarking Knowledge and Capability of Large Language Models in ...
How to Benchmark Large Language Model Performance with LlamaIndex ...

SOLUTION: Large language model routing with benchmark datasets - Studypool
Large Language Model Benchmarks | mlcommons/inference_results_v6.0 ...

Enterprise Benchmarks For Large Language Model Evaluation 4lxl1jzv6cpd ...

Medical Large Language Model Benchmarks Should Prioritize Construct ...

Paper page - A Survey on Large Language Model Benchmarks
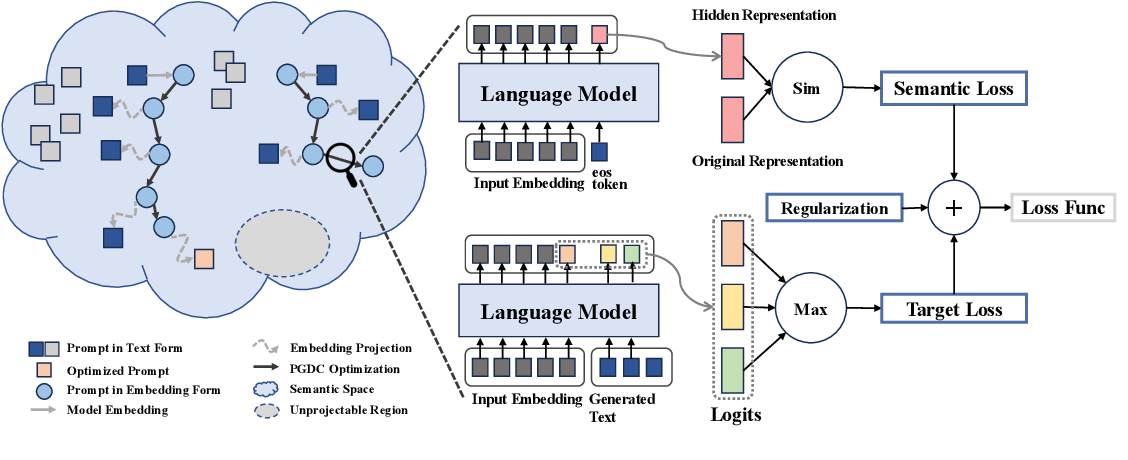
Figure 2 from Benchmarking Knowledge Boundary for Large Language Model ...
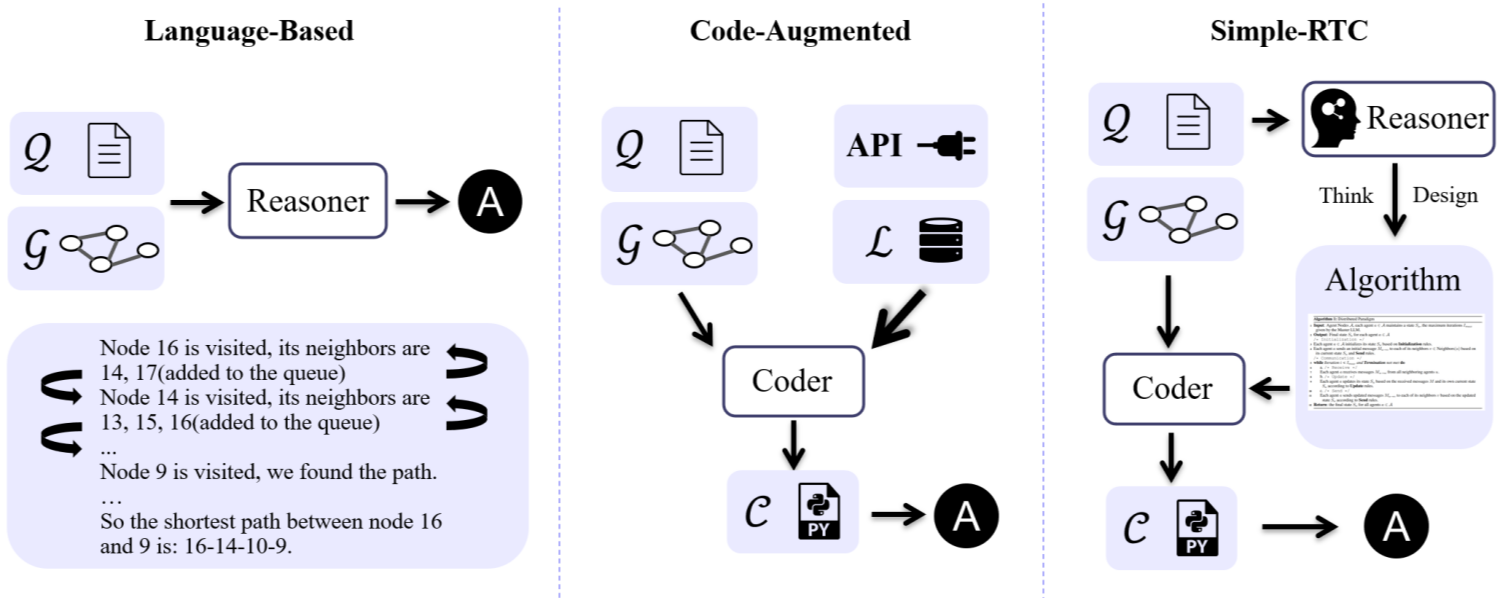
[논문 리뷰] Rethinking and Benchmarking Large Language Models for Graph ...
Advertisement Space (336x280)

(PDF) Do Large Language Model Benchmarks Test Reliability?

Benchmarking Large Language Models with a Unified Performance Ranking ...
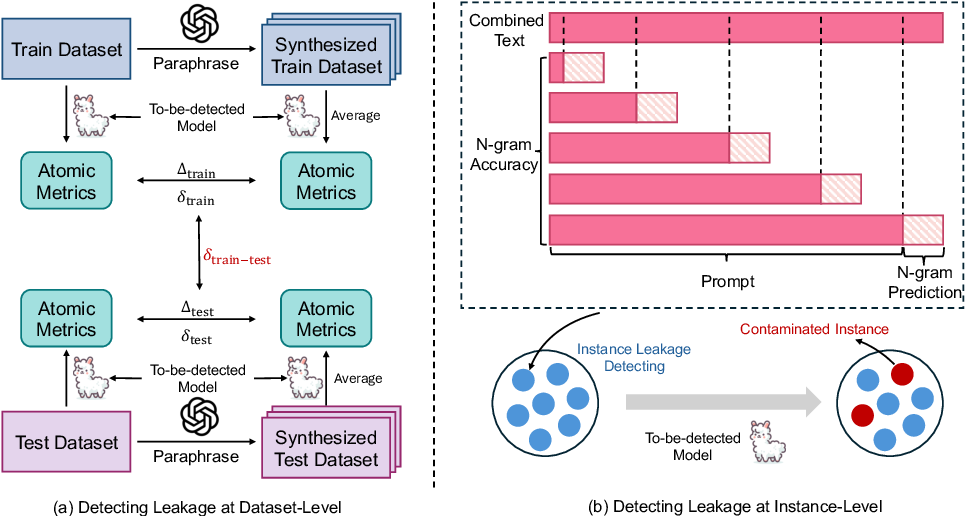
Figure 2 from Benchmarking Benchmark Leakage in Large Language Models ...

Benchmarking Large Language Models in Retrieval-Augmented Generation ...

GLBench: A Comprehensive Benchmark for Graph with Large Language Models ...

Rethinking Benchmark and Contamination For Language Models With ...

(PDF) Benchmarking Large Language Models for News Summarization

(PDF) Benchmarking Large Language Models: Evaluating Robustness and ...

Benchmarking AI: Evaluating Large Language Models (LLMs) - Cuttlesoft ...
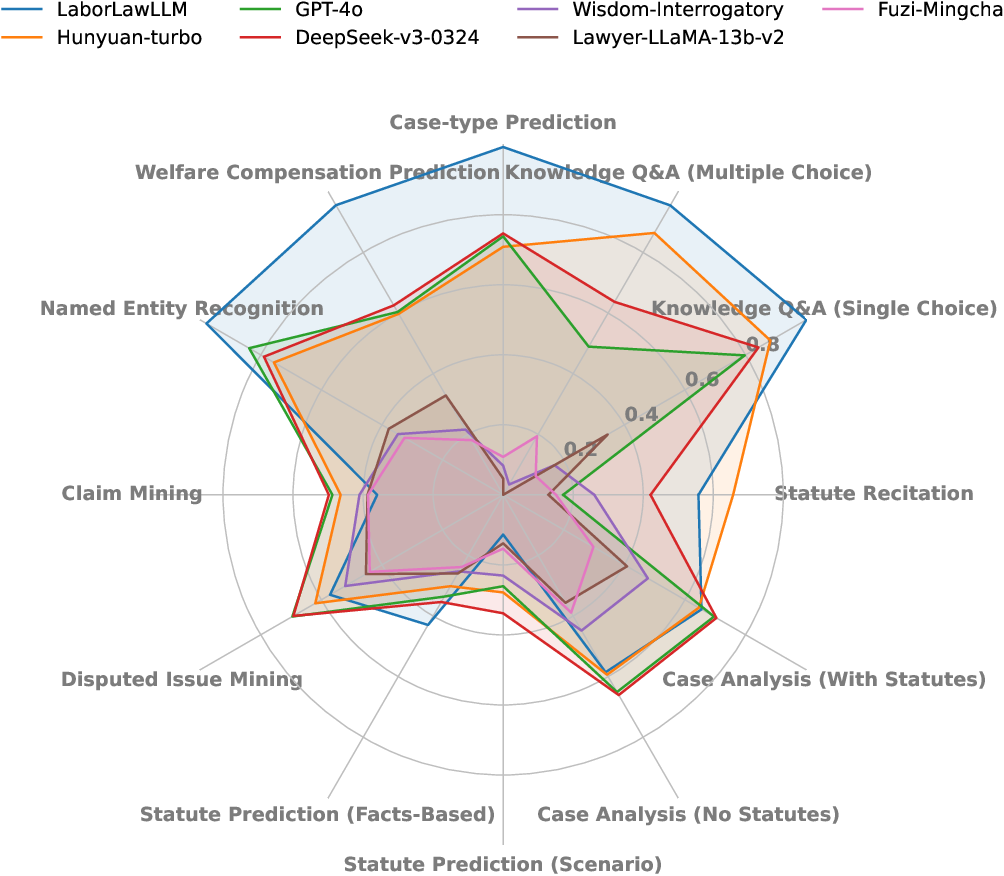
Figure 1 from Chinese Labor Law Large Language Model Benchmark ...
Advertisement Space (336x280)

Benchmarking Large Language Models: Enhancing Reliability & Reducing Bias

CPSDbench: a large language model evaluation benchmark and baseline for ...

[Revisión de artículo] Evaluating Large Language Models in Crisis ...

Evaluating Large Language Models in Crisis Detection: A Real-World ...

(PDF) LLM4Mat-bench: benchmarking large language models for materials ...

Benchmarking Large Language Models from Open and Closed Source Models ...