
Figure 1 From Maximum Likelihood Voice Conversion Based On Gmm With
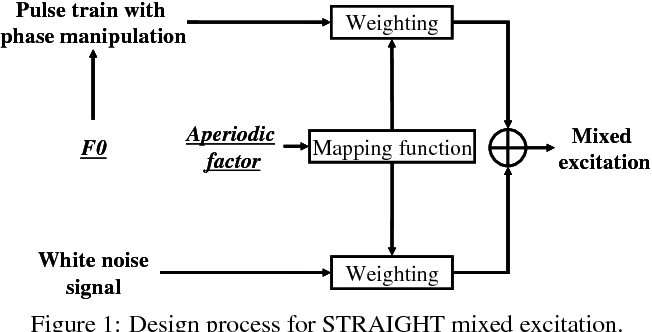
Figure 1 from Maximum likelihood voice conversion based on GMM with ...
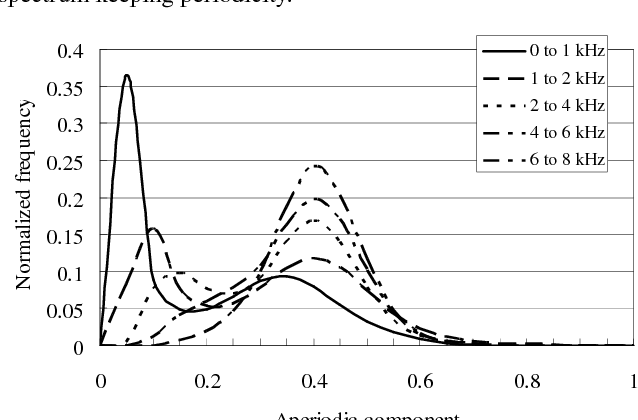
Figure 3 from Maximum likelihood voice conversion based on GMM with ...

Figure 2 from Maximum likelihood voice conversion based on GMM with ...
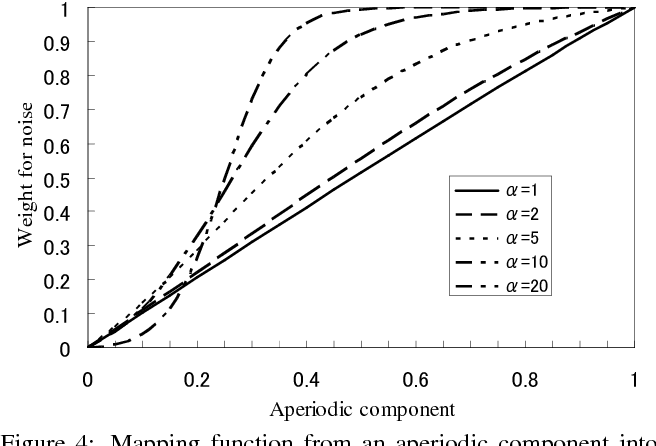
Figure 4 from Maximum likelihood voice conversion based on GMM with ...
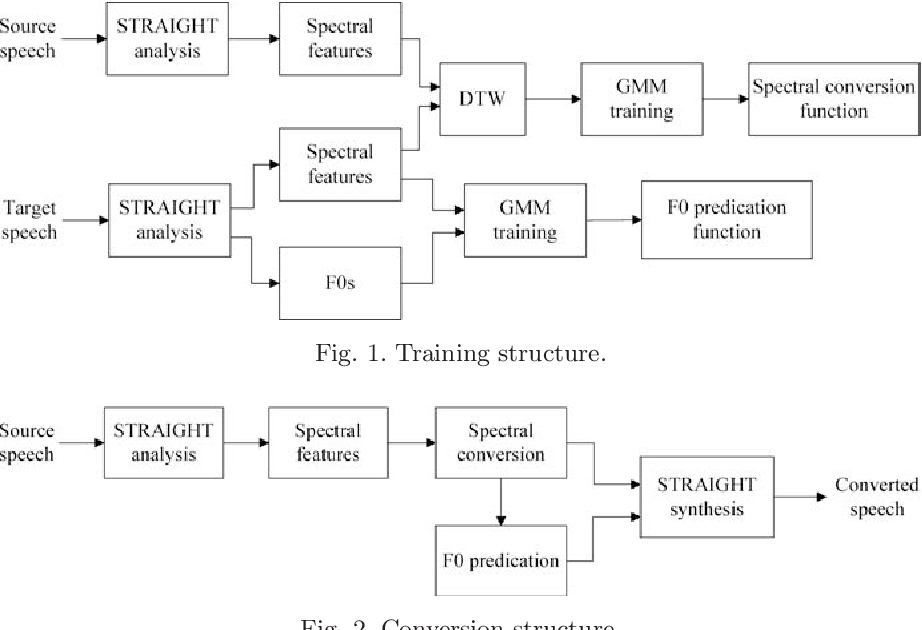
Figure 1 from Voice Conversion Based on Hybrid SVR and GMM | Semantic ...

Figure 2 from Low-delay voice conversion based on maximum likelihood ...

(PDF) Maximum likelihood voice conversion based on GMM with STRAIGHT ...
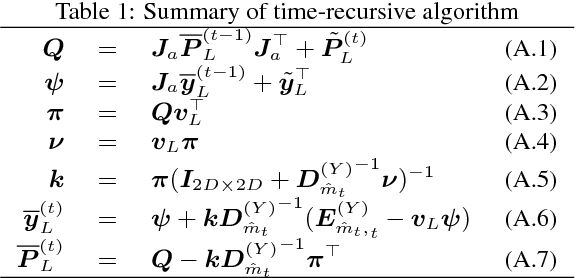
Table 1 from Low-delay voice conversion based on maximum likelihood ...
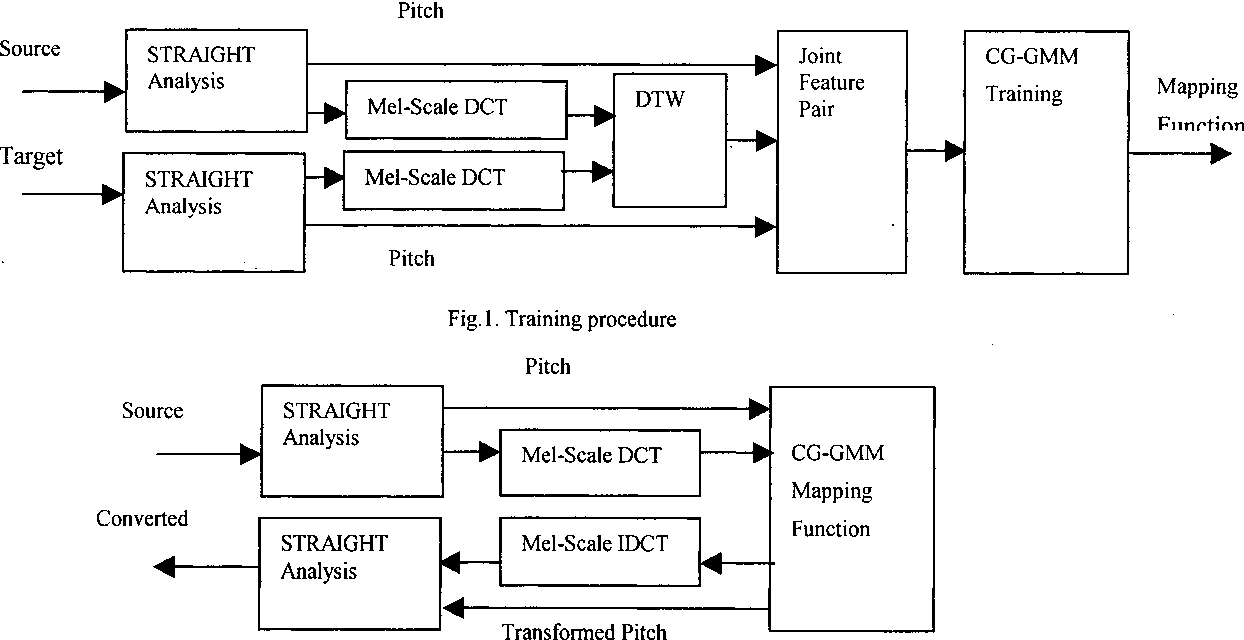
Figure 1 from Voice conversion based on joint pitch and spectral ...

Figure 1 from Diffusion-Based Voice Conversion with Fast Maximum ...
Advertisement Space (300x250)
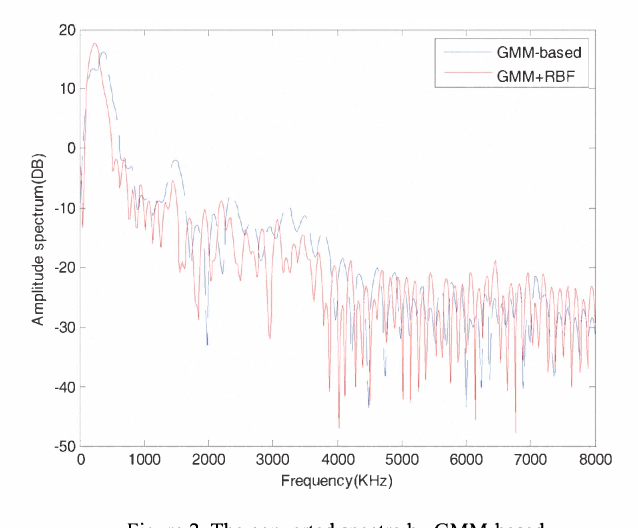
Figure 2 from Voice Conversion based on GMM and Artificial Neural ...

Figure 1 from Statistical Voice Conversion Based on Wavenet | Semantic ...
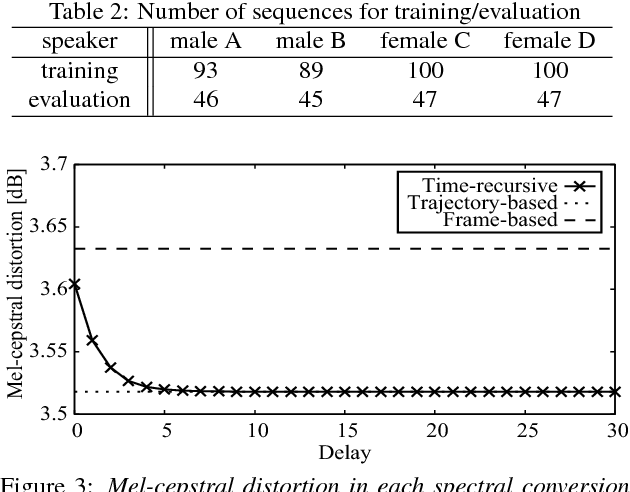
Table 2 from Low-delay voice conversion based on maximum likelihood ...
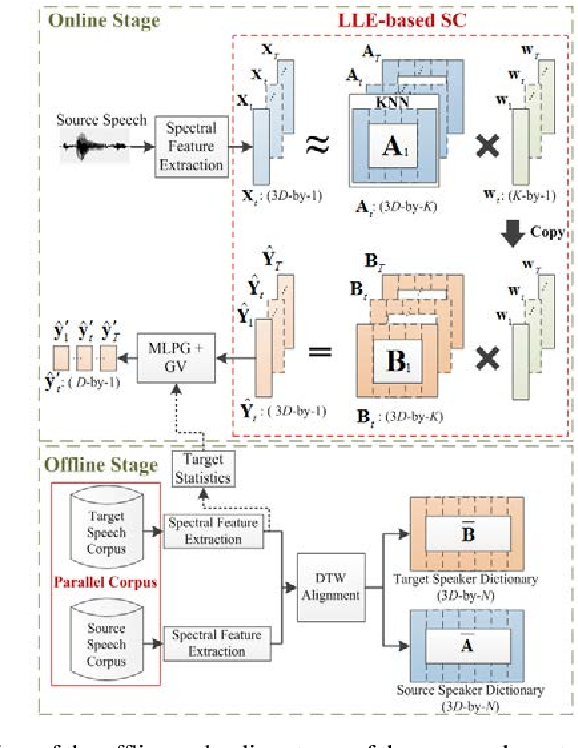
Figure 1 from Voice Conversion Based on Locally Linear Embedding ...

Figure 1 from Voice conversion using Viterbi algorithm based on ...

Figure 1 from GMM-based voice conversion with explicit modelling on ...
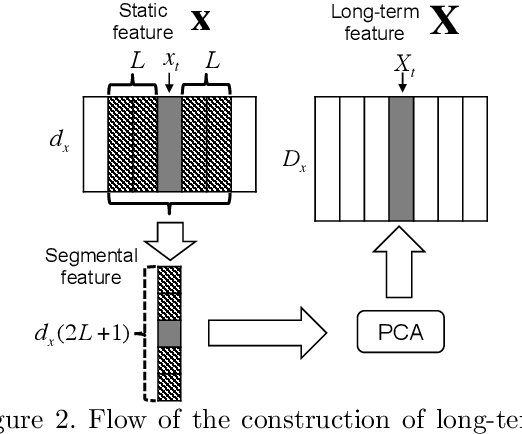
Figure 2 from Visual-to-speech conversion based on maximum likelihood ...
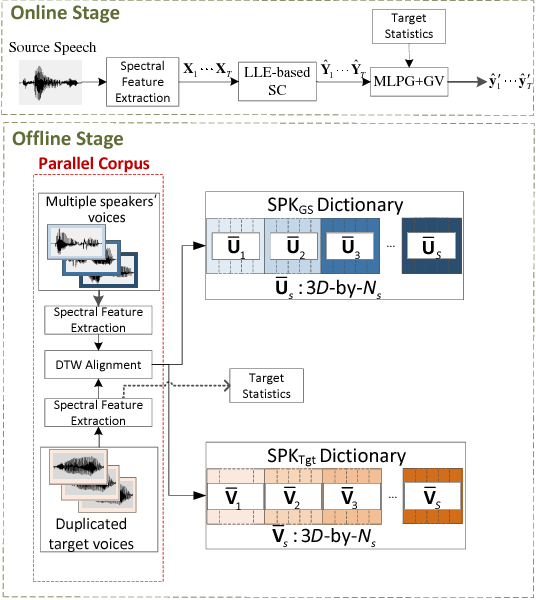
Figure 1 from Voice Conversion Based on Locally Linear Embedding ...
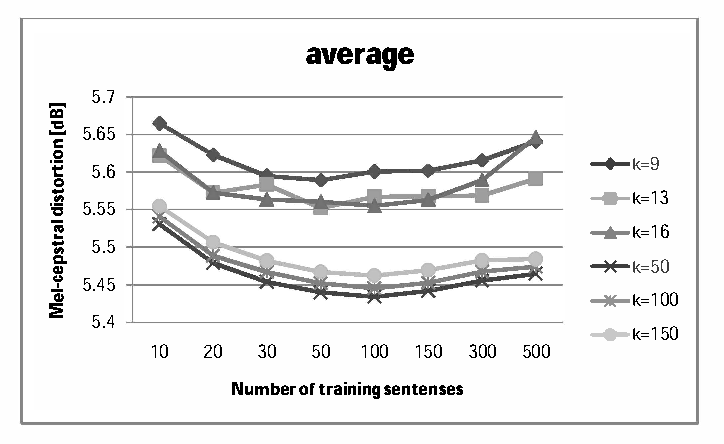
Figure 1 from Voice conversion based on State Space Model and ...
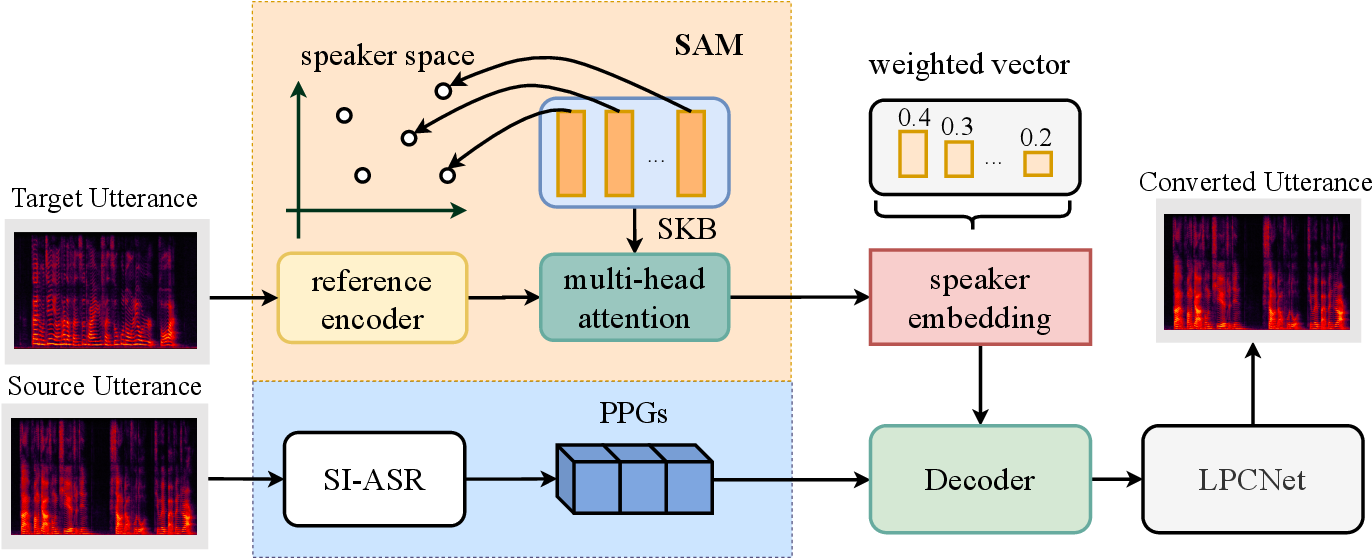
Figure 1 from One-Shot Voice Conversion Based on Speaker Aware Module ...
Advertisement Space (336x280)

Figure 1 from A system for voice conversion based on adaptive filtering ...
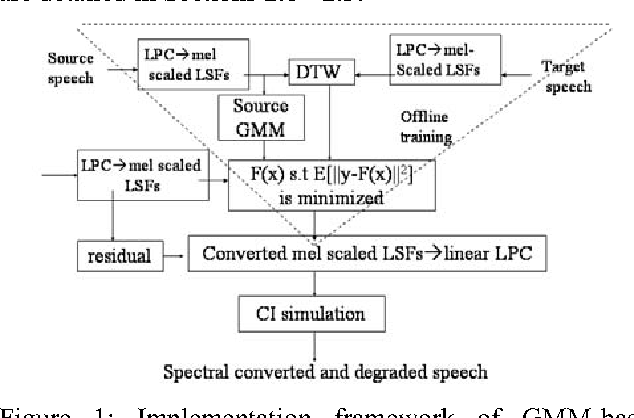
Figure 1 from Smooth Gmm Based Multi-Talker Spectral Conversion for ...

Figure 1 from Voice activity detection based on sequential Gaussian ...

Figure 1 from Speaker Identification Based on Voice Samples using MFCC ...
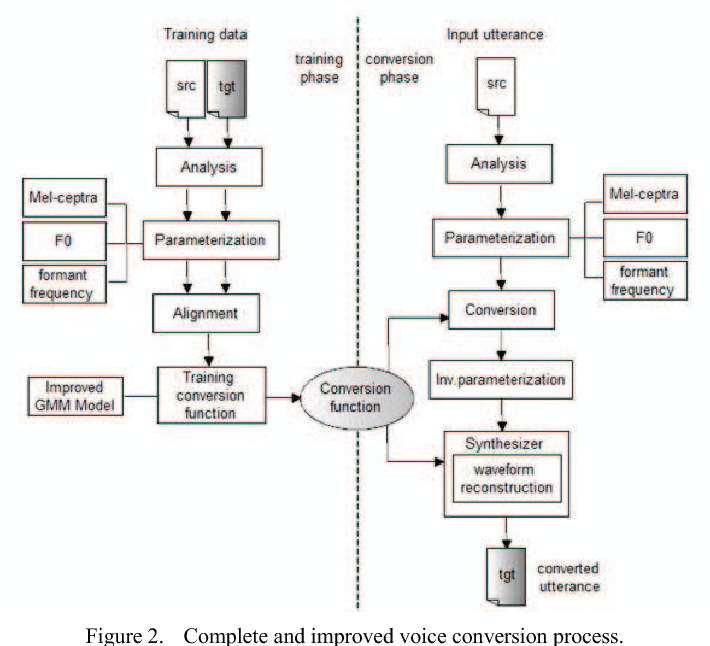
Figure 2 from Comprehensive Voice Conversion Analysis Based on DGMM and ...

Figure 1 from Smooth Gmm Based Multi-Talker Spectral Conversion for ...
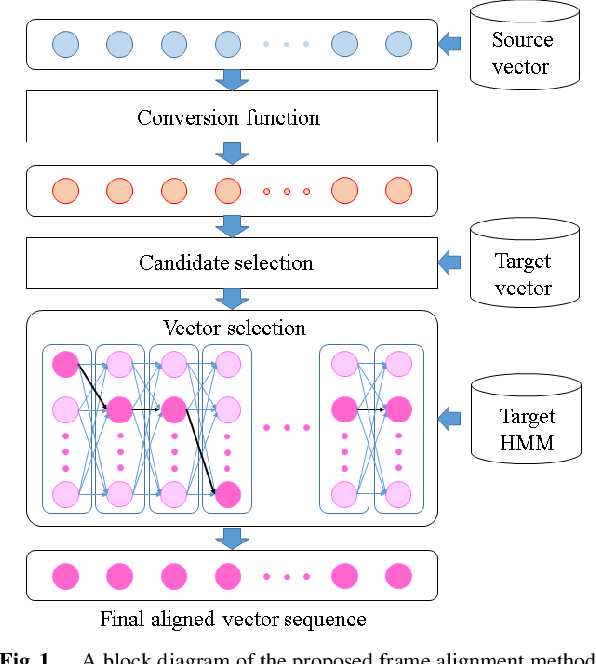
Figure 1 from HMM-Based Maximum Likelihood Frame Alignment for Voice ...

(PDF) Low-delay voice conversion based on maximum likelihood estimation ...
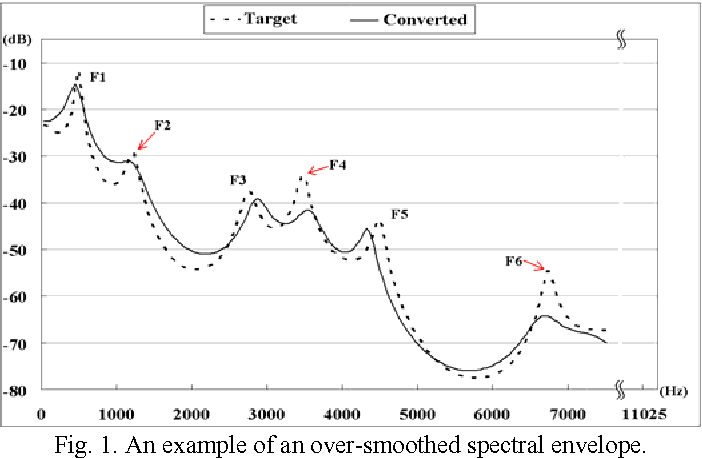
Figure 1 from A Voice Conversion Method Combining Segmental GMM Mapping ...

Figure 1 from ATTS2S-VC: Sequence-to-sequence Voice Conversion with ...
Advertisement Space (336x280)

Figure 1 from A New HMM-Based Voice Conversion Methodology Evaluated on ...

Figure 1 from GMM-Based Emotional Voice Conversion Using Spectrum and ...

Figure 1 from Fast GMM-based voice conversion for text-to-speech ...
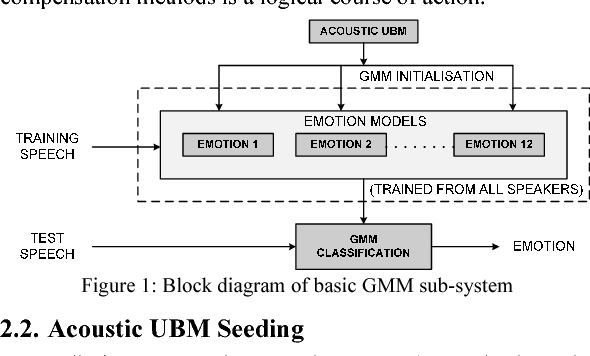
Figure 1 from GMM based speaker variability compensated system for ...

Figure 1 from Narrowband to wideband conversion of speech using GMM ...
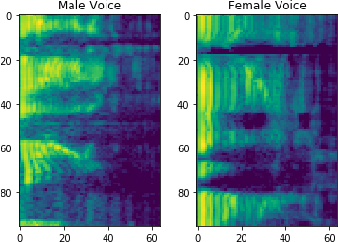
Figure 1 from Voice Conversion using Generative Techniques | Semantic ...