
Figure 2 From Low Delay Voice Conversion Based On Maximum Likelihood

Figure 2 from Low-delay voice conversion based on maximum likelihood ...

Figure 2 from Maximum likelihood voice conversion based on GMM with ...
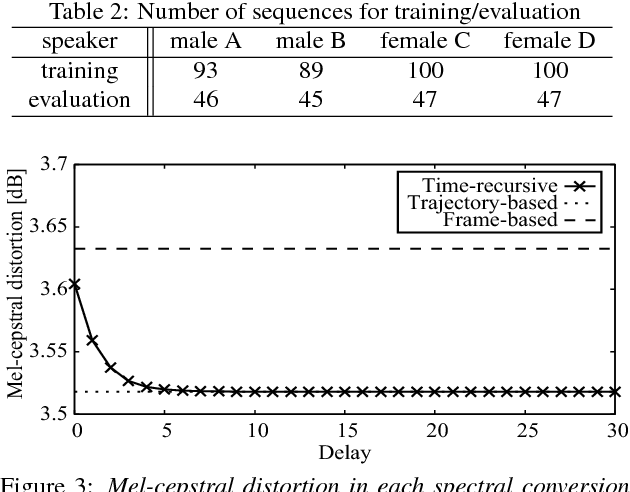
Table 2 from Low-delay voice conversion based on maximum likelihood ...
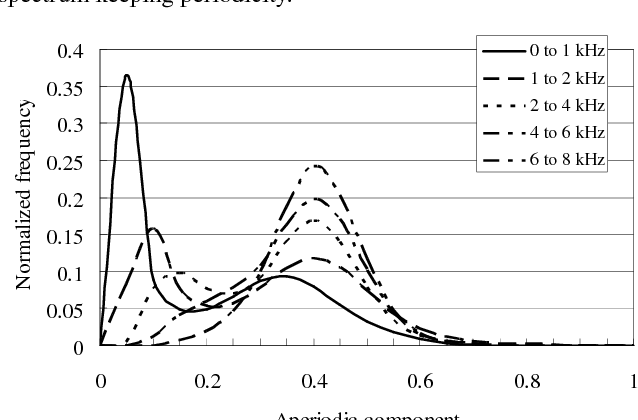
Figure 3 from Maximum likelihood voice conversion based on GMM with ...
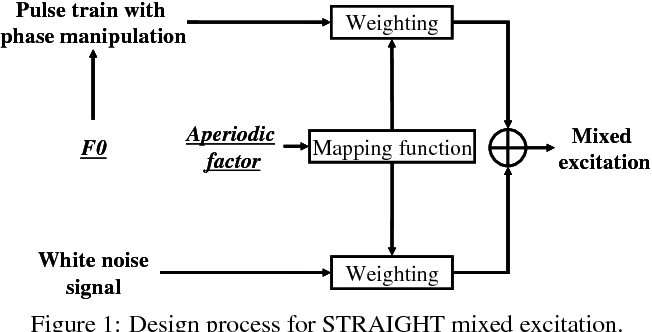
Figure 1 from Maximum likelihood voice conversion based on GMM with ...
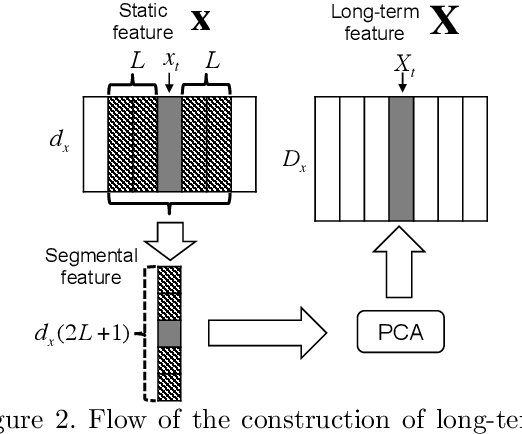
Figure 2 from Visual-to-speech conversion based on maximum likelihood ...
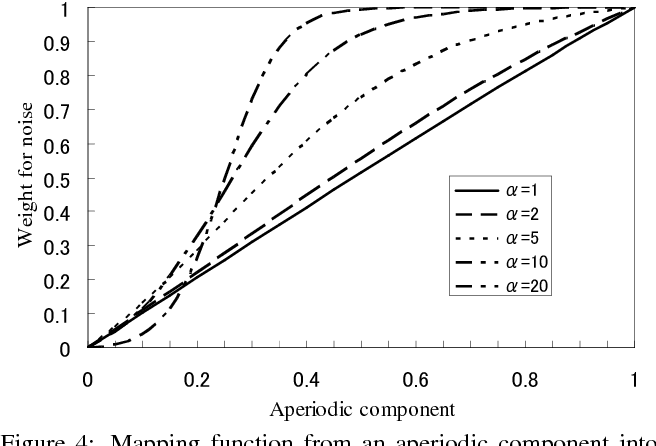
Figure 4 from Maximum likelihood voice conversion based on GMM with ...
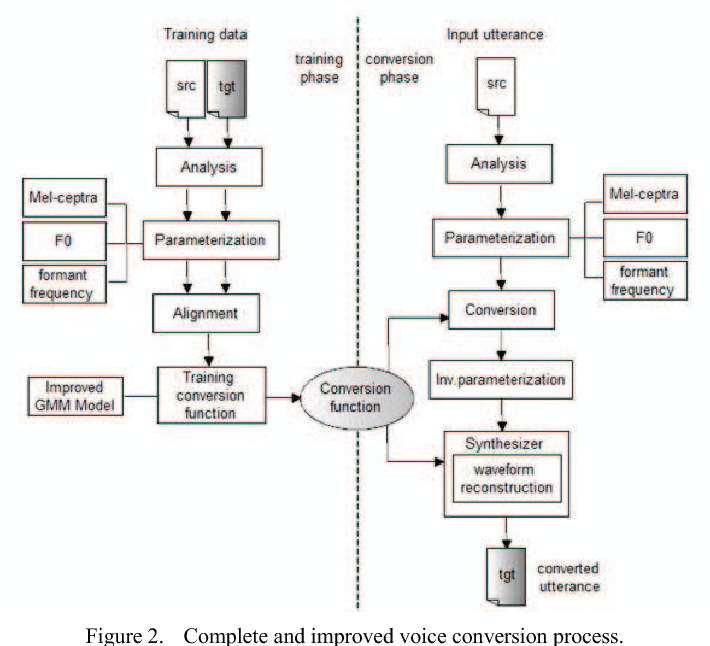
Figure 2 from Comprehensive Voice Conversion Analysis Based on DGMM and ...
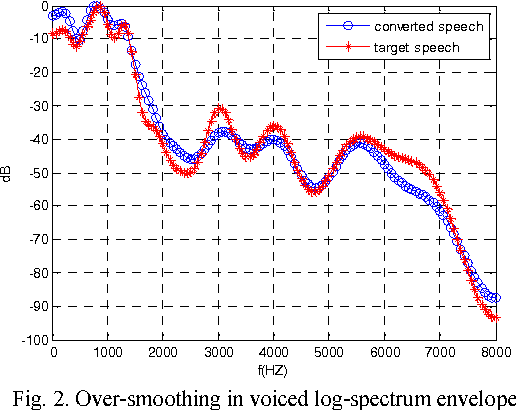
Figure 2 from Voice conversion based on Gaussian mixture modules with ...

Figure 2 from Voice Conversion Based on Locally Linear Embedding ...
Advertisement Space (300x250)
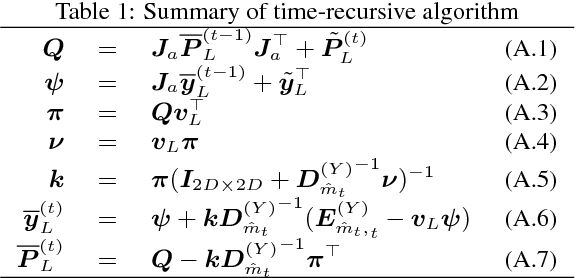
Table 1 from Low-delay voice conversion based on maximum likelihood ...

Figure 2 from Voice Conversion Based on Deep Neural Networks for Time ...

Figure 2 from High-Quality Nonparallel Voice Conversion Based on Cycle ...
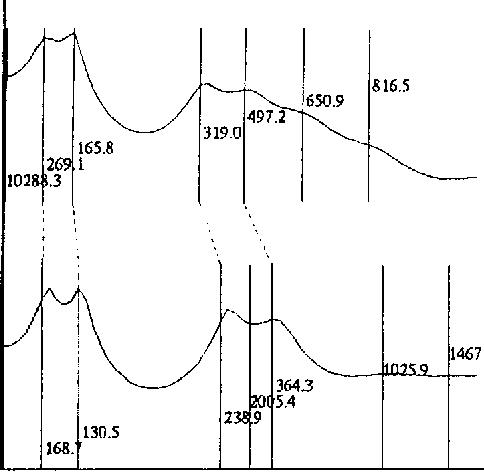
Figure 2 from Voice conversion based on piecewise linear conversion ...
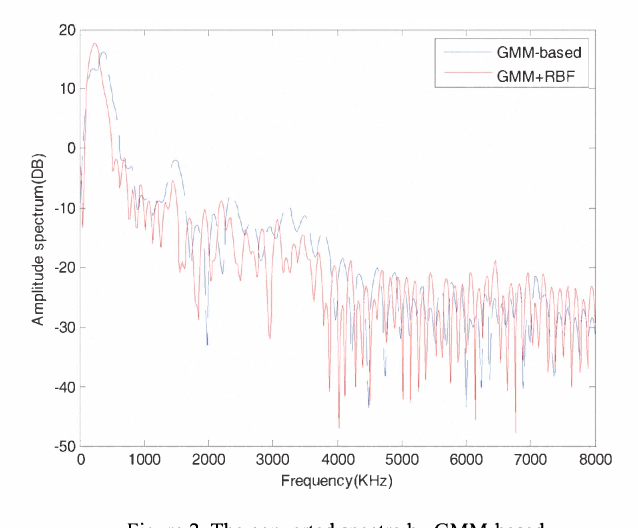
Figure 2 from Voice Conversion based on GMM and Artificial Neural ...

(PDF) Low-delay voice conversion based on maximum likelihood estimation ...

Figure 2 from Enhancing Multilingual TTS with Voice Conversion Based ...

Figure 2 from Low-Latency Real-Time Non-Parallel Voice Conversion based ...
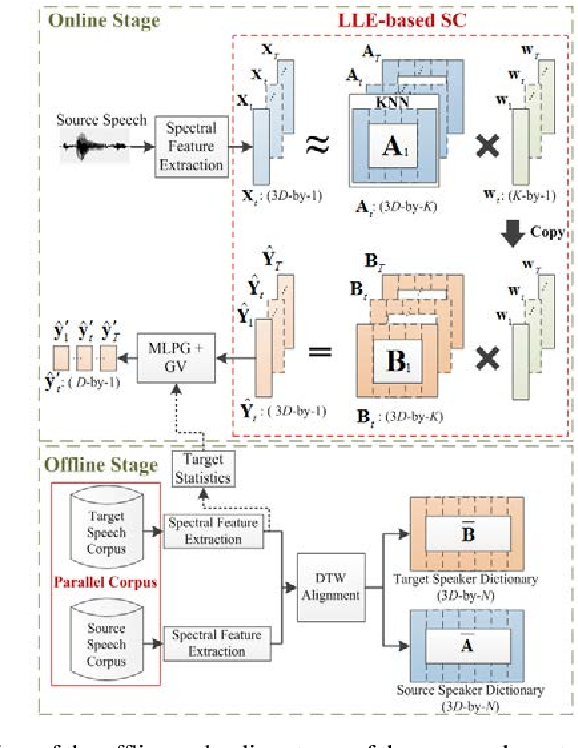
Figure 1 from Voice Conversion Based on Locally Linear Embedding ...

Figure 1 from A system for voice conversion based on adaptive filtering ...
Advertisement Space (336x280)

(PDF) Maximum likelihood voice conversion based on GMM with STRAIGHT ...

Figure 1 from Noise-robust voice conversion based on spectral mapping ...
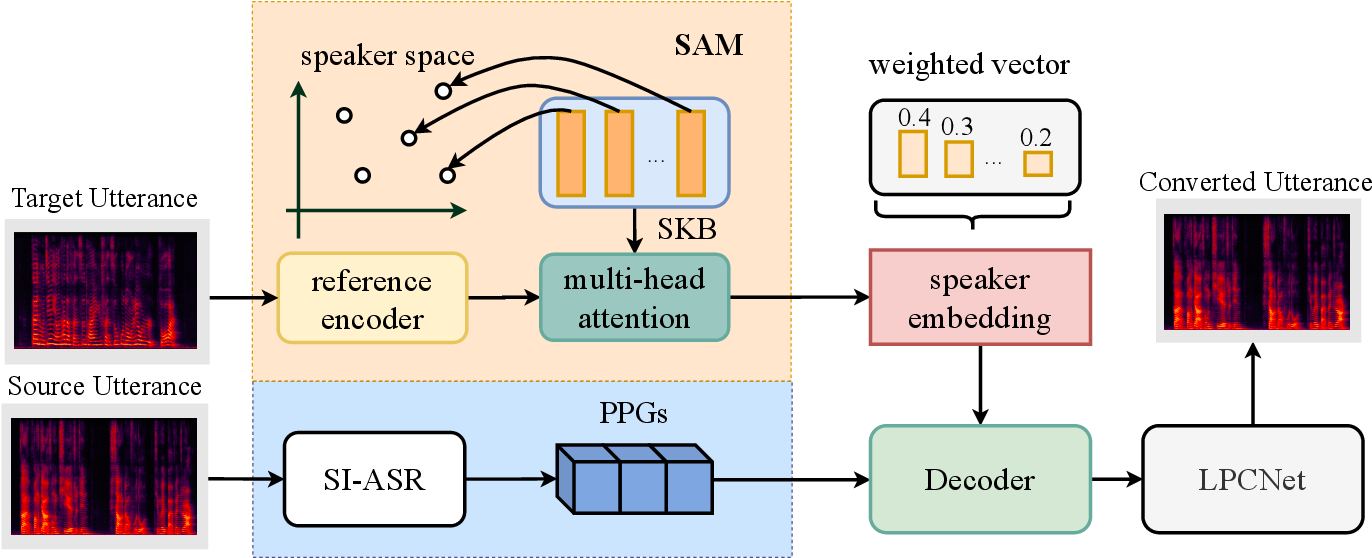
Figure 1 from One-Shot Voice Conversion Based on Speaker Aware Module ...

Figure 1 from Voice conversion based on Non-negative matrix ...

Figure 5 from Voice Conversion Based on Locally Linear Embedding ...

Figure 1 from Voice conversion using Viterbi algorithm based on ...

Figure 10 from Voice Conversion Based on Deep Neural Networks for Time ...

Figure 3 from Voice Conversion Based on Locally Linear Embedding ...

Figure 1 from Voice Conversion Based on Deep Neural Networks for Time ...
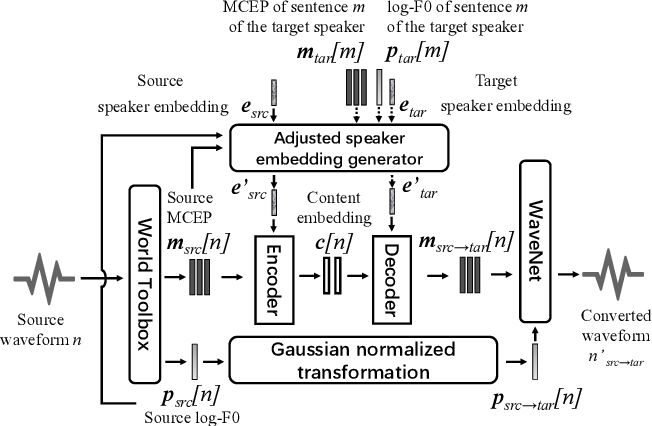
Figure 2 from Zero-Shot Voice Conversion with Adjusted Speaker ...
Advertisement Space (336x280)

Figure 2 from Voice Conversion Using Sequence-to-Sequence Learning of ...

Figure 1 from Low-latency Real-time Voice Conversion on CPU | Semantic ...
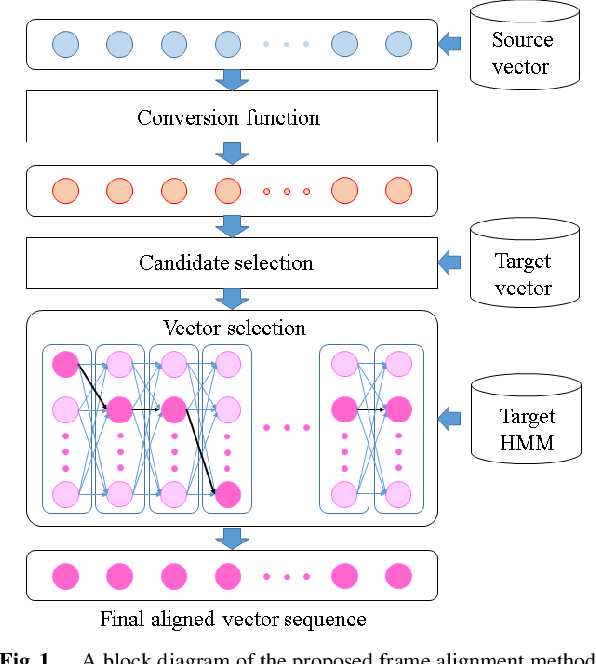
Figure 1 from HMM-Based Maximum Likelihood Frame Alignment for Voice ...

Figure 1 from Low-Latency Real-Time Non-Parallel Voice Conversion based ...
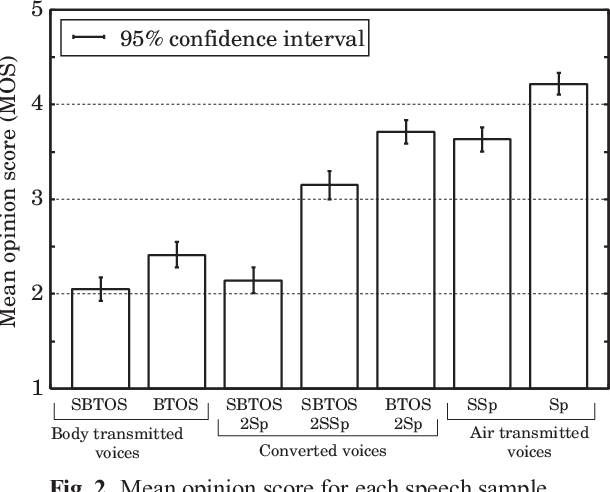
Figure 2 from Voice conversion for various types of body transmitted ...

Diffusion-Based Voice Conversion with Fast Maximum Likelihood Sampling ...