
Figure 1 From Respinquant Efficient Layer Wise Llm Quantization Via
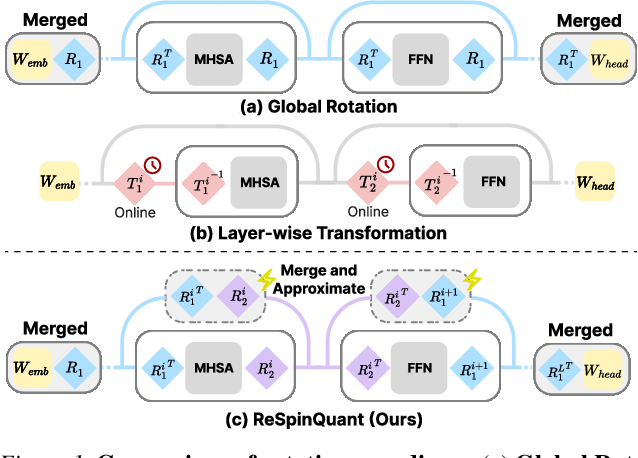
Figure 1 from ReSpinQuant: Efficient Layer-Wise LLM Quantization via ...

Table 1 from ReSpinQuant: Efficient Layer-Wise LLM Quantization via ...

Figure 1 from QuEST: Low-bit Diffusion Model Quantization via Efficient ...
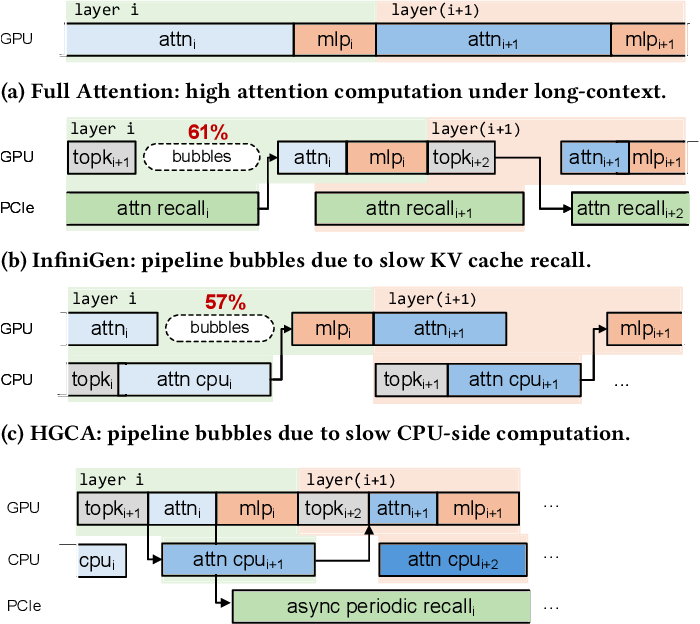
Figure 1 from ScoutAttention: Efficient KV Cache Offloading via Layer ...
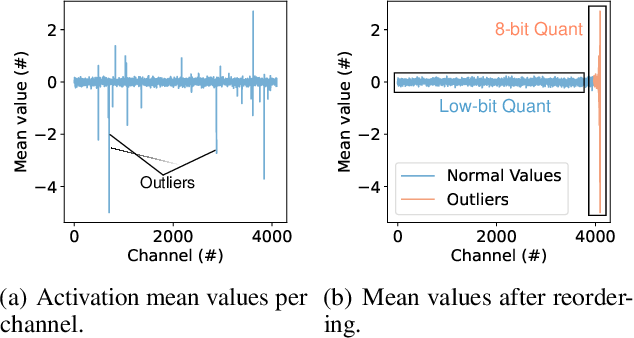
Figure 1 from Atom: Low-bit Quantization for Efficient and Accurate LLM ...
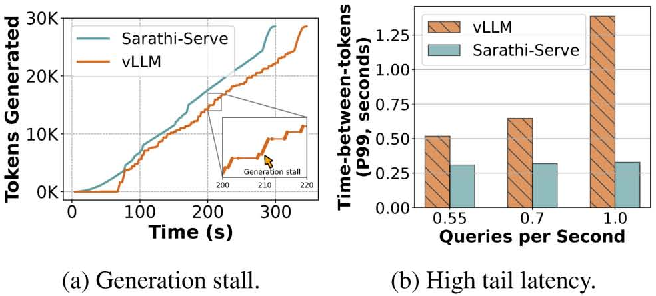
Figure 1 from Efficient LLM Inference via Chunked Prefills | Semantic ...

Figure 1 from Oaken: Fast and Efficient LLM Serving with Online-Offline ...

Figure 1 from Deep Neural Network Quantization via Layer-Wise ...
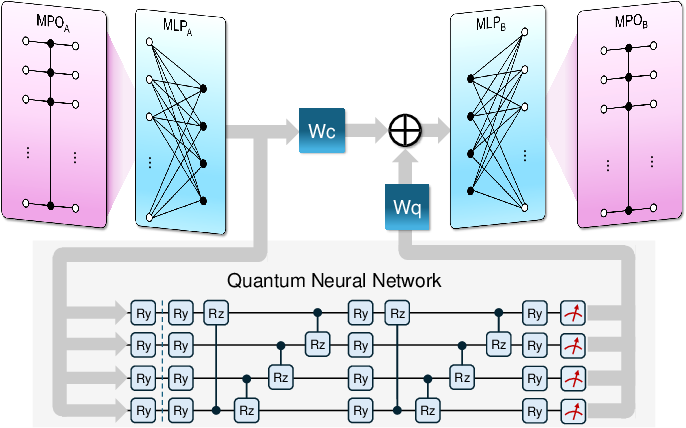
Figure 1 from Quantum-Enhanced LLM Efficient Fine Tuning | Semantic Scholar
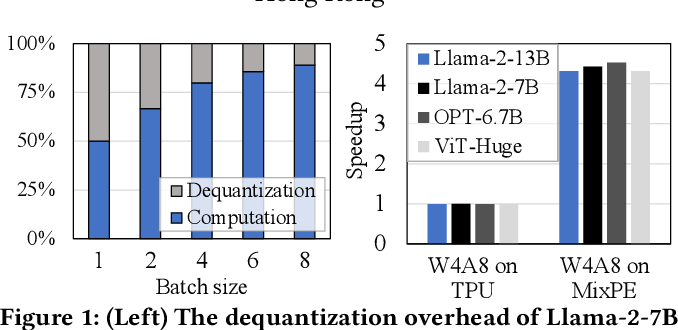
Figure 1 from MixPE: Quantization and Hardware Co-design for Efficient ...
Advertisement Space (300x250)

Figure 1 from Element-wise Partial Product Quantization for Efficient ...
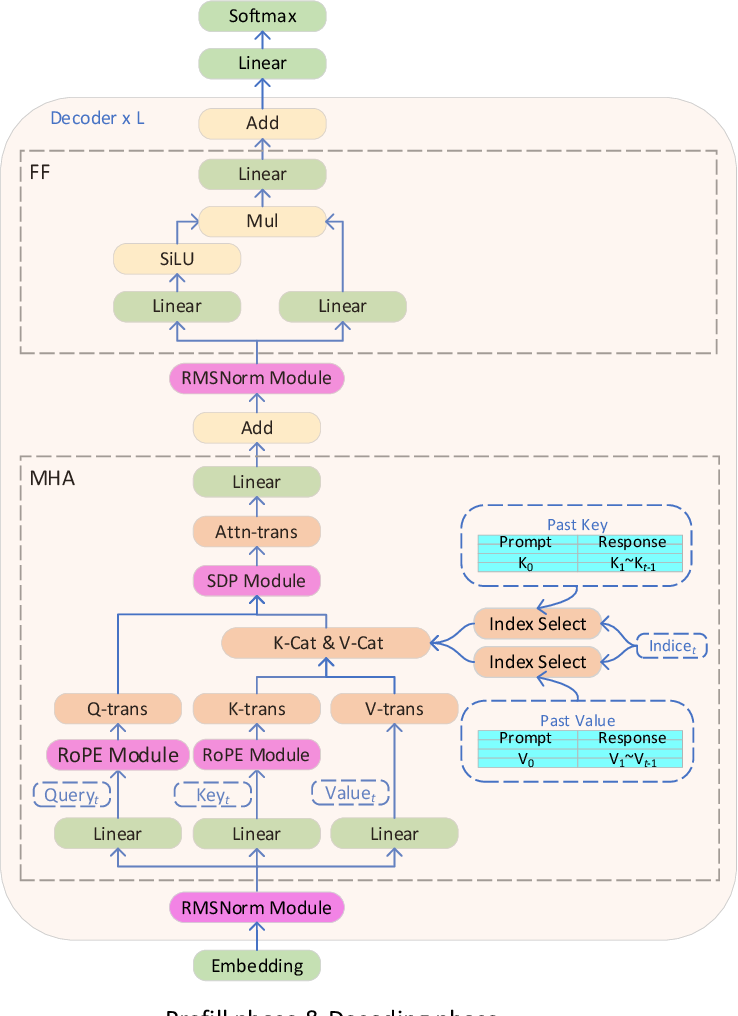
Figure 1 from Efficient LLM inference solution on Intel GPU | Semantic ...

ReSpinQuant: Efficient Layer-Wise LLM Quantization via Subspace ...

ReSpinQuant: Efficient Layer-Wise LLM Quantization via Subspace ...
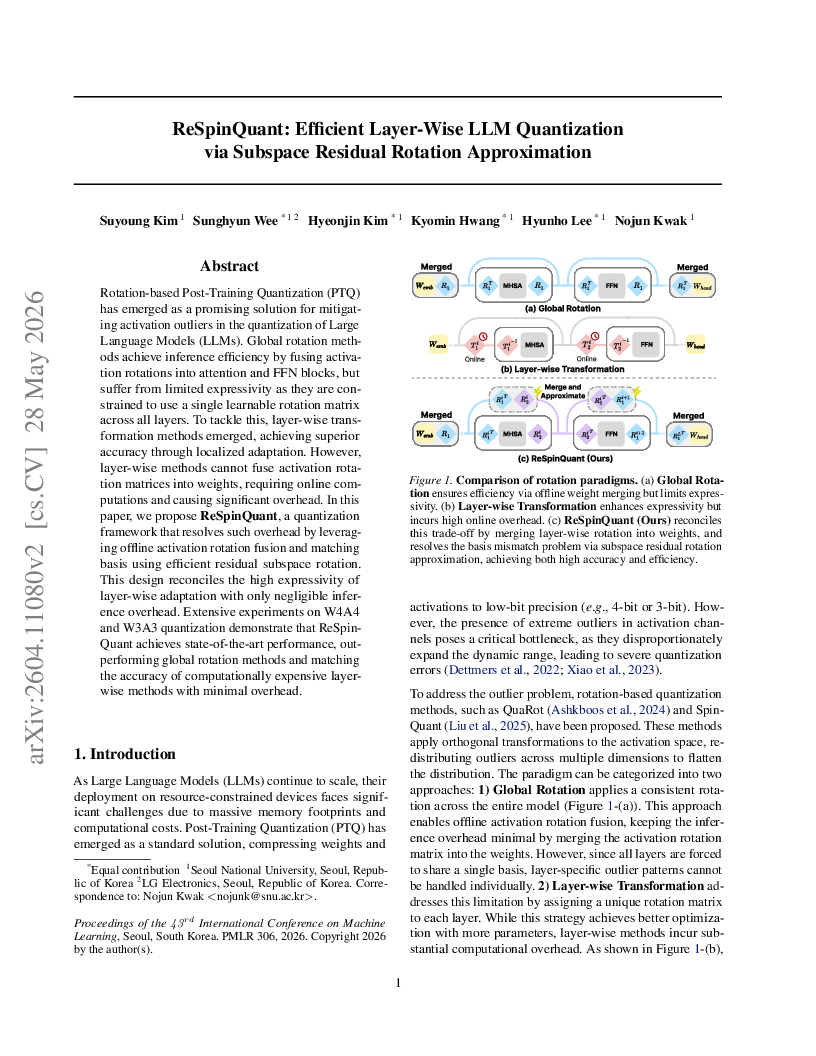
ReSpinQuant: Efficient Layer-Wise LLM Quantization via Subspace ...

ReSpinQuant: Efficient Layer-Wise LLM Quantization via Subspace ...

ReSpinQuant: Efficient Layer-Wise LLM Quantization via Subspace ...
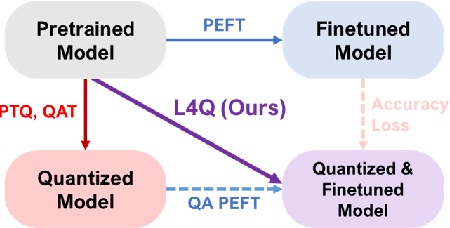
Figure 1 from L4Q: Parameter Efficient Quantization-Aware Training on ...

FlexQ: Efficient Post-training INT6 Quantization for LLM Serving via ...
FlexQ: Efficient Post-training INT6 Quantization for LLM Serving via ...
Advertisement Space (336x280)

Figure 1 from XShift: FPGA-efficient Binarized LLM with Joint ...
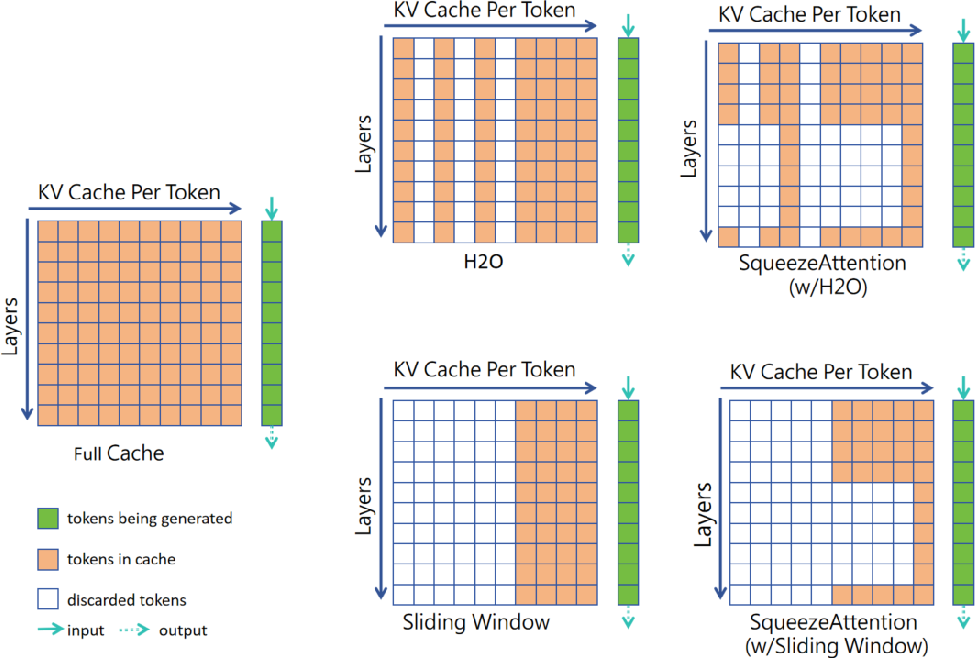
Figure 1 from SqueezeAttention: 2D Management of KV-Cache in LLM ...

Figure 1 from SparQ Attention: Bandwidth-Efficient LLM Inference ...

Developed DynaQuant for efficient LLM layer quantization | Ilia Badanin ...

Table 1 from Efficient Quantization Strategies for Latent Diffusion ...

BTC-LLM: Efficient Sub-1-Bit LLM Quantization via Learnable ...
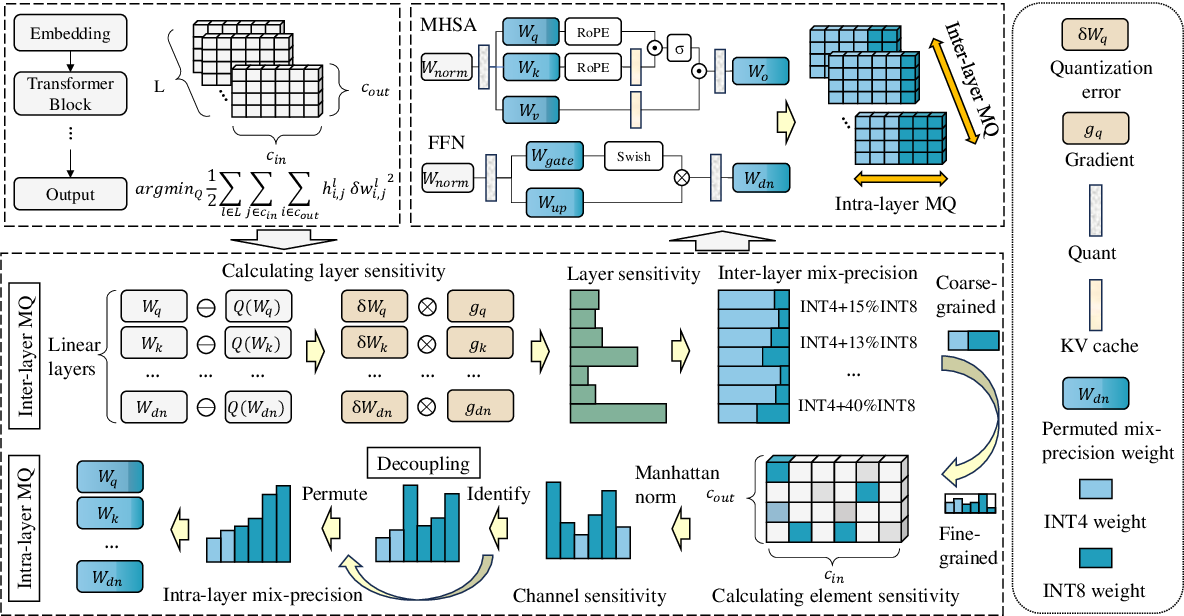
Figure 3 from Beyond Dynamic Quantization: An Efficient Static ...

LLM Inference Acceleration via Efficient Operation Fusion
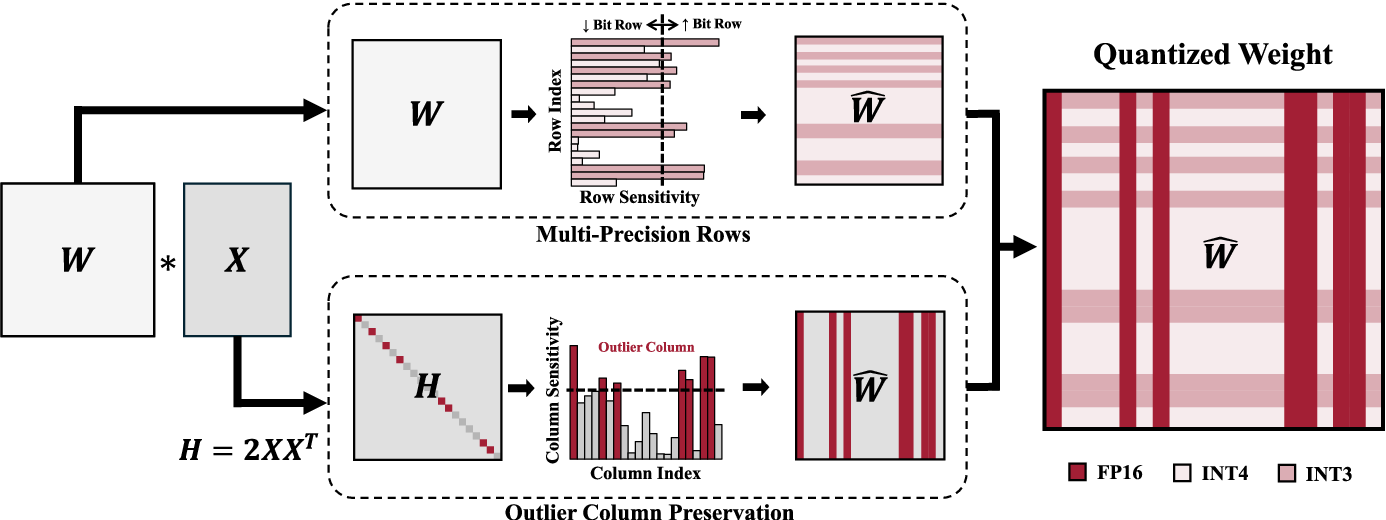
Figure 2 from Sub 4-bit Power-of-Two-Based Mixed-Precision Quantization ...

Dual Grained Quantization: Efficient Fine-Grained Quantization for LLM
Advertisement Space (336x280)

"ResQ: Efficient LLM Quantization with Low Rank Residuals" | Utkarsh ...

RQ-MoE: Residual Quantization via Mixture of Experts for Efficient ...

Dual Grained Quantization: Efficient Fine-Grained Quantization for LLM

VecInfer: Efficient LLM Inference with Low-Bit KV Cache via Outlier ...

Layer Wise Quantization (LWQ) — Intel® Neural Compressor 2.4 documentation

Atom: Low-bit Quantization for Efficient and Accurate LLM Serving