
Figure 1 From Sef Net Speaker Embedding Free Target Speaker Extraction
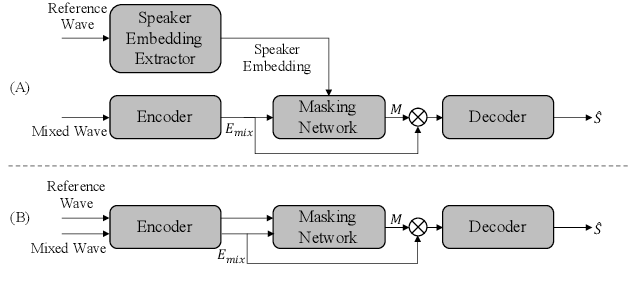
Figure 1 from SEF-Net: Speaker Embedding Free Target Speaker Extraction ...

Figure 1 from Target Speaker Extraction with Curriculum Learning ...

Figure 1 from Efficient Speaker Embedding Extraction Using a Twofold ...

Figure 1 from Target Speaker Extraction with Attention Enhancement and ...
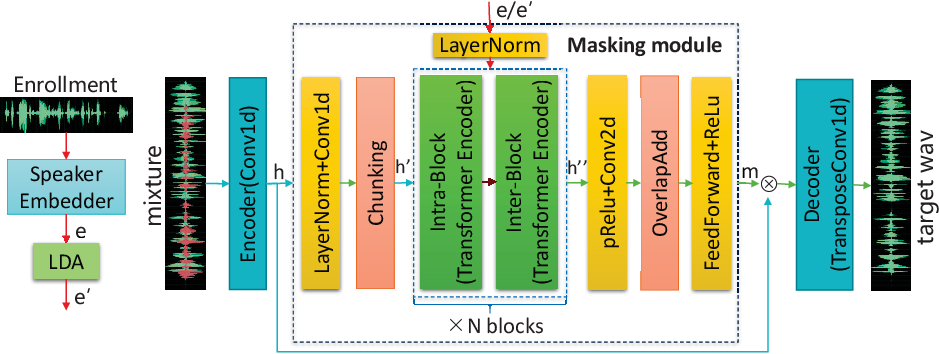
Figure 1 from Improving Target Speaker Extraction with Sparse LDA ...
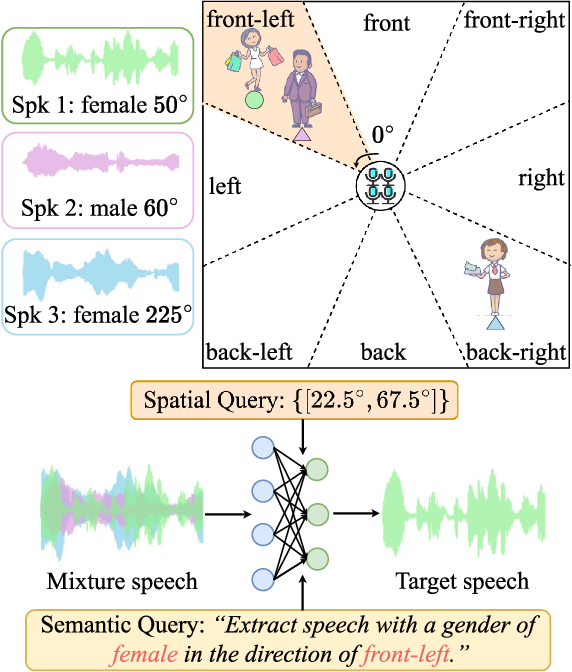
Figure 1 from SSDQ: Target Speaker Extraction via Semantic and Spatial ...

Figure 1 from Target Speaker Extraction for Multi-Talker Speaker ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...

Figure 1 from SMMA-Net: An Audio Clue-Based Target Speaker Extraction ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...
Advertisement Space (300x250)

Figure 1 from Speaker Embedding Extraction with Phonetic Information ...
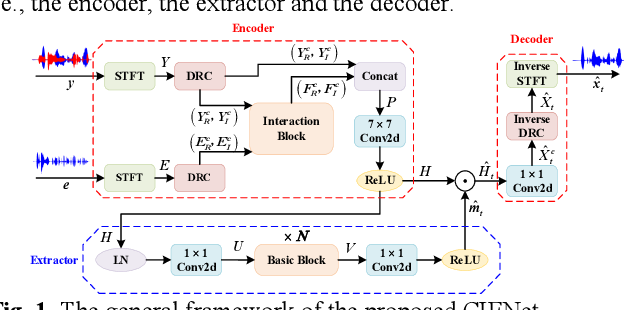
Figure 1 from Target Speaker Extraction by Directly Exploiting ...

Figure 1 from Audio-Visual Target Speaker Extraction with Reverse ...

Figure 1 from Speaker Embedding Extraction with Phonetic Information ...

Figure 1 from Single Channel Target Speaker Extraction Based on Deep ...

Figure 1 from Speaker Embedding Extraction with Phonetic Information ...

Figure 1 from Dual-Channel Target Speaker Extraction Based on ...
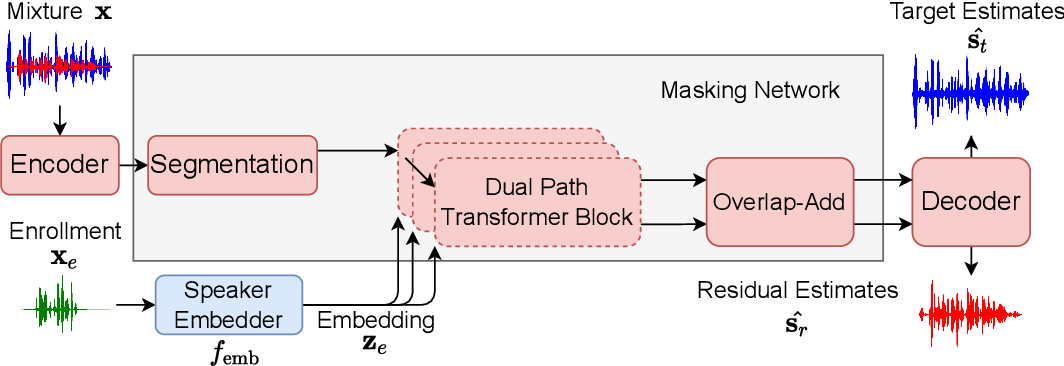
Figure 1 from Semi-supervised Time Domain Target Speaker Extraction ...

Figure 1 from Binaural Target Speaker Extraction using Individualized ...

Figure 1 from Speaker-Aware Target Speaker Enhancement by Jointly ...
Advertisement Space (336x280)

Figure 1 from Speaker-conditioning Single-channel Target Speaker ...
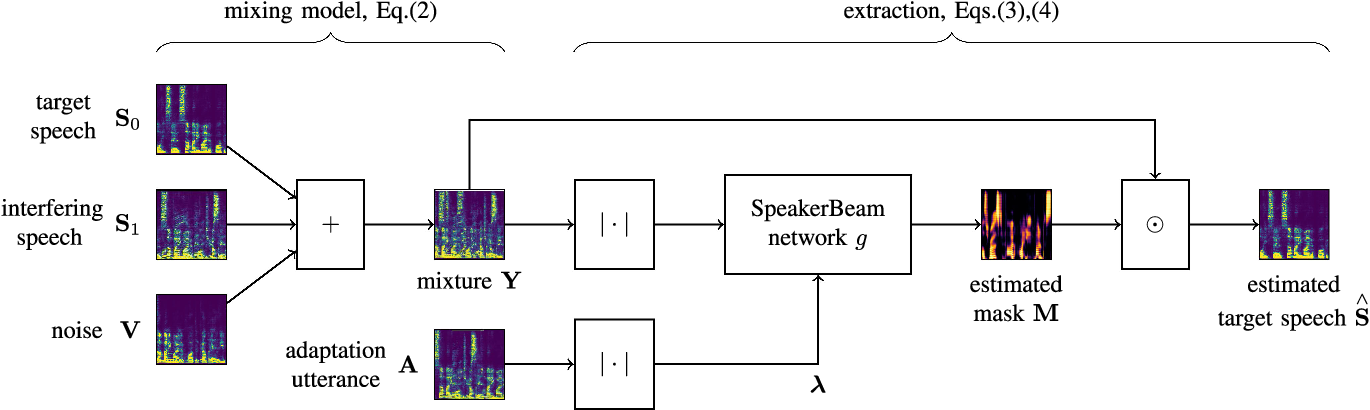
Figure 1 from SpeakerBeam: Speaker Aware Neural Network for Target ...
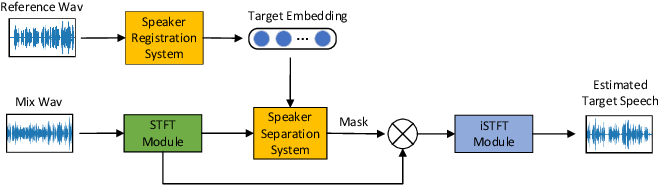
Figure 1 from A Target Speaker Separation Neural Network with Joint ...

Universal Speaker Embedding Free Target Speaker Extraction and Personal ...
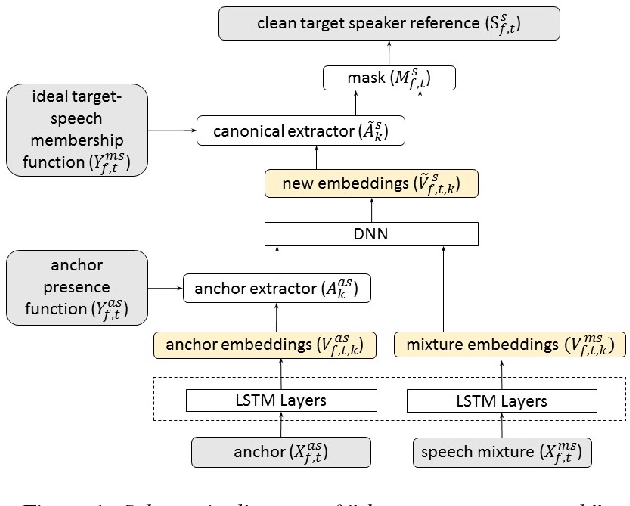
Figure 1 from Deep Extractor Network for Target Speaker Recovery From ...

Figure 1 from Low-complexity Multi-Channel Speaker Extraction with Pure ...

Figure 1 from Hierarchical Speaker Representation for Target Speaker ...

Figure 1 from Vision-Guided Speaker Embedding Based Speech Separation ...
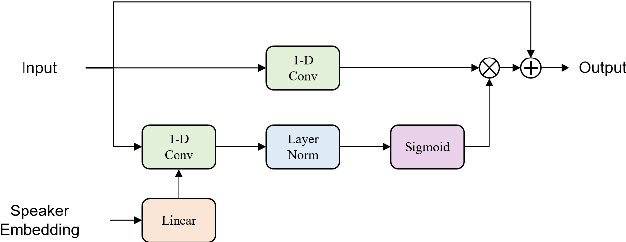
Figure 1 from Gated Convolutional Fusion for Time-Domain Target Speaker ...

[논문 리뷰] Universal Speaker Embedding Free Target Speaker Extraction and ...
Advertisement Space (336x280)

Figure 1 from Multi-Stage Speaker Extraction with Utterance and Frame ...

Figure 1 from Binaural Selective Attention Model for Target Speaker ...

Figure 1 from Gated Convolutional Fusion for Time-Domain Target Speaker ...

Figure 1 from Universal Speaker Extraction in the Presence and Absence ...
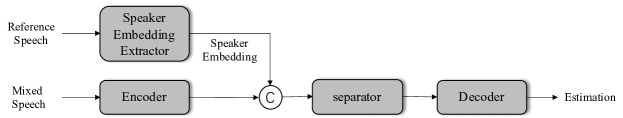
[2409.02615] USEF-TSE: Universal Speaker Embedding Free Target Speaker ...
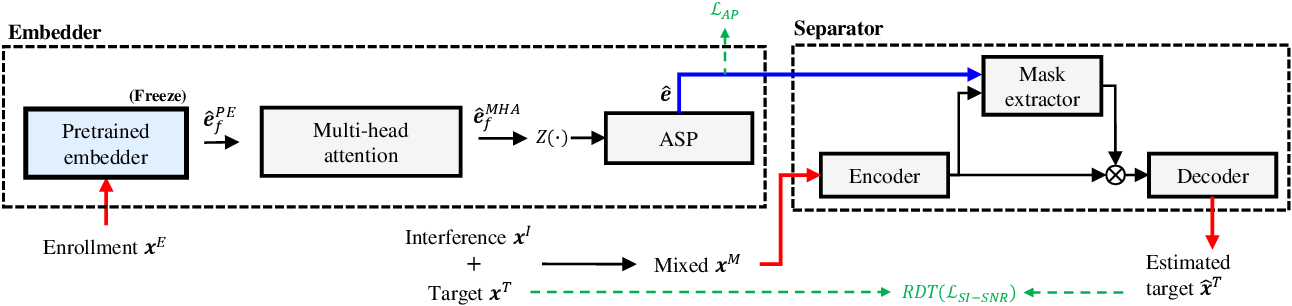
Figure 1 from Centroid Estimation with Transformer-Based Speaker ...