
Figure 1 From Temporally Efficient Vision Transformer For Video
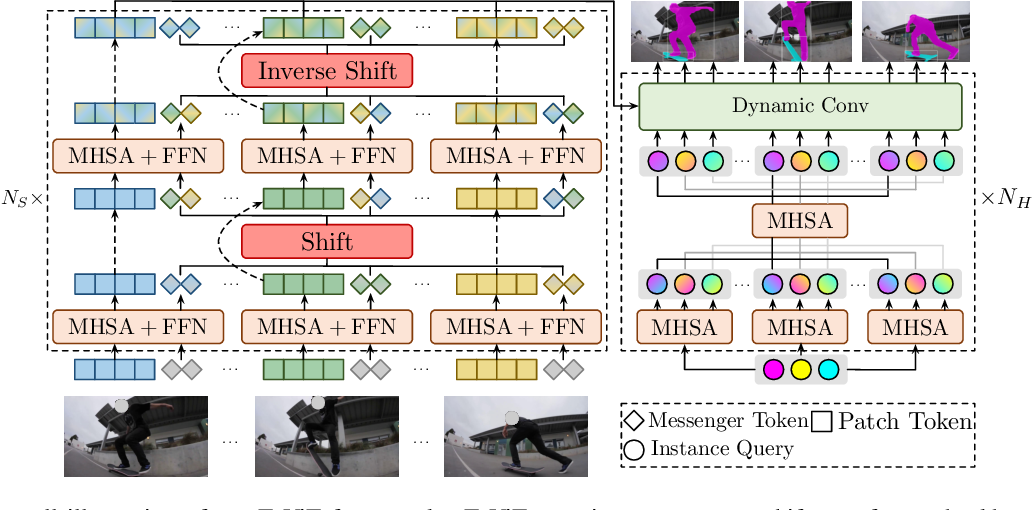
Figure 1 from Temporally Efficient Vision Transformer for Video ...
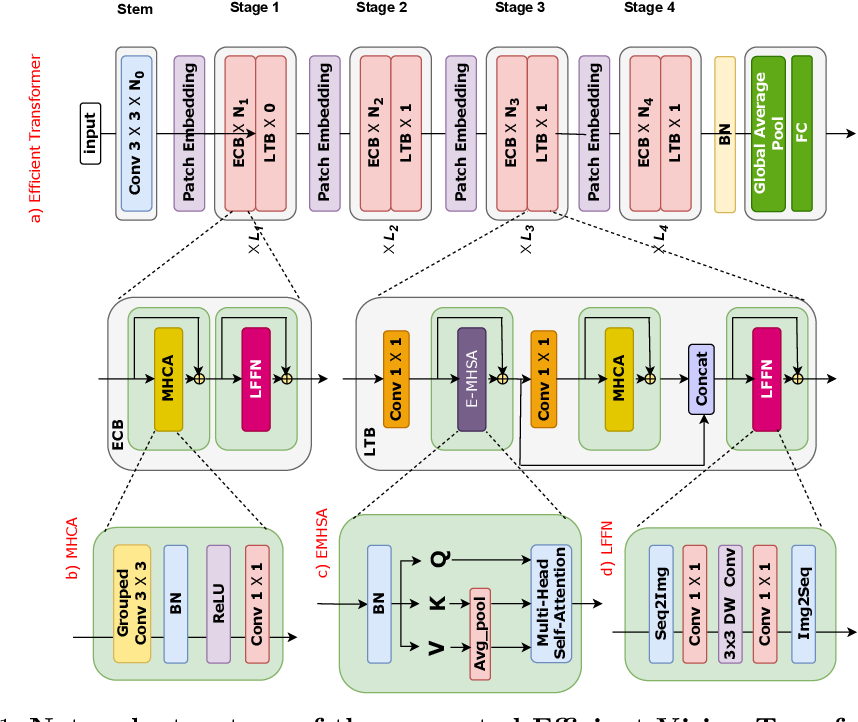
Figure 1 from Efficient Vision Transformer for Accurate Traffic Sign ...

Figure 1 from LS-VIT: Vision Transformer for action recognition based ...

(PDF) Temporally Efficient Vision Transformer for Video Instance ...
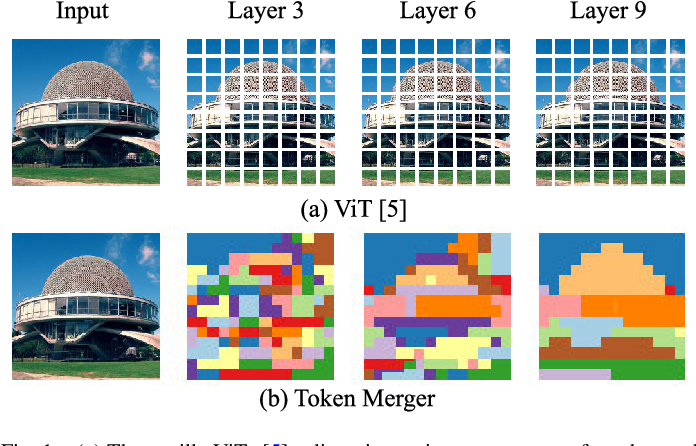
Figure 1 from Efficient Vision Transformer via Token Merger | Semantic ...

Figure 1 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 1 from Dynamic Spatial Sparsification for Efficient Vision ...
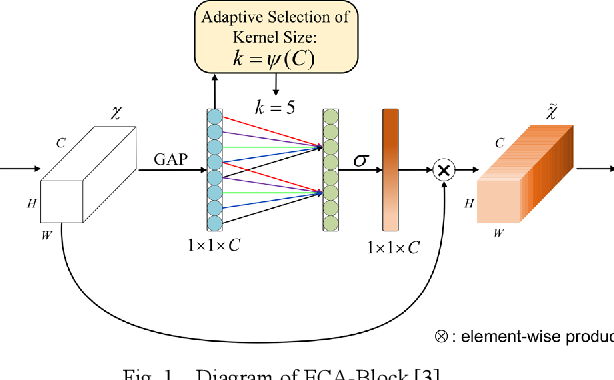
Figure 1 from Data & Channel Efficient Vision Transformer | Semantic ...

Figure 1 from Computationally-Efficient Vision Transformer for Medical ...

Temporally Efficient Vision Transformer for Video Instance Segmentation
Advertisement Space (300x250)
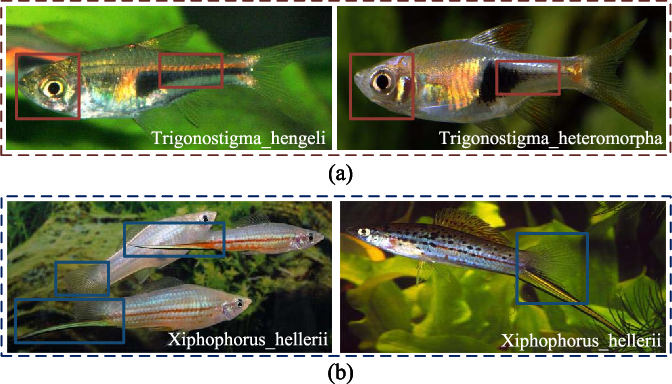
Figure 1 from Efficient Vision Transformer With Token-Selective and ...
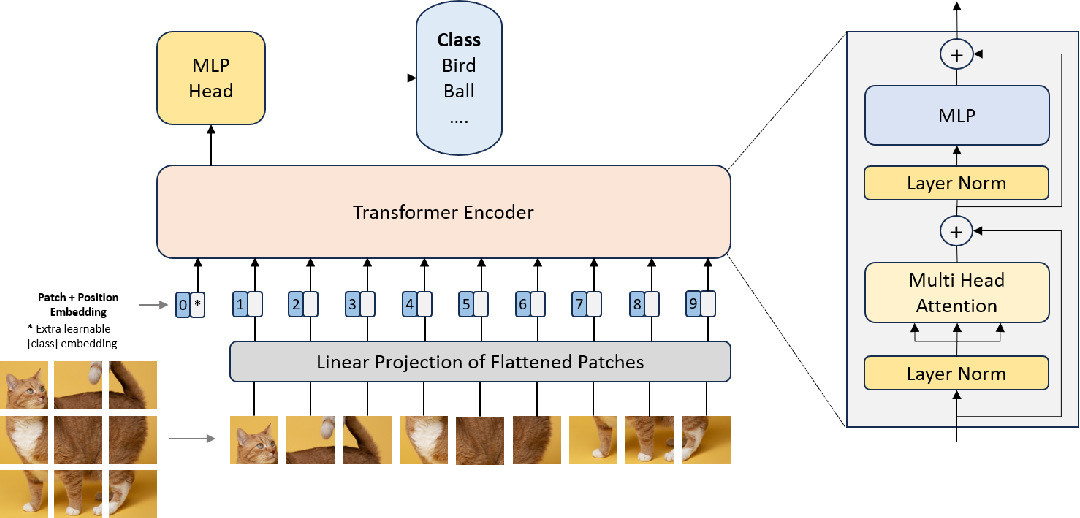
Figure 1 from Sparse then Prune: Toward Efficient Vision Transformers ...

Figure 1 from Predicting Token Impact Towards Efficient Vision ...

Figure 1 from A Lightweight Convolution and Vision Transformer ...
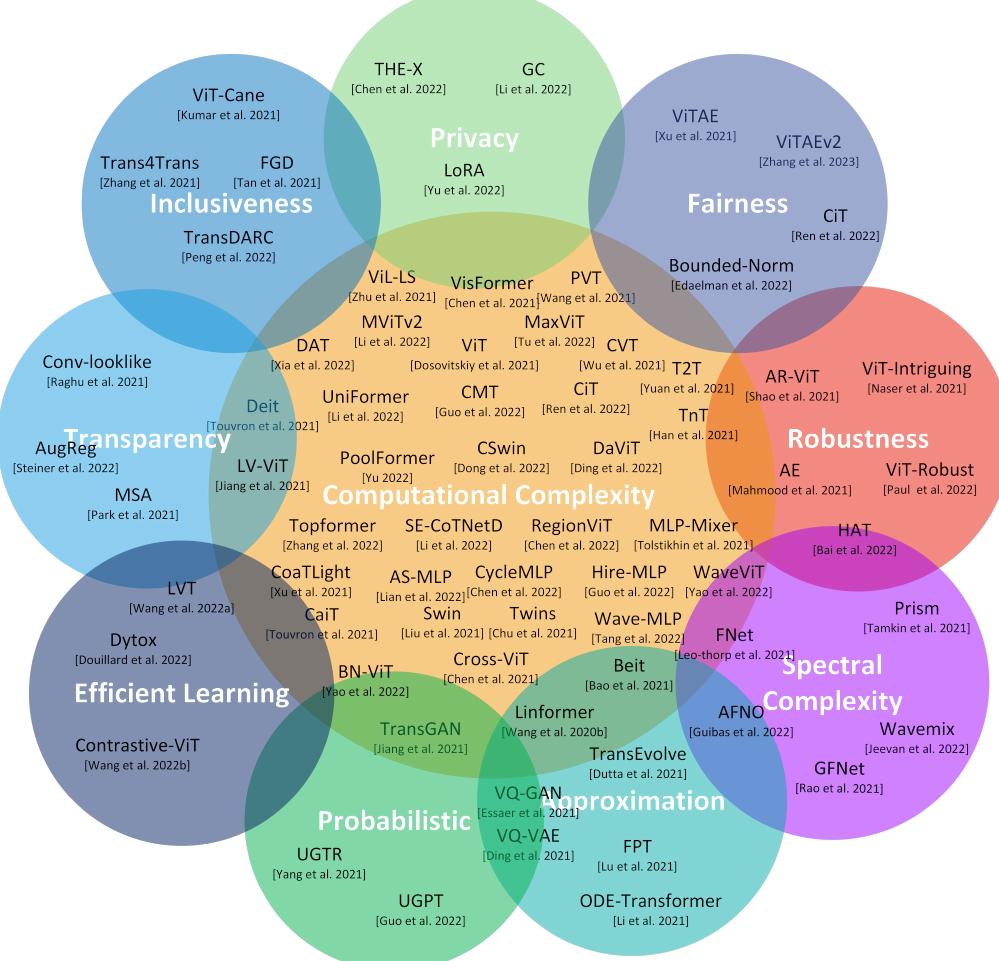
Figure 1 - from Efficiency 360: Efficient Vision

Figure 1 from Learning Efficient Vision Transformers via Fine-Grained ...

Figure 1 from A Survey on Efficient Vision Transformers: Algorithms ...

Figure 1 from Efficient Video Transformers via Spatial-temporal Token ...

Video-TransUNet: Temporally Blended Vision Transformer for CT VFSS ...

Figure 3 from Temporal Shift Module-Based Vision Transformer Network ...
Advertisement Space (336x280)

Figure 1 from Low-Bit Integerization of Vision Transformers Using ...

Vision Transformer with Cross-attention by Temporal Shift for Efficient ...

Figure 1 from Vision Transformers are Parameter-Efficient Audio-Visual ...

Temporal Object-Aware Vision Transformer for Few-Shot Video Object ...

Efficient Vision Transformer YOLOv5 for Accurate and Fast Traffic Sign ...

Figure 1 from Spectral–Spatial–Temporal Transformers for Hyperspectral ...

(PDF) Efficient Vision Transformer YOLOv5 for Accurate and Fast Traffic ...

Optimal Topology of Vision Transformer for Real-Time Video Action ...

Figure 1 from End-to-End Video Object Detection with Spatial-Temporal ...
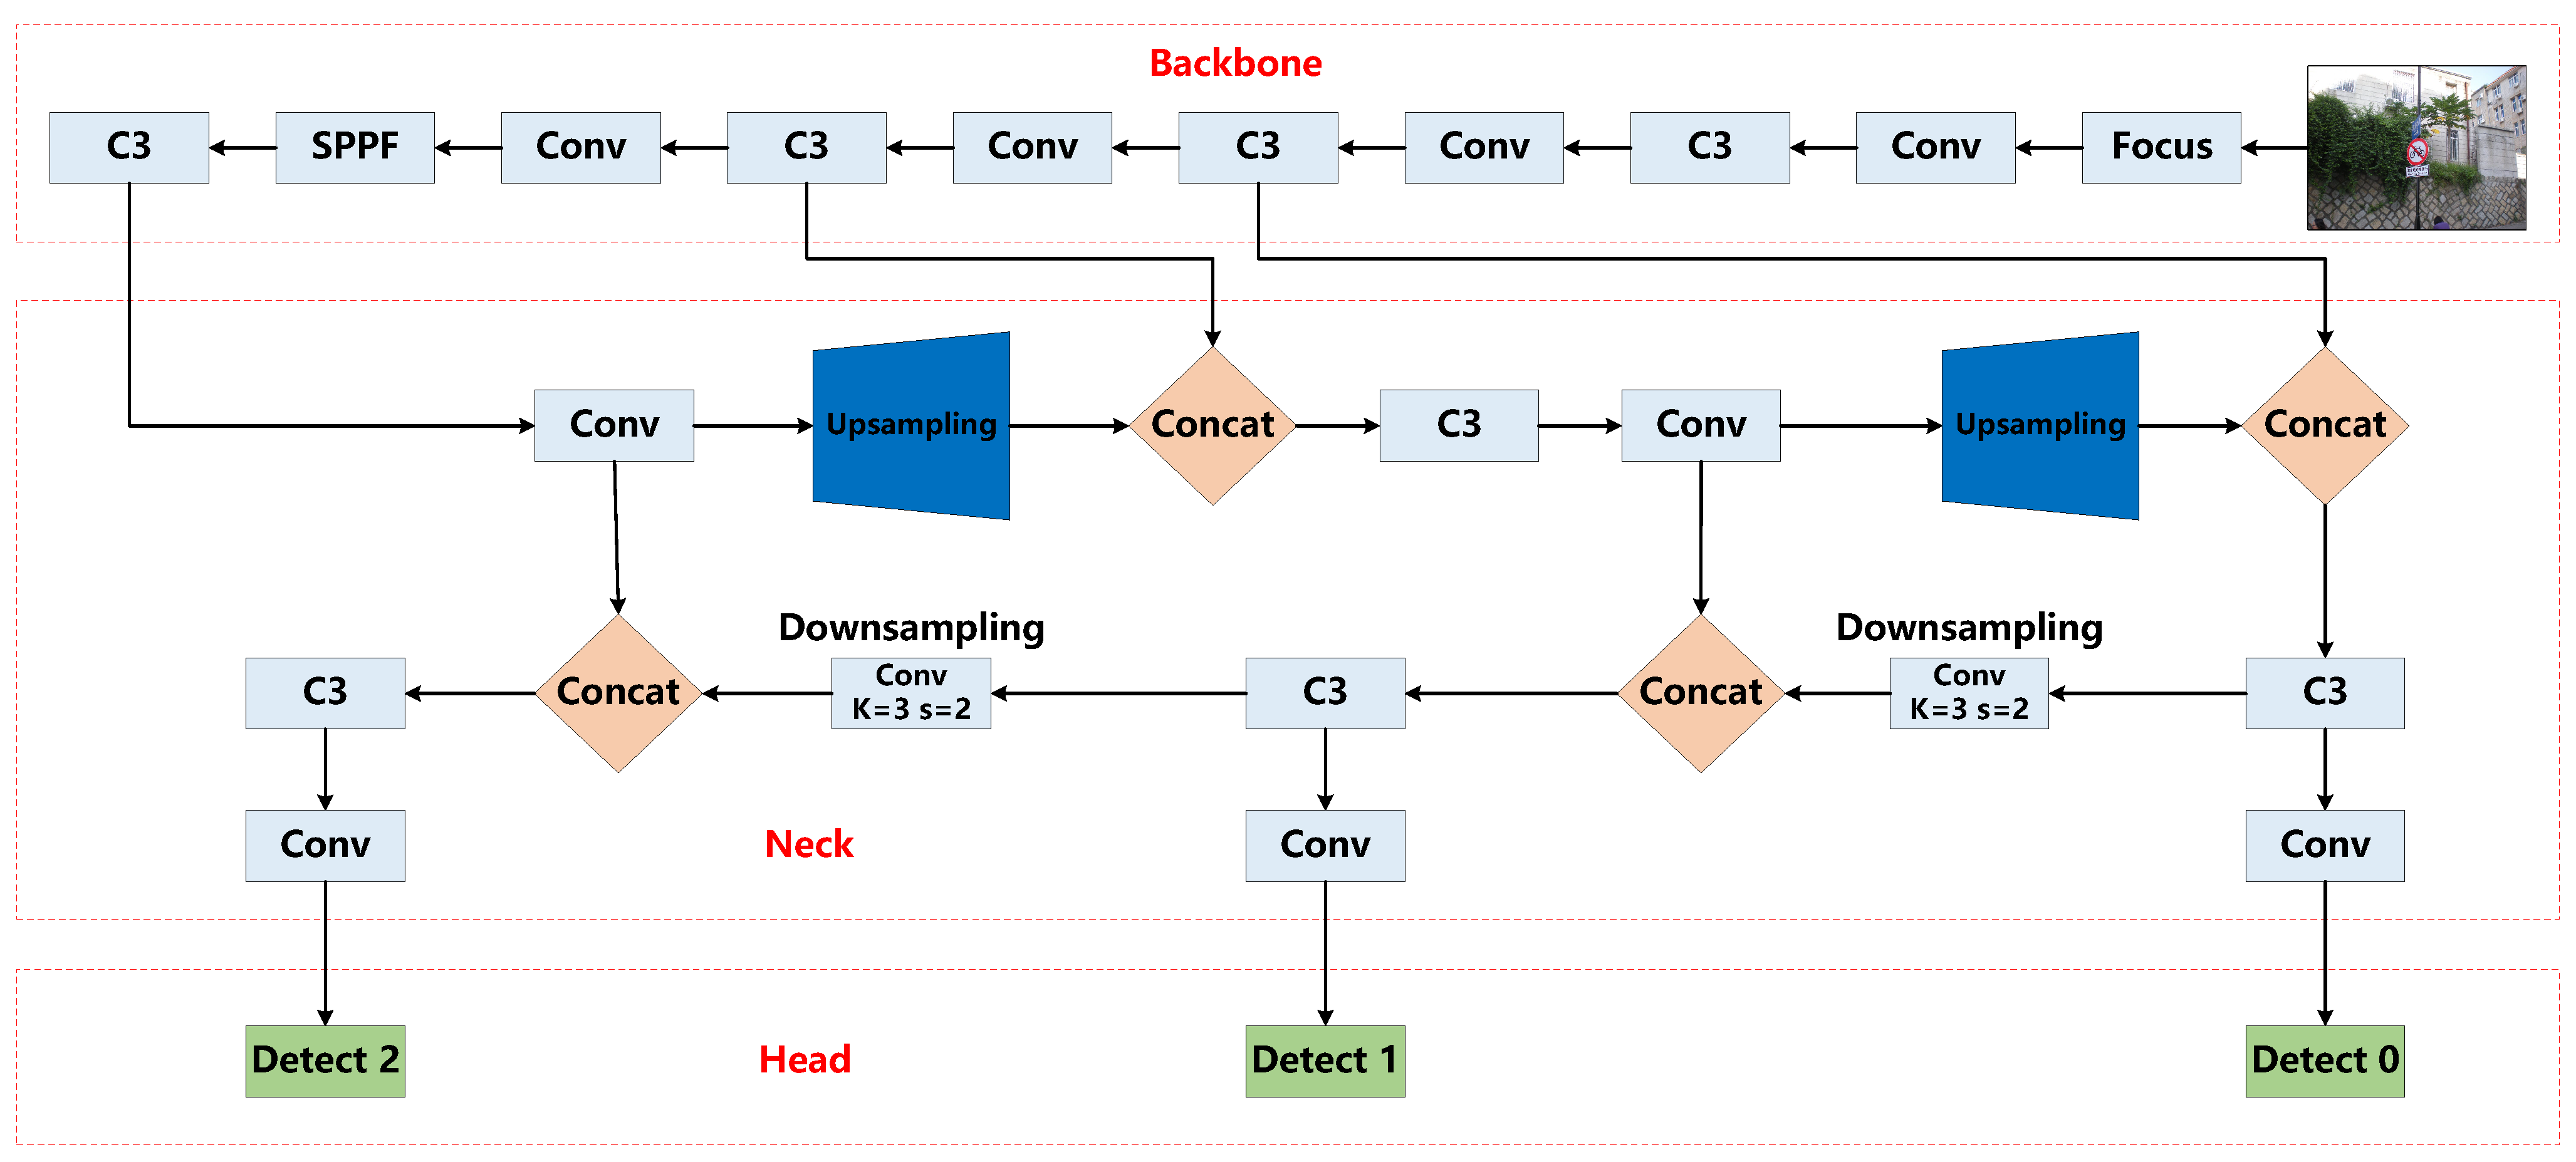
Efficient Vision Transformer YOLOv5 for Accurate and Fast Traffic Sign ...
Advertisement Space (336x280)

(PDF) Temporal Attention-based Vision Transformer for Source-Free Video ...
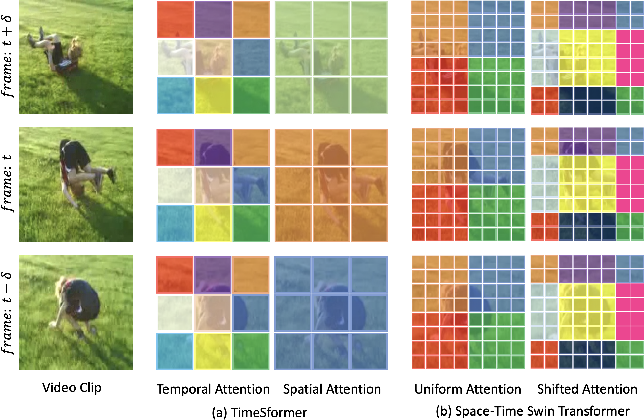
Figure 1 from Long-Short Temporal Contrastive Learning of Video ...

Figure 1 from CST-ViT: Cascaded Spatio–Temporal Redundancy Elimination ...

Figure 1 from Eventful Transformers: Leveraging Temporal Redundancy in ...
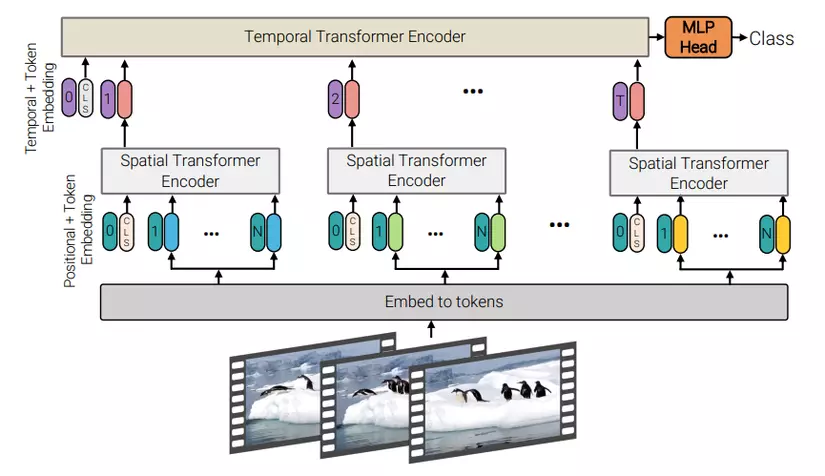
Paper reading | ViViT: A Video Vision Transformer

Overview of the Vision Transformer architecture (Adapted from [12 ...