
Figure 1 From Distilling Efficient Vision Transformers From Cnns For

Figure 1 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 6 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 10 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 5 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 11 from Distilling Efficient Vision Transformers from CNNs for ...

Figure 1 from Distilling Self-Supervised Vision Transformers for Weakly ...
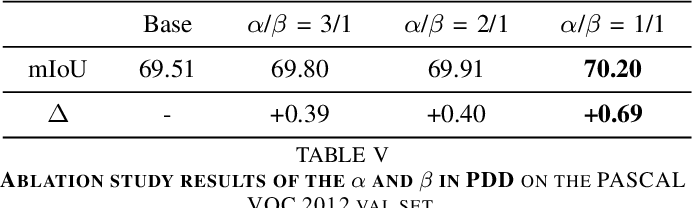
Table V from Distilling Efficient Vision Transformers from CNNs for ...

Table I from Distilling Efficient Vision Transformers from CNNs for ...

Table VI from Distilling Efficient Vision Transformers from CNNs for ...

Table VII from Distilling Efficient Vision Transformers from CNNs for ...
Advertisement Space (300x250)

Figure 1 from Distilling Stereo Networks for Performant and Efficient ...
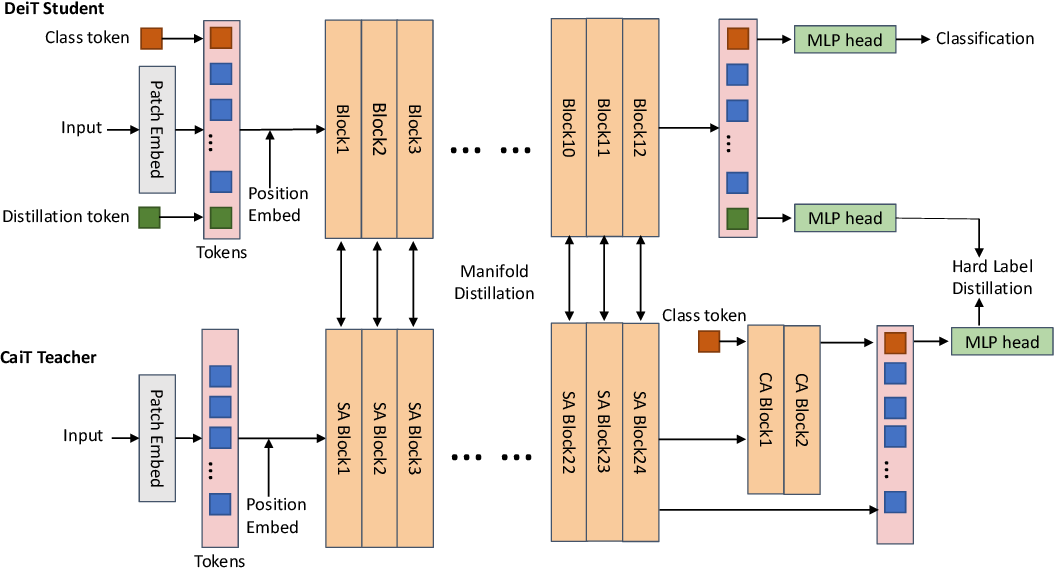
Figure 1 from Efficient Vision Transformers via Fine-Grained Manifold ...
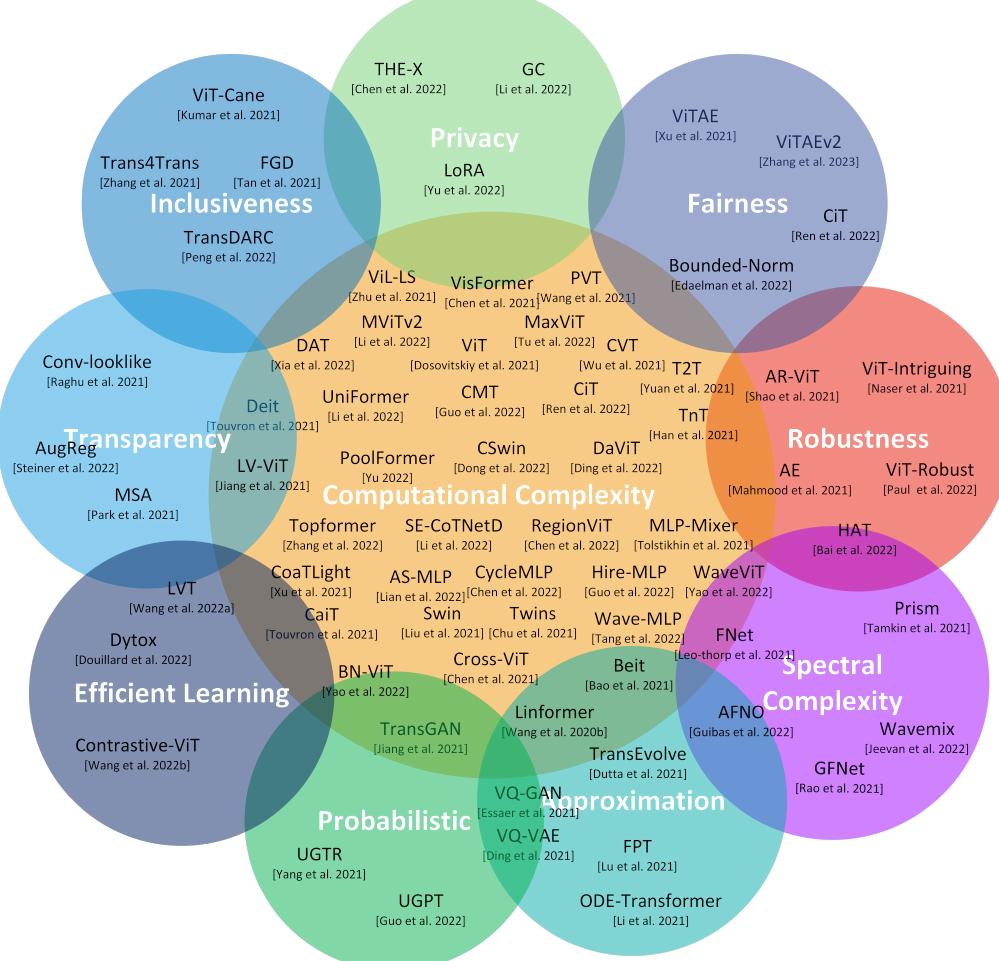
Figure 1 - from Efficiency 360: Efficient Vision

Figure 1 from Low-Bit Integerization of Vision Transformers Using ...
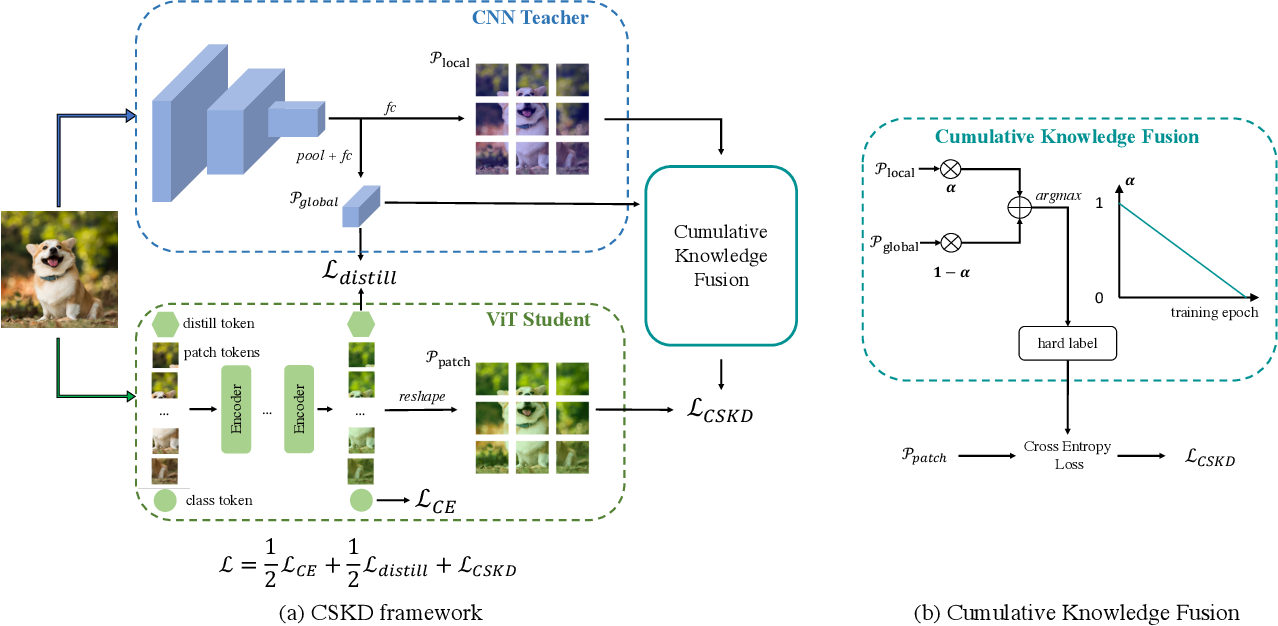
Figure 1 from Cumulative Spatial Knowledge Distillation for Vision ...

Figure 1 from VER: Vision Expert Transformer for Robot Learning via ...

Figure 1 from The Role of Masking for Efficient Supervised Knowledge ...

Figure 2 from Learning Efficient Vision Transformers via Fine-Grained ...

Figure 1 from Orion-Lite: Distilling LLM Reasoning into Efficient ...
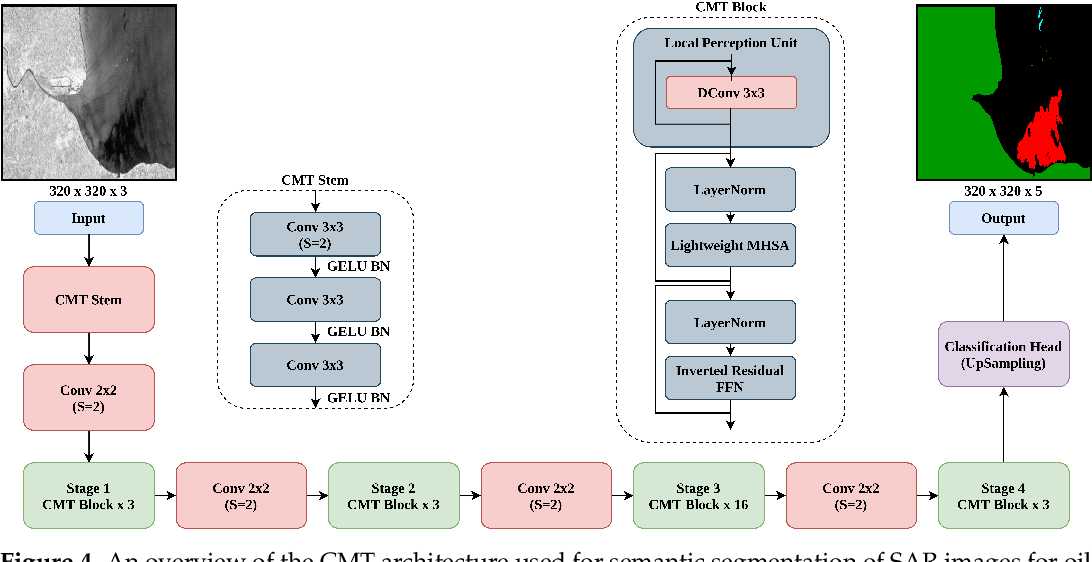
Figure 4 from Comparison of CNNs and Vision Transformers-Based Hybrid ...
Advertisement Space (336x280)
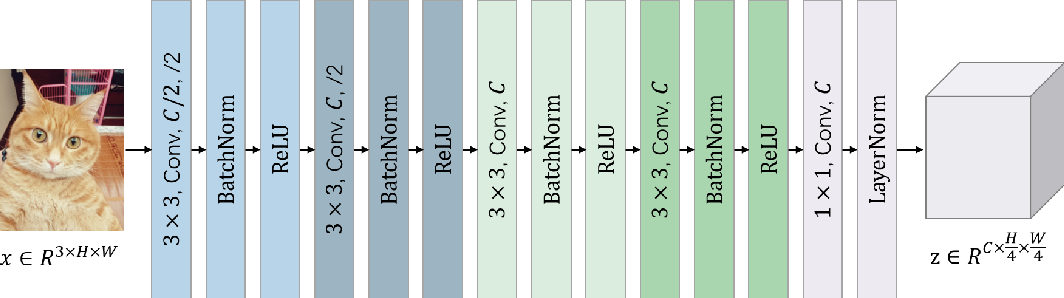
Figure I from Orthogonal Transformer: An Efficient Vision Transformer ...

Figure 1 from MVKD-Trans: A Multi-View Knowledge Distillation Vision ...

Figure 1 from ViTKD: Practical Guidelines for ViT feature knowledge ...

Figure 1 from MVKD-Trans: A Multi-View Knowledge Distillation Vision ...
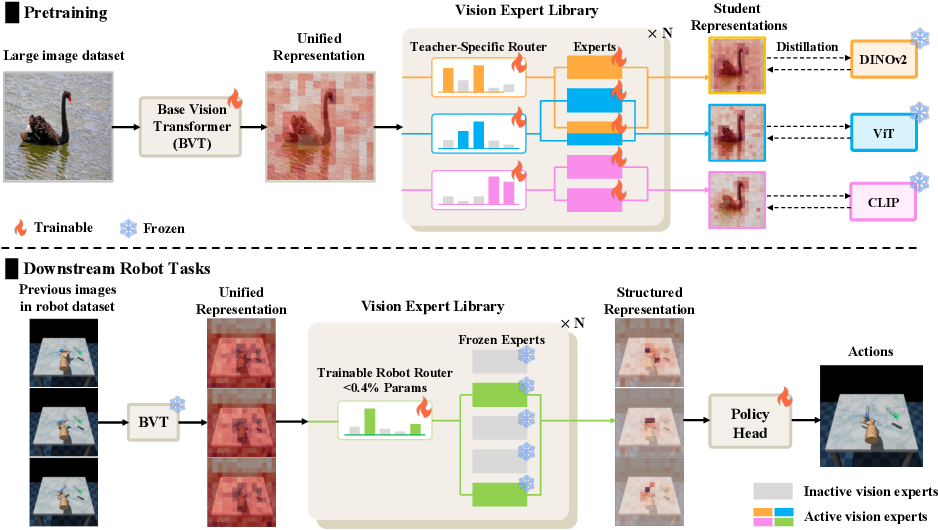
Figure 2 from VER: Vision Expert Transformer for Robot Learning via ...

Figure 1 from A Lightweight Convolution and Vision Transformer ...

Figure 1 from Attention Distillation: self-supervised vision ...
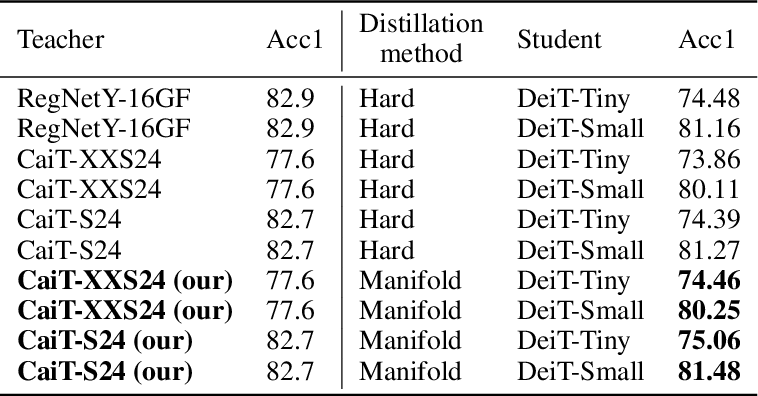
Table 2 from Efficient Vision Transformers via Fine-Grained Manifold ...
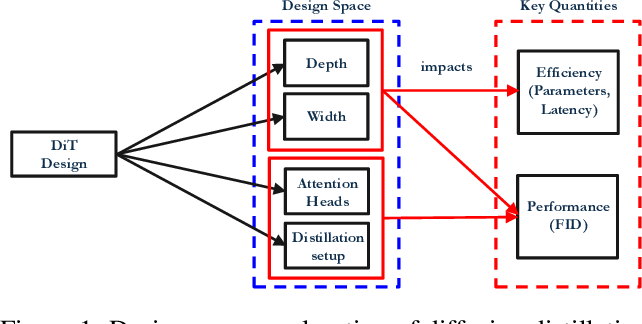
Figure 1 from Designing Parameter and Compute Efficient Diffusion ...
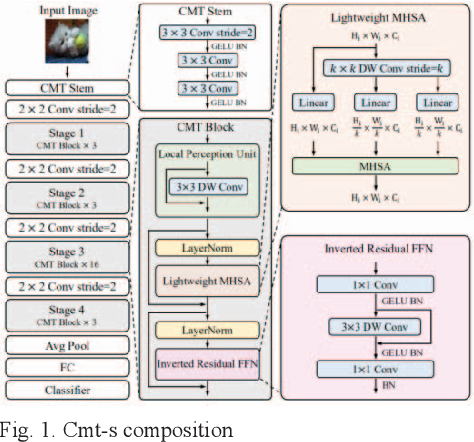
Figure 1 from The combination of transformer and CNN in computer vision ...
Advertisement Space (336x280)
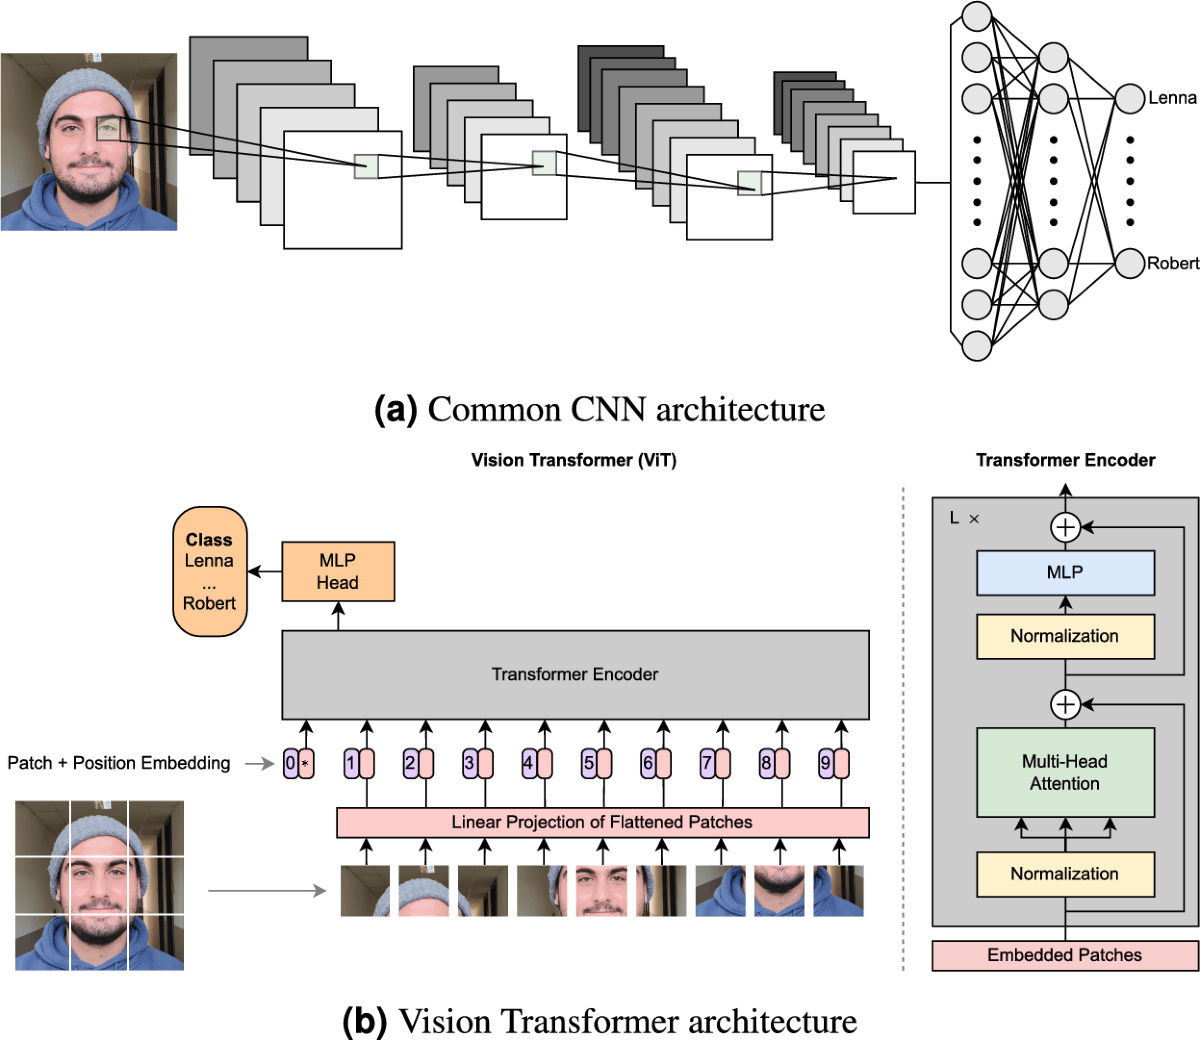
The Rise of Smart Video Processing - From CNNs to Transformers - Djoupe ...

Distilling Multilingual Transformers into CNNs for Scalable Intent ...

Figure 2 from MVKD-Trans: A Multi-View Knowledge Distillation Vision ...

Figure 11 from Convolutional Neural Network (CNN) vs Vision Transformer ...

(PDF) DiffRate : Differentiable Compression Rate for Efficient Vision ...

(PDF) Vision Transformer for Efficient Chest X-ray and Gastrointestinal ...