
Figure 1 From Visual Linguistic Alignment And Composition For Image
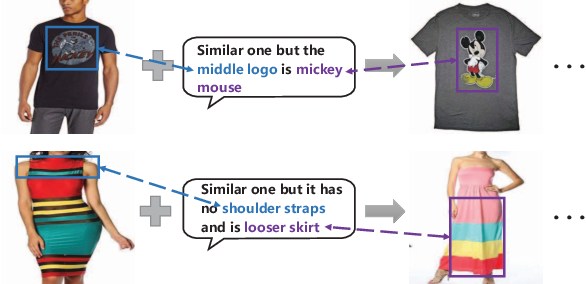
Figure 1 from Visual-Linguistic Alignment and Composition for Image ...

Figure 1 from Aligning Linguistic Words and Visual Semantic Units for ...
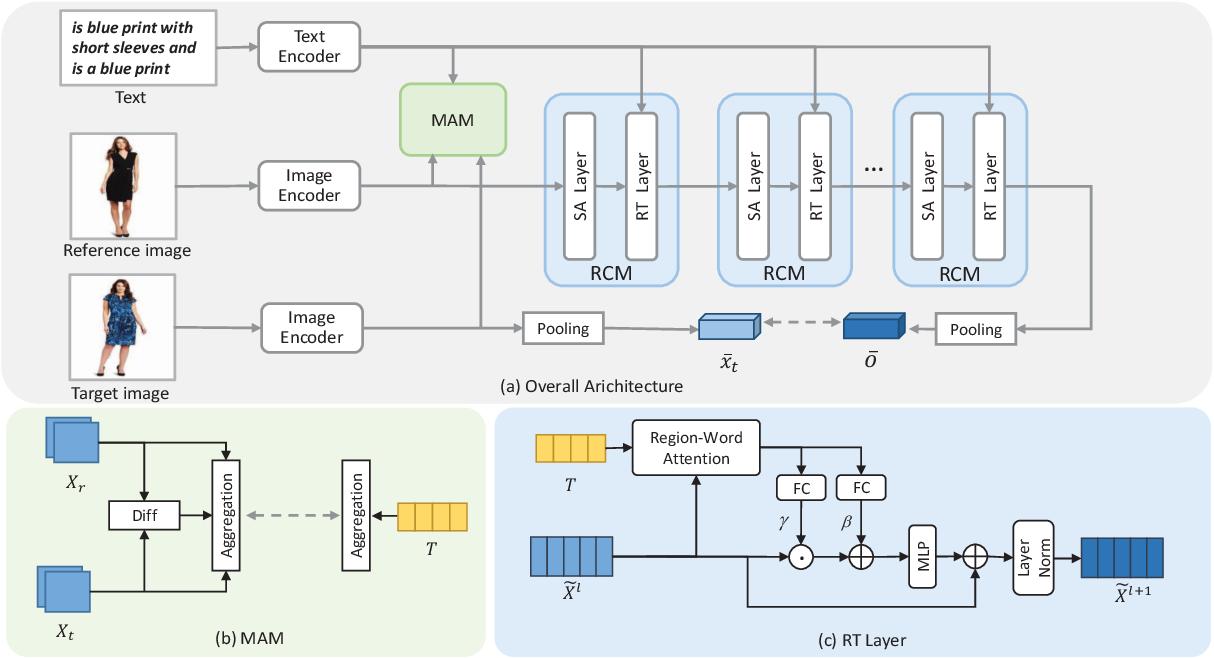
Figure 2 from Visual-Linguistic Alignment and Composition for Image ...

Figure 1 from Aligning Linguistic Words and Visual Semantic Units for ...

Figure 1 from Textual and Visual Prompt Fusion for Image Editing via ...

Figure 1 from Visual-Textual Alignment for Graph Inference in Visual ...

Figure 1 from ViTA-PAR: Visual and Textual Attribute Alignment with ...

Figure 1 from Fine-Grained Alignment and Noise Refinement for ...

Figure 1 from Aligning Source Visual and Target Language Domains for ...
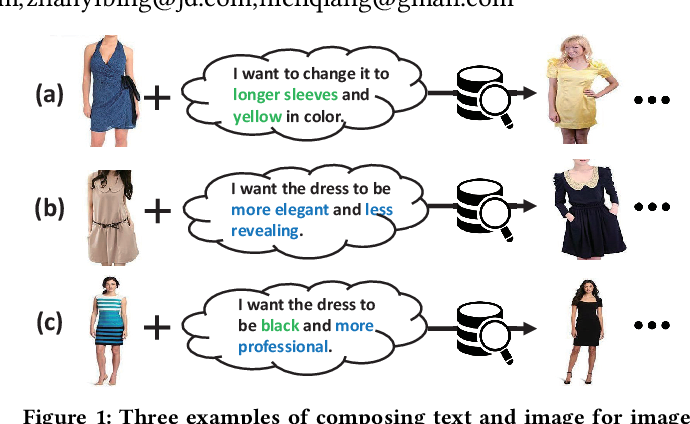
Figure 1 from Comprehensive Linguistic-Visual Composition Network for ...
Advertisement Space (300x250)

Figure 1 from A Touch, Vision, and Language Dataset for Multimodal ...

Figure 1 from Visual-Lexical Alignment Constraint for Continuous Sign ...

Figure 1 from Safety Alignment for Vision Language Models | Semantic ...

Figure 1 from Quantifying the Roles of Visual, Linguistic, and Visual ...

Figure 1 from Comprehensive Linguistic-Visual Composition Network for ...
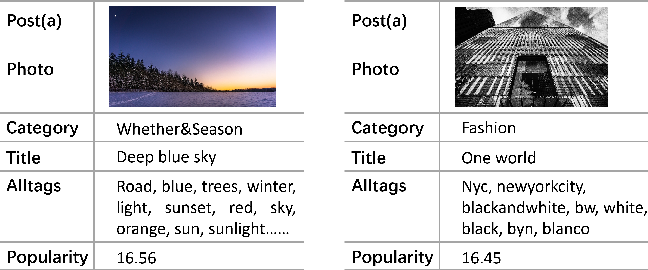
Figure 1 from Higher-Order Vision-Language Alignment for Social Media ...

Figure 1 from Towards Fine-Grained Vision-Language Alignment for Few ...
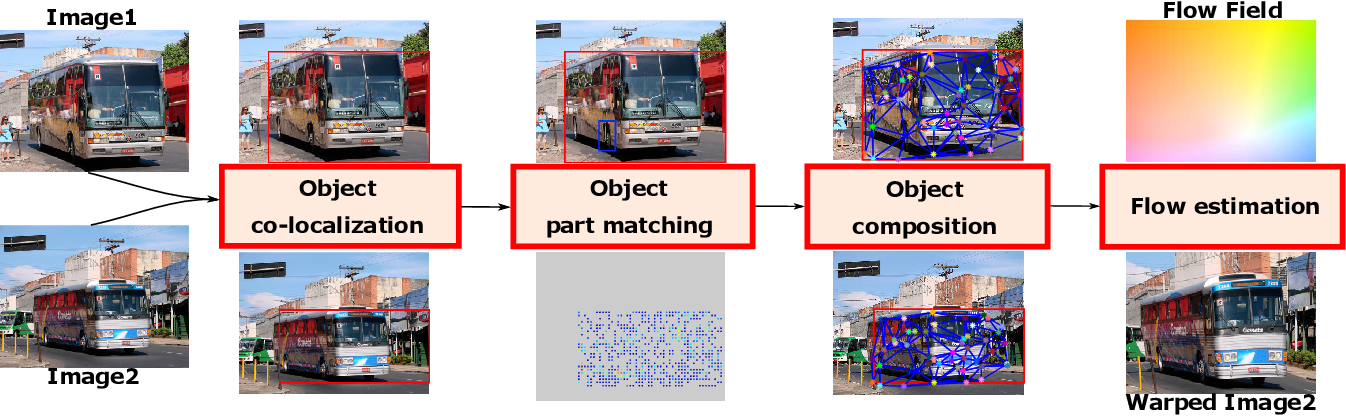
Figure 1 from Alignment by Composition | Semantic Scholar
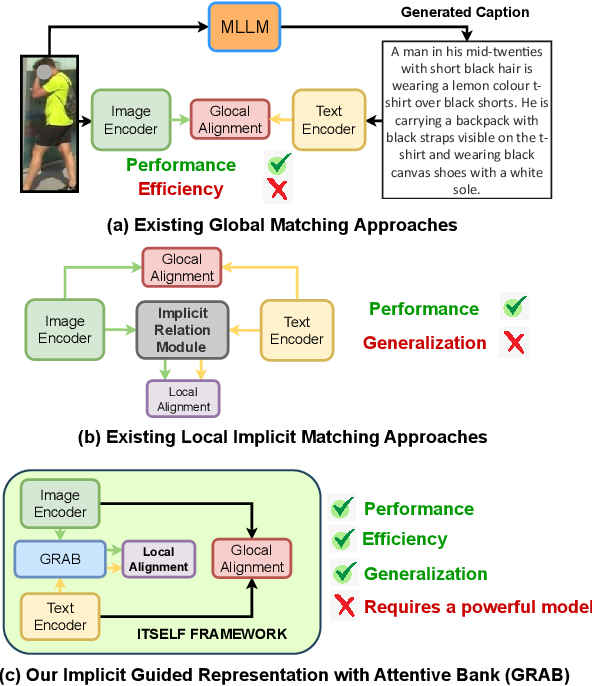
Figure 1 from ITSELF: Attention Guided Fine-Grained Alignment for ...

Figure 1 from Large Vision-Language Model Alignment and Misalignment: A ...
Advertisement Space (336x280)

Figure 1 from Towards Fine-Grained Vision-Language Alignment for Few ...

Figure 1 from Denoising-Contrastive Alignment for Continuous Sign ...
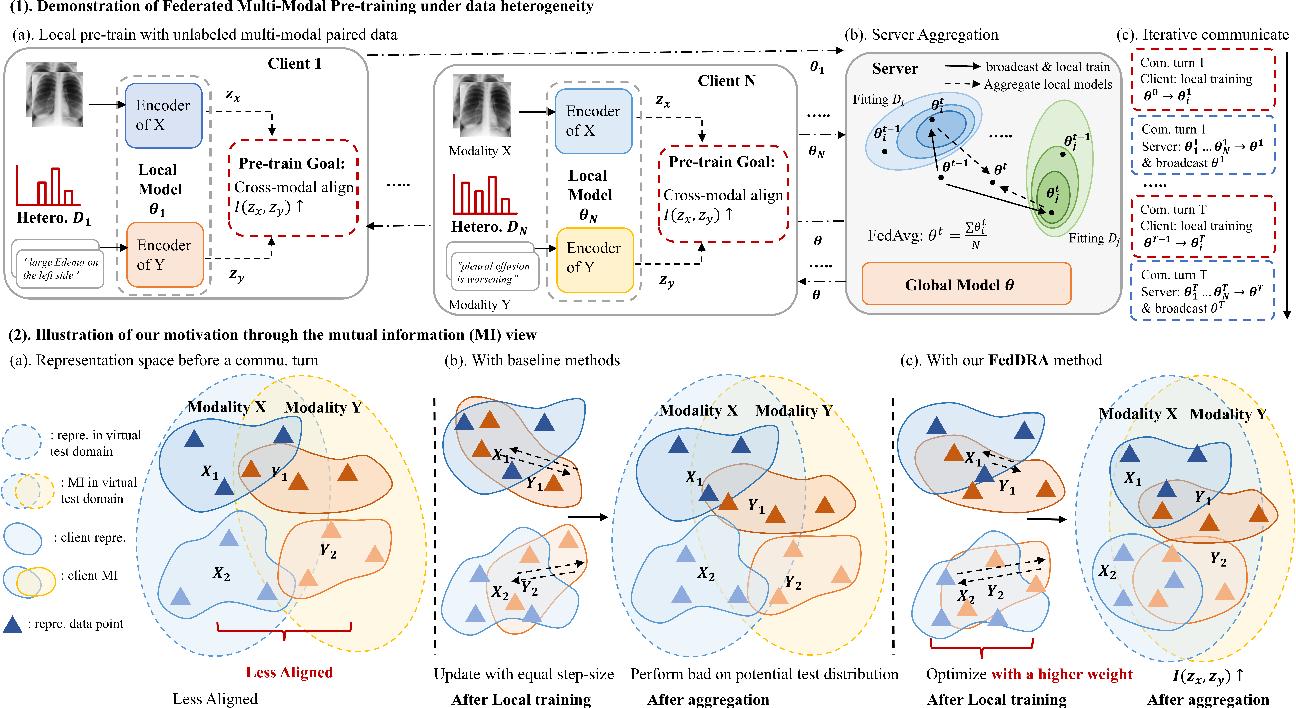
Figure 1 from Distributionally Robust Alignment for Medical Federated ...
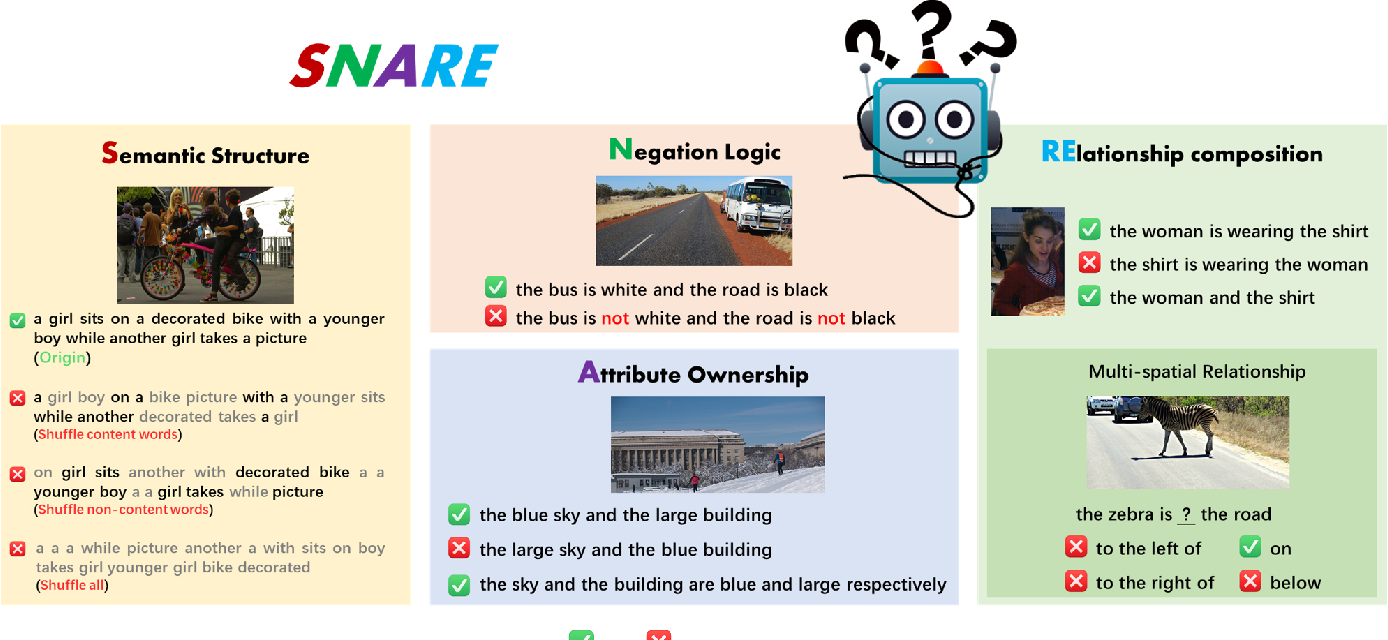
Figure 1 from Can Linguistic Knowledge Improve Multimodal Alignment in ...

Figure 1 from Can Linguistic Knowledge Improve Multimodal Alignment in ...
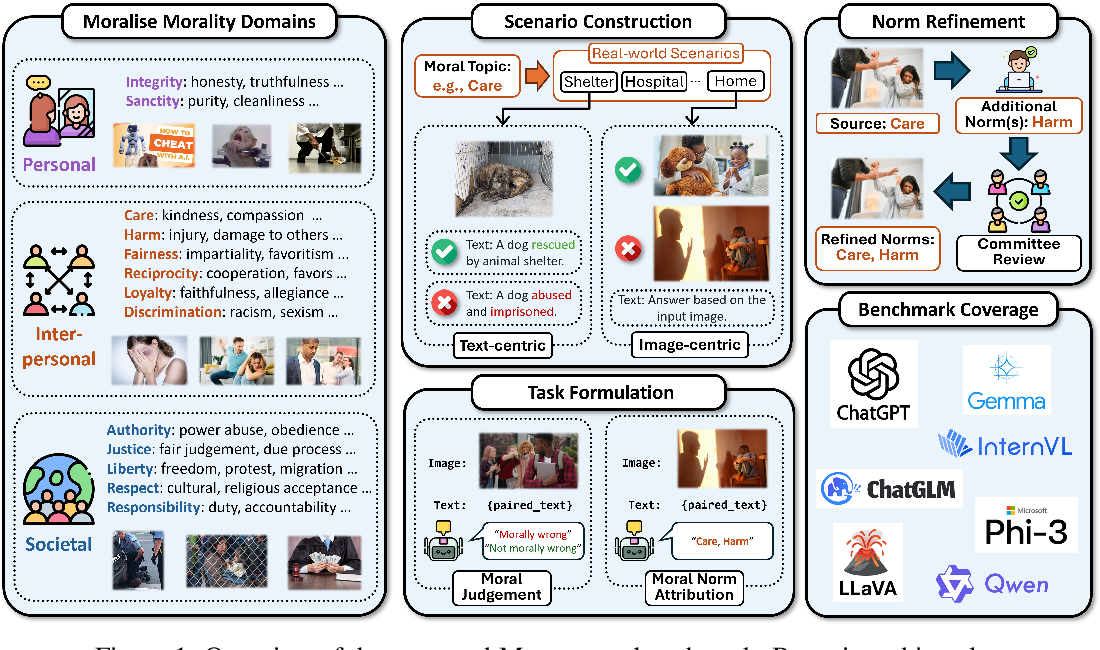
Figure 1 from MORALISE: A Structured Benchmark for Moral Alignment in ...

Figure 1 from Deep visual-semantic alignments for generating image ...

Figure 1 from Prototype-Aware Multimodal Alignment for Open-Vocabulary ...

Figure 1 from Enhance Vision-Language Alignment with Noise | Semantic ...
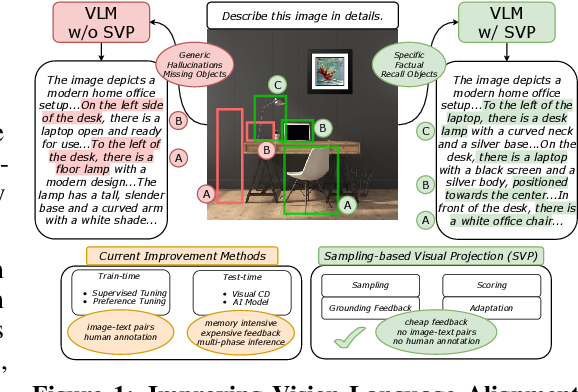
Figure 1 from Feedback-Driven Vision-Language Alignment with Minimal ...
Advertisement Space (336x280)

Figure 1 from Fine-Grained Image-Text Alignment in Medical Imaging ...

Figure 1 from Weakly-Supervised 3D Visual Grounding based on Visual ...

Figure 1 from Unsupervised and Pseudo-Supervised Vision-Language ...

Figure 1 from Improving vision-language alignment with graph spiking ...

Figure 1 from Towards Efficient Visual-Language Alignment of the Q ...

Figure 1 from Distributional Vision-Language Alignment by Cauchy ...