
Figure 1 From Voice Conversion Using Sequence To Sequence Learning Of
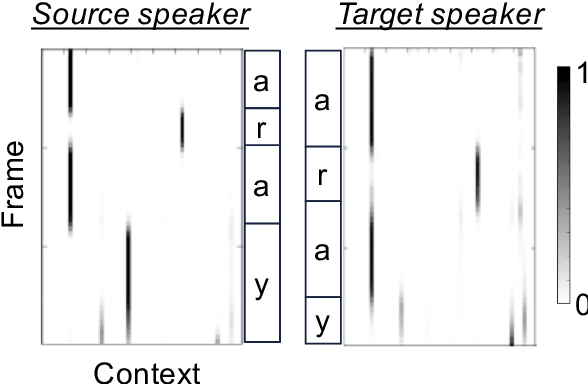
Figure 1 from Voice Conversion Using Sequence-to-Sequence Learning of ...

Figure 2 from Voice Conversion Using Sequence-to-Sequence Learning of ...
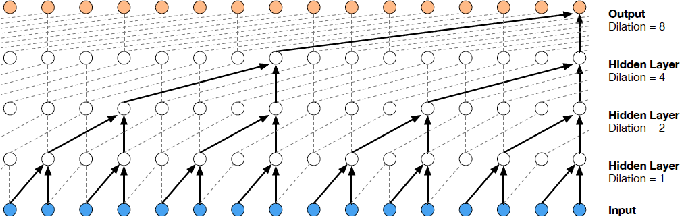
Figure 1 from A Survey on Voice Conversion using Deep Learning ...

Figure 1 from Sequence-To-Sequence Voice Conversion using F0 and Time ...

Figure 1 from Any-to-One Sequence-to-Sequence Voice Conversion Using ...

Figure 1 from Whisper to Normal Speech Conversion Using Sequence-to ...

Figure 1 from An overview of voice conversion systems | Semantic Scholar
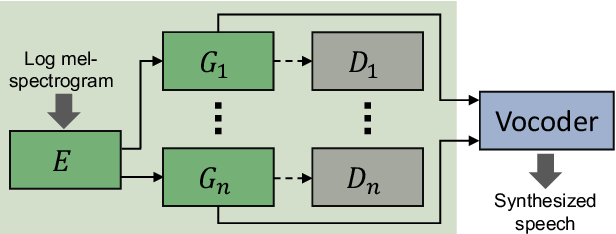
Figure 1 from Voice Conversion Using Speech-to-Speech Neuro-Style ...
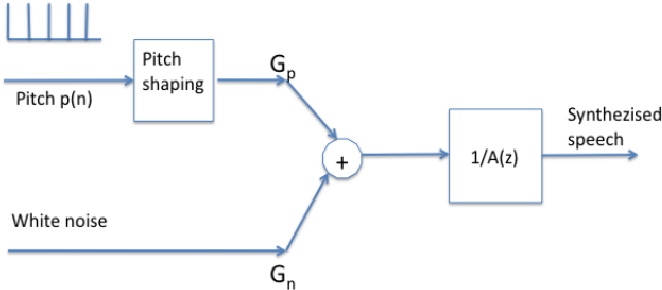
Figure 2.1 from Voice Conversion using Deep Learning | Semantic Scholar

Figure 1 from DRVC: A Framework of Any-to-Any Voice Conversion with ...
Advertisement Space (300x250)

Figure 1 from Sequence-to-Sequence Learning Based Conversion of Pseudo ...
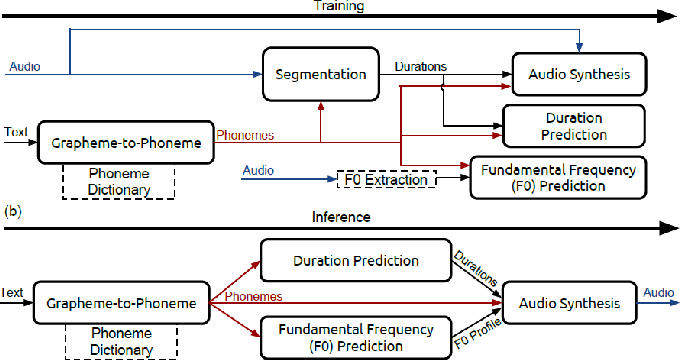
Figure 3 from A Survey on Voice Conversion using Deep Learning ...

Figure 1 from ACE-VC: Adaptive and Controllable Voice Conversion Using ...
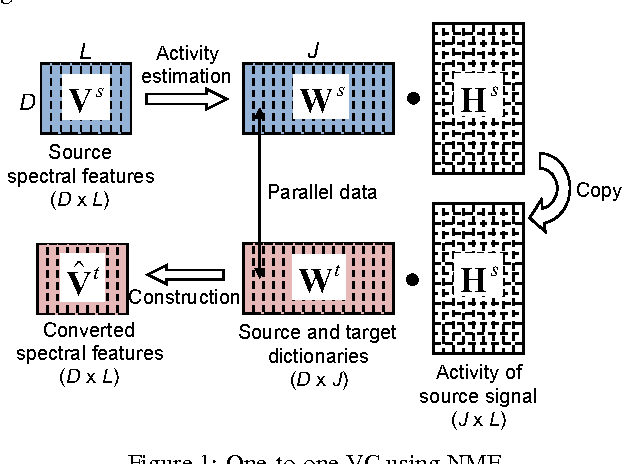
Figure 1 from Many-to-one voice conversion using exemplar-based sparse ...

Figure 1 from Reverberation-Controllable Voice Conversion Using ...

Figure 1 from Non-Parallel Sequence-to-Sequence Voice Conversion With ...

Figure 1 from Non-Autoregressive Sequence-To-Sequence Voice Conversion ...
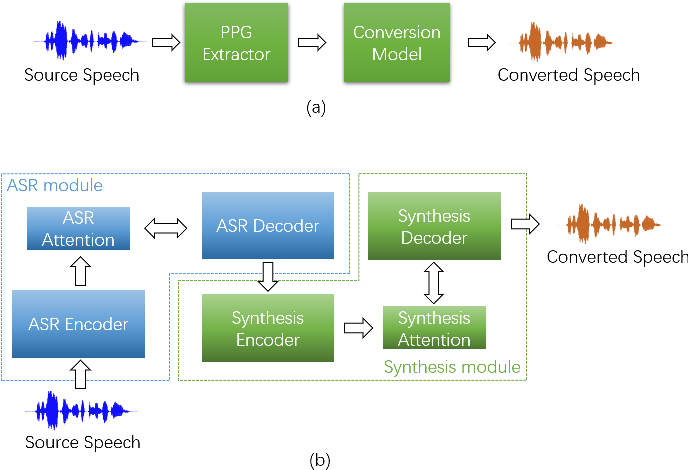
Figure 1 from Any-to-Many Voice Conversion With Location-Relative ...

Figure 1 from ATTS2S-VC: Sequence-to-sequence Voice Conversion with ...

Figure 1 from Improving Sequence-to-sequence Voice Conversion by Adding ...
Advertisement Space (336x280)
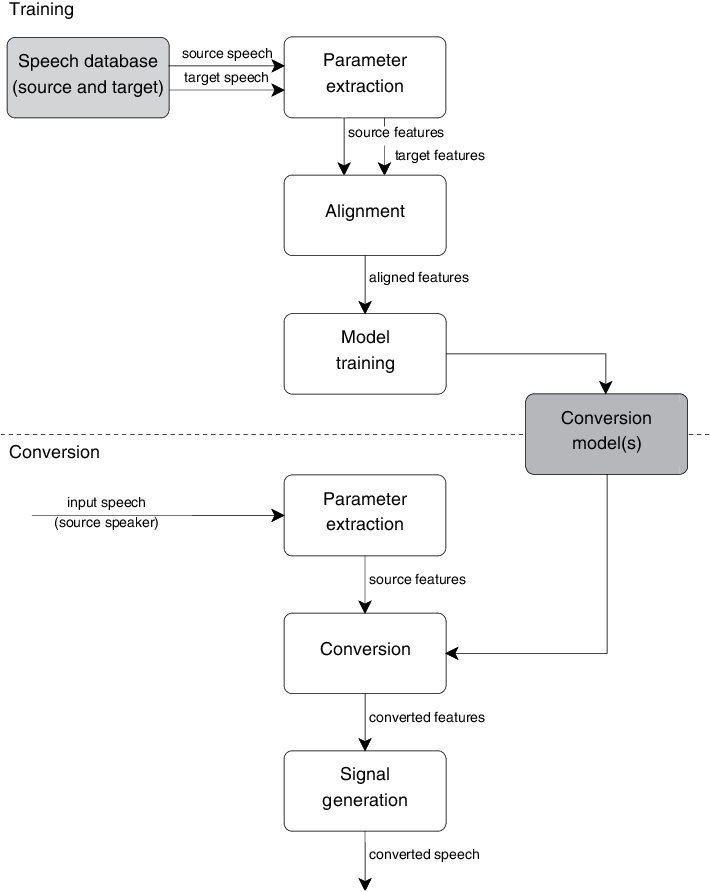
Figure 1 from Voice conversion | Semantic Scholar
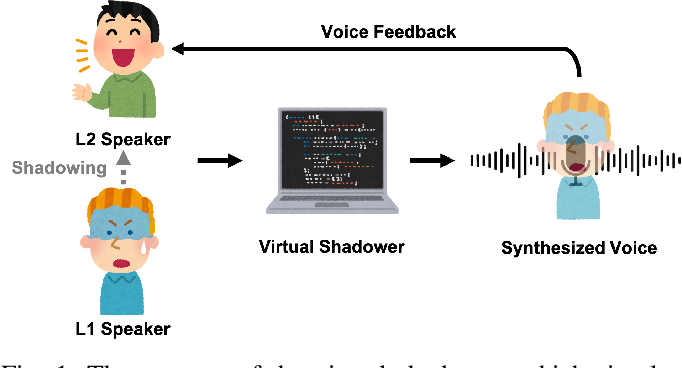
Figure 1 from A Pilot Study of Applying Sequence-to-Sequence Voice ...

(PDF) Voice Conversion Using Sequence-to-Sequence Learning of Context ...

Figure 1 from One-shot Voice Conversion by Separating Speaker and ...
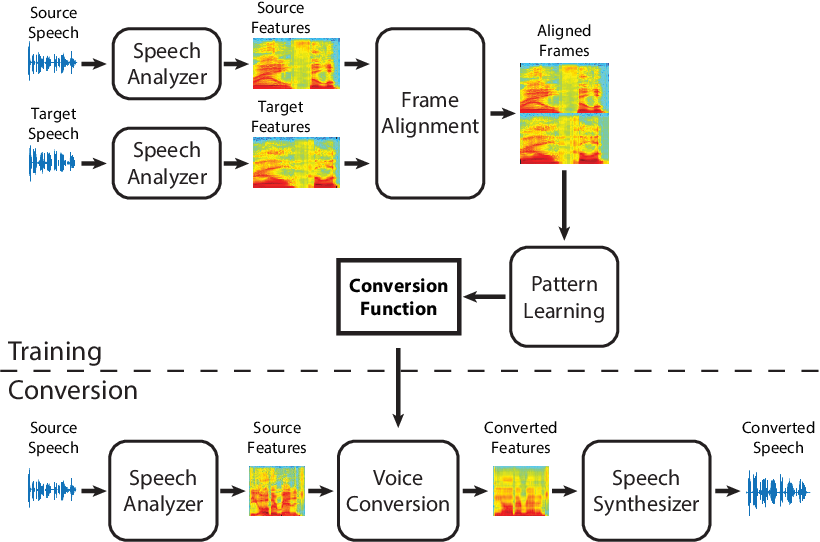
Figure 2.1 from Voice Conversion using Deep Neural Networks | Semantic ...

Voice Conversion Using Sequence-to-Sequence Learning of Context ...

Figure 1 from Voice Conversion by Cascading Automatic Speech ...
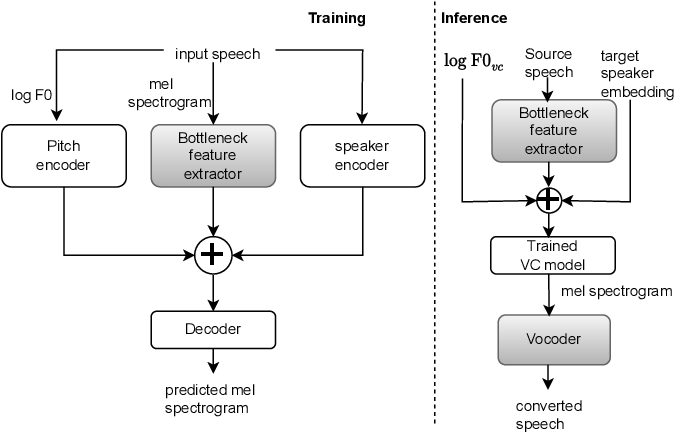
Figure 1 from Adapting Pretrained Models for Adult to Child Voice ...

Figure 1 from Voice Conversion Augmentation for Speaker Recognition on ...
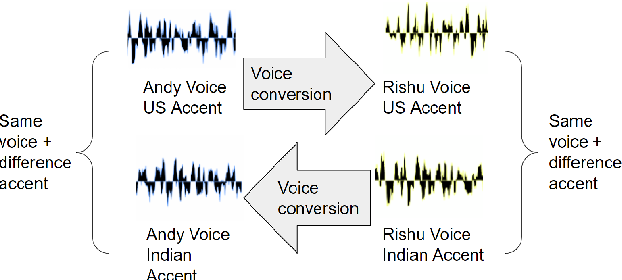
Figure 1 from Accent Conversion using Pre-trained Model and Synthesized ...
Advertisement Space (336x280)

Figure 1 from On the use of I-vectors and average voice model for voice ...
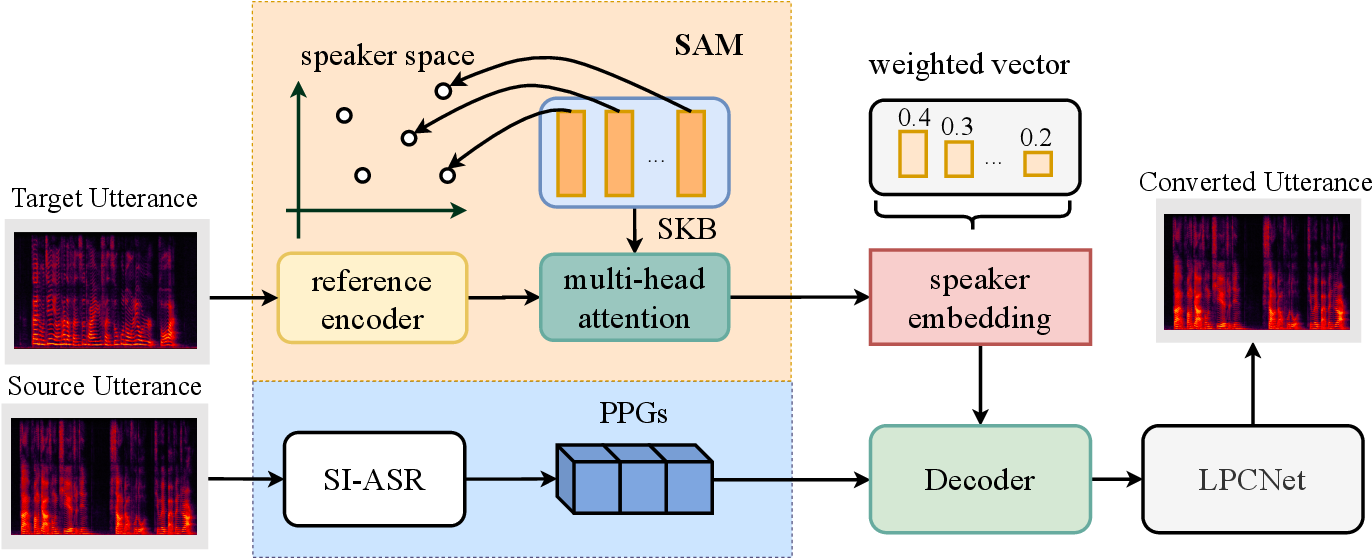
Figure 1 from One-Shot Voice Conversion Based on Speaker Aware Module ...
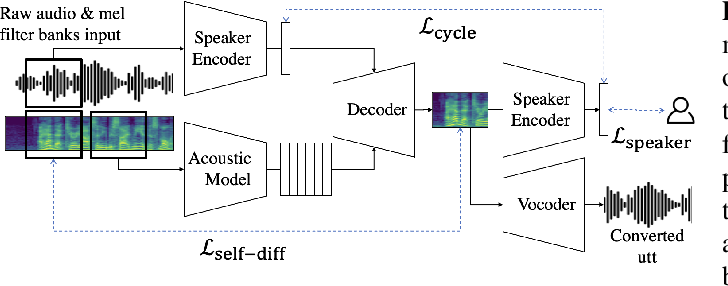
Figure 1 from Training Robust Zero-Shot Voice Conversion Models with ...

(PDF) Hierarchical Sequence to Sequence Voice Conversion with Limited Data

Figure 1 from CASIA Voice Conversion System for the Voice Conversion ...

Figure 1 from Segment Level Voice Conversion with Recurrent Neural ...