
Figure 2 From Contrastive Speaker Embedding With Sequential
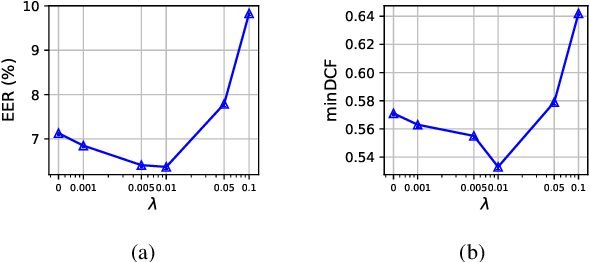
Figure 2 from Contrastive Speaker Embedding With Sequential ...
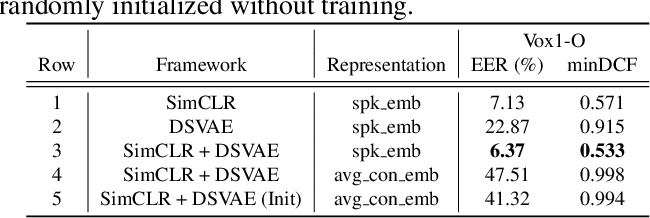
Table 2 from Contrastive Speaker Embedding With Sequential ...

Figure 1 from Contrastive Self-Supervised Speaker Embedding With ...
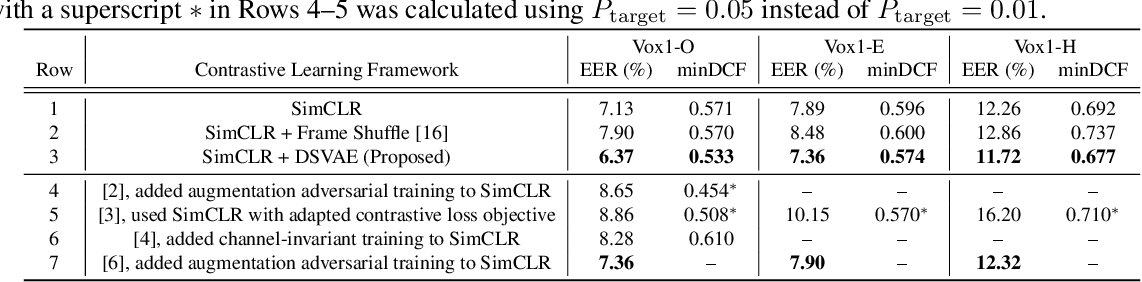
Table 1 from Contrastive Speaker Embedding With Sequential ...
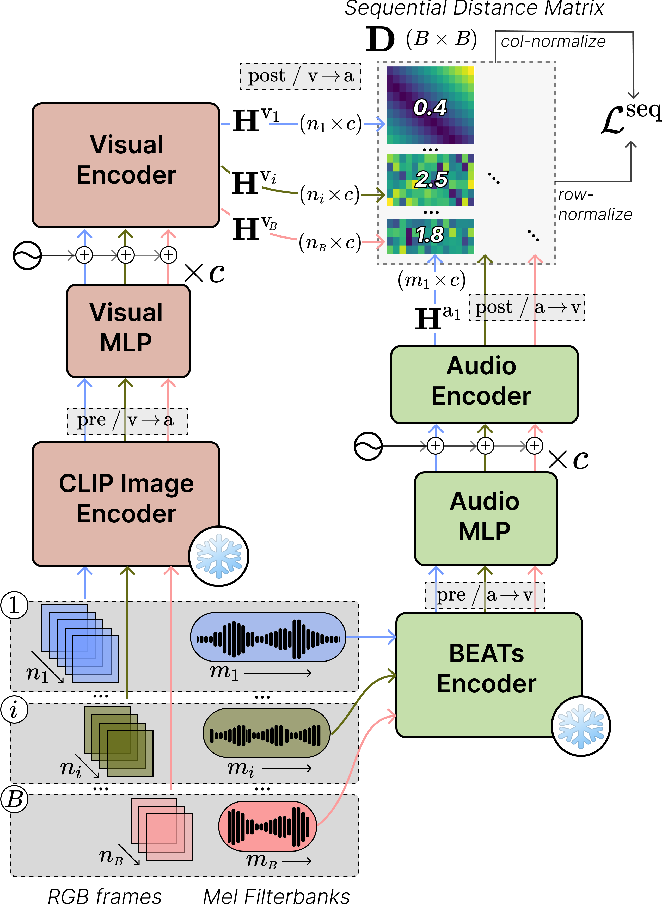
Figure 2 from Sequential Contrastive Audio-Visual Learning | Semantic ...
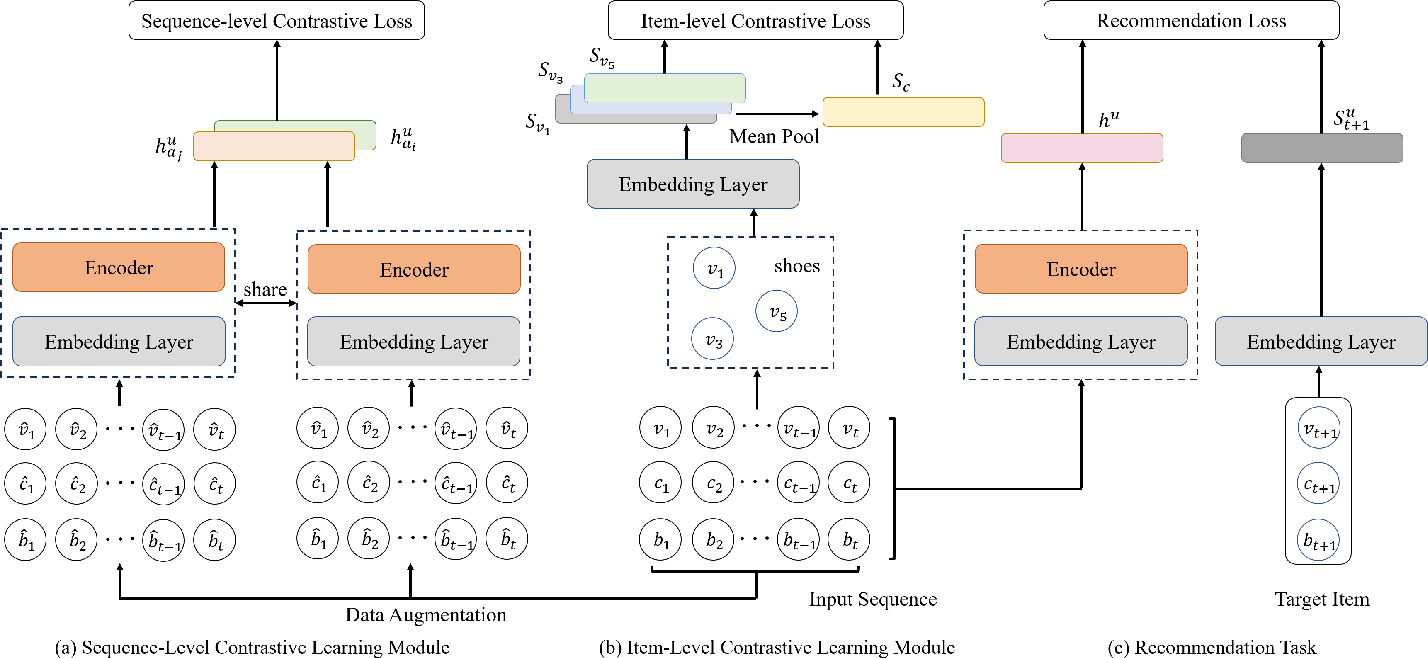
Figure 2 from MCL4SRec: A Sequential Recommendation Model with Multi ...

Figure 2 from Explanation Guided Contrastive Learning for Sequential ...

Figure 2 from Sequential Contrastive Audio-Visual Learning | Semantic ...

Figure 2 from Collaborative Graph Neural Networks with Contrastive ...

Figure 2 from Contrastive Embedding for Generalized Zero-Shot Learning ...
Advertisement Space (300x250)

Figure 2 from Dual Contrastive Network for Sequential Recommendation ...
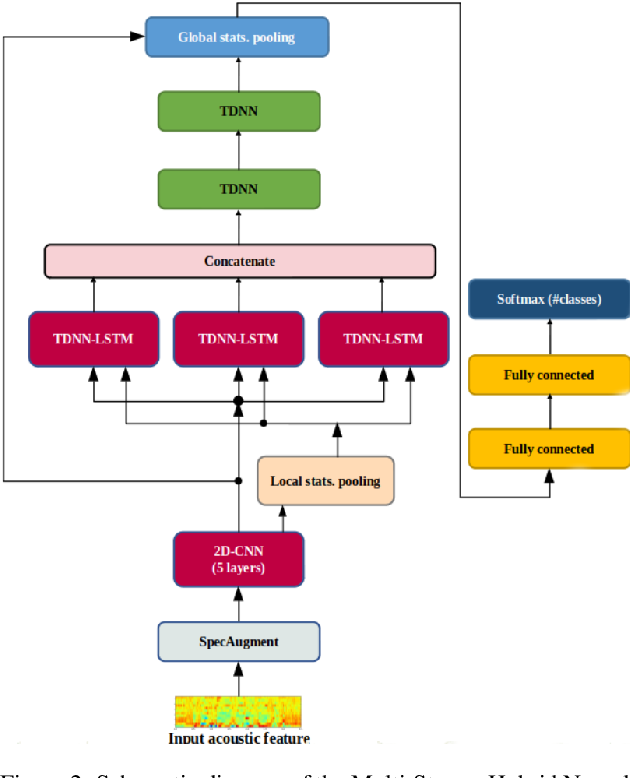
Figure 2 from Investigation on Deep Speaker Embedding Extraction ...

Figure 2 from Debiased Contrastive Learning for Sequential ...

Figure 2 from Joint Speech-Text Embeddings with Disentangled Speaker ...

Figure 2 from DNN-based Speaker Embedding Using Subjective Inter ...

Figure 1 from Speaker Embedding Extraction with Phonetic Information ...

Figure 2 from Speaker Embeddings With Weakly Supervised Voice Activity ...
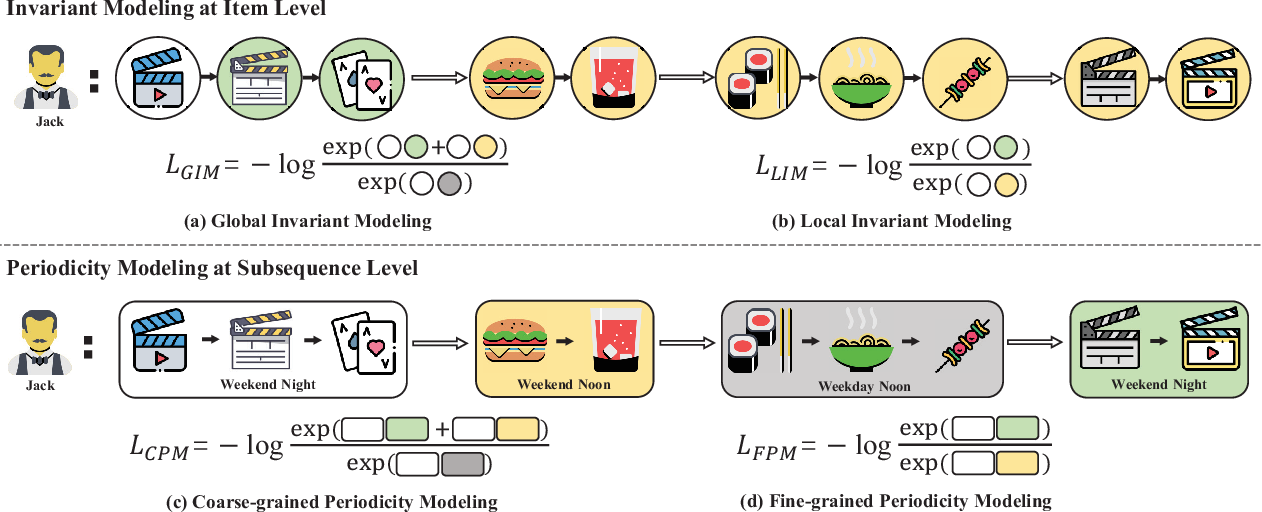
Figure 2 from Temporal Contrastive Pre-Training for Sequential ...
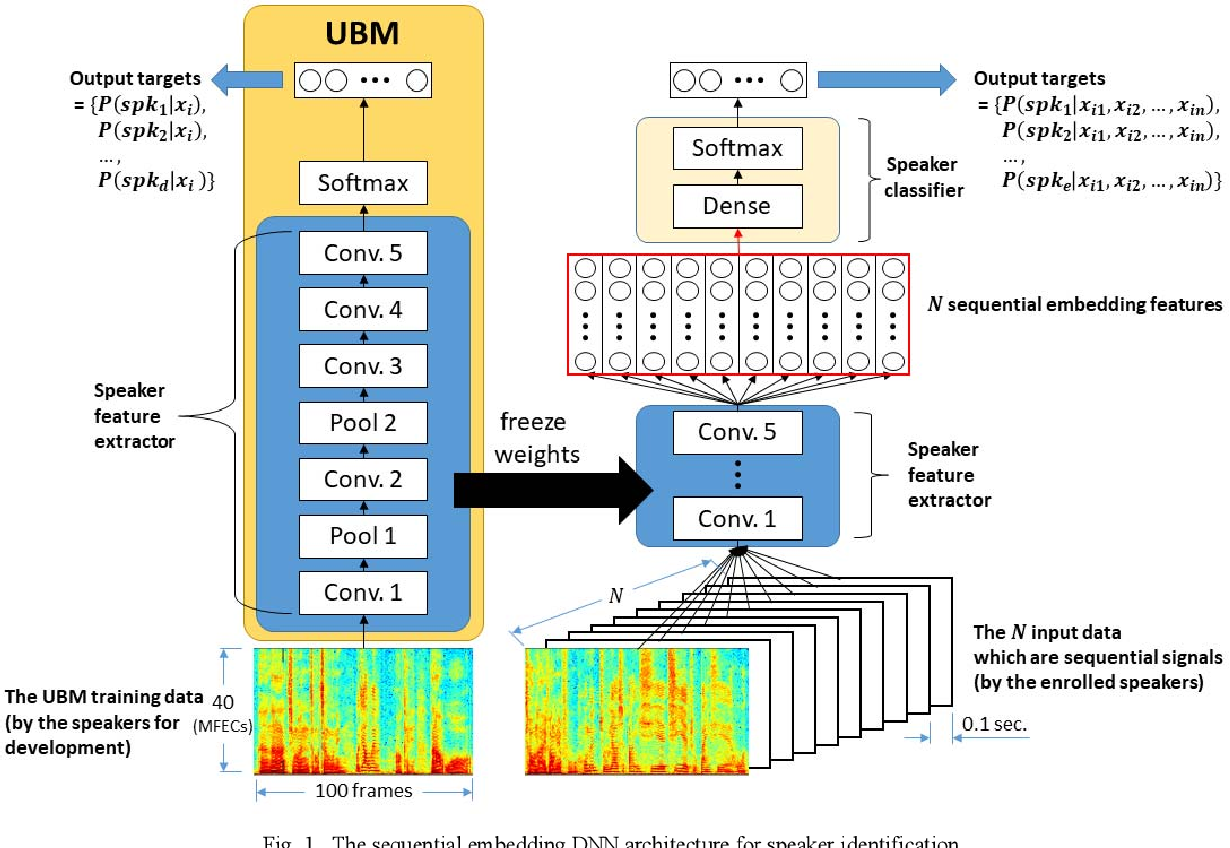
Figure 1 from Sequential Speaker Embedding and Transfer Learning for ...
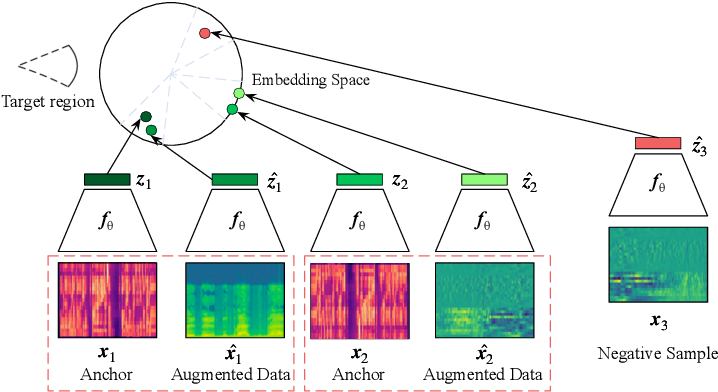
Figure 1 from Speaker Representation Learning via Contrastive Loss with ...
Advertisement Space (336x280)

Figure 2 from Instance Adaptive Prototypical Contrastive Embedding for ...
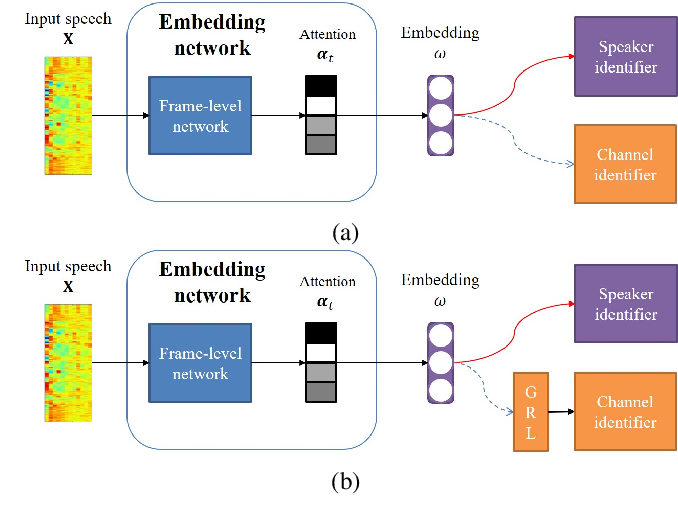
Figure 2 from Disentangled Speaker and Nuisance Attribute Embedding for ...

Figure 2 from Ensemble Modeling with Contrastive Knowledge Distillation ...

Figure 1 from Speaker Embedding Extraction with Phonetic Information ...
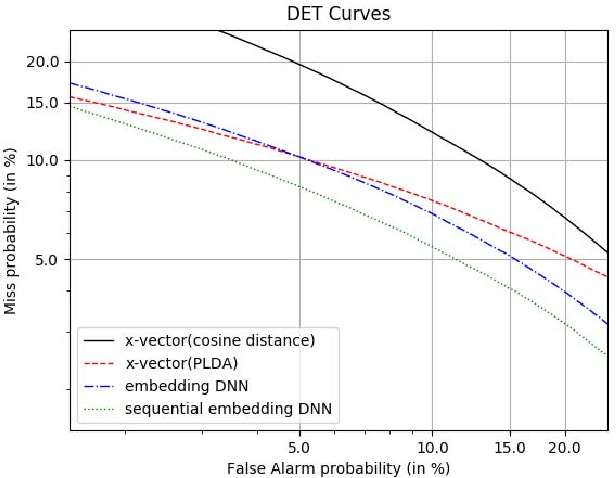
Figure 1 from Sequential Speaker Embedding and Transfer Learning for ...

Figure 2 from Denoising Multi-modal Sequential Recommenders with ...

Figure 1 from A Word-axis Speaker Embedding Trained with Multi-Speaker ...

Figure 1 from SAFE: Sequential Attentive Face Embedding with ...
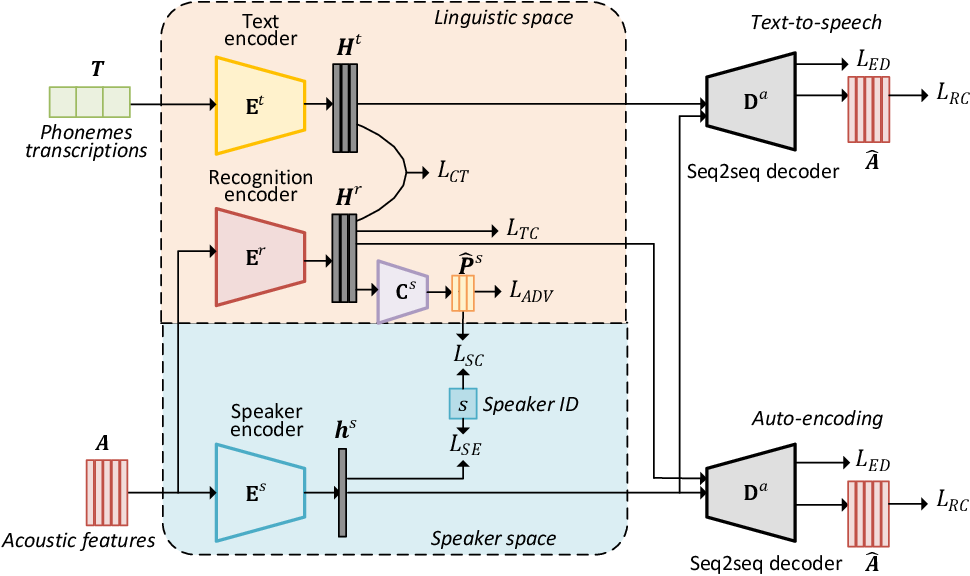
Figure 2 from Non-Parallel Sequence-to-Sequence Voice Conversion With ...

Figure 2 from Multi-Scale Speaker Embedding-Based Graph Attention ...
Advertisement Space (336x280)
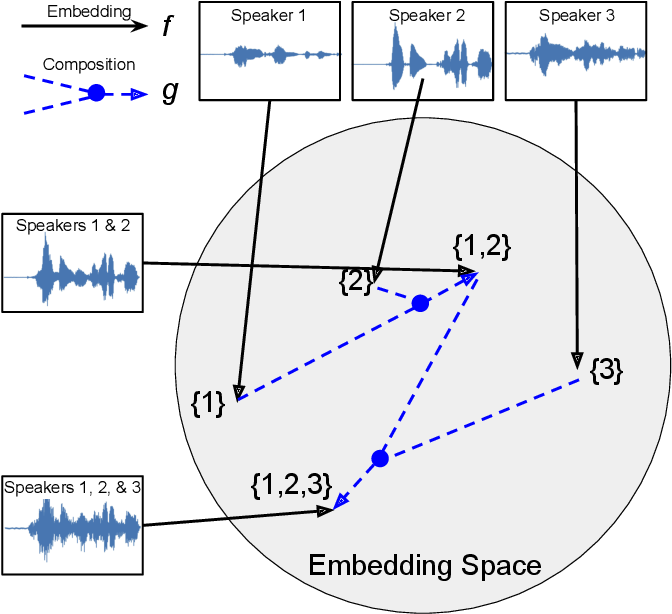
Figure 1 from Compositional Embedding Models for Speaker Identification ...

Figure 1 from Vision-Guided Speaker Embedding Based Speech Separation ...

Figure 2 from Mutual Information-based Embedding Decoupling for ...
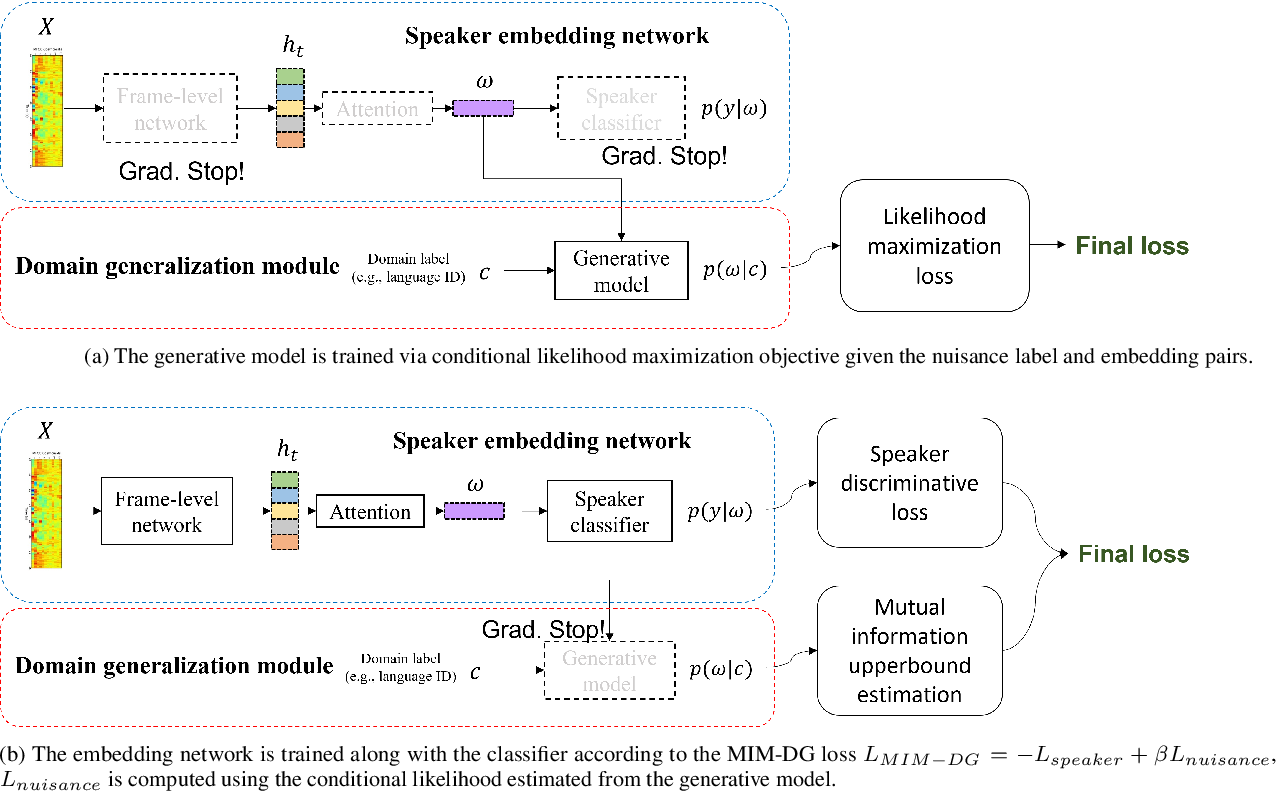
Figure 1 from Domain Generalized Speaker Embedding Learning via Mutual ...

Figure 2 from Unifying Dual-Space Embedding for Entity Alignment via ...
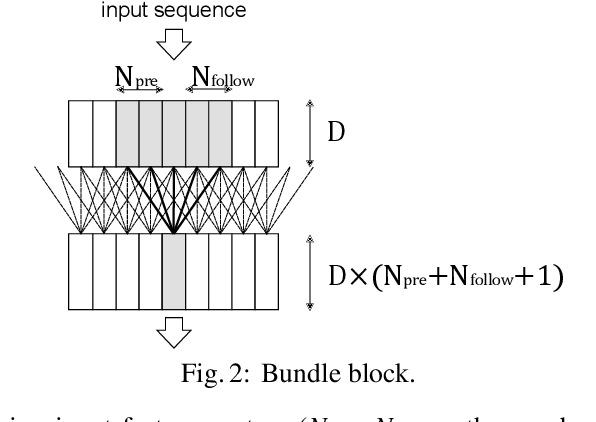
Figure 2 from Speech Rhythm-Based Speaker Embeddings Extraction from ...