
Figure 2 From Fusion Optimized Multimodal Entity Alignment With Textual
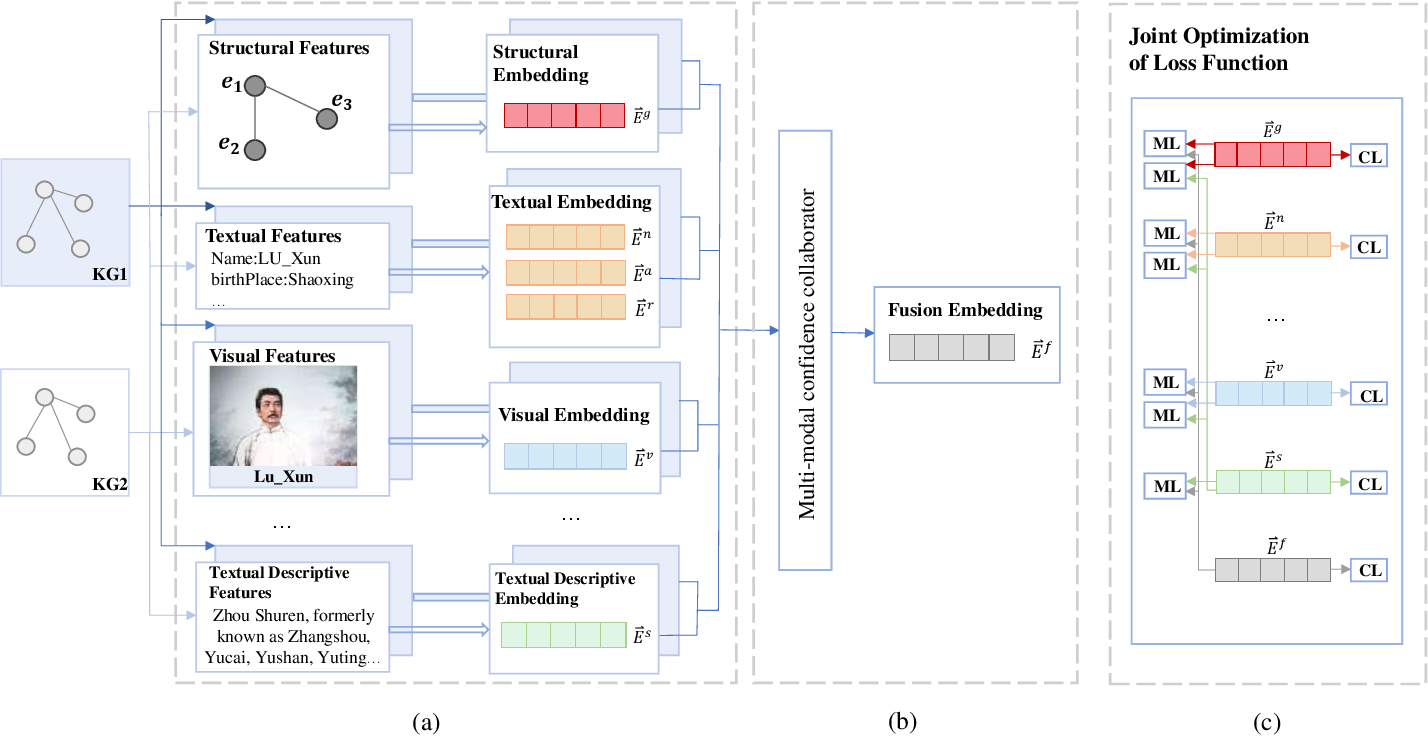
Figure 2 from Fusion-Optimized Multimodal Entity Alignment with Textual ...

Figure 2 from Text-Image Scene Graph Fusion for Multimodal Named Entity ...

Figure 2 from A Multimodal Semantic Fusion Network with Cross-Modal ...
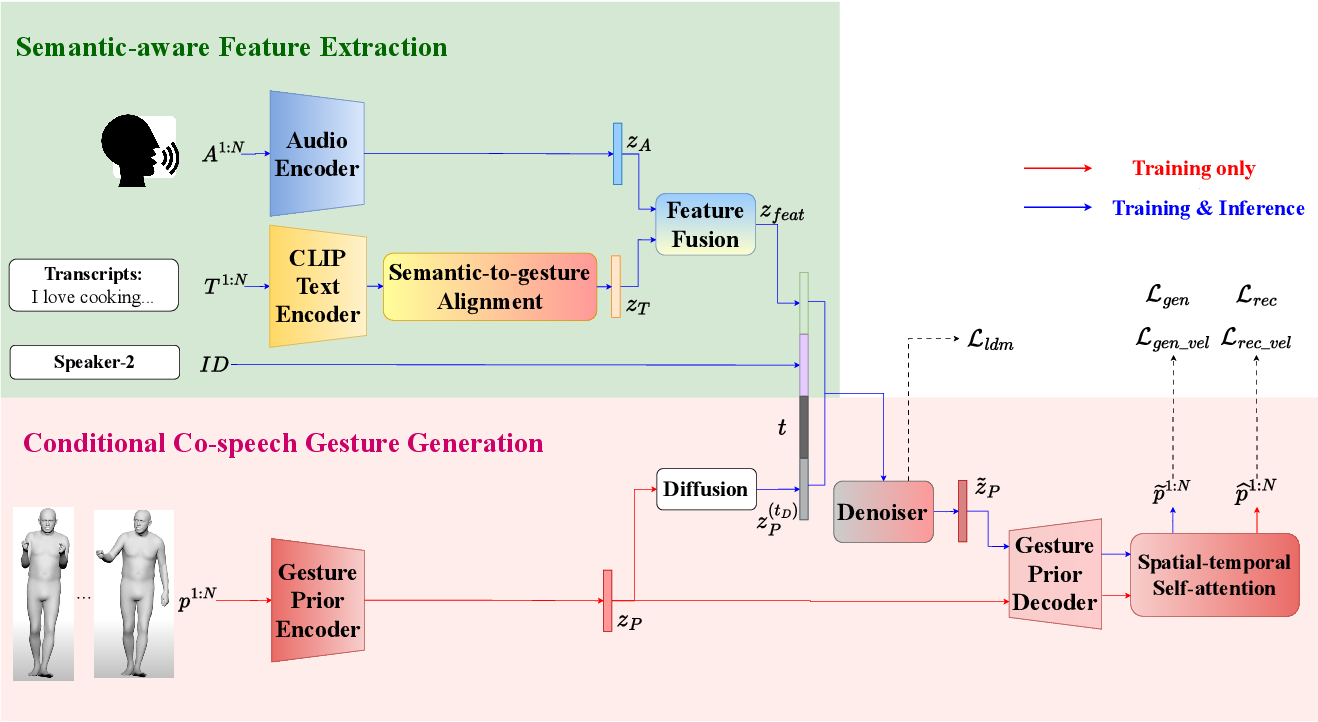
Figure 2 from SemGest: A Multimodal Feature Space Alignment and Fusion ...

Figure 2 from Modular and Parameter-Efficient Multimodal Fusion with ...

Figure 2 from Contrastive Learning-Based Multi-Modal Entity Alignment ...

Fusion-Optimized Multimodal Entity Alignment with Textual Descriptions
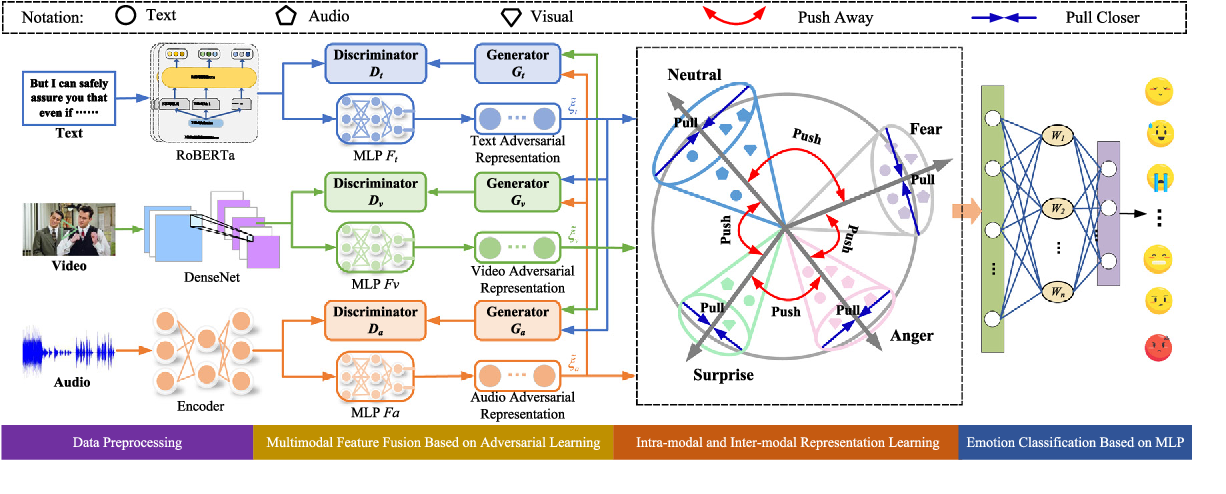
Figure 2 from Adversarial alignment and graph fusion via information ...

Fusion-Optimized Multimodal Entity Alignment with Textual Descriptions
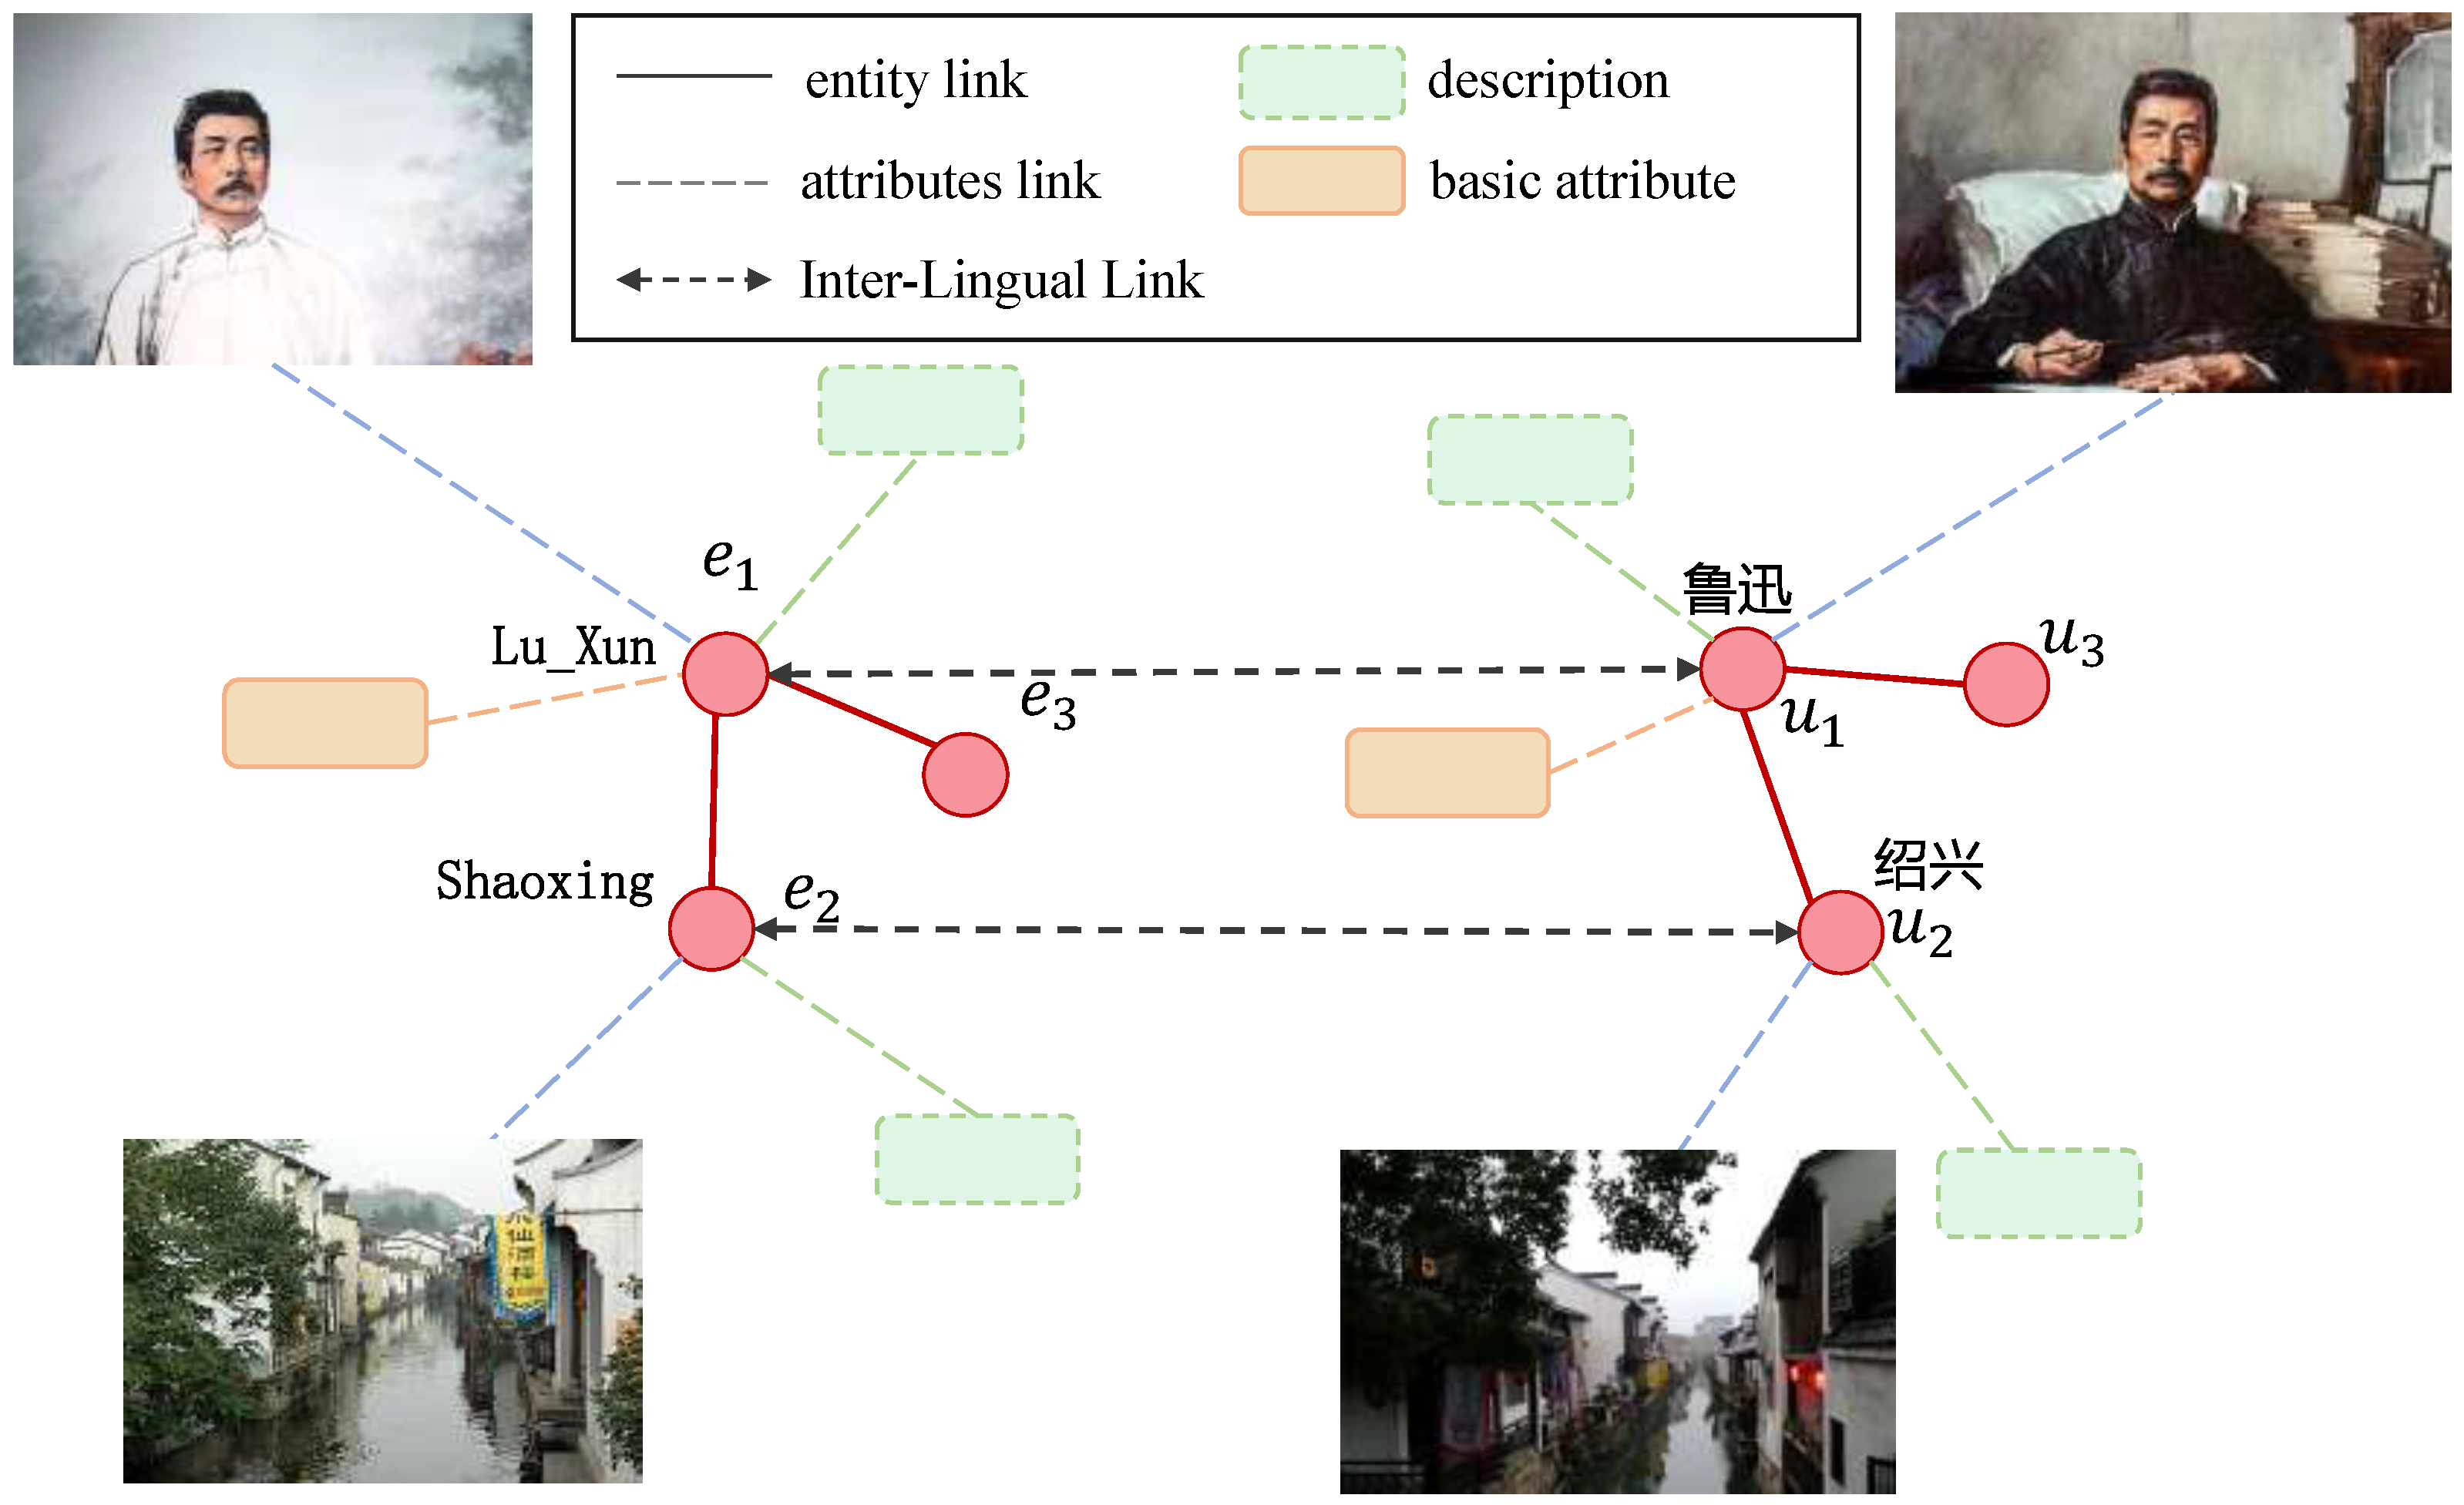
Fusion-Optimized Multimodal Entity Alignment with Textual Descriptions
Advertisement Space (300x250)
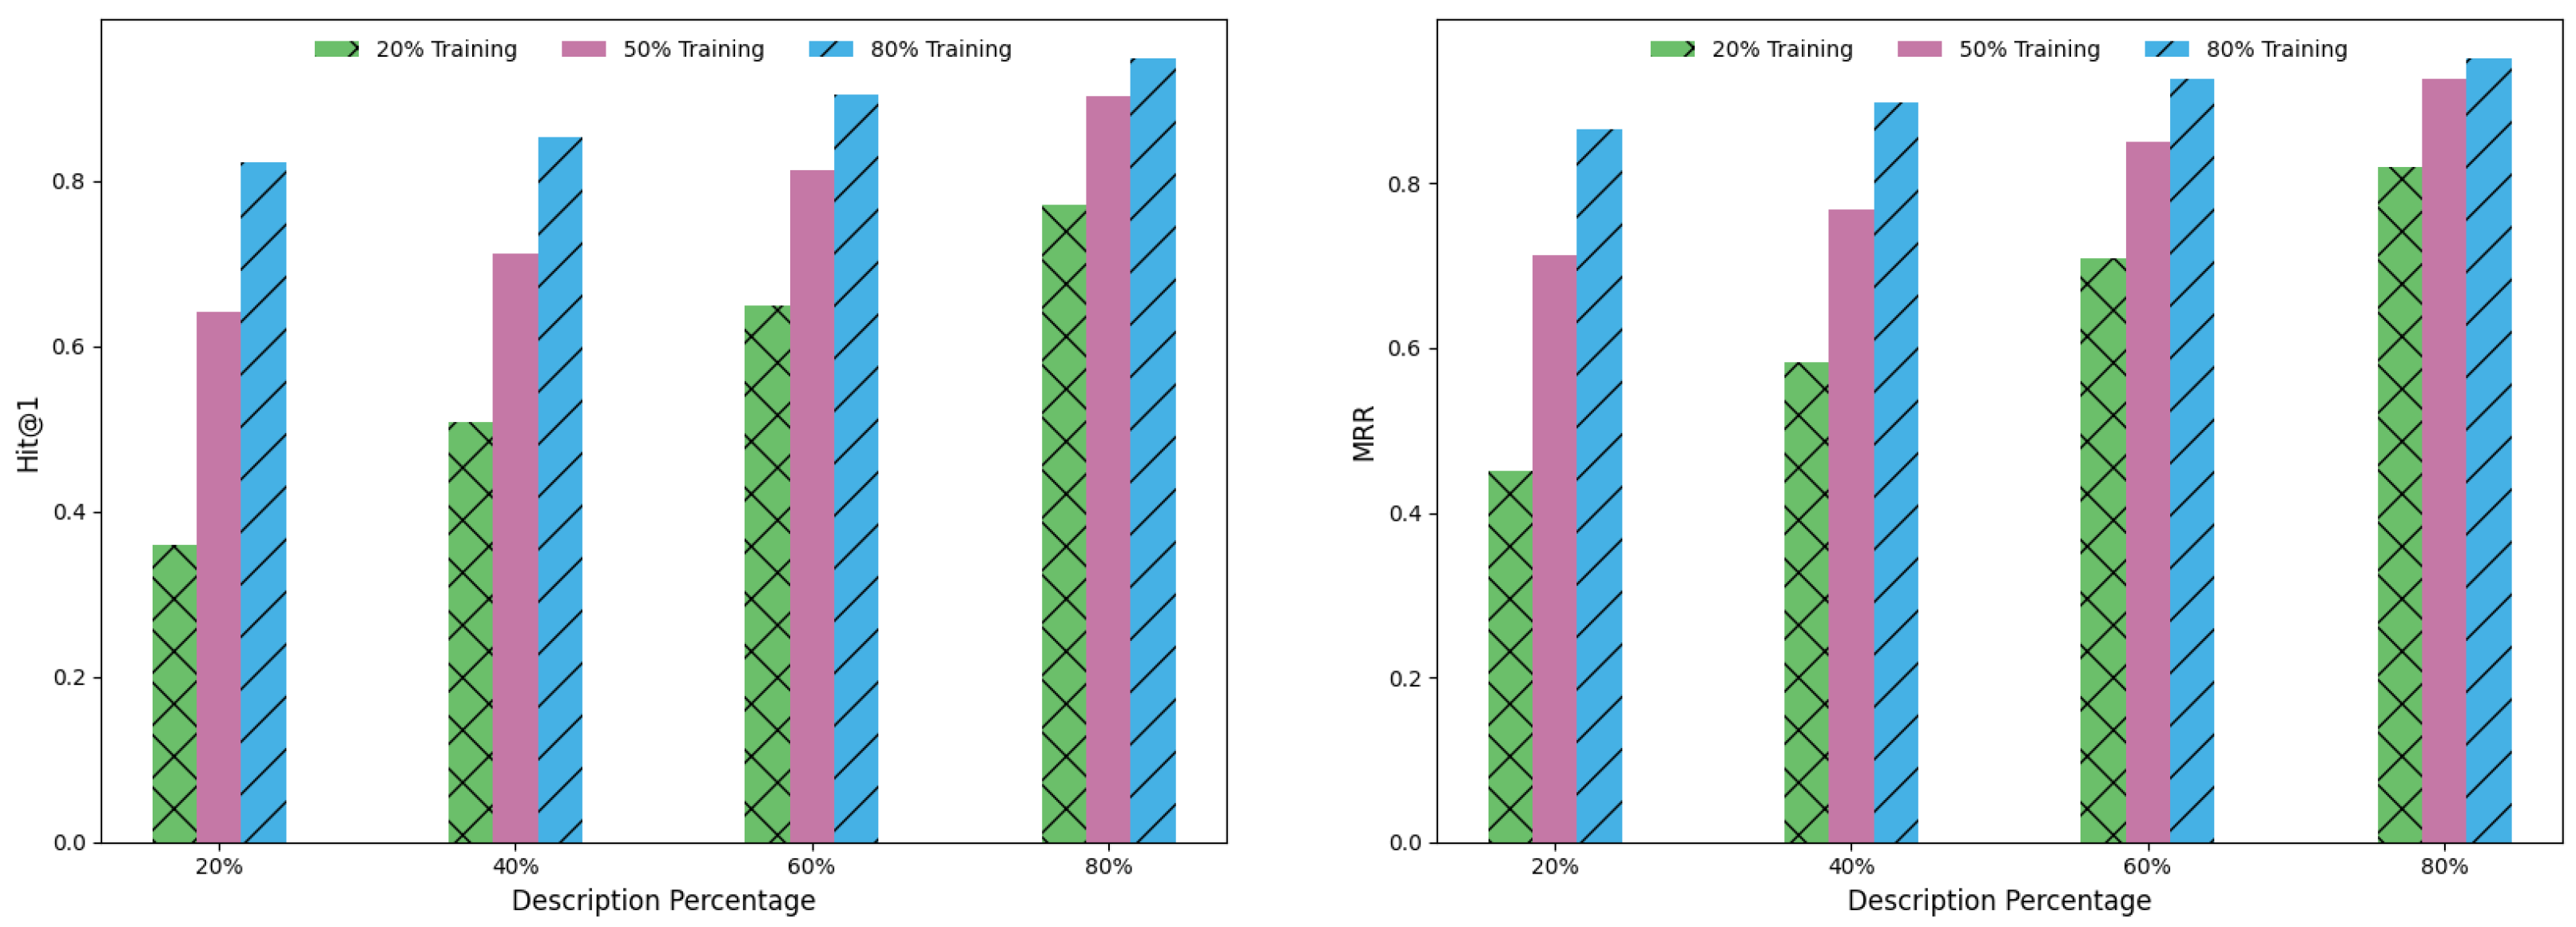
Fusion-Optimized Multimodal Entity Alignment with Textual Descriptions
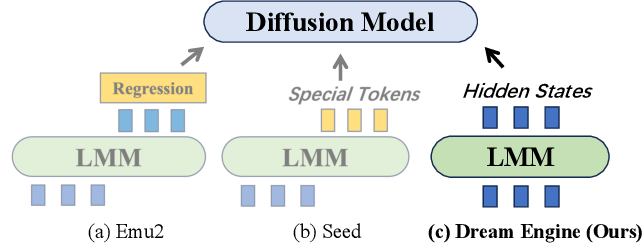
Figure 2 from Multimodal Representation Alignment for Image Generation ...

Fusion-Optimized Multimodal Entity Alignment with Textual Descriptions

Figure 2 from Multi-Modal Entity Alignment Method Based on Feature ...

Figure 2 from Multi-modal Graph Fusion for Named Entity Recognition ...

Figure 2 from Universal Multi-modal Entity Alignment via Iteratively ...

Figure 2 from Multi-Modal Entity Alignment Using Uncertainty ...

Figure 2 from Masked Graph Learning With Recurrent Alignment for ...
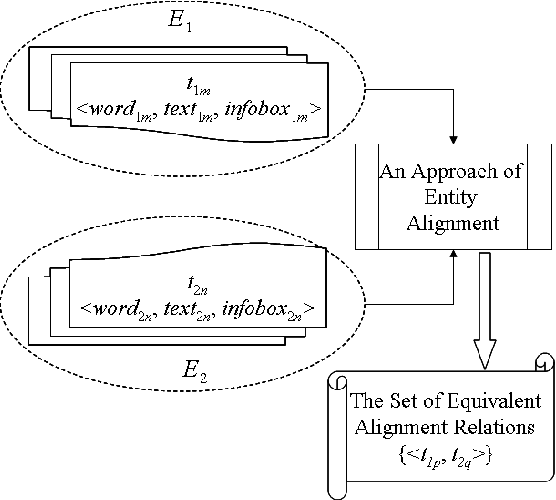
Figure 1 from A multi-view fusion approach for entity alignment ...

Figure 2 from Multi-modal Entity Alignment via Position-enhanced Multi ...
Advertisement Space (336x280)

Figure 2 from An Effective Span-based Multimodal Named Entity ...
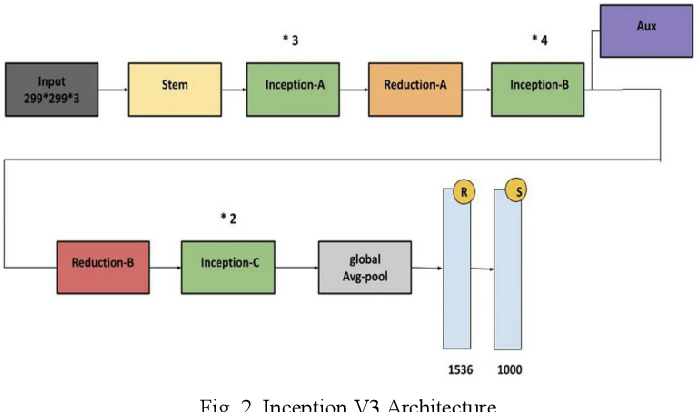
Figure 2 from Deep Learning-based Multimodal Fusion for Improved Object ...

Figure 2 from Cross-Modal Semantic Alignment before Fusion for Two-Pass ...

Figure 3 from Optimized Multimodal Neurological Image Fusion Based on ...

Figure 2 from Text-centric Alignment for Multi-Modality Learning ...

Figure 2 from Integrating Large Pre-trained Models into Multimodal ...

Figure 2 from Joint Multimodal Entity-Relation Extraction Based on Edge ...

Figure 1 from Contrastive Learning-Based Multi-Modal Entity Alignment ...

(PDF) Multi-level fusion with fine-grained alignment for multimodal ...
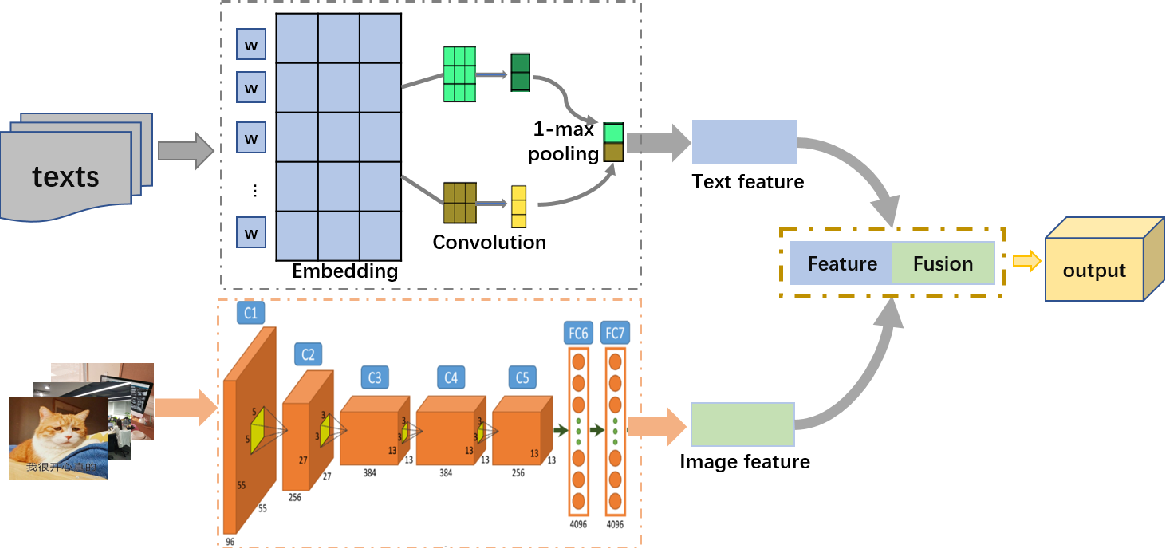
Figure 2 from A Deep Multi-Modal Fusion Approach for Semantic Place ...
Advertisement Space (336x280)

Figure 5 from Contrastive Learning-Based Multi-Modal Entity Alignment ...

Figure 2 from Integrating Large Pre-trained Models into Multimodal ...

Figure 2 from Alignment-Enhanced Interactive Fusion Model for Complete ...

Figure 1 from Attentive Multimodal Fusion for Optical and Scene Flow ...

Figure 1 from Enhancing Multi-Modal Entity Alignment via Multi-Grained ...
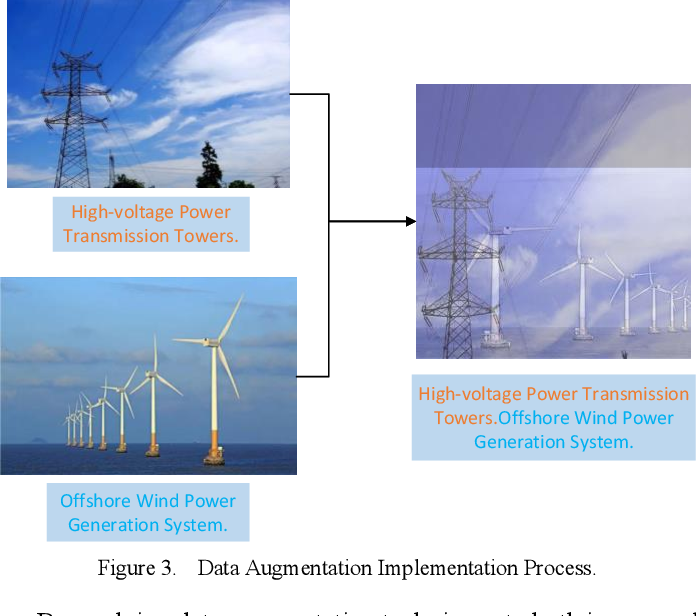
Figure 3 from Contrastive Learning-Based Multi-Modal Entity Alignment ...