
Figure 2 From Madtp Multimodal Alignment Guided Dynamic Token Pruning

Figure 2 from MADTP: Multimodal Alignment-Guided Dynamic Token Pruning ...

Figure 2 from ProPD: Dynamic Token Tree Pruning and Generation for LLM ...
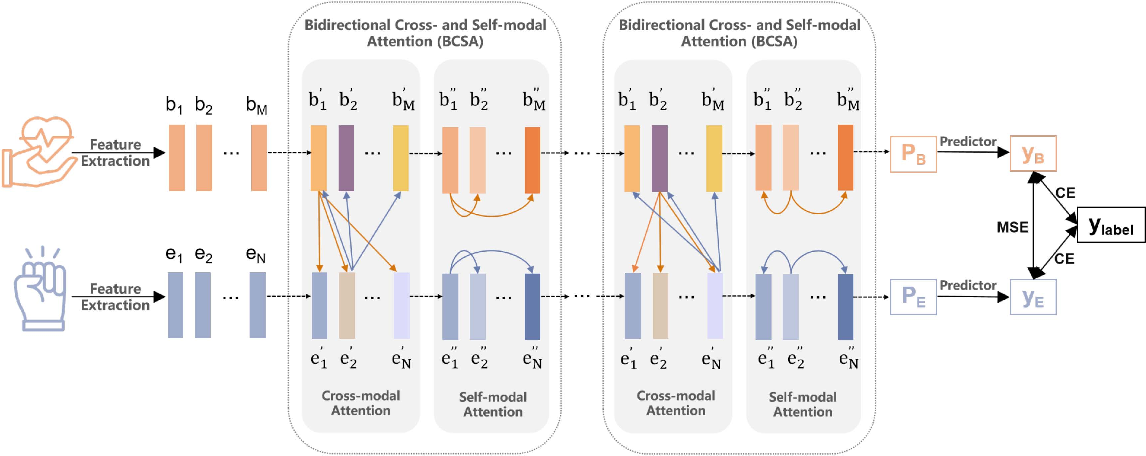
Figure 2 from Dynamic Alignment and Fusion of Multimodal Physiological ...
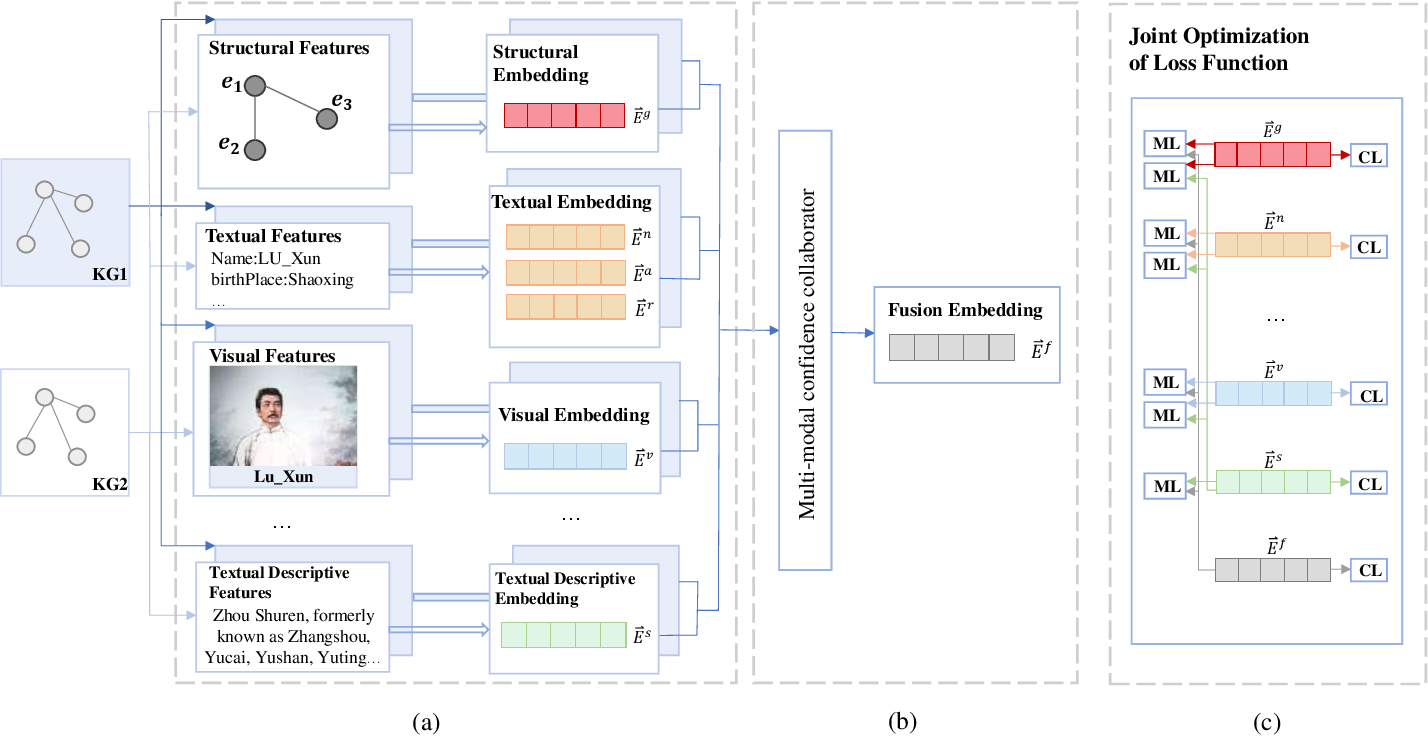
Figure 2 from Fusion-Optimized Multimodal Entity Alignment with Textual ...

Figure 1 from Query-Oriented Dynamic Multimodal Alignment for Few-Shot ...

Figure 3 from VLTP: Vision-Language Guided Token Pruning for Task ...

Figure 1 from ProPD: Dynamic Token Tree Pruning and Generation for LLM ...

Figure 2 from AIM: Adaptive Inference of Multi-Modal LLMs via Token ...
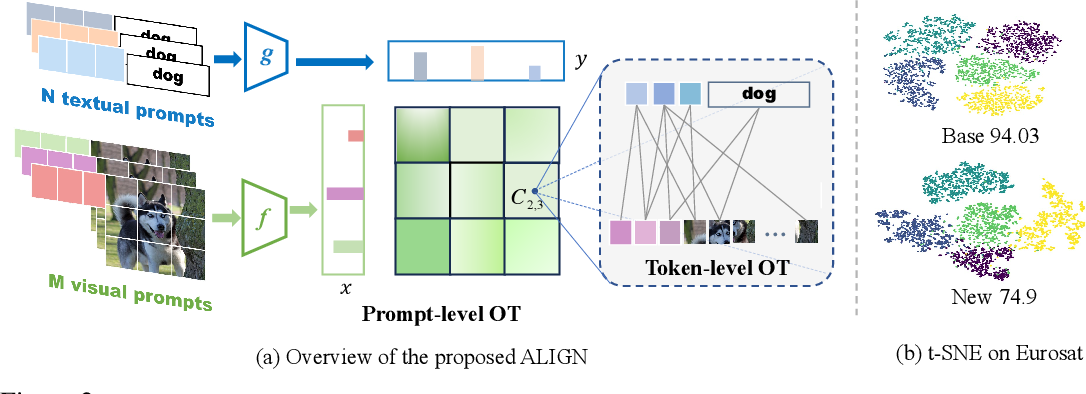
Figure 2 from Tuning Multi-mode Token-level Prompt Alignment across ...
MADTP: Multimodal Alignment-Guided Dynamic Token Pruning for ...
Advertisement Space (300x250)

MADTP: Multimodal Alignment-Guided Dynamic Token Pruning for ...
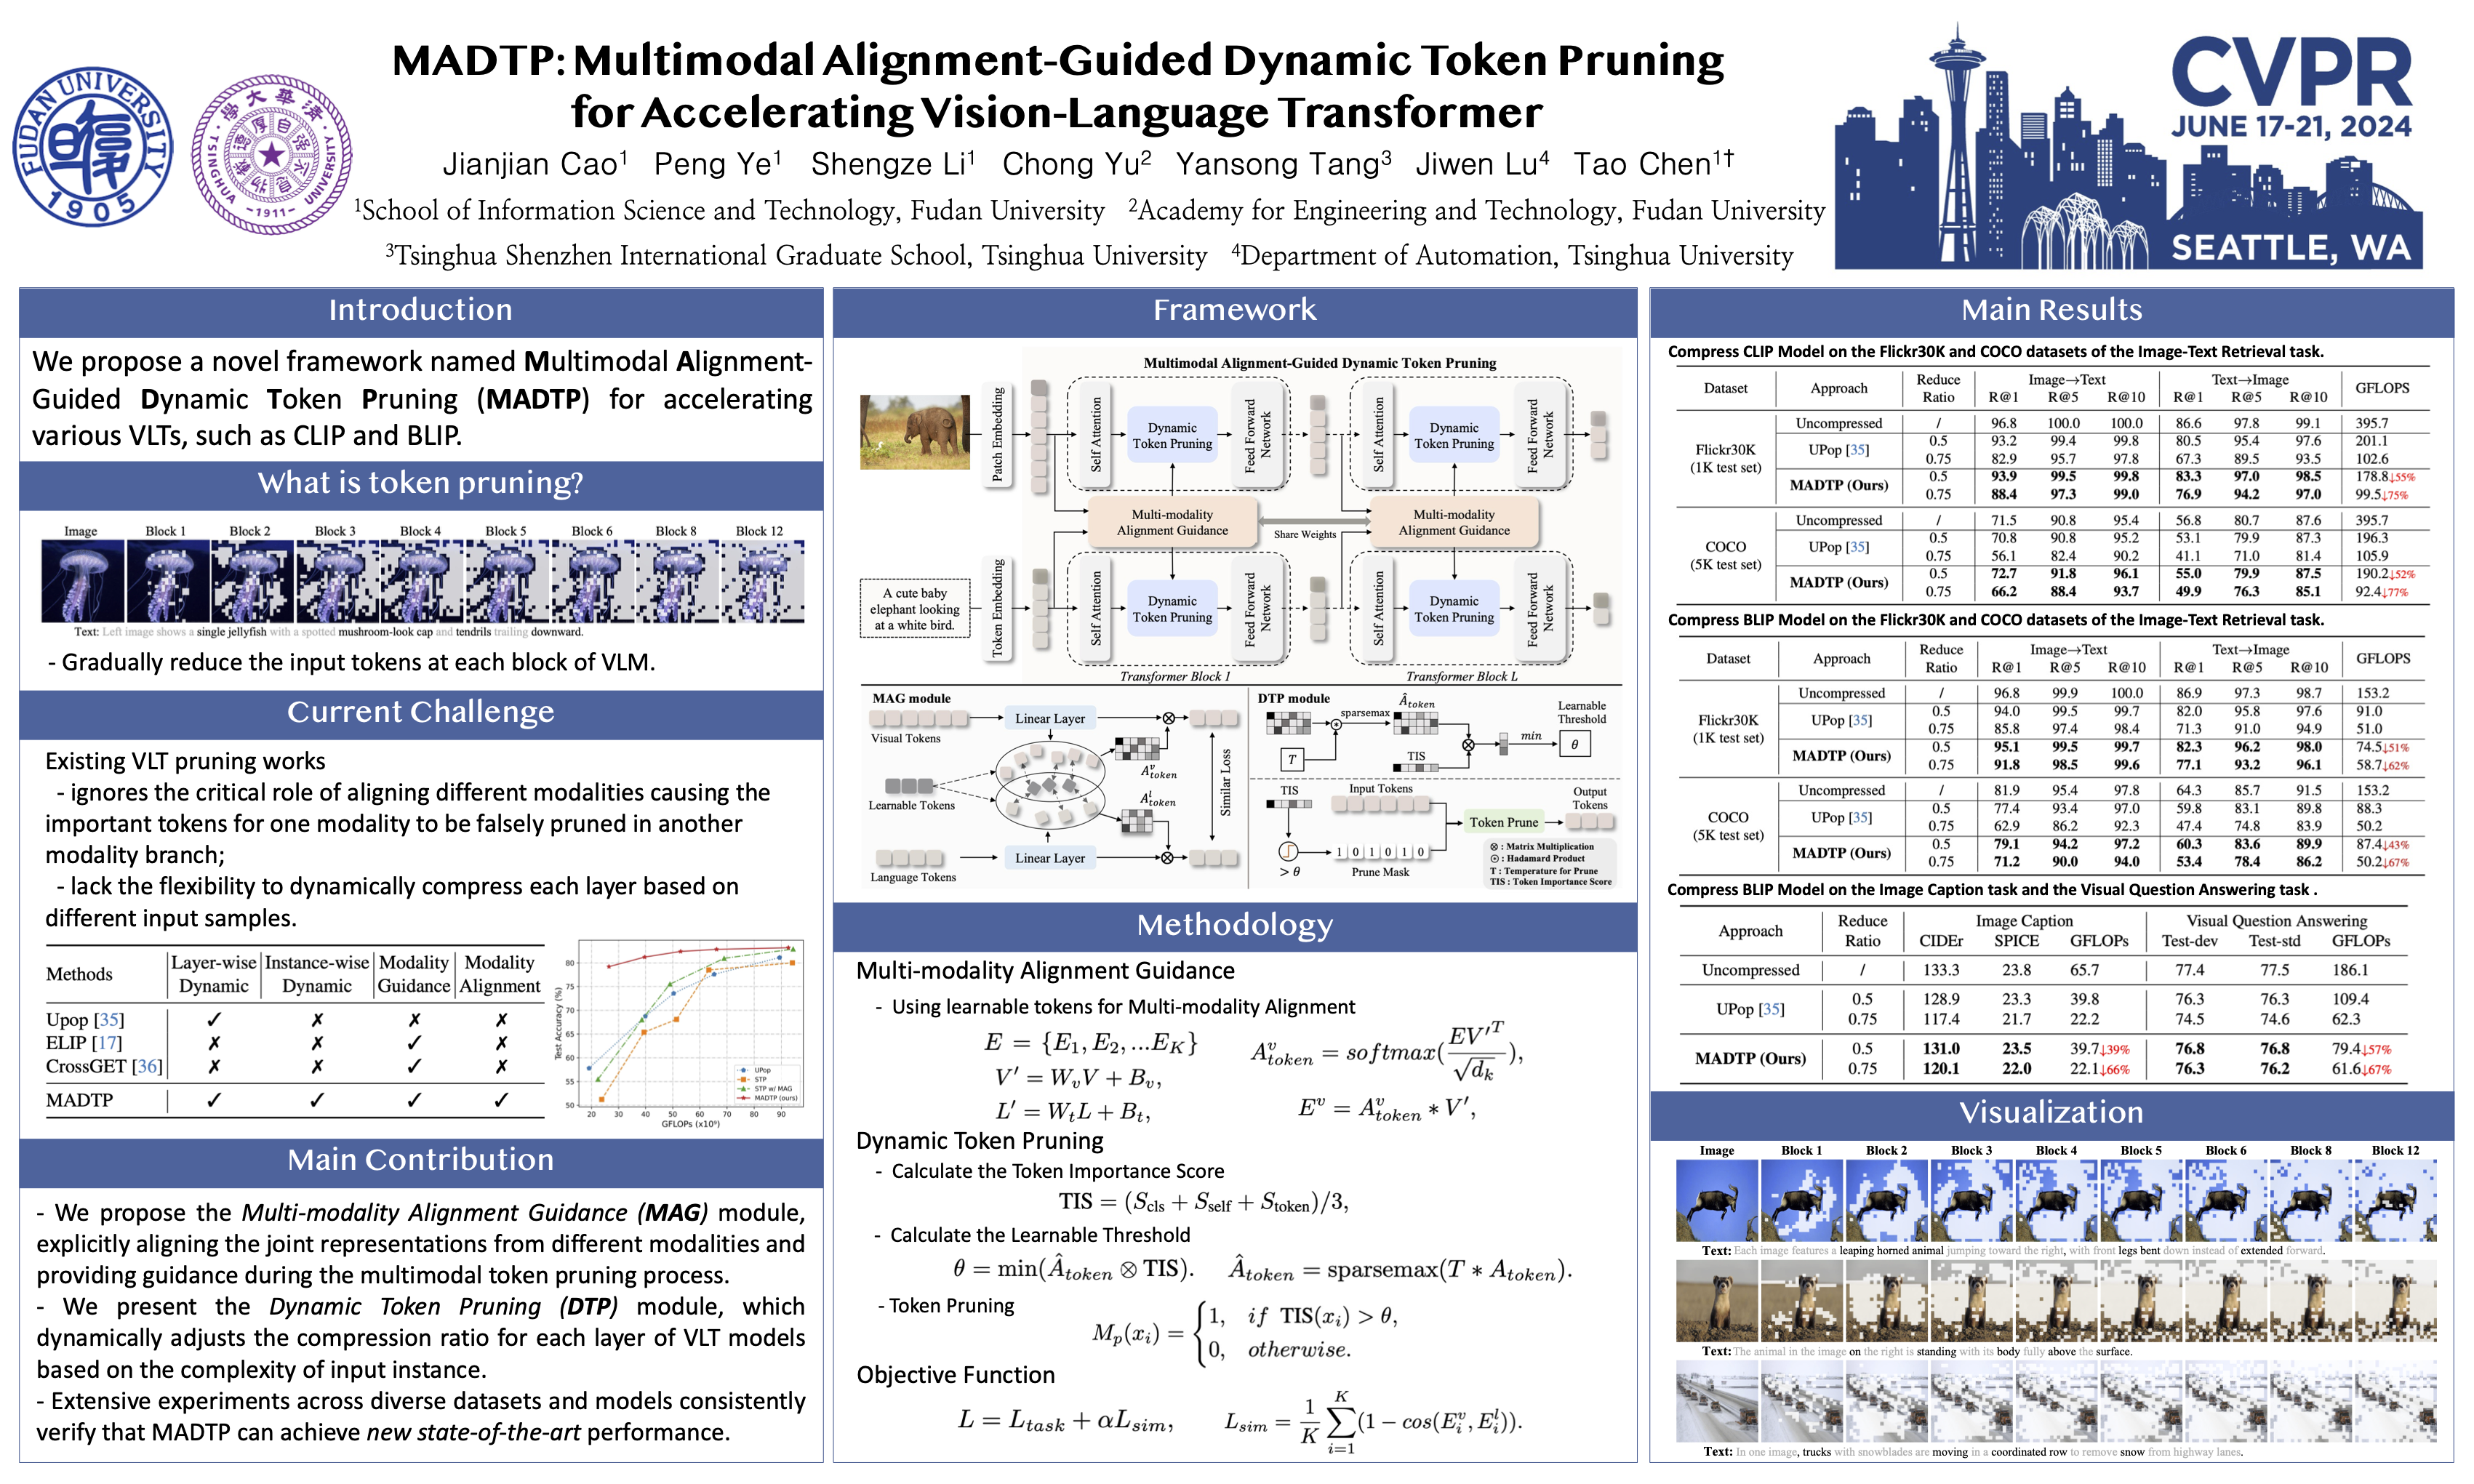
CVPR Poster MADTP: Multimodal Alignment-Guided Dynamic Token Pruning ...

Figure 2 from A Multimodal Semantic Fusion Network with Cross-Modal ...
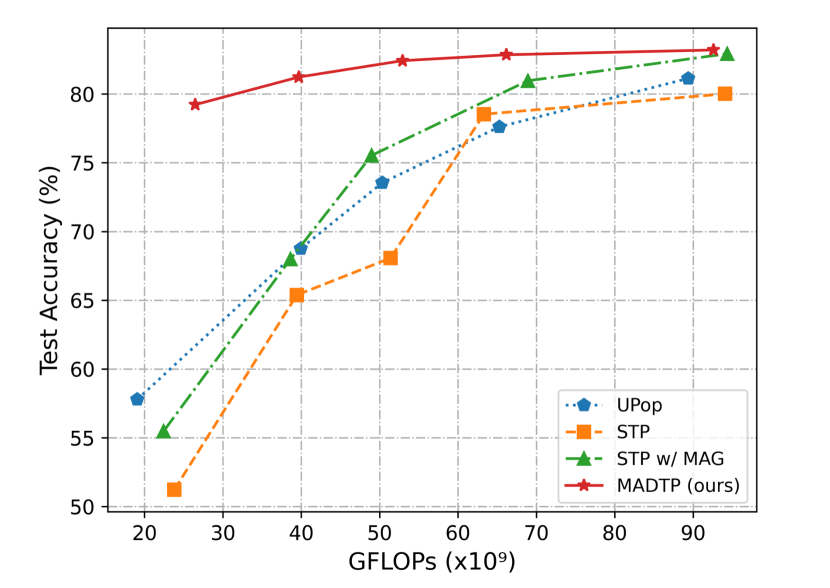
[2403.02991] MADTP: Multimodal Alignment-Guided Dynamic Token Pruning ...
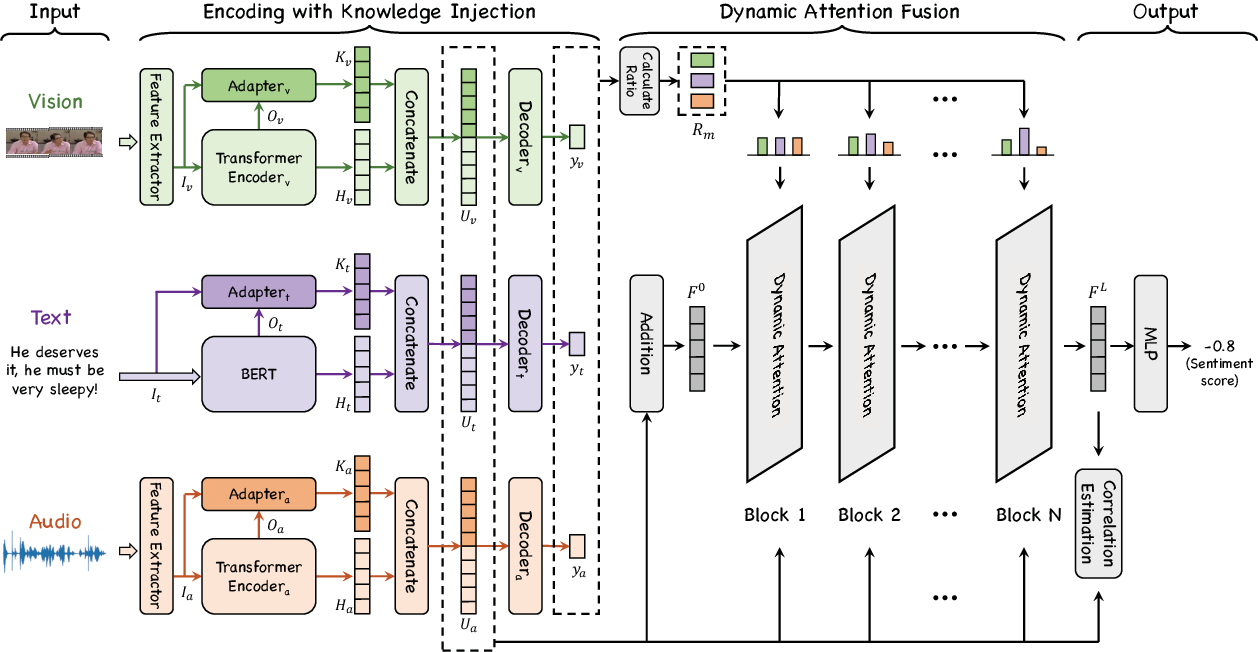
Figure 2 from Knowledge-Guided Dynamic Modality Attention Fusion ...
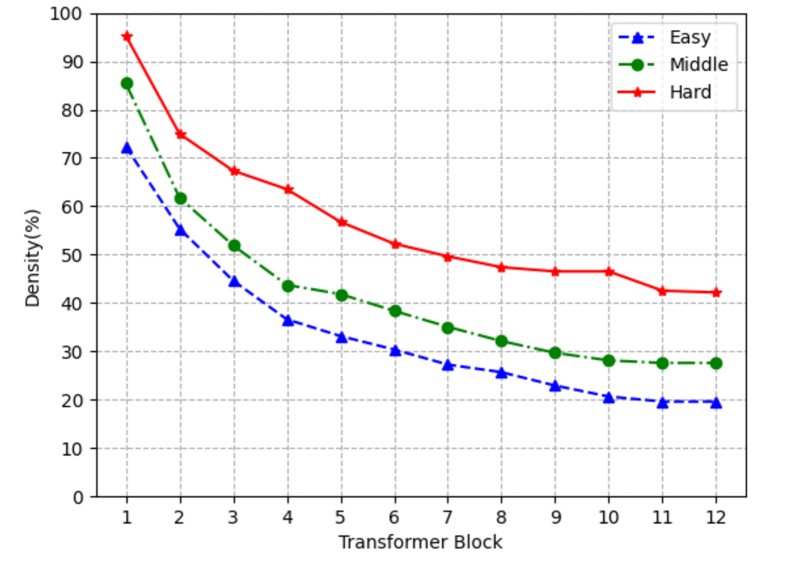
[2403.02991] MADTP: Multimodal Alignment-Guided Dynamic Token Pruning ...

Figure 2 from MMT: Image-guided Story Ending Generation with Multimodal ...

Figure 2 from Contrastive Pre-training with Multi-level Alignment for ...

Figure 2 from Tell and Show: A Multimodal Guidance Method for ...

Figure 2 from Masked Graph Learning With Recurrent Alignment for ...
Advertisement Space (336x280)

Figure 2 from Alignment and Fusion Using Distinct Sensor Data for ...
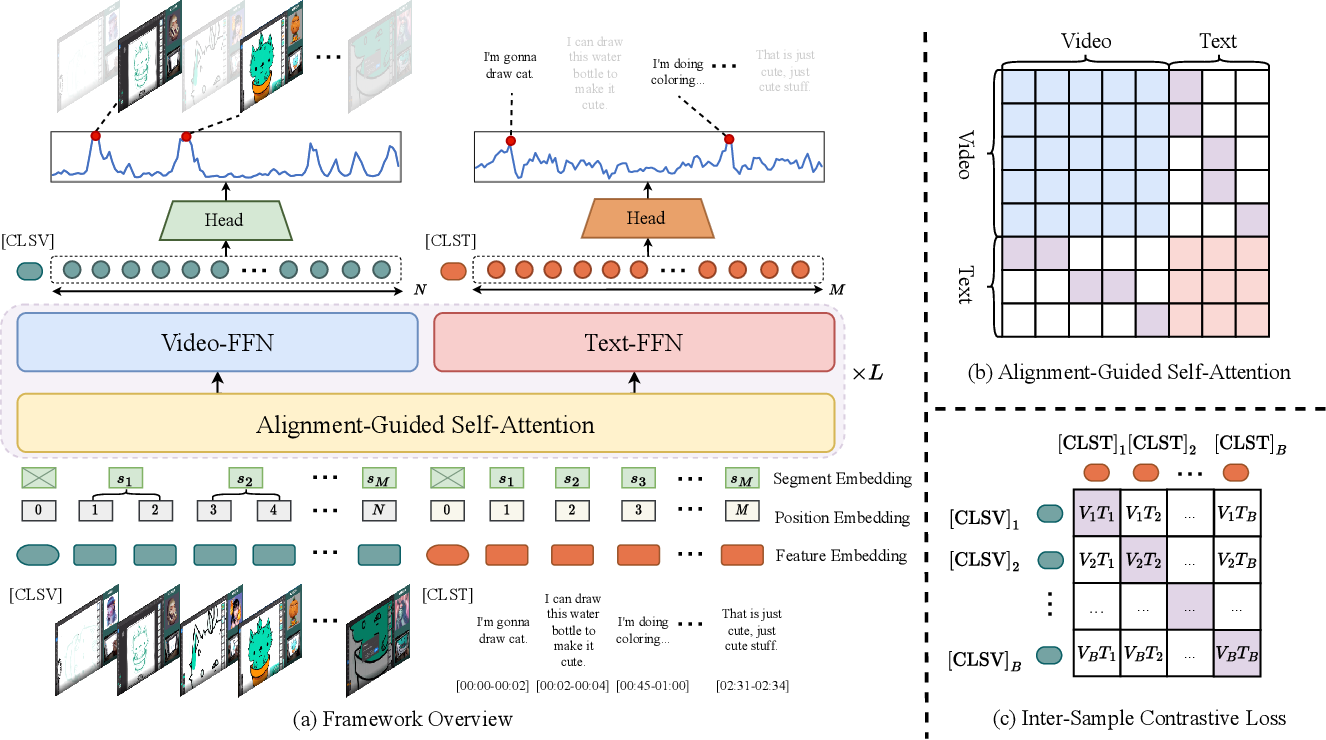
Figure 2 from Align and Attend: Multimodal Summarization with Dual ...

Figure 2 from An Effective Span-based Multimodal Named Entity ...

Figure 1 from Relative Alignment Network for Source-Free Multimodal ...
EntropyPrune: Matrix Entropy Guided Visual Token Pruning for Multimodal ...

Figure 1 from Why and When Visual Token Pruning Fails? A Study on ...
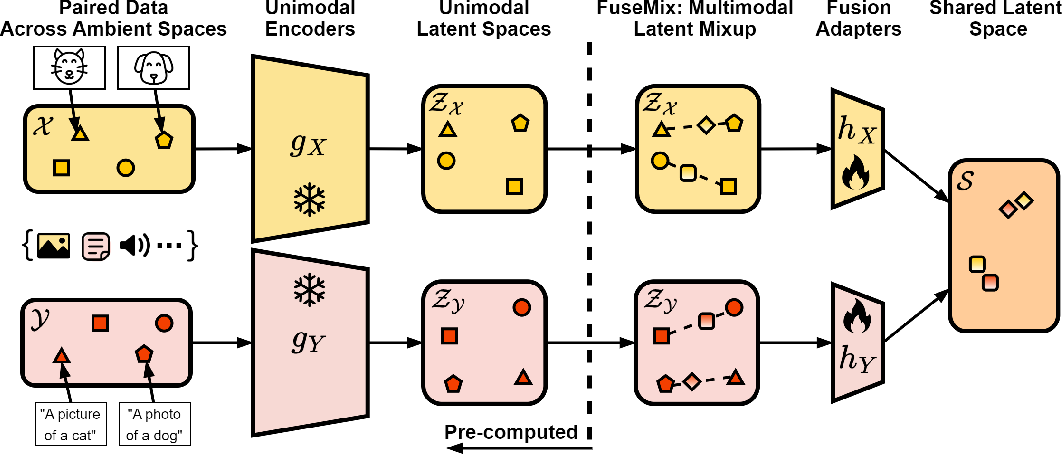
Figure 2 from Data-Efficient Multimodal Fusion on a Single GPU ...

Figure 1 from An Analysis on Matching Mechanisms and Token Pruning for ...

Table 5 from Dynamic Token Pruning in Plain Vision Transformers for ...

Figure 2 from Joint Multimodal Entity-Relation Extraction Based on Edge ...
Advertisement Space (336x280)

Figure 2 from A Touch, Vision, and Language Dataset for Multimodal ...

[2308.01045] Dynamic Token Pruning in Plain Vision Transformers for ...

[论文评述] SkipGPT: Dynamic Layer Pruning Reinvented with Token Awareness ...

Paper page - LazyLLM: Dynamic Token Pruning for Efficient Long Context ...

From Feature Alignment to Multimodal Fusion: A Two-Stage Primary ...
The variational context model for multimodal alignment, figure from ...