
Figure 2 From Pose Guided Modality Invariant Feature Alignment For

Figure 2 from Pose-Guided Modality-Invariant Feature Alignment for ...

Figure 2 from Enhanced Invariant Feature Joint Learning via Modality ...

Figure 2 from Modality Alignment between Deep Representations for ...

Figure 2 from View-invariant Feature using Pose Information and ...

Figure 2 from Exploiting Modality-Invariant Feature for Robust ...

Figure 1 from Pose-Guided Modality-Invariant Feature Alignment for ...

Figure 2 from Learning Clothing and Pose Invariant 3D Shape ...

Figure 4 from Pose-Guided Modality-Invariant Feature Alignment for ...

Figure 2 from Pose Invariant Person Re-Identification using Robust Pose ...

Figure 5 from Pose-Guided Modality-Invariant Feature Alignment for ...
Advertisement Space (300x250)

Figure 3 from Pose-Guided Modality-Invariant Feature Alignment for ...

Figure 1 from Pose and Expression Invariant Alignment based Multi-View ...

Figure 6 from Enhanced Invariant Feature Joint Learning via Modality ...

Figure 2 from Scale Invariant Feature Transform-Scholarpedia | Semantic ...

Figure 2 from Learning Invariant Representation via Contrastive Feature ...

Figure 2 from Modality-Invariant Asymmetric Networks for Cross-Modal ...

Figure 3 from View-invariant Feature using Pose Information and ...

Figure 2 from General Rotation Invariance Learning for Point Clouds via ...

Figure 1 from View-invariant Feature using Pose Information and ...

Figure 1 from Dual-alignment Feature Embedding for Cross-modality ...
Advertisement Space (336x280)

Figure 2 from Reconstruction-Based Disentanglement for Pose-Invariant ...
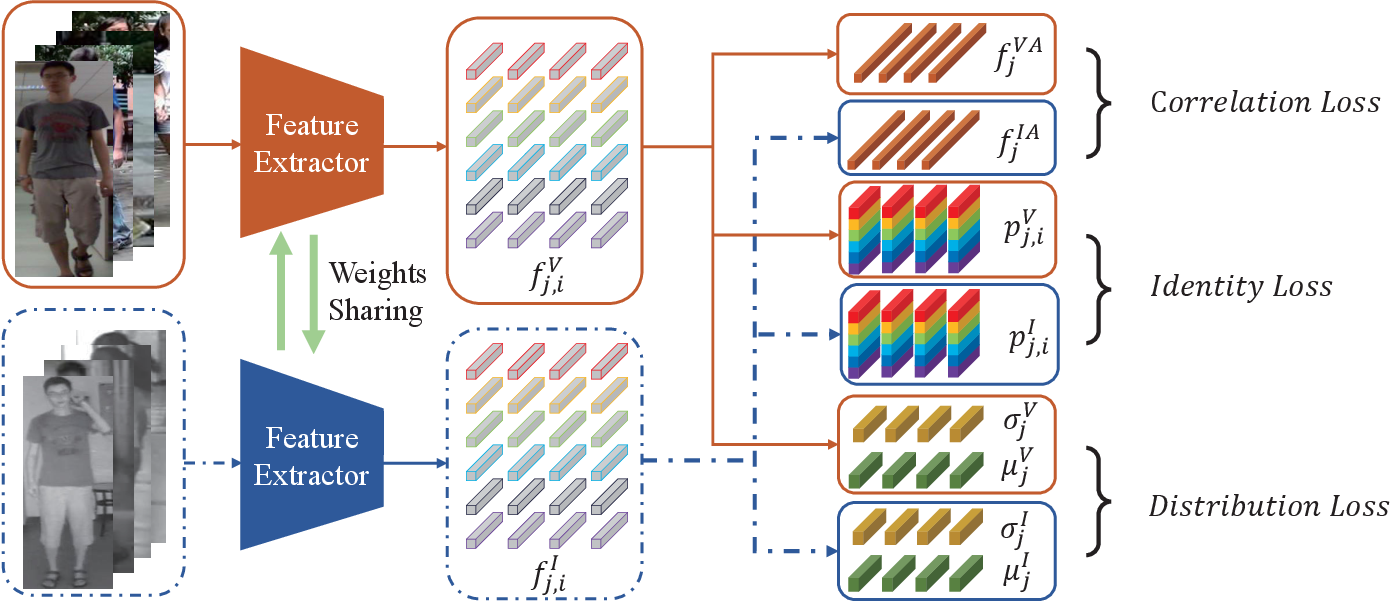
Figure 5 from Dual-alignment Feature Embedding for Cross-modality ...

Figure 1 from Temporal Feature Alignment and Mutual Information ...

Figure 2 from 3D-Guided Frontal Face Generation for Pose-Invariant ...

Figure 1 from Improving Cross-modal Alignment for Text-Guided Image ...

Figure 2 from Modality-invariant and Specific Prompting for Multimodal ...

Figure 1 from Domain-Invariant Feature Alignment Using Variational ...
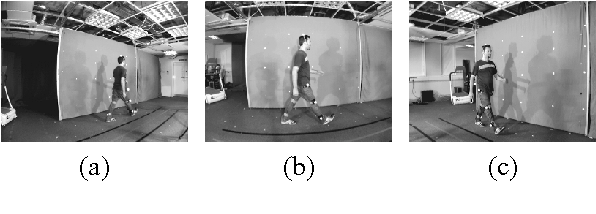
Figure 1 from Towards pose invariant gait reconstruction | Semantic Scholar

Figure 1 from Cross-Modal Cross-Domain Dual Alignment Network for RGB ...

Figure 1.1 from Learning Pose Invariant and Covariant Classifiers from ...
Advertisement Space (336x280)
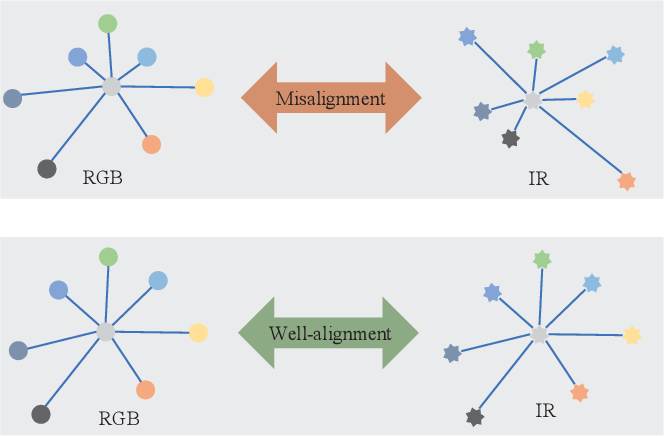
Figure 3 from Dual-alignment Feature Embedding for Cross-modality ...
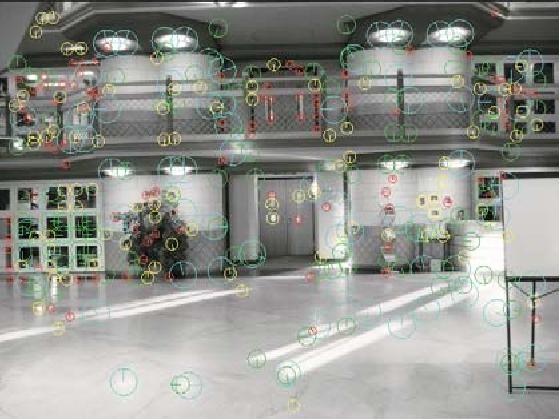
Figure 2 from Image-based Localization and Pose Recovery Using Scale ...

Figure 1 from Learning Invariant Representation via Contrastive Feature ...

Figure 4 from View-invariant Feature using Pose Information and ...

Figure I from Modified curvature scale space feature alignment approach ...

Figure 1 from Modality Invariant Multimodal Learning to Handle Missing ...