
Figure 2 From Refining Attention Maps For Vision Transformer Semantic
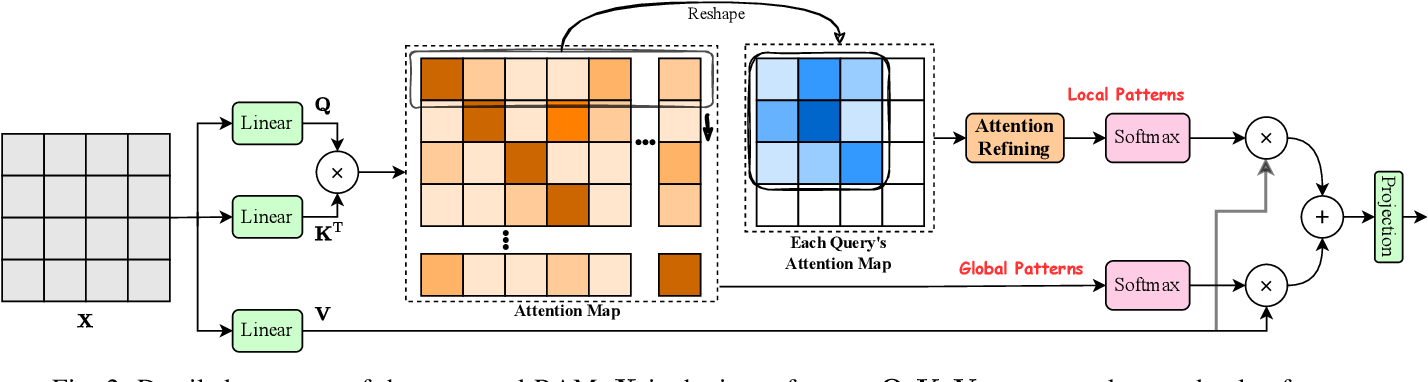
Figure 2 from Refining Attention Maps for Vision Transformer | Semantic ...
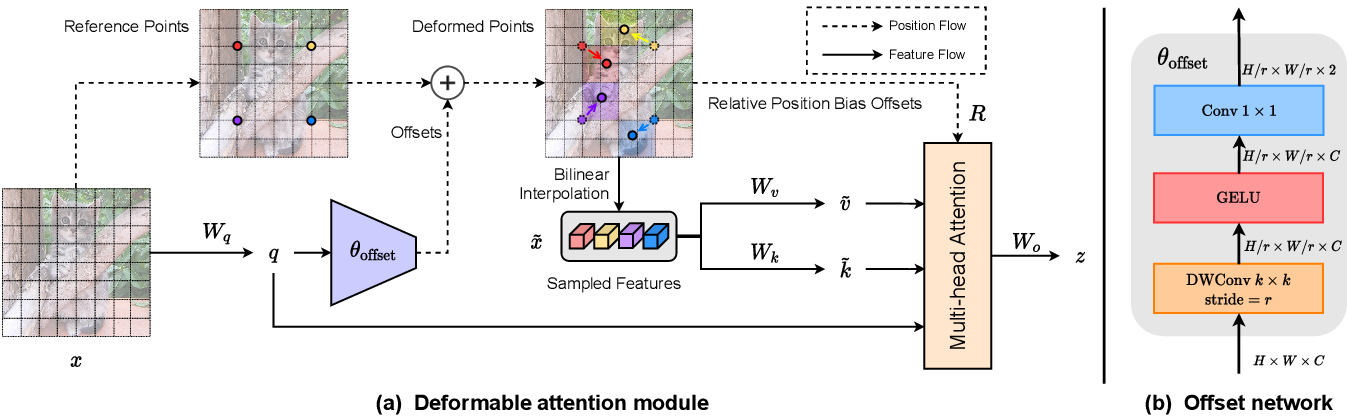
Figure 2 from Vision Transformer with Deformable Attention | Semantic ...

Figure 2 from Robustifying Token Attention for Vision Transformers ...

Figure 2 from Geometric Point Attention Transformer for 3D Shape ...
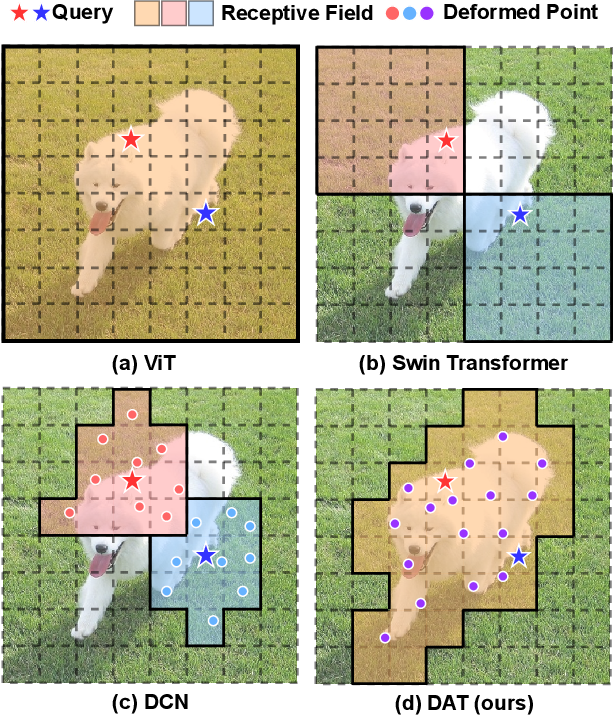
Figure 1 from Vision Transformer with Deformable Attention | Semantic ...
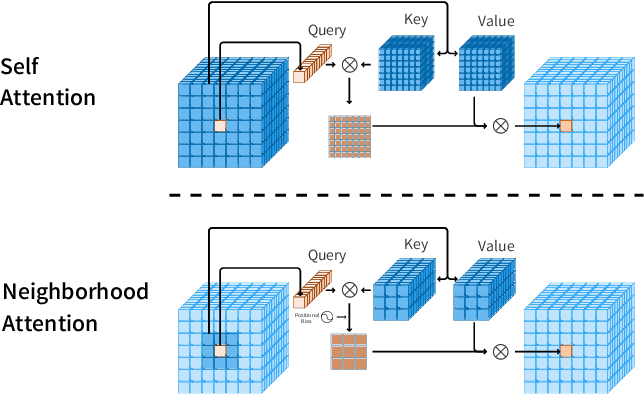
Figure 2 from Neighborhood Attention Transformer | Semantic Scholar
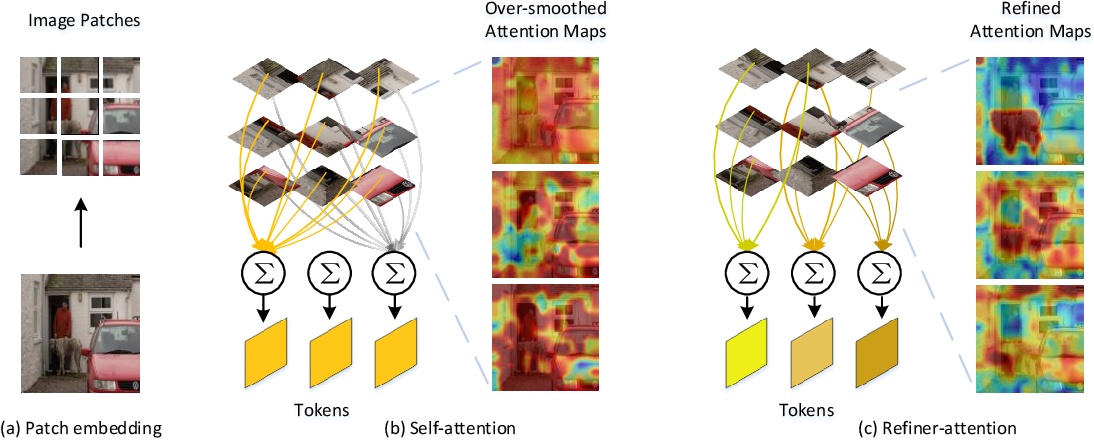
Figure 1 from Refiner: Refining Self-attention for Vision Transformers ...

Figure 2 from Fusion of regional and sparse attention in Vision ...
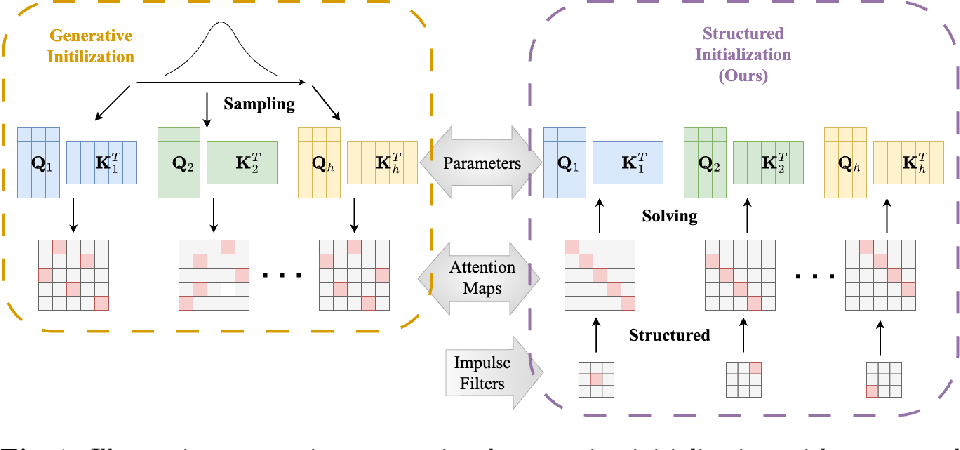
Figure 1 from Structured Initialization for Attention in Vision ...
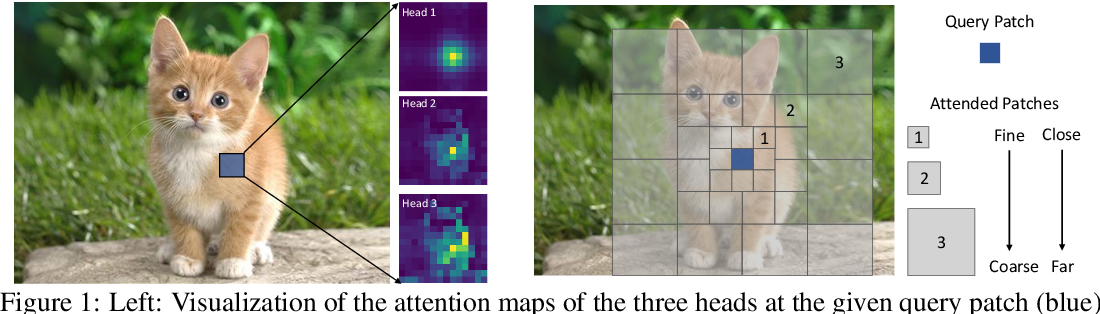
Figure 1 from Focal Attention for Long-Range Interactions in Vision ...
Advertisement Space (300x250)

Figure 1 from Multi-Manifold Attention for Vision Transformers ...
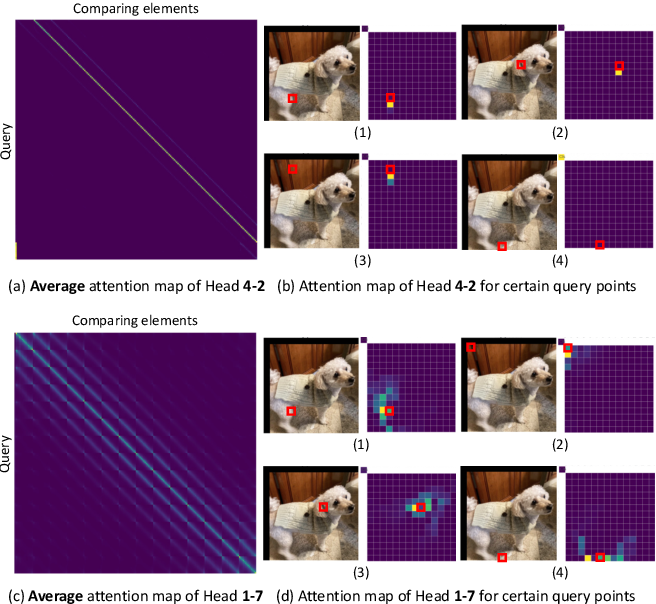
Figure 2 from Rethinking the Self-Attention in Vision Transformers ...

Figure 1 from Transformer Interpretability Beyond Attention ...
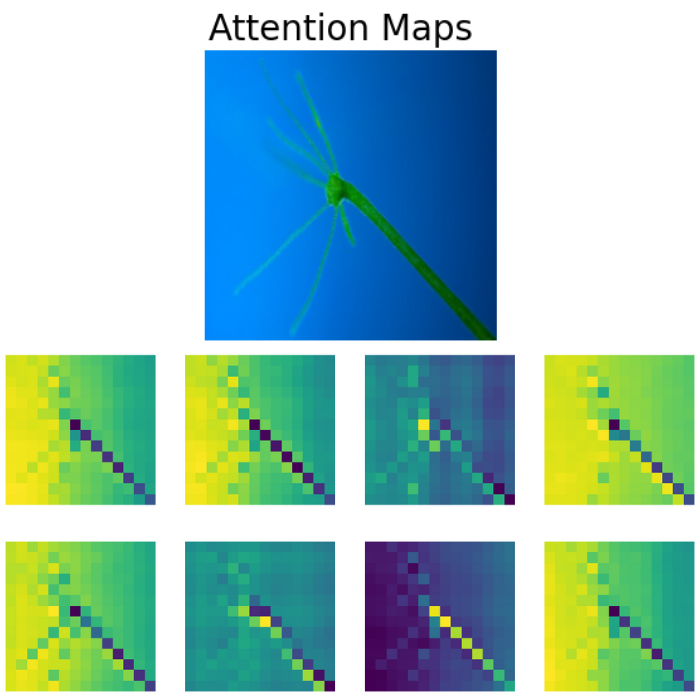
Fine Tuning Vision Transformer and Visualizing Attention Maps
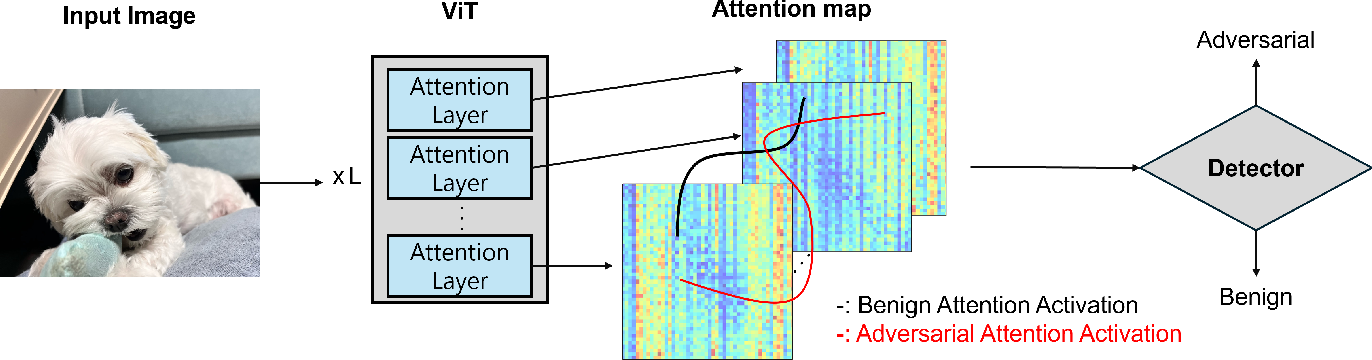
Figure 1 from Adversarial Image Detection for Vision Transformers via ...
Fine Tuning Vision Transformer and Visualizing Attention Maps

Figure 2 from Visualizing Attention in Transformer-Based Language ...

Paper page - Inherently Faithful Attention Maps for Vision Transformers

Figure 1 from Semantic-Aligned Attention With Refining Feature ...

Attention maps of a few samples that vision transformer Succeeded ...
Advertisement Space (336x280)

Paper page - Inherently Faithful Attention Maps for Vision Transformers

Figure 2 from DIAMANT: Dual Image-Attention Map Encoders For Medical ...

Figure 1 from Multi-Scale Hybrid Attention Integrated with Vision ...

Attention maps of a few samples that vision transformer Succeeded ...
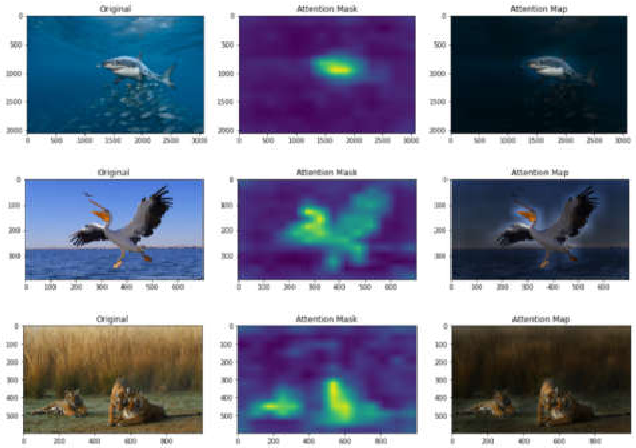
Figure 2 from Vision Transformers: A Review of Architecture ...

Figure 1 from Human attribute recognition by refining attention heat ...
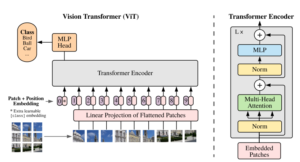
Fine Tuning Vision Transformer and Visualizing Attention Maps

Refiner: Refining Self-attention for Vision Transformers

Visualization for feature maps in the vision transformer. We show the ...
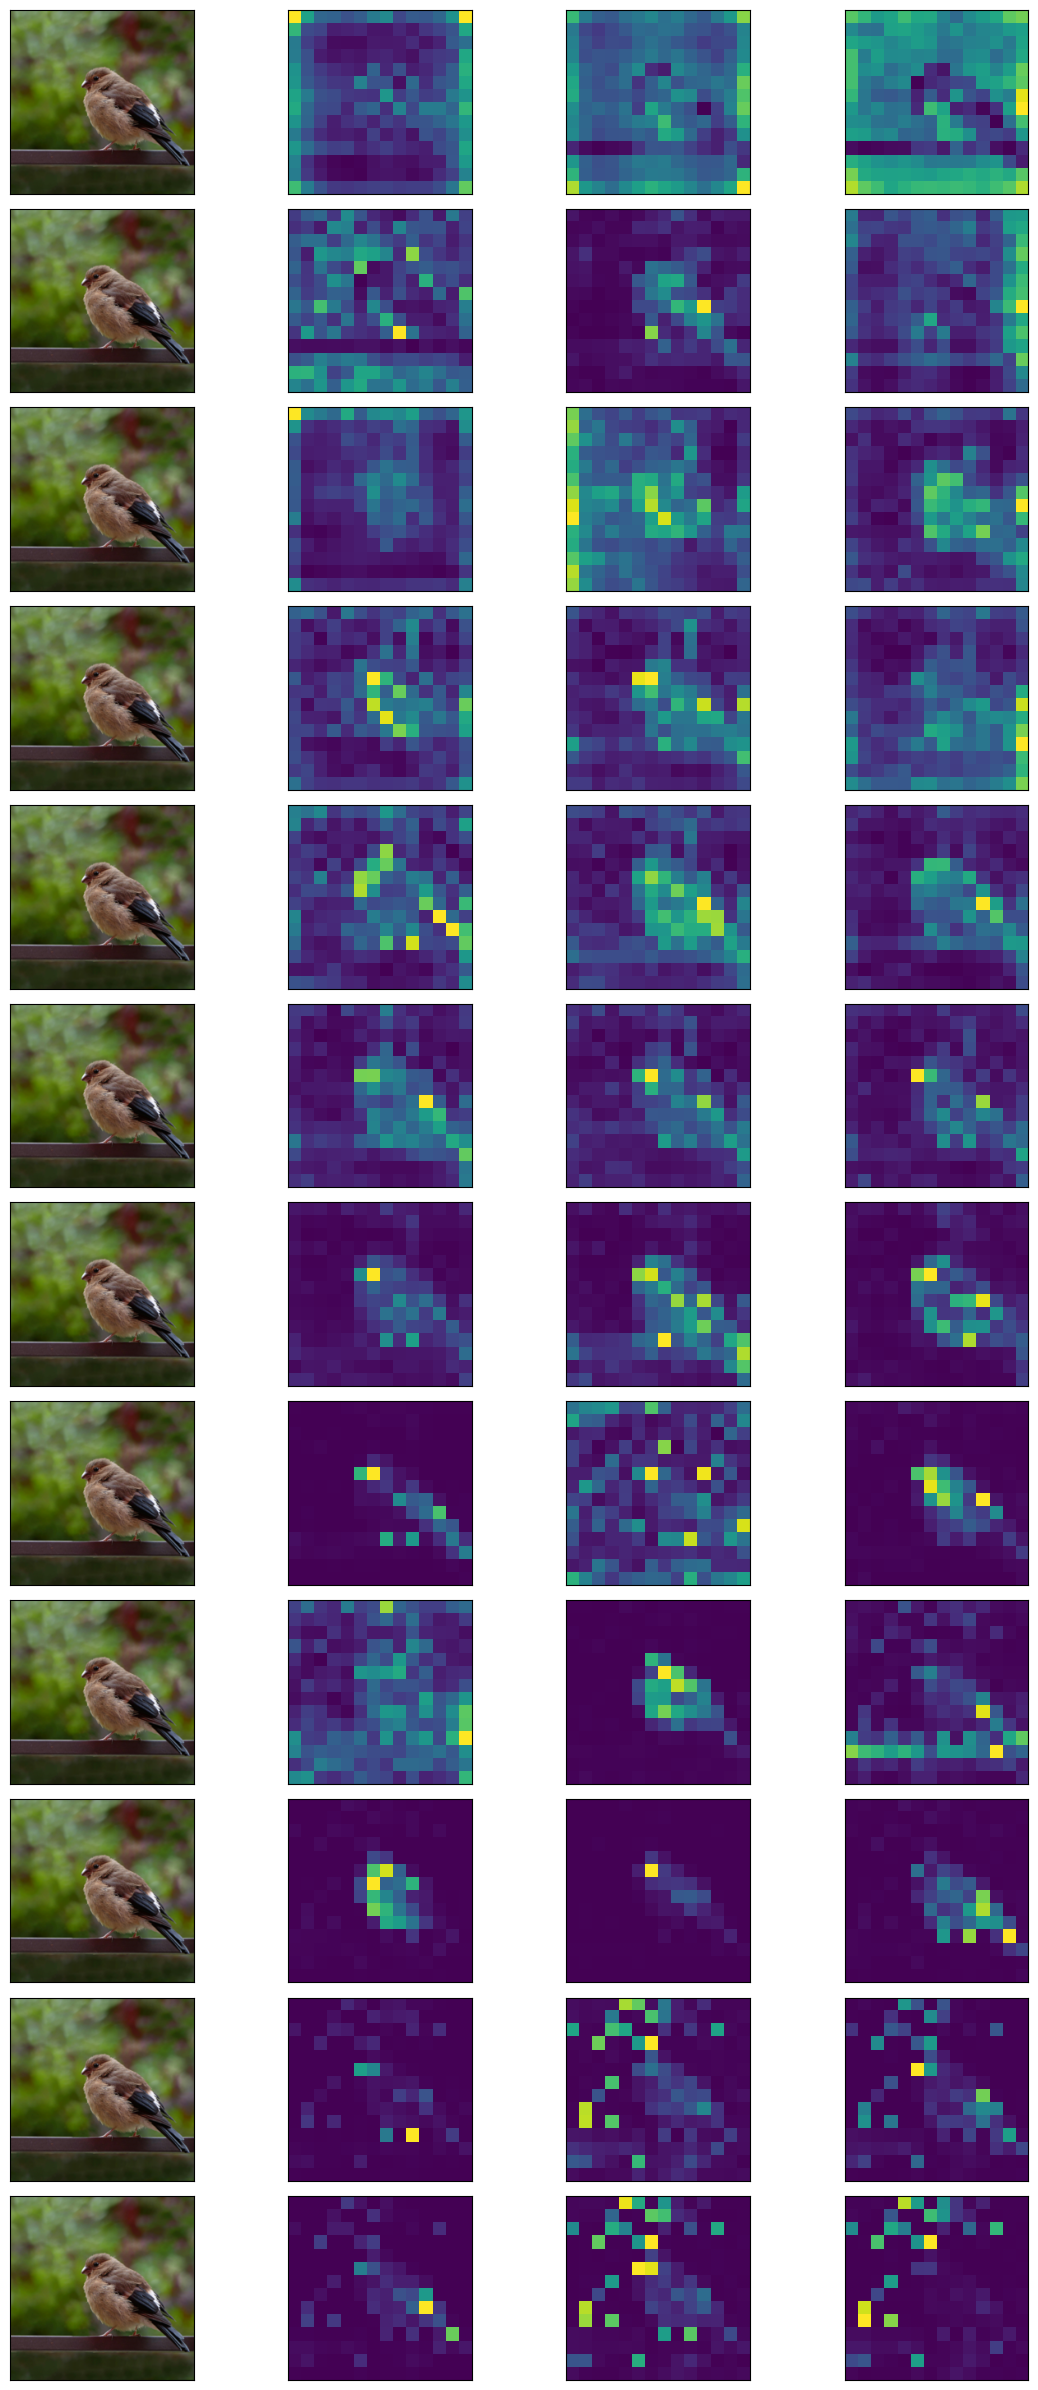
Visualizing Attention Maps in Pre-trained Vision Transformers (Pytorch ...
Advertisement Space (336x280)
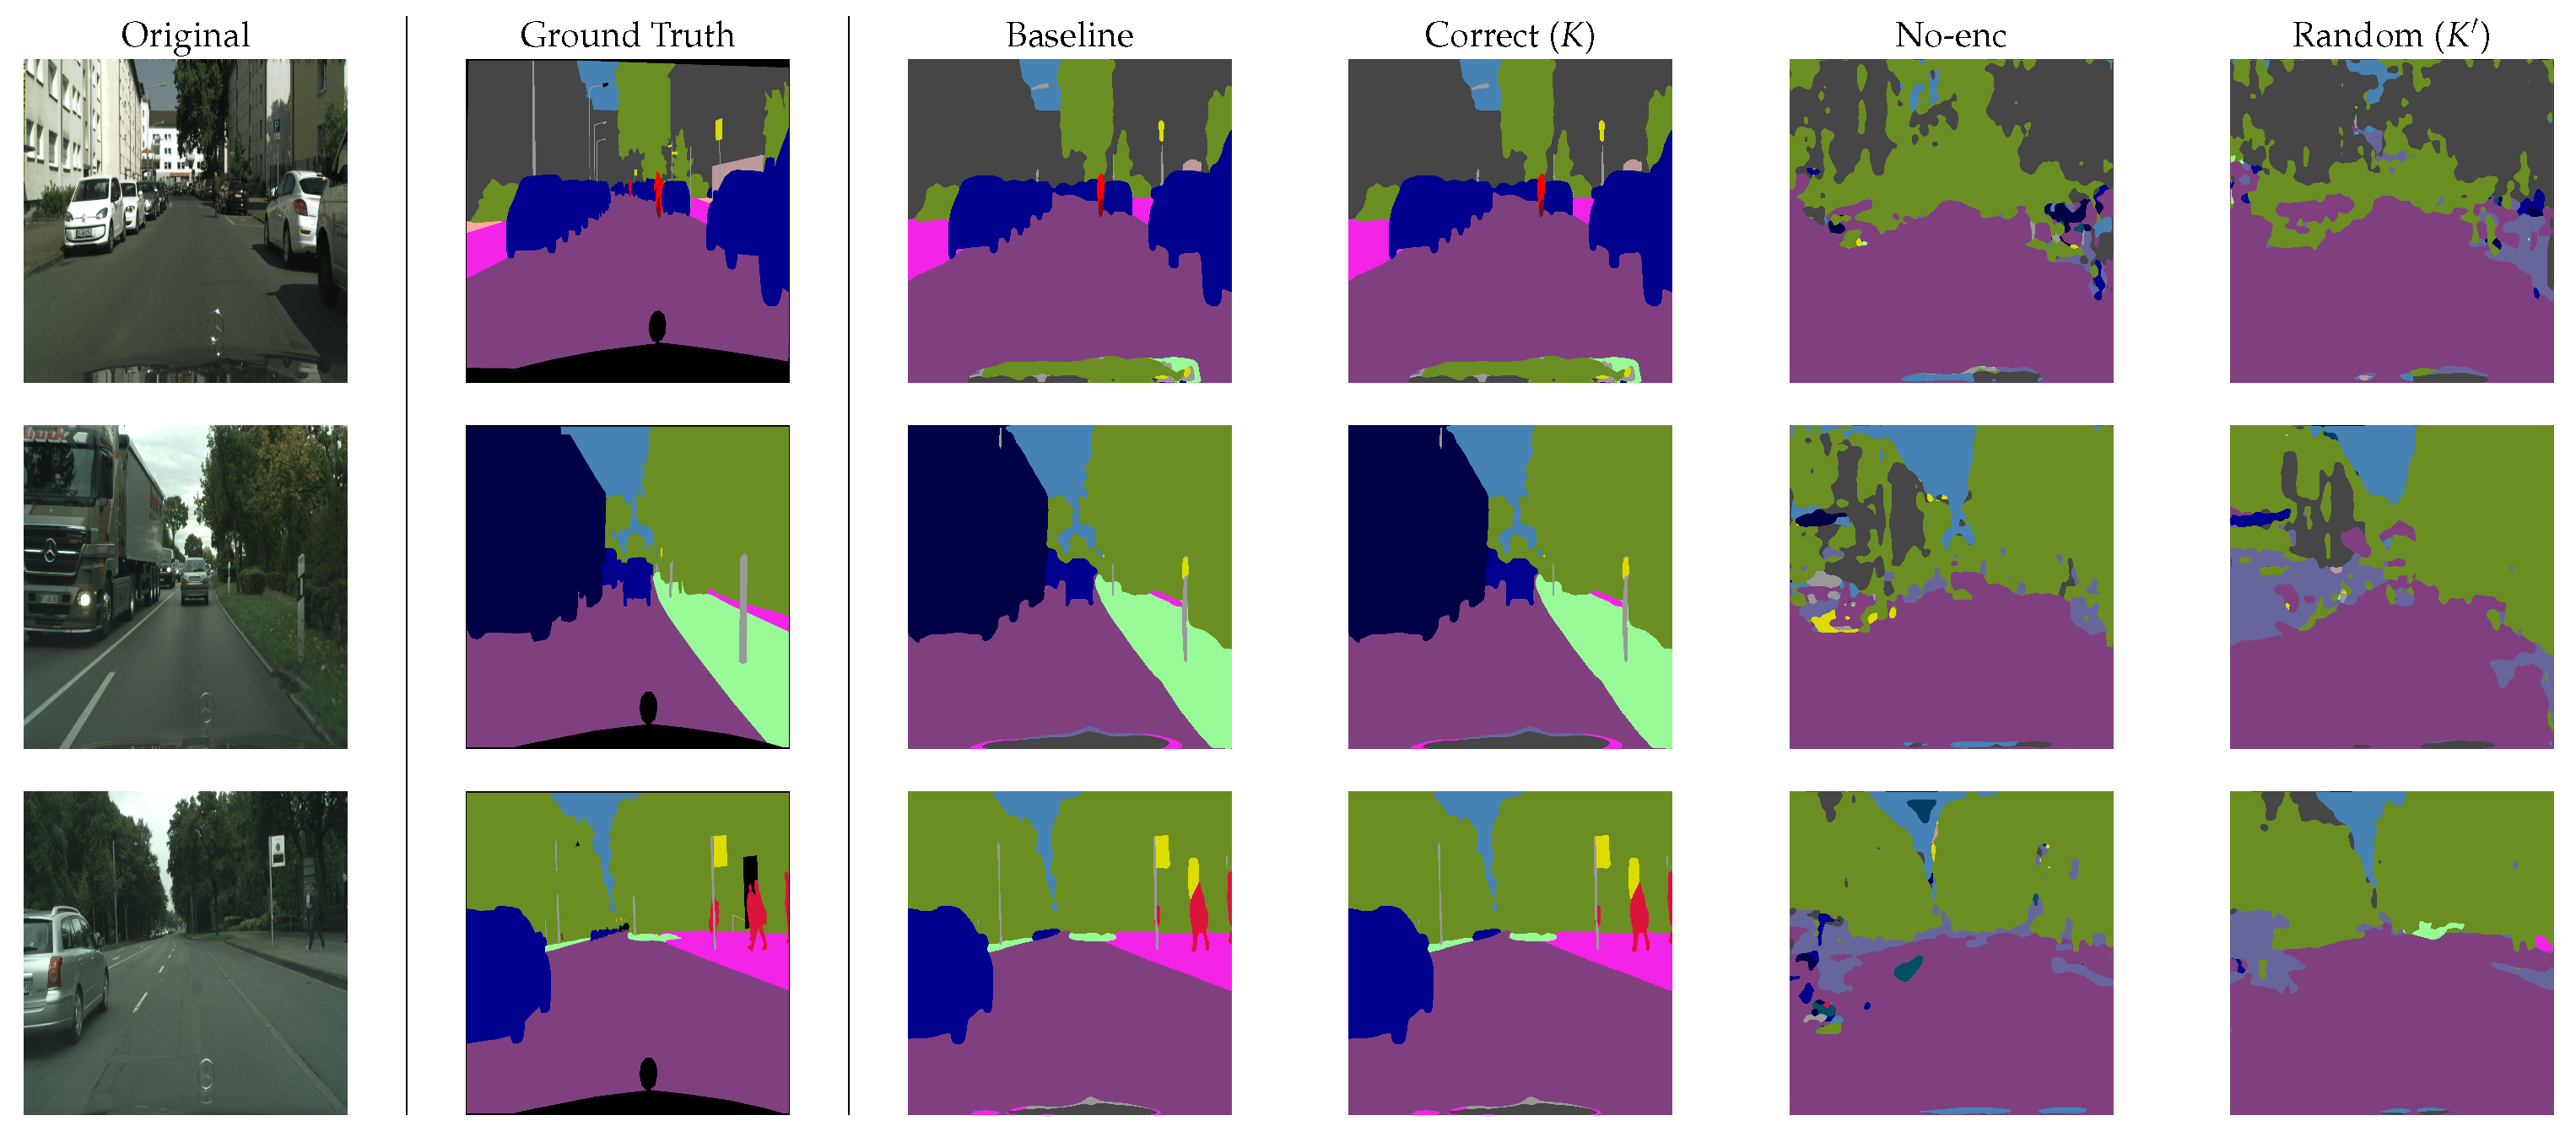
Privacy-Preserving Semantic Segmentation Using Vision Transformer
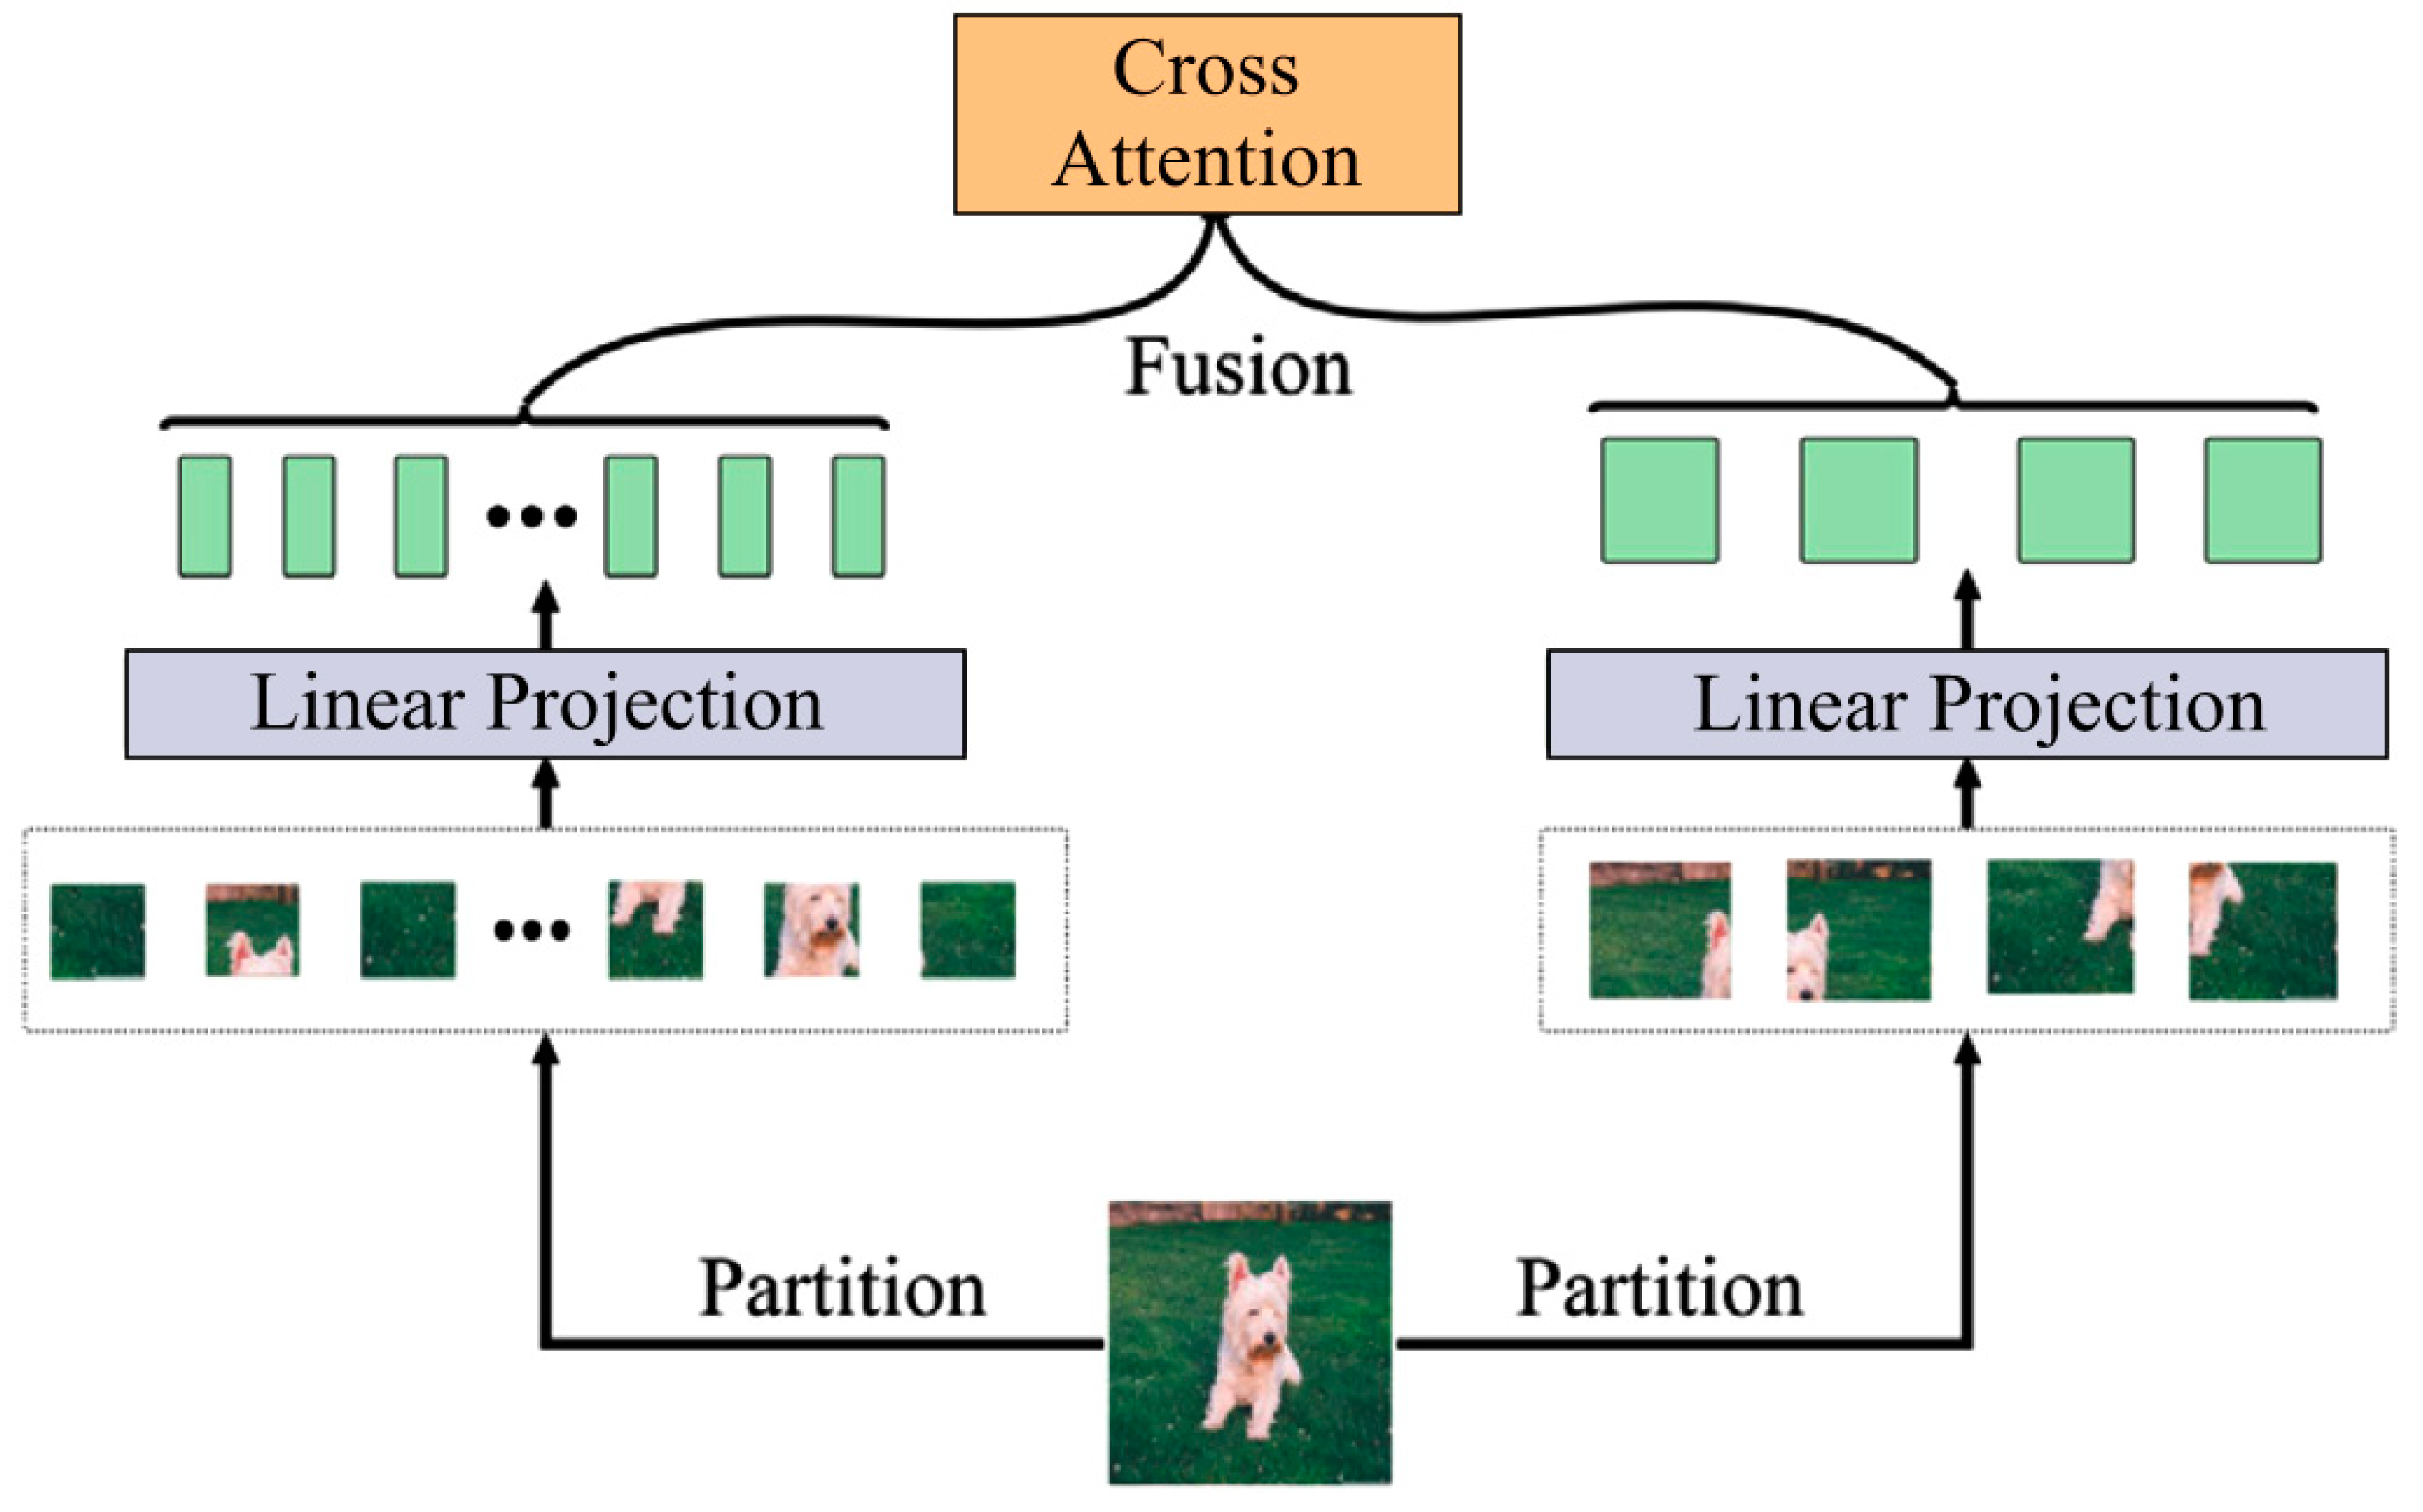
Comparative Analysis of Vision Transformer Models for Facial Emotion ...
A visualization of the attention maps based on each transformer head ...

MapNav: A Novel Memory Representation via Annotated Semantic Maps for ...
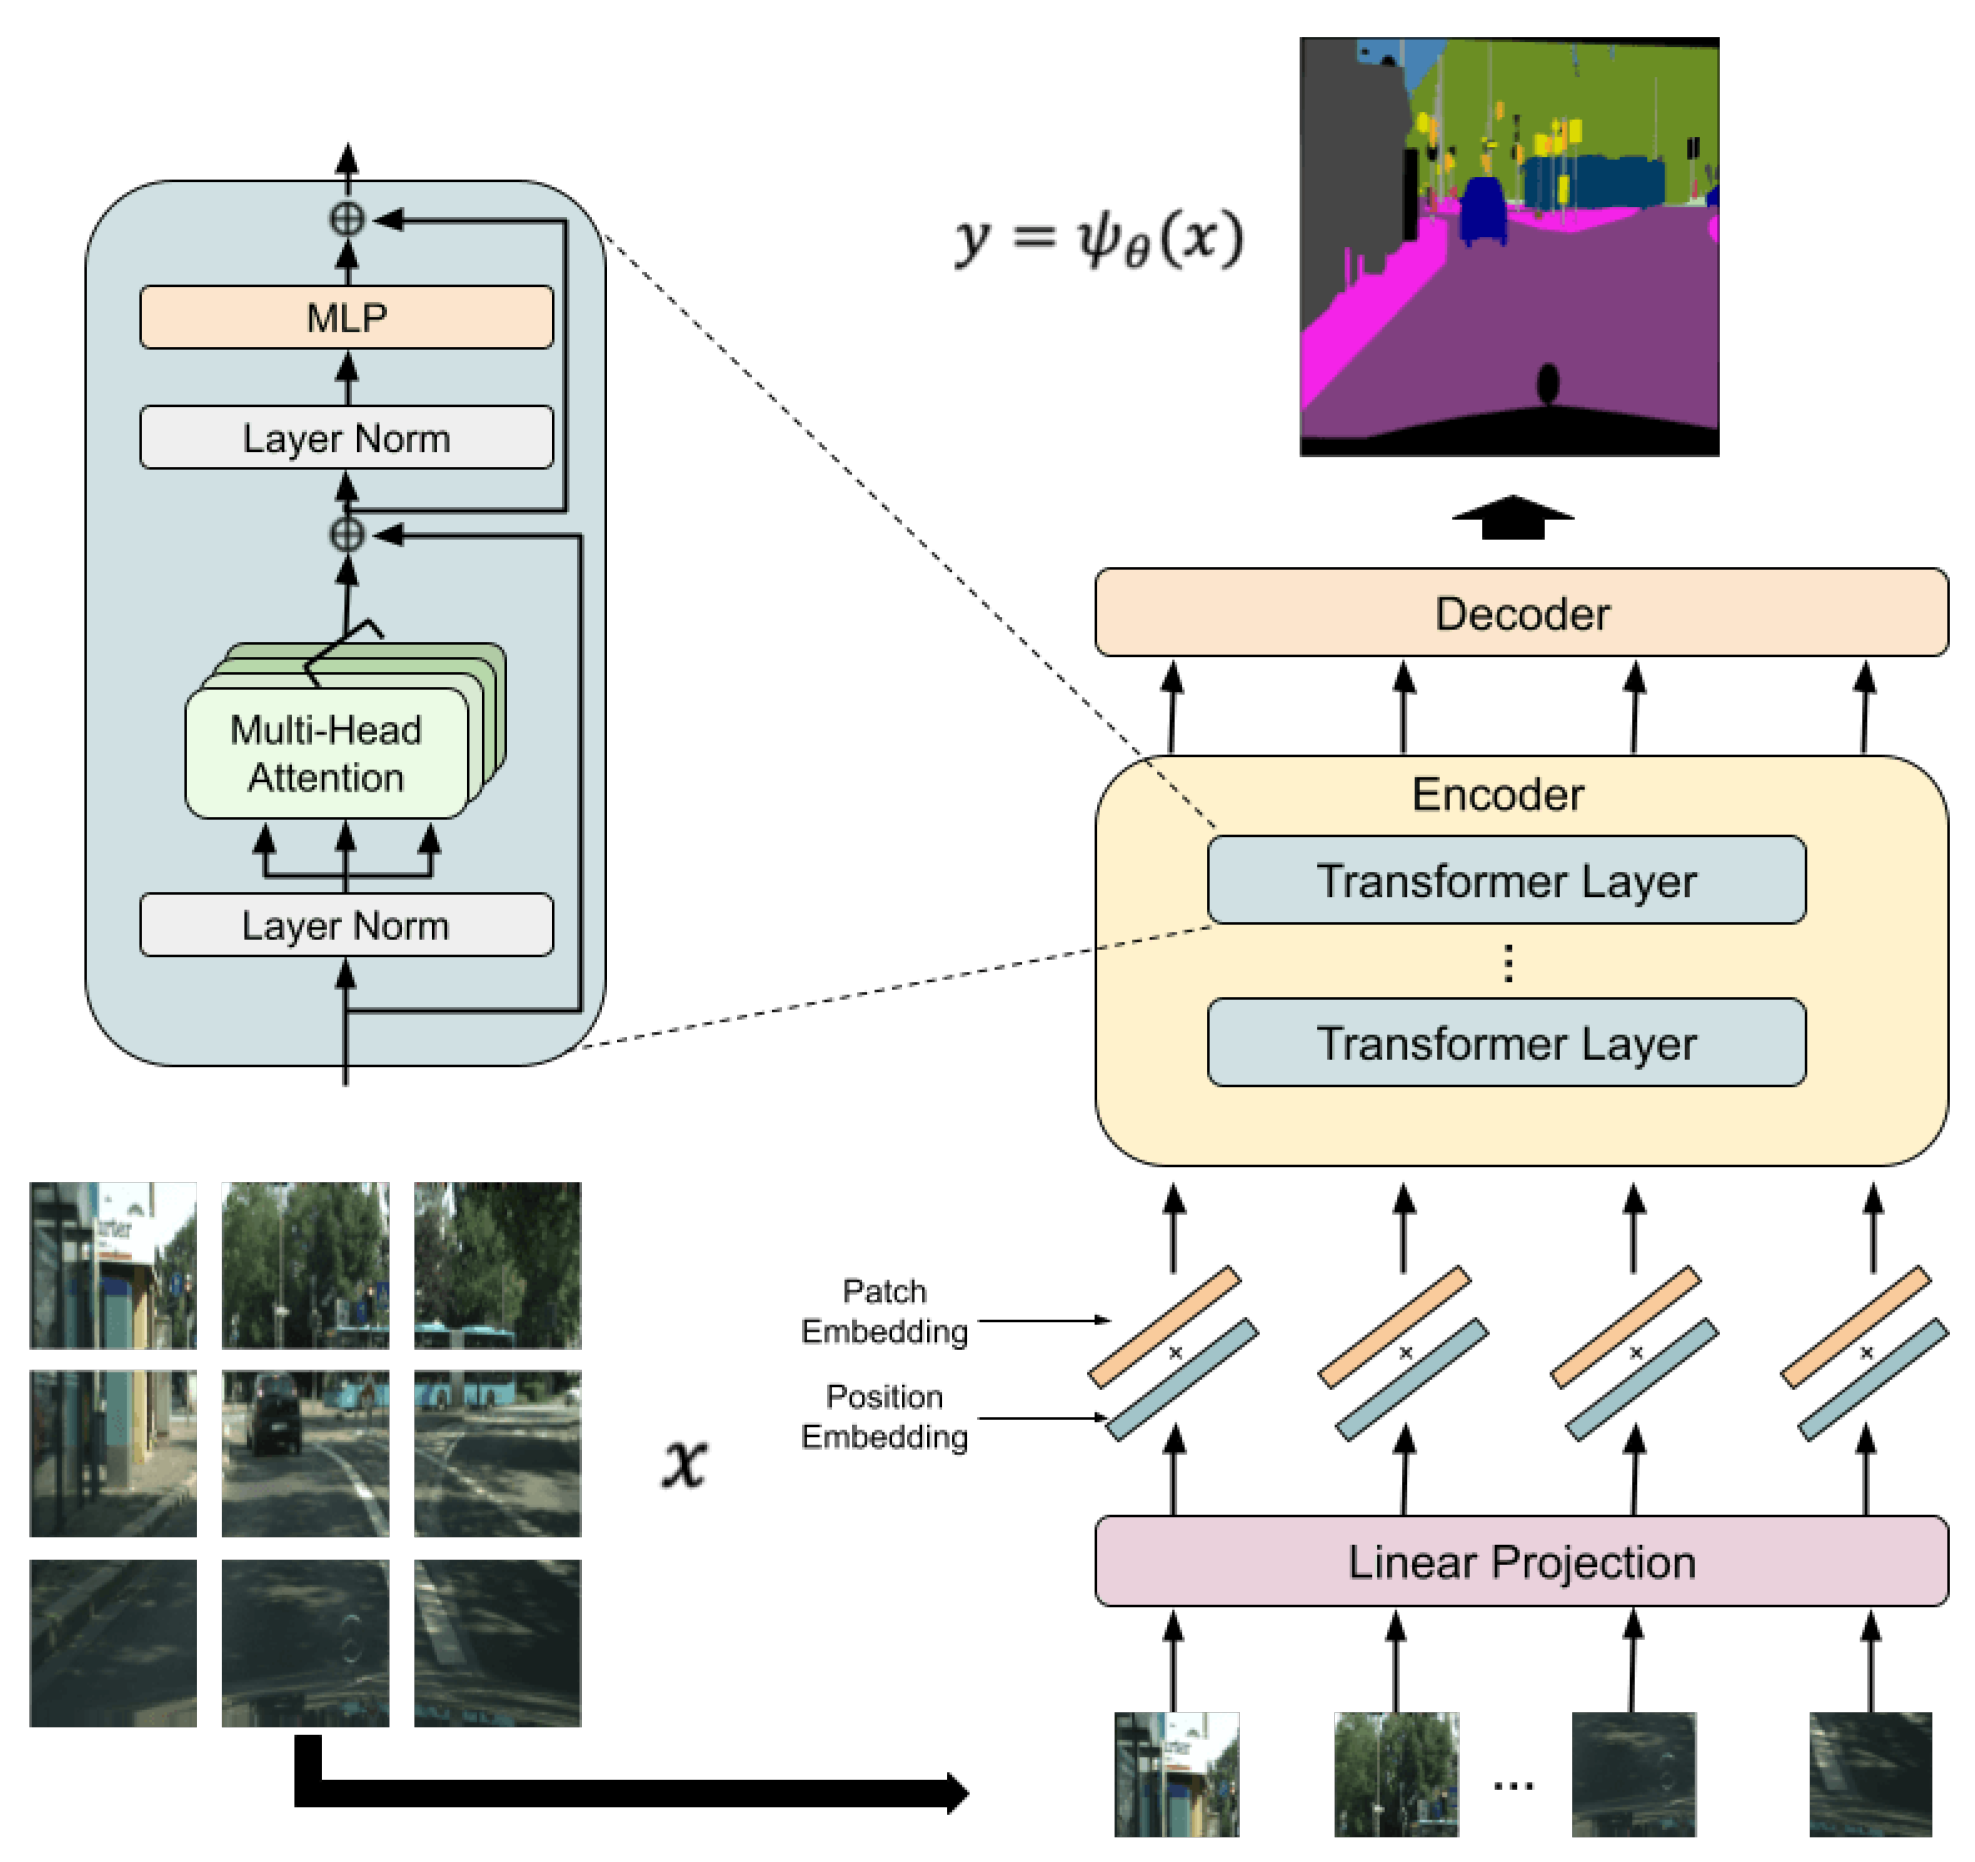
Privacy-Preserving Semantic Segmentation Using Vision Transformer

[2103.14862] TS-CAM: Token Semantic Coupled Attention Map for Weakly ...