
Figure 2 From Robustifying Token Attention For Vision Transformers

Figure 2 from Robustifying Token Attention for Vision Transformers ...
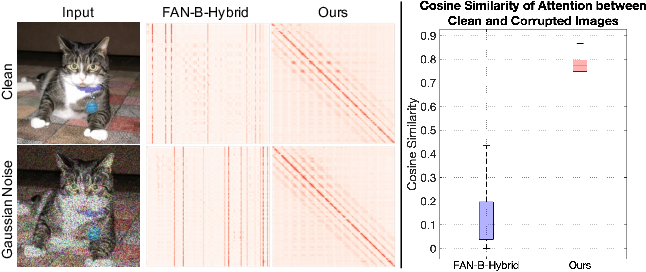
Figure 1 from Robustifying Token Attention for Vision Transformers ...

Figure 1 from Token Pooling in Vision Transformers for Image ...

[2303.11126] Robustifying Token Attention for Vision Transformers

[2303.11126] Robustifying Token Attention for Vision Transformers

Robustifying Token Attention for Vision Transformers - YouTube
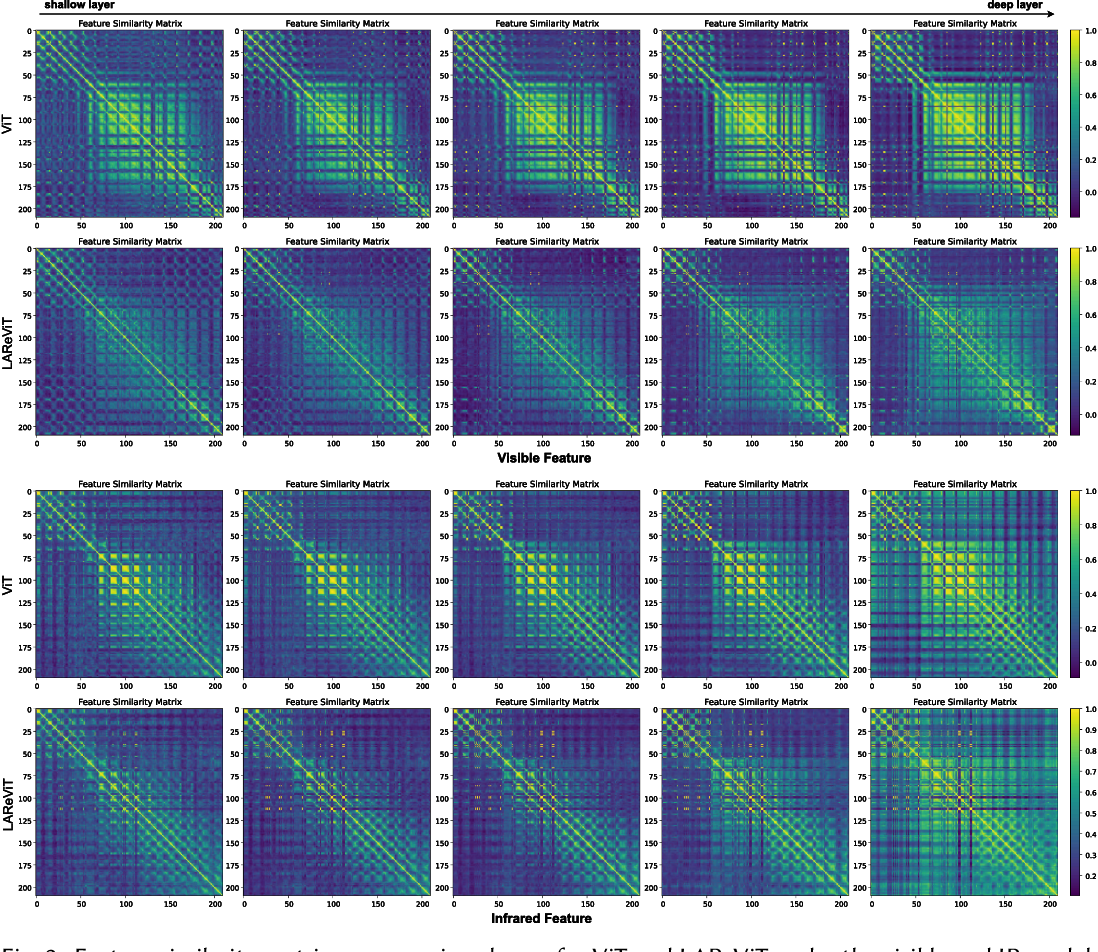
Figure 2 from Local-Aware Residual Attention Vision Transformer for ...
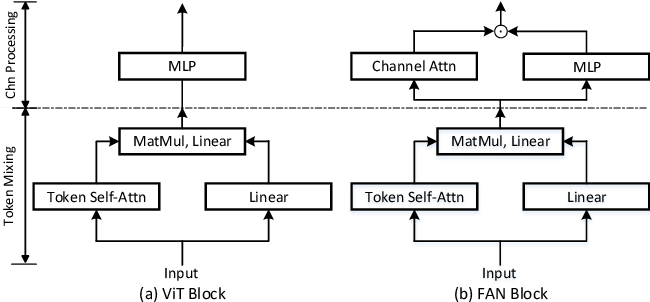
Figure 2 from Understanding The Robustness in Vision Transformers ...
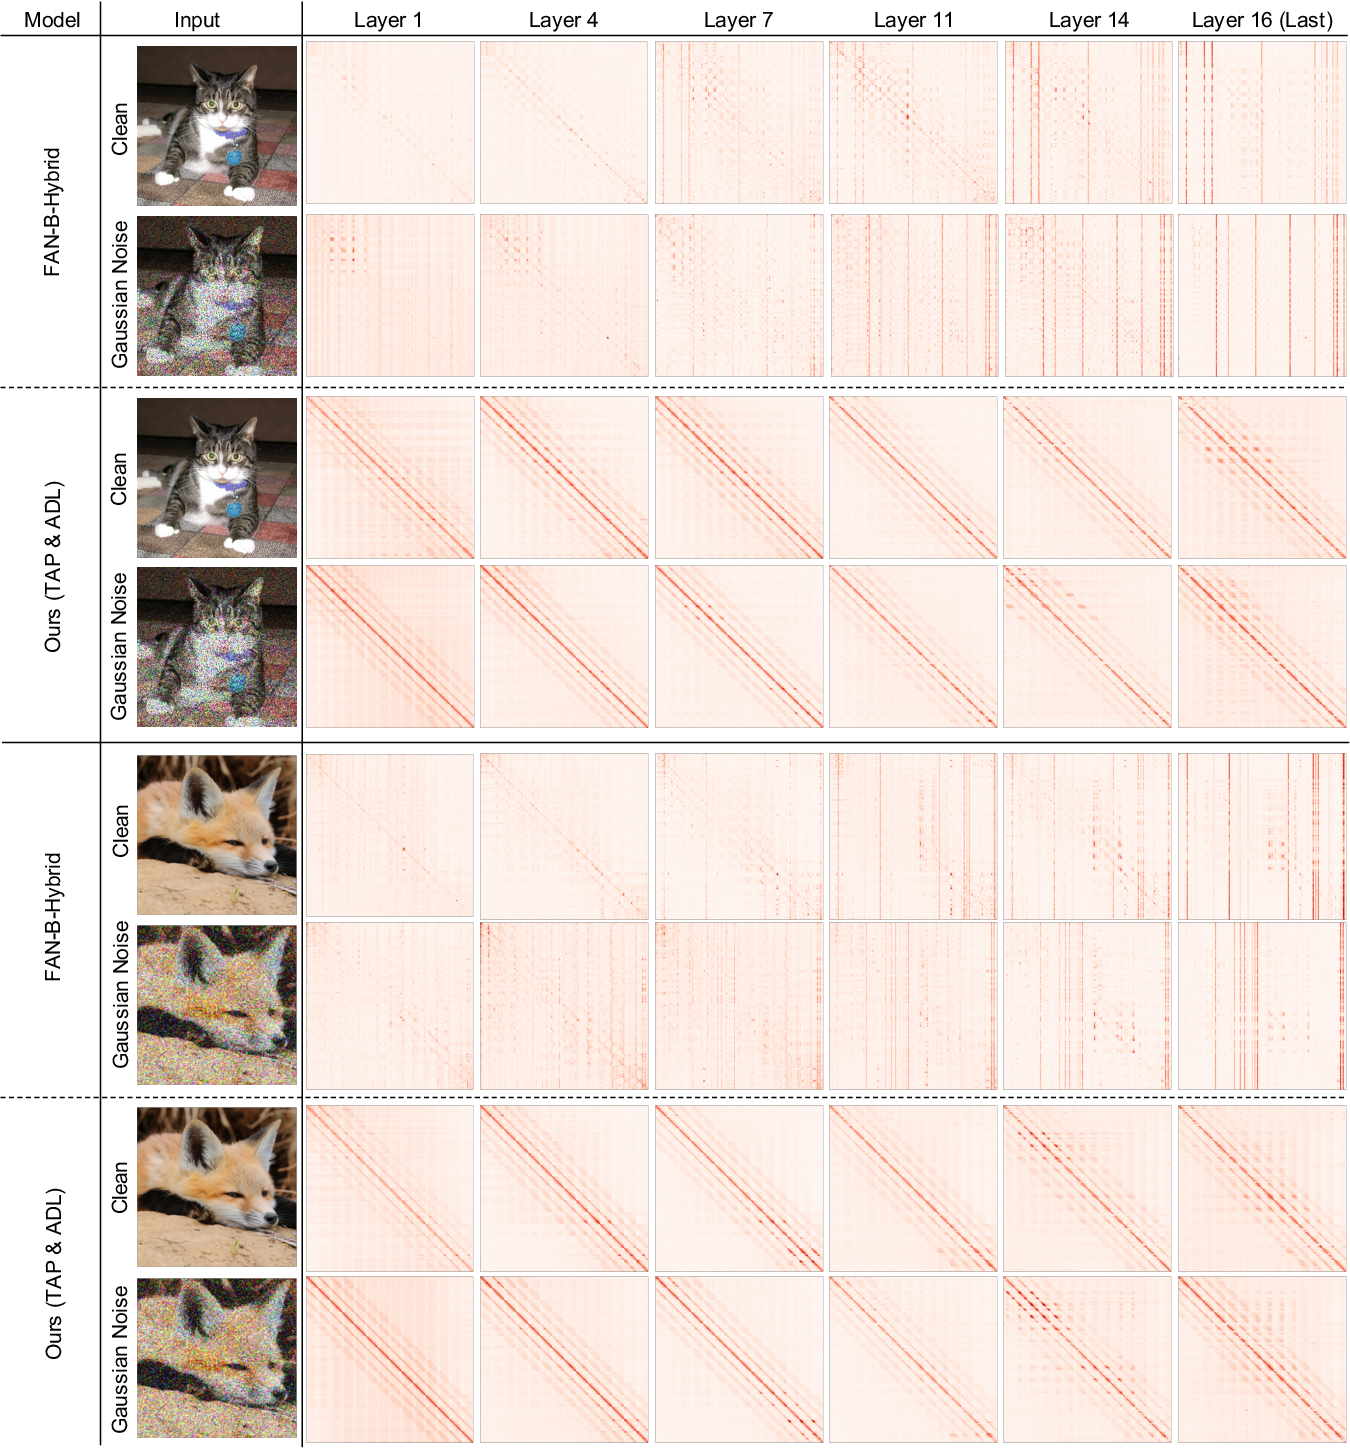
Figure I from Supplementary Materials for “Robustifying Token Attention ...
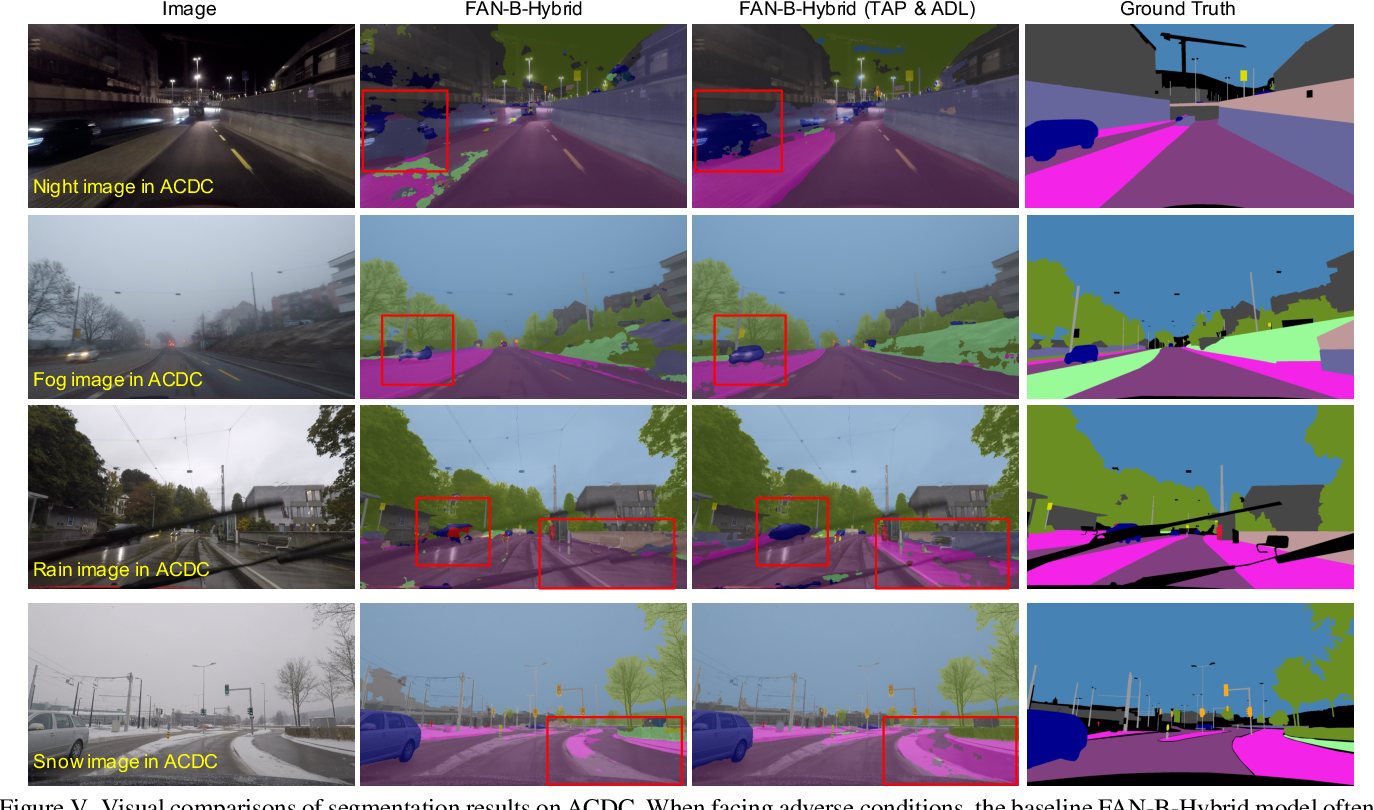
Figure V from Supplementary Materials for “Robustifying Token Attention ...
Advertisement Space (300x250)

Figure 2 from Learning to Mask and Permute Visual Tokens for Vision ...

Figure 1 from PPT: Token Pruning and Pooling for Efficient Vision ...
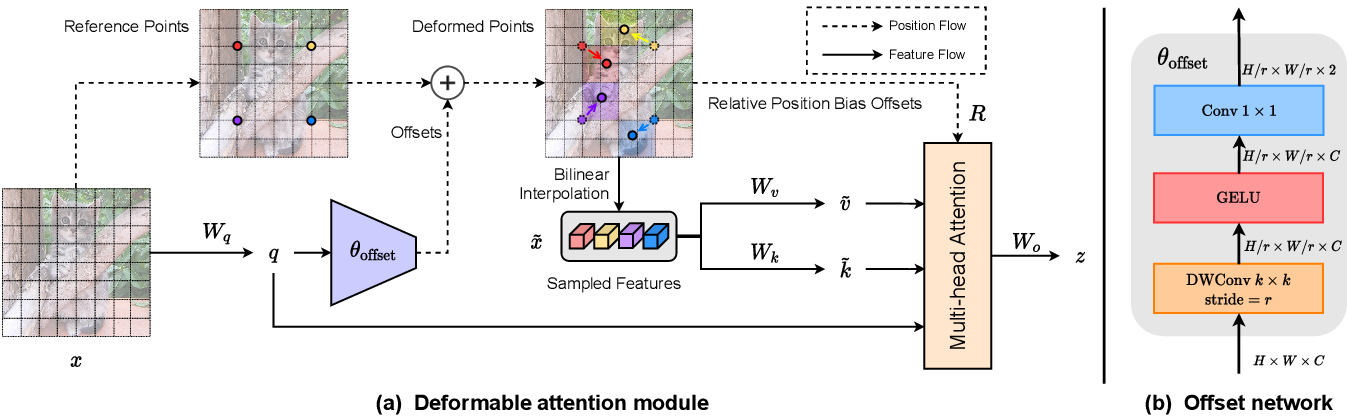
Figure 2 from Vision Transformer with Deformable Attention | Semantic ...
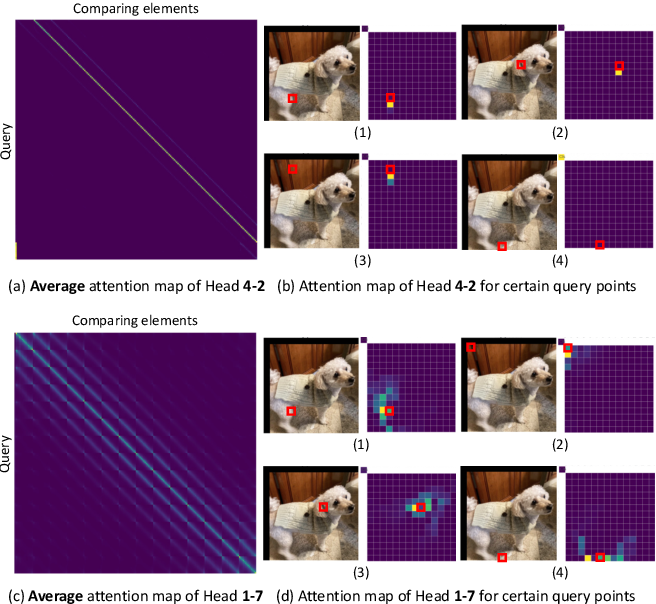
Figure 2 from Rethinking the Self-Attention in Vision Transformers ...
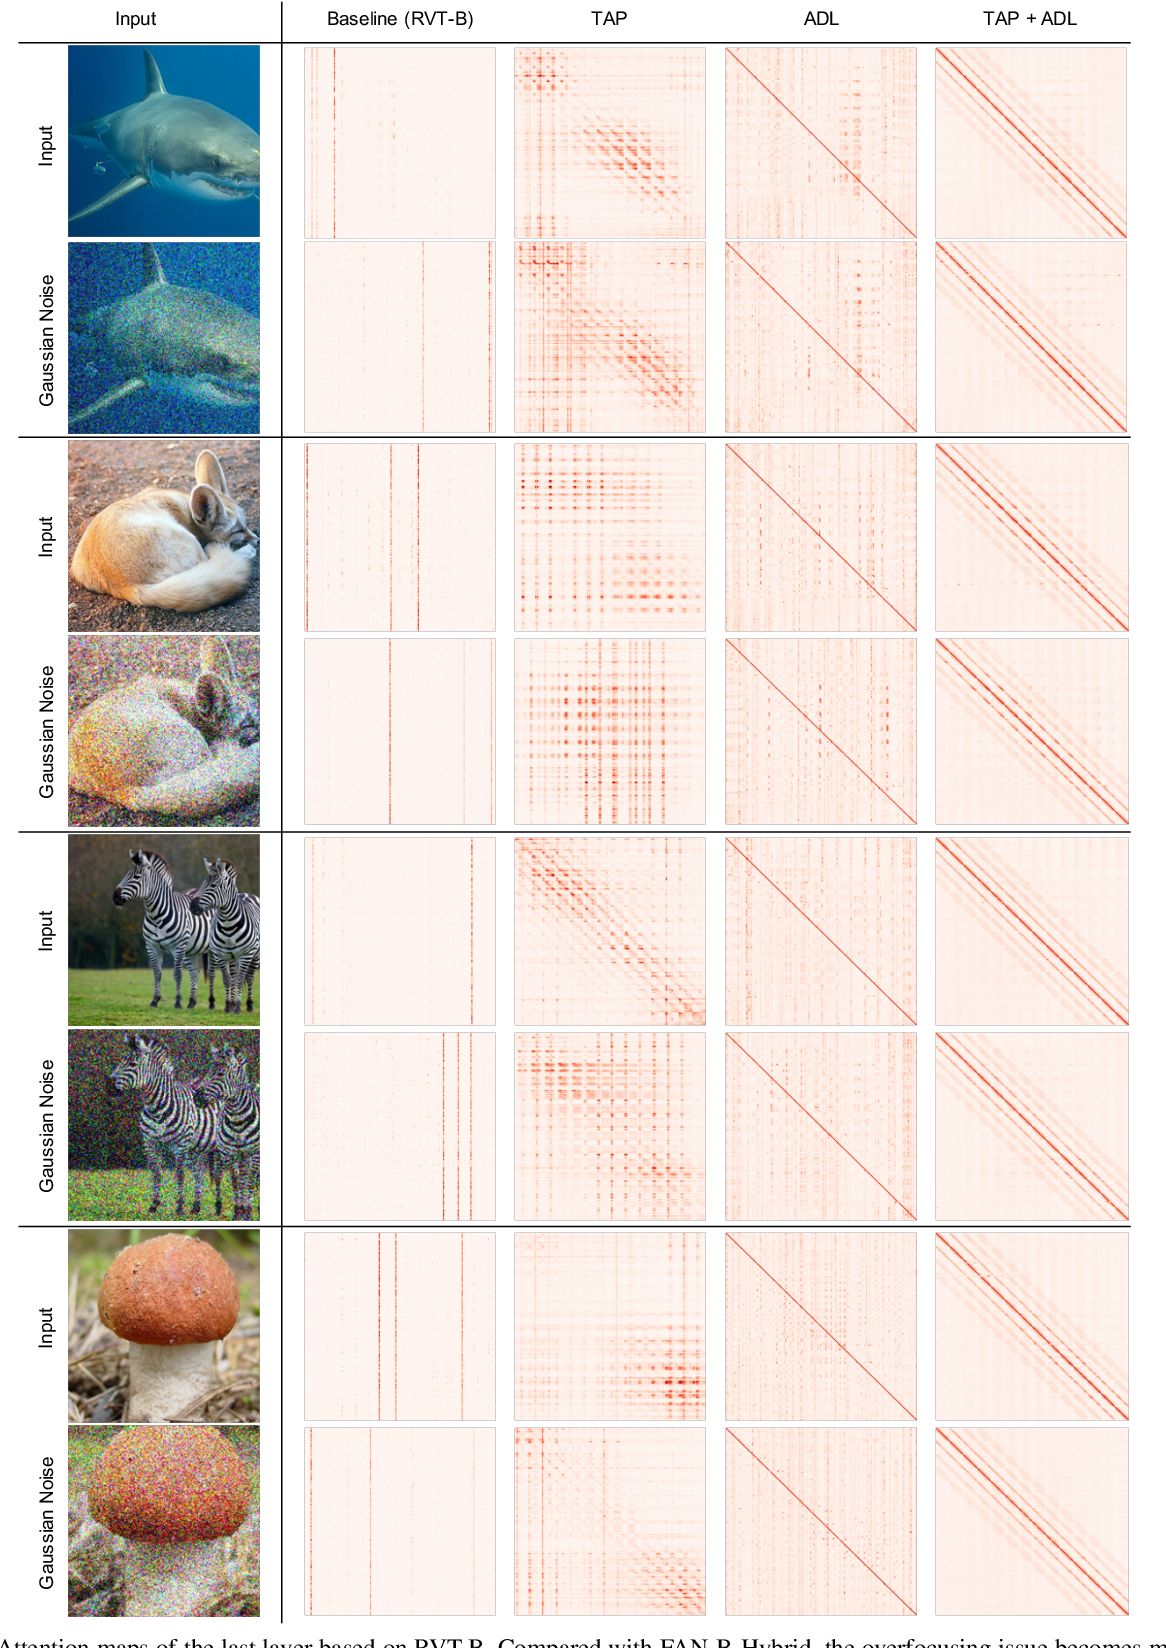
Figure II from Supplementary Materials for “Robustifying Token ...

CVPR2023 Making Vision Transformers Efficient from A Token ...

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

Figure 2 from Vision Transformer Interpretability via Prediction of ...

CVPR2023 Making Vision Transformers Efficient from A Token ...

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客
Advertisement Space (336x280)
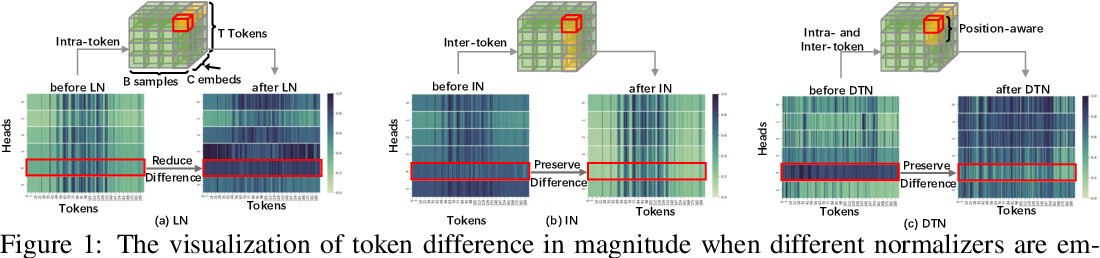
Figure 1 from Dynamic Token Normalization Improves Vision Transformer ...

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客
Hybrid lightweight vision transformers with attention mechanism for ...

Table I from Supplementary Materials for “Robustifying Token Attention ...

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...

【ICCV2023】Robustifying Token Attention for Vision Transformers-CSDN博客
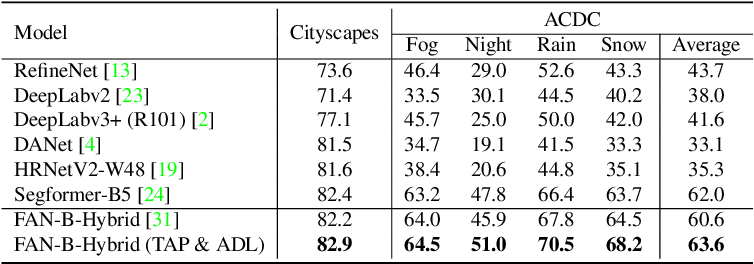
Table V from Supplementary Materials for “Robustifying Token Attention ...
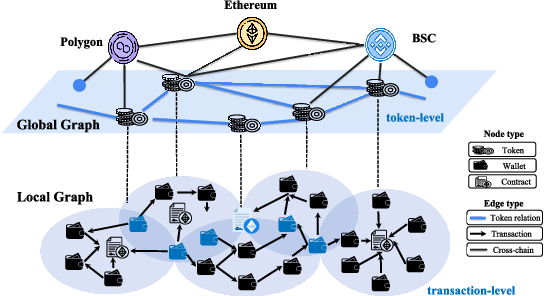
Figure 1 from TG-Transformer: A Graph Transformer for Token Transaction ...

Learning Correlation Structures for Vision Transformers | AI Research ...
Advertisement Space (336x280)
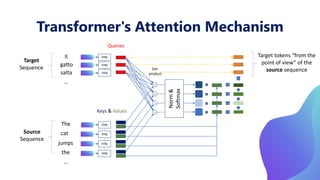
Transformers In Vision From Zero to Hero (DLI).pptx
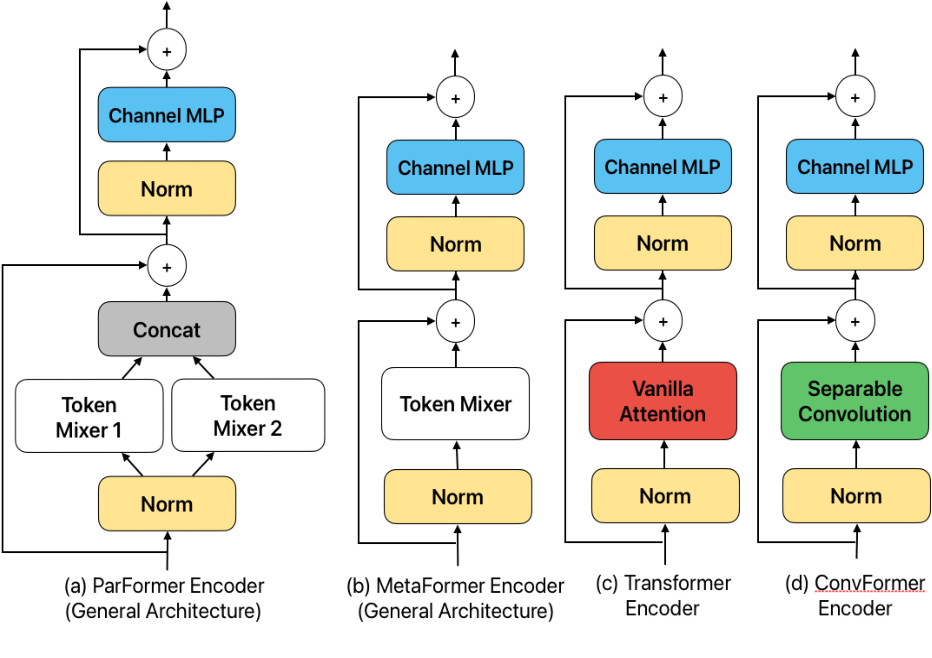
Figure 1 from ParFormer: Vision Transformer Baseline with Parallel ...

DaViT: Dual Attention Vision Transformers - 知乎
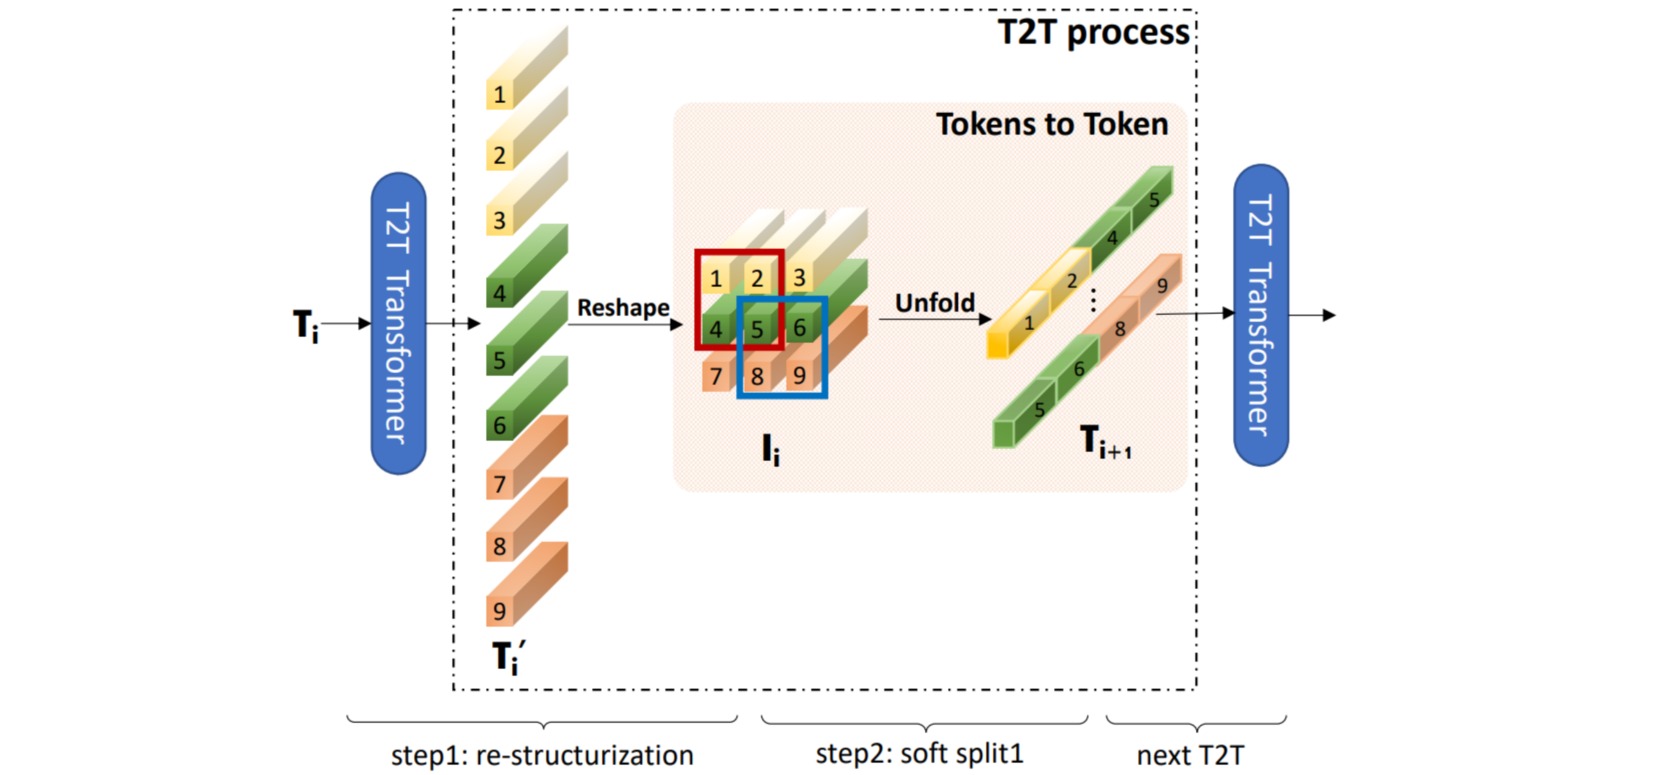
Tokens-to-Token ViT: Training Vision Transformers from Scratch on ...

Rethinking Attention Mechanisms in Vision Transformers with Graph ...

[论文评述] Efficient Token Compression for Vision Transformer with Spatial ...