
Figure 2 From Semantics Enriched Cross Modal Alignment For Complex

Figure 2 from Semantics-Enriched Cross-Modal Alignment for Complex ...

Figure 1 from Semantic Maximum Relevance and Modal Alignment for Cross ...

Figure 2 from Cross-Modal Semantic Alignment before Fusion for Two-Pass ...
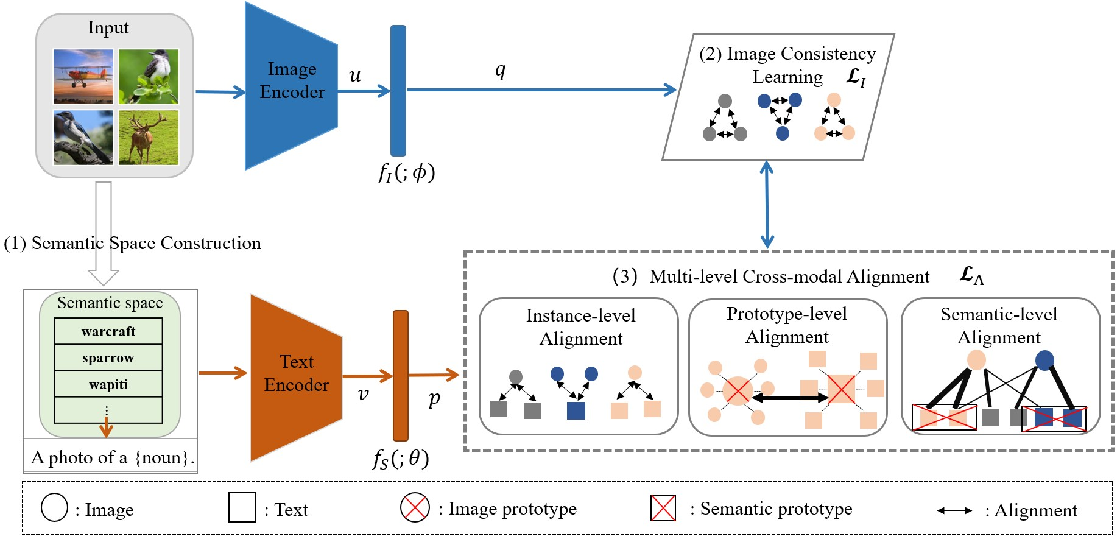
Figure 2 from Multi-level Cross-modal Alignment for Image Clustering ...

Figure 2 from Uncertainty-Aware Cross-Modal Alignment for Hate Speech ...

Figure 2 from CMFAN: Cross-Modal Feature Alignment Network for Few-Shot ...

Figure 2 from A Cross-Modal Alignment for Zero-Shot Image ...

Figure 2 from Discrete Joint Semantic Alignment Hashing for Cross-Modal ...

Figure 2 from Interpretable Cross-Modal Alignment Network for EEG ...

Figure 2 from Multi-Prompts Learning with Cross-Modal Alignment for ...
Advertisement Space (300x250)
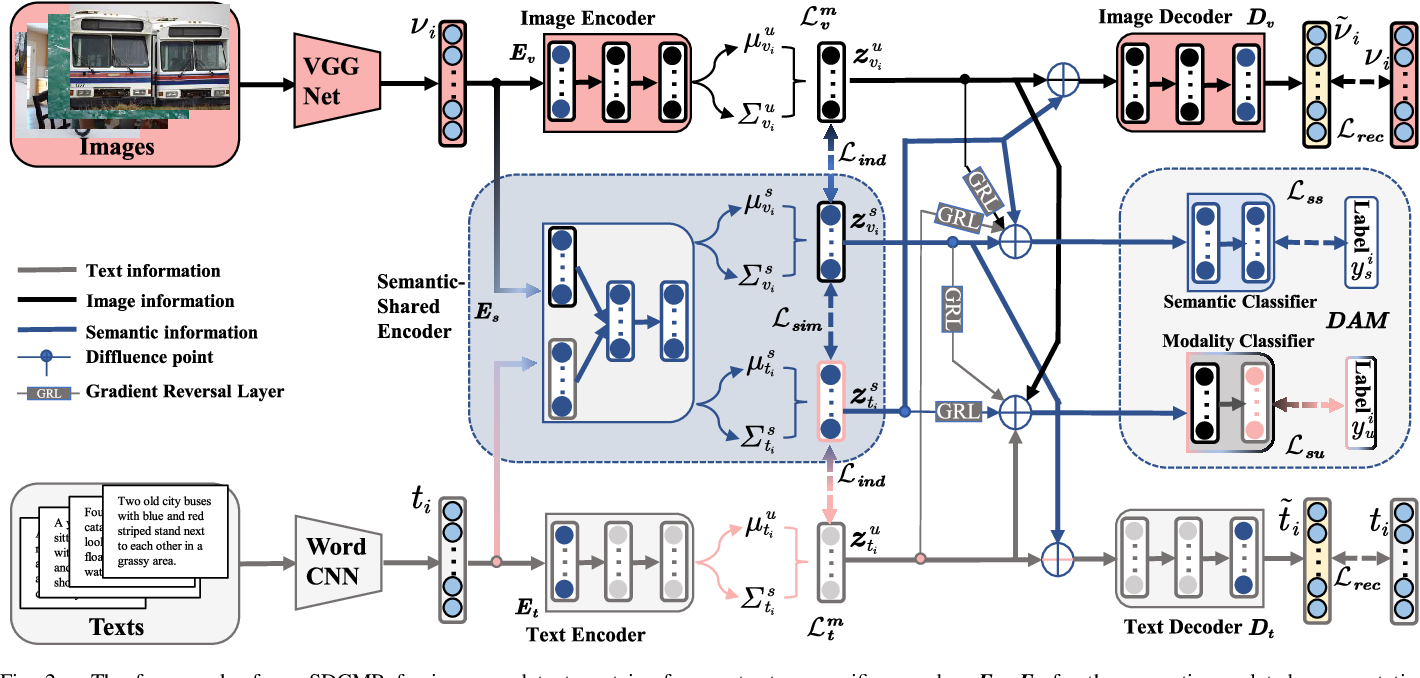
Figure 2 from Semantics Disentangling for Cross-Modal Retrieval ...

Figure 2 from A Deep Semantic Alignment Network for the Cross-Modal ...
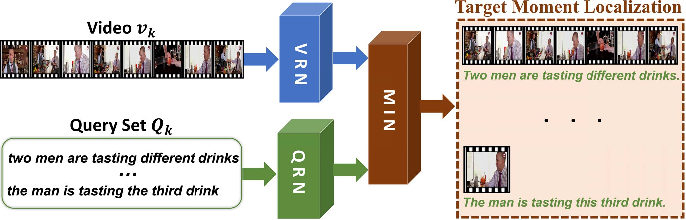
Figure 2 from Coarse-to-Fine Semantic Alignment for Cross-Modal Moment ...

Figure 1 from Semantics-Enriched Cross-Modal Alignment for Complex ...

Figure 2 from Eye Gaze Guided Cross-Modal Alignment Network for ...

Figure 2 from Reinforced Cross-modal Alignment for Radiology Report ...

Figure 2 from Learning Hierarchical Semantic Correspondences for Cross ...
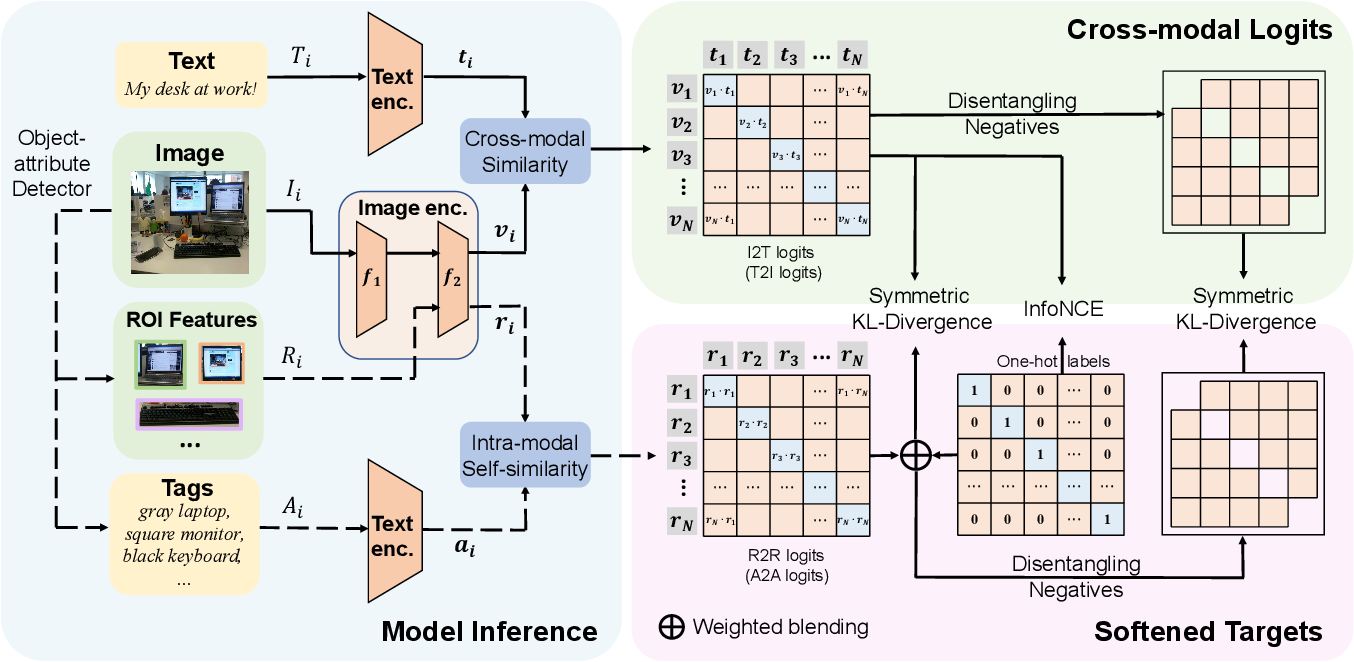
Figure 2 from SoftCLIP: Softer Cross-modal Alignment Makes CLIP ...

Figure 2 from Cross-Modal Alignment Learning of Vision-Language ...

Figure 2 from Discrete Cross-Modal Alignment Enables Zero-Shot Speech ...
Advertisement Space (336x280)

Figure 2 from Speech-Text Pre-training for Spoken Dialog Understanding ...

Figure 1 from CA_DeepSC: Cross-Modal Alignment for Multi-Modal Semantic ...

Figure 1 from Cross-Modal Cross-Domain Dual Alignment Network for RGB ...
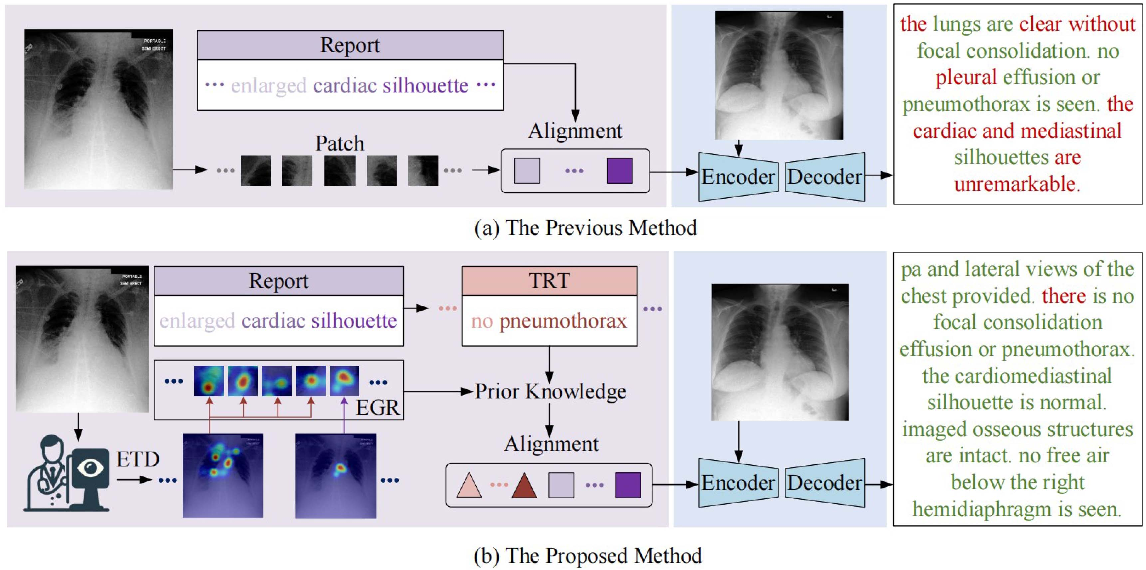
Figure 1 from Eye Gaze Guided Cross-Modal Alignment Network for ...

Figure 1 from Cross-Modal and Uni-Modal Soft-Label Alignment for Image ...

Figure 2 from How do Cross-View and Cross-Modal Alignment Affect ...

Figure 2 from Cross-Modal Alignment Learning of Vision-Language ...

Figure 1 from Discrete Joint Semantic Alignment Hashing for Cross-Modal ...
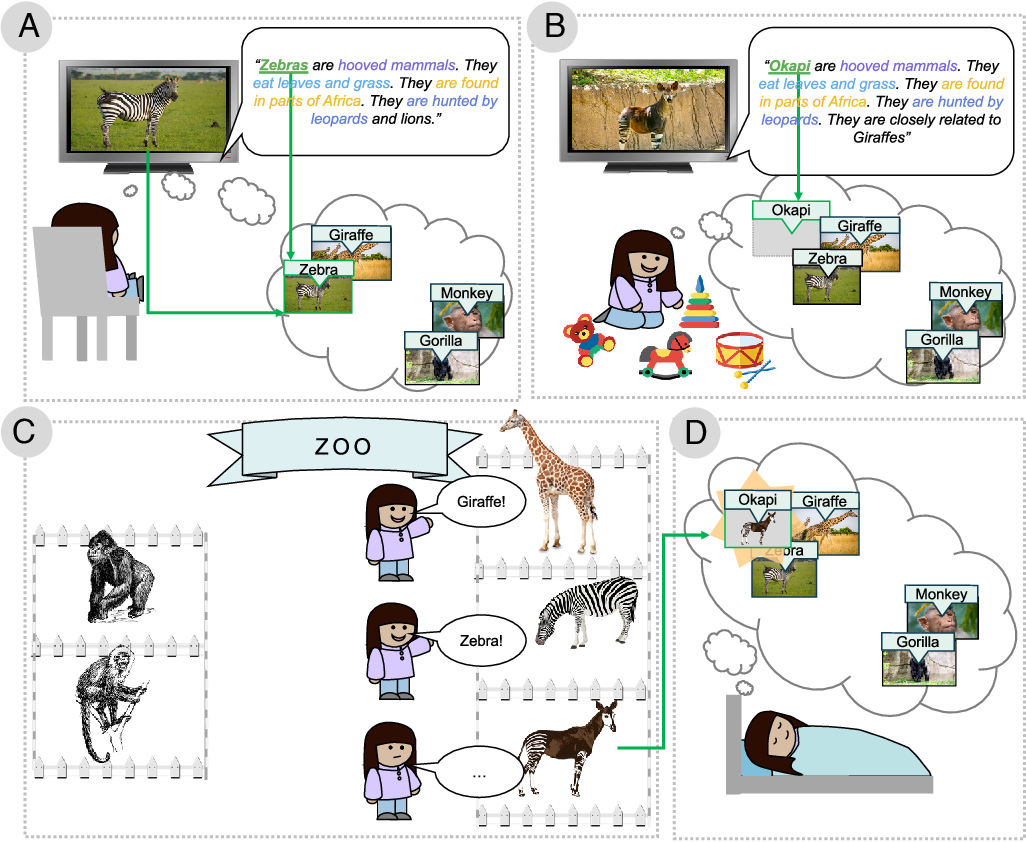
Figure 2 from Signatures of cross-modal alignment in children’s early ...
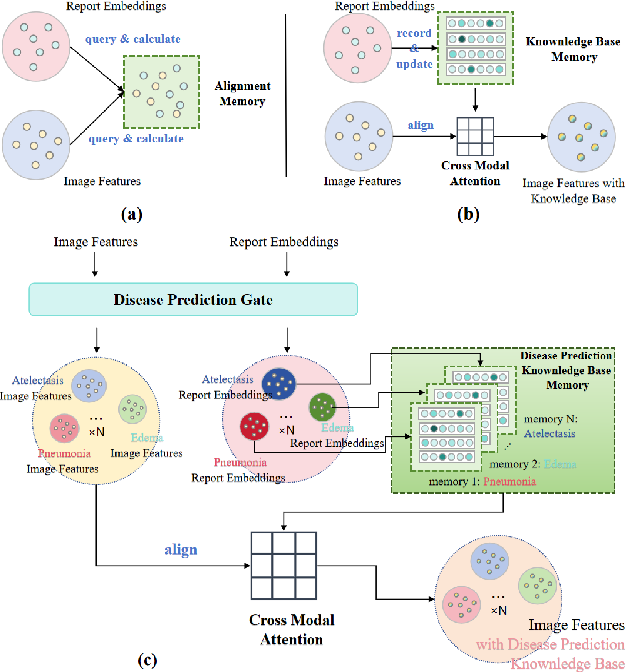
Figure 1 from Adaptive Semantic Alignment for Automated Radiology ...
Advertisement Space (336x280)

Figure 2 from A Multi-Level Alignment and Cross-Modal Unified Semantic ...
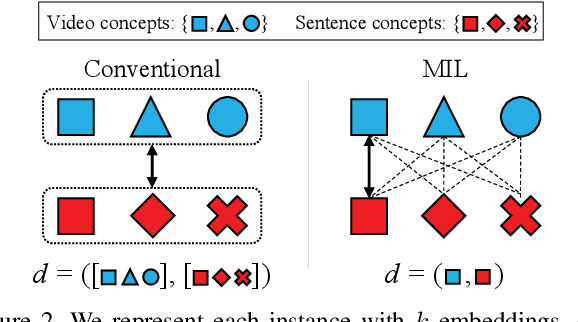
Figure 2 from Polysemous Visual-Semantic Embedding for Cross-Modal ...

Figure 1 from Learning Fine-Grained Information Alignment for ...
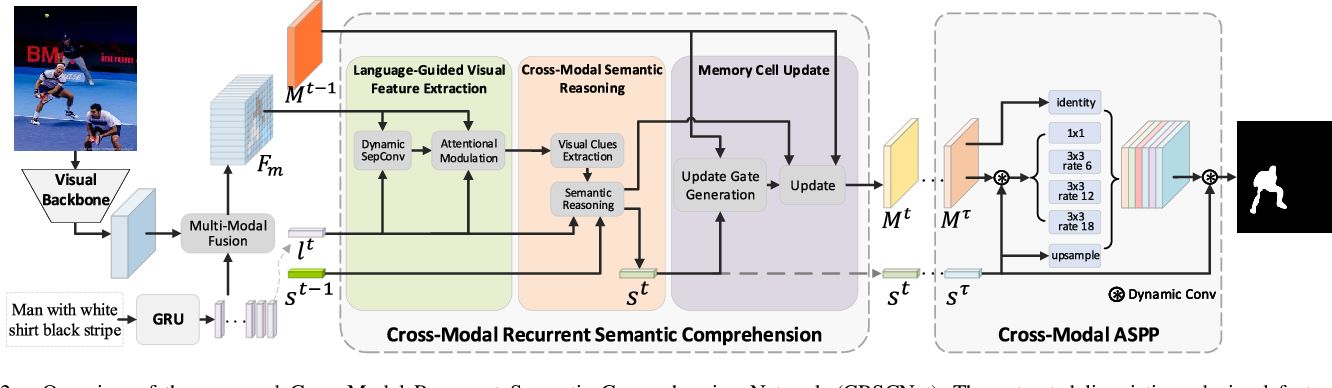
Figure 2 from Cross-Modal Recurrent Semantic Comprehension for ...
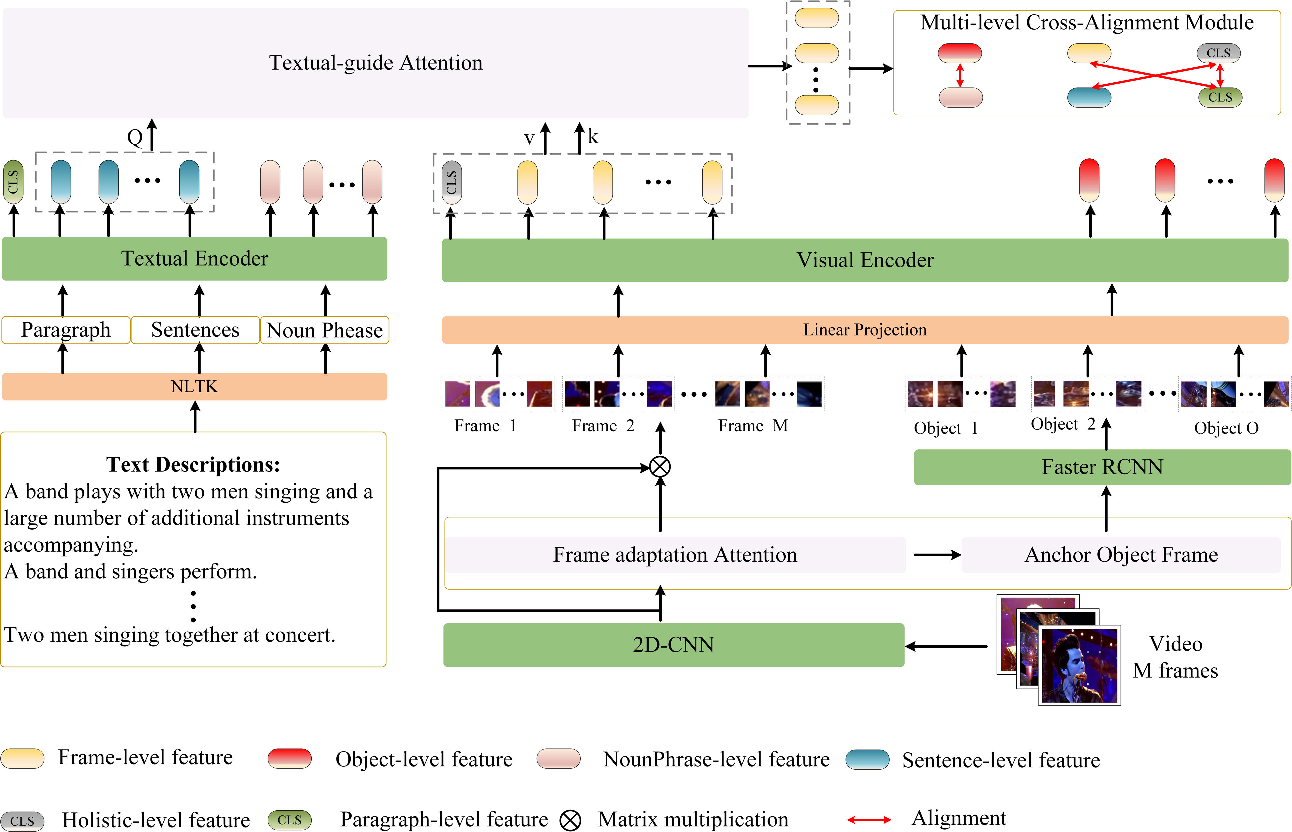
Figure 4 from Multilevel Semantic Interaction Alignment for Video–Text ...

Figure 2 from Translation, Scale and Rotation: Cross-Modal Alignment ...