
Figure 2 From Token Label Alignment For Vision Transformers Semantic

Figure 2 from Token-Label Alignment for Vision Transformers | Semantic ...

Figure 2 from Token Pooling in Vision Transformers for Image ...
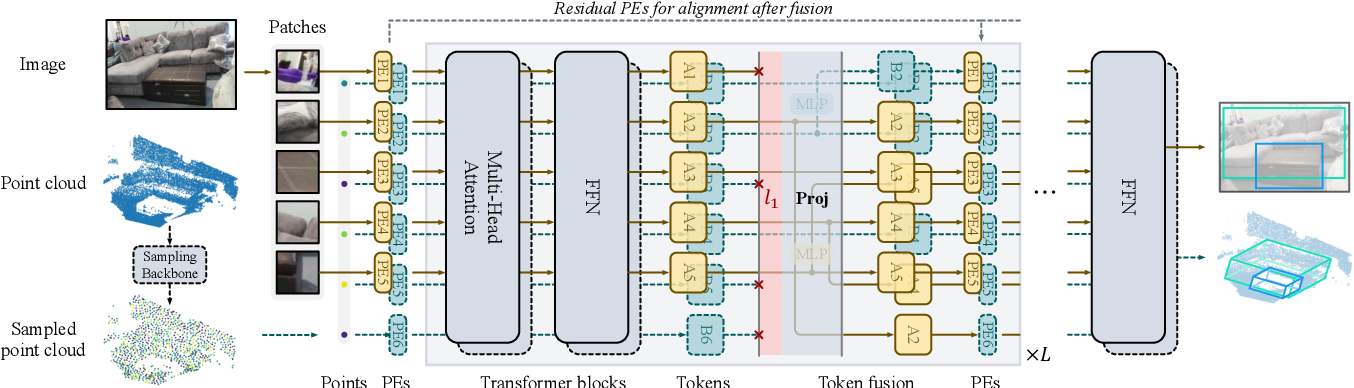
Figure 2 from Multimodal Token Fusion for Vision Transformers ...

Table 2 from Token-Label Alignment for Vision Transformers | Semantic ...
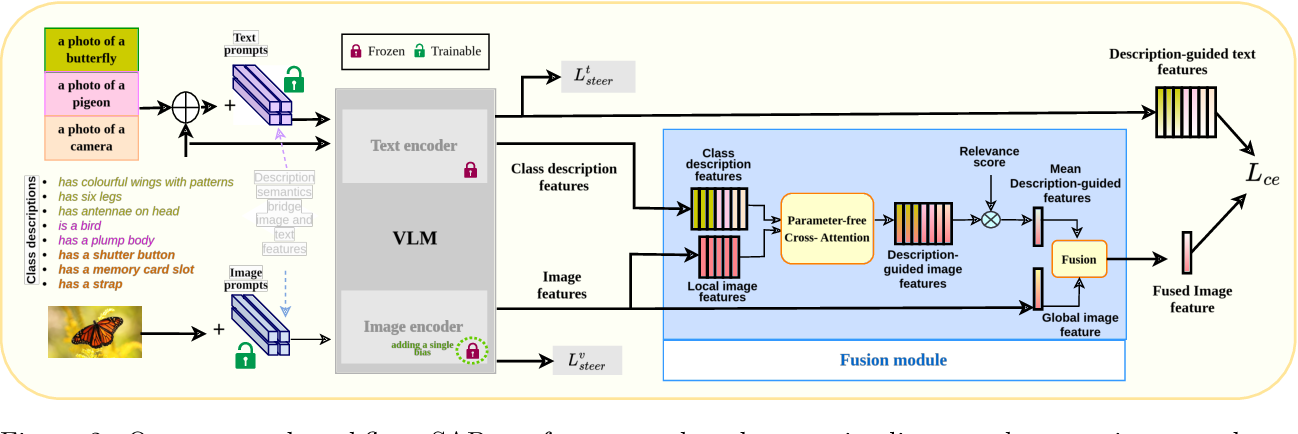
Figure 2 from Semantic Alignment for Prompt-Tuning in Vision Language ...
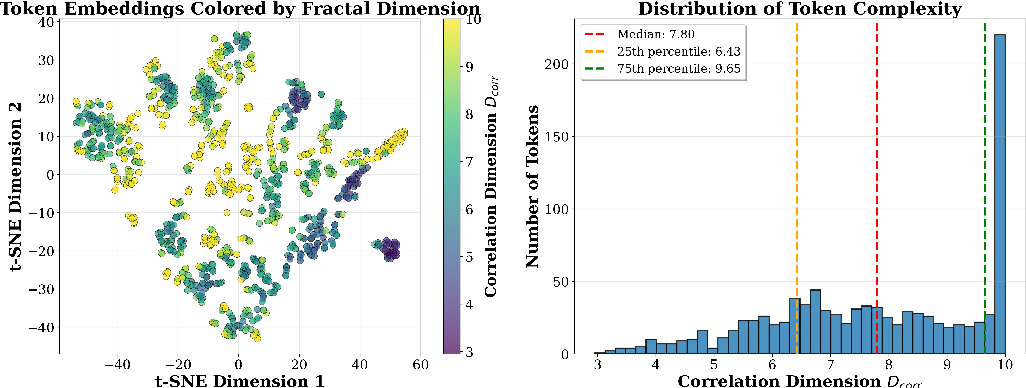
Figure 2 from Fractal-Guided Token Pruning for Efficient Vision ...
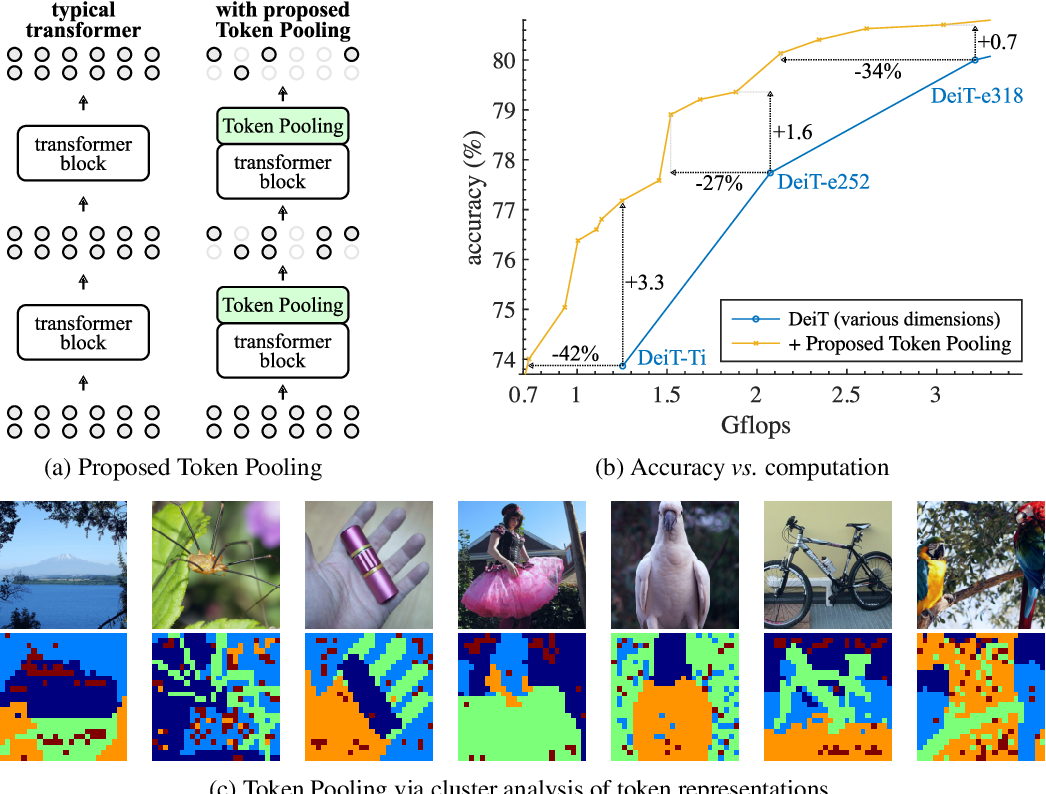
Figure 1 from Token Pooling in Vision Transformers | Semantic Scholar
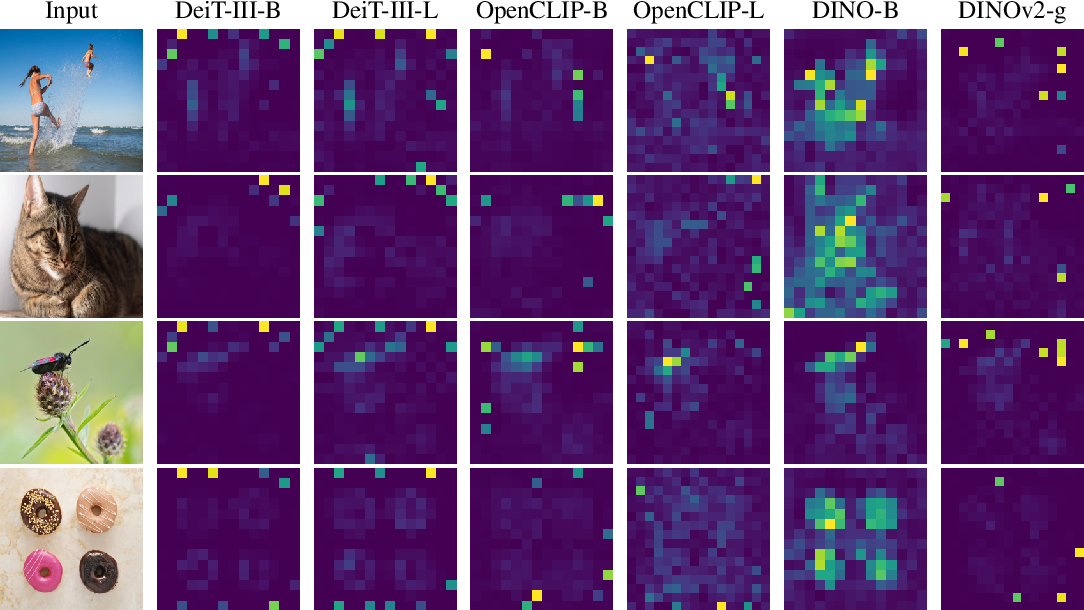
Figure 2 from Vision Transformers Need Registers | Semantic Scholar

Figure 1 from Safety Alignment for Vision Language Models | Semantic ...
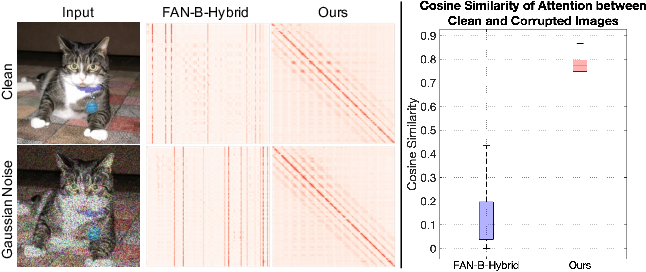
Figure 1 from Robustifying Token Attention for Vision Transformers ...
Advertisement Space (300x250)

Figure 2 from Token Selection is a Simple Booster for Vision ...
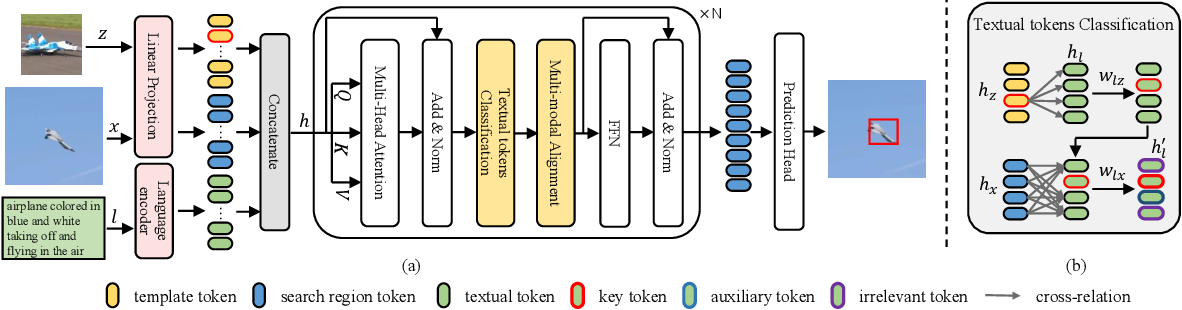
Figure 2 from Textual Tokens Classification for Multi-Modal Alignment ...

Figure 2 from Learning to Mask and Permute Visual Tokens for Vision ...

Figure 1 from PPT: Token Pruning and Pooling for Efficient Vision ...

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...

Figure 1 from Content-aware Token Sharing for Efficient Semantic ...
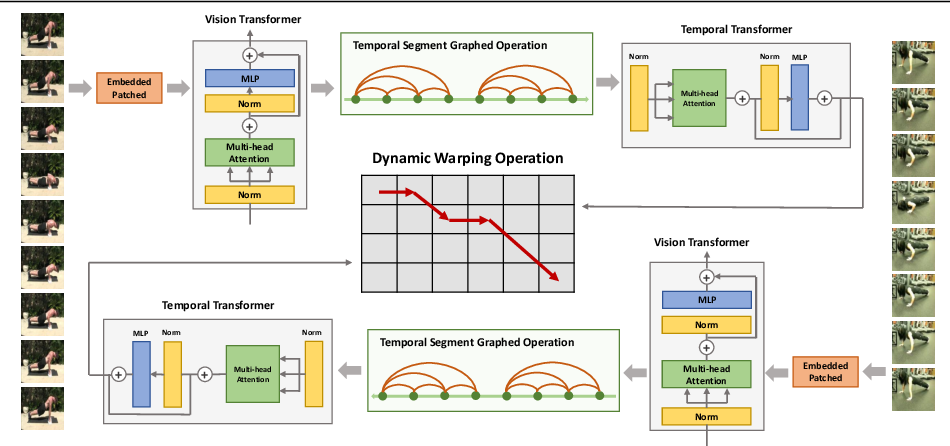
Figure 2 from Dynamic Graph Warping Transformer for Video Alignment ...

Figure 1 from Positional Label for Self-Supervised Vision Transformer ...
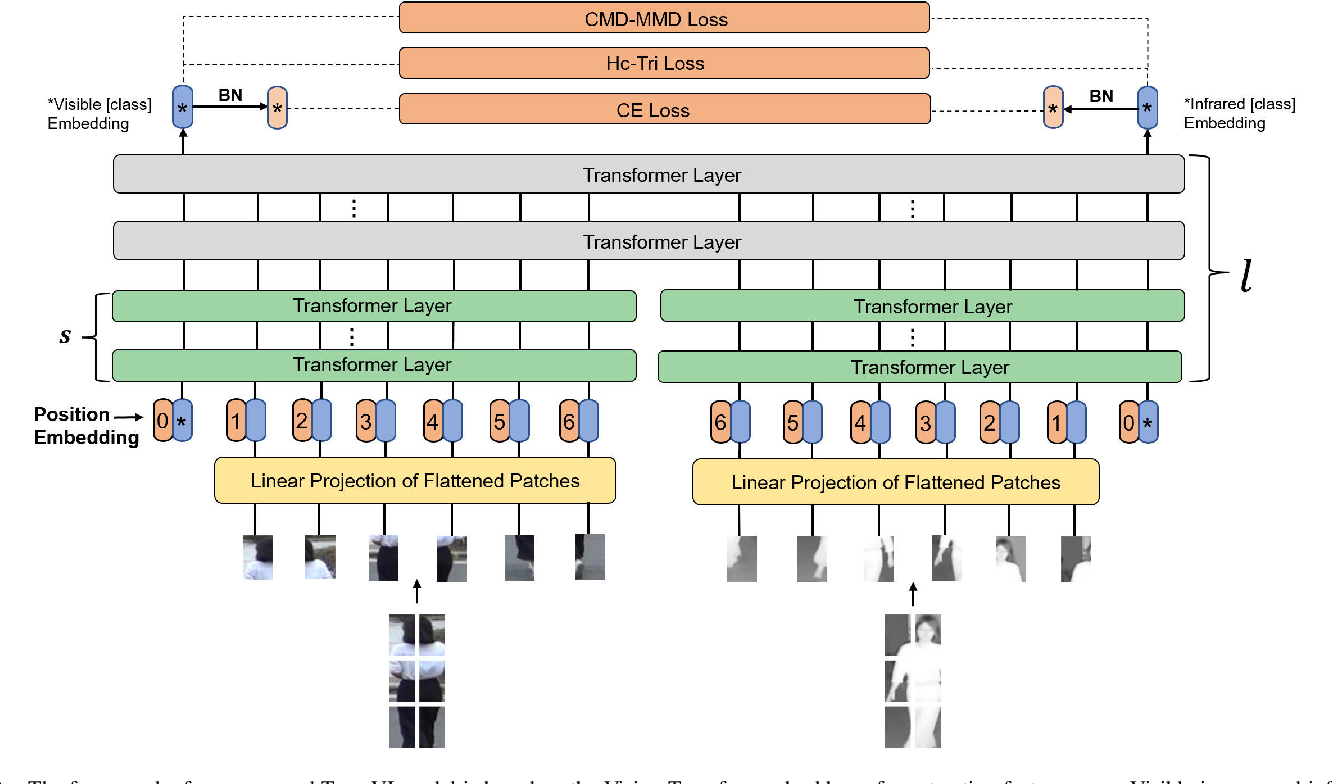
Figure 2 from Dual-Stream Transformer With Distribution Alignment for ...
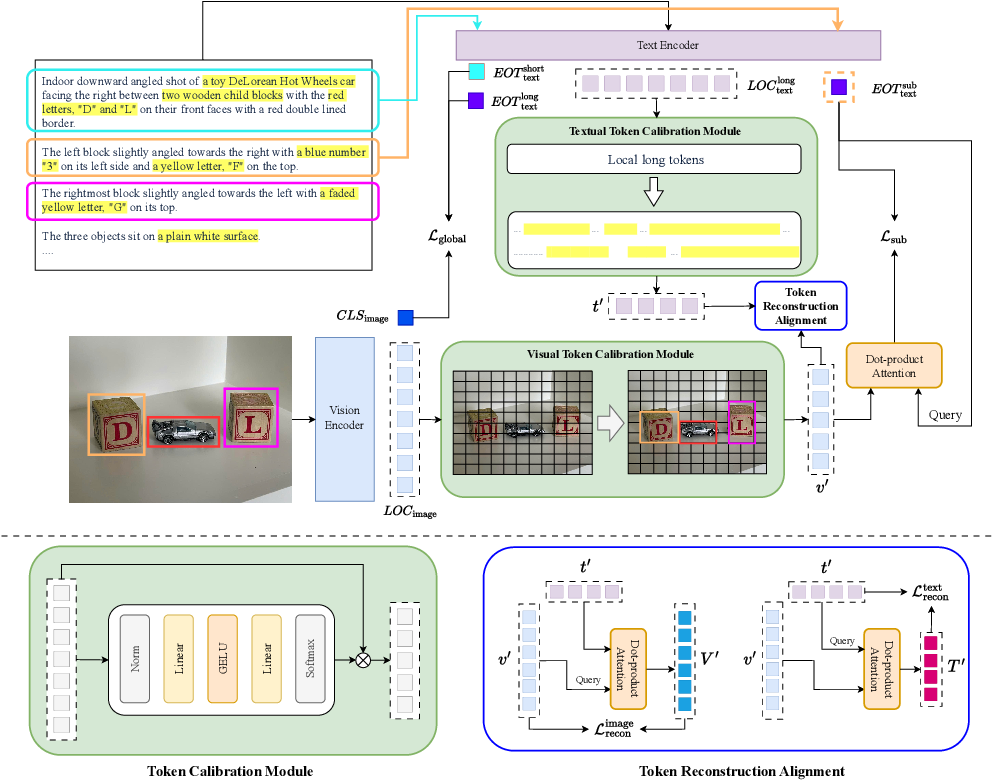
Figure 2 from MulCLIP: A Multi-level Alignment Framework for Enhancing ...
Advertisement Space (336x280)

(PDF) Dynamic Token Pruning in Plain Vision Transformers for Semantic ...

Figure 1 from Joint Token and Feature Alignment Framework for Text ...

Figure 2 from Textual Tokens Classification for Multi-Modal Alignment ...

Figure 2 from Textual Tokens Classification for Multi-Modal Alignment ...

Figure 2 from MADTP: Multimodal Alignment-Guided Dynamic Token Pruning ...
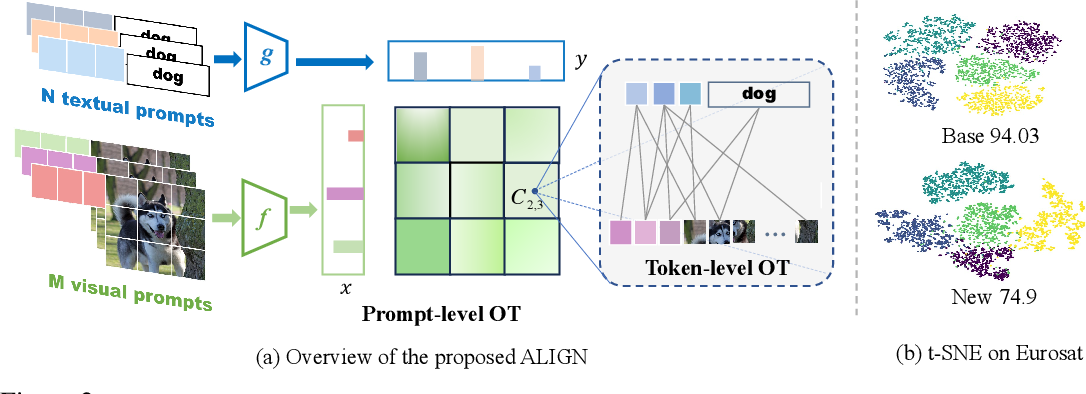
Figure 2 from Tuning Multi-mode Token-level Prompt Alignment across ...

CVPR2023 Making Vision Transformers Efficient from A Token ...

Token-Label Alignment for Vision Transformers
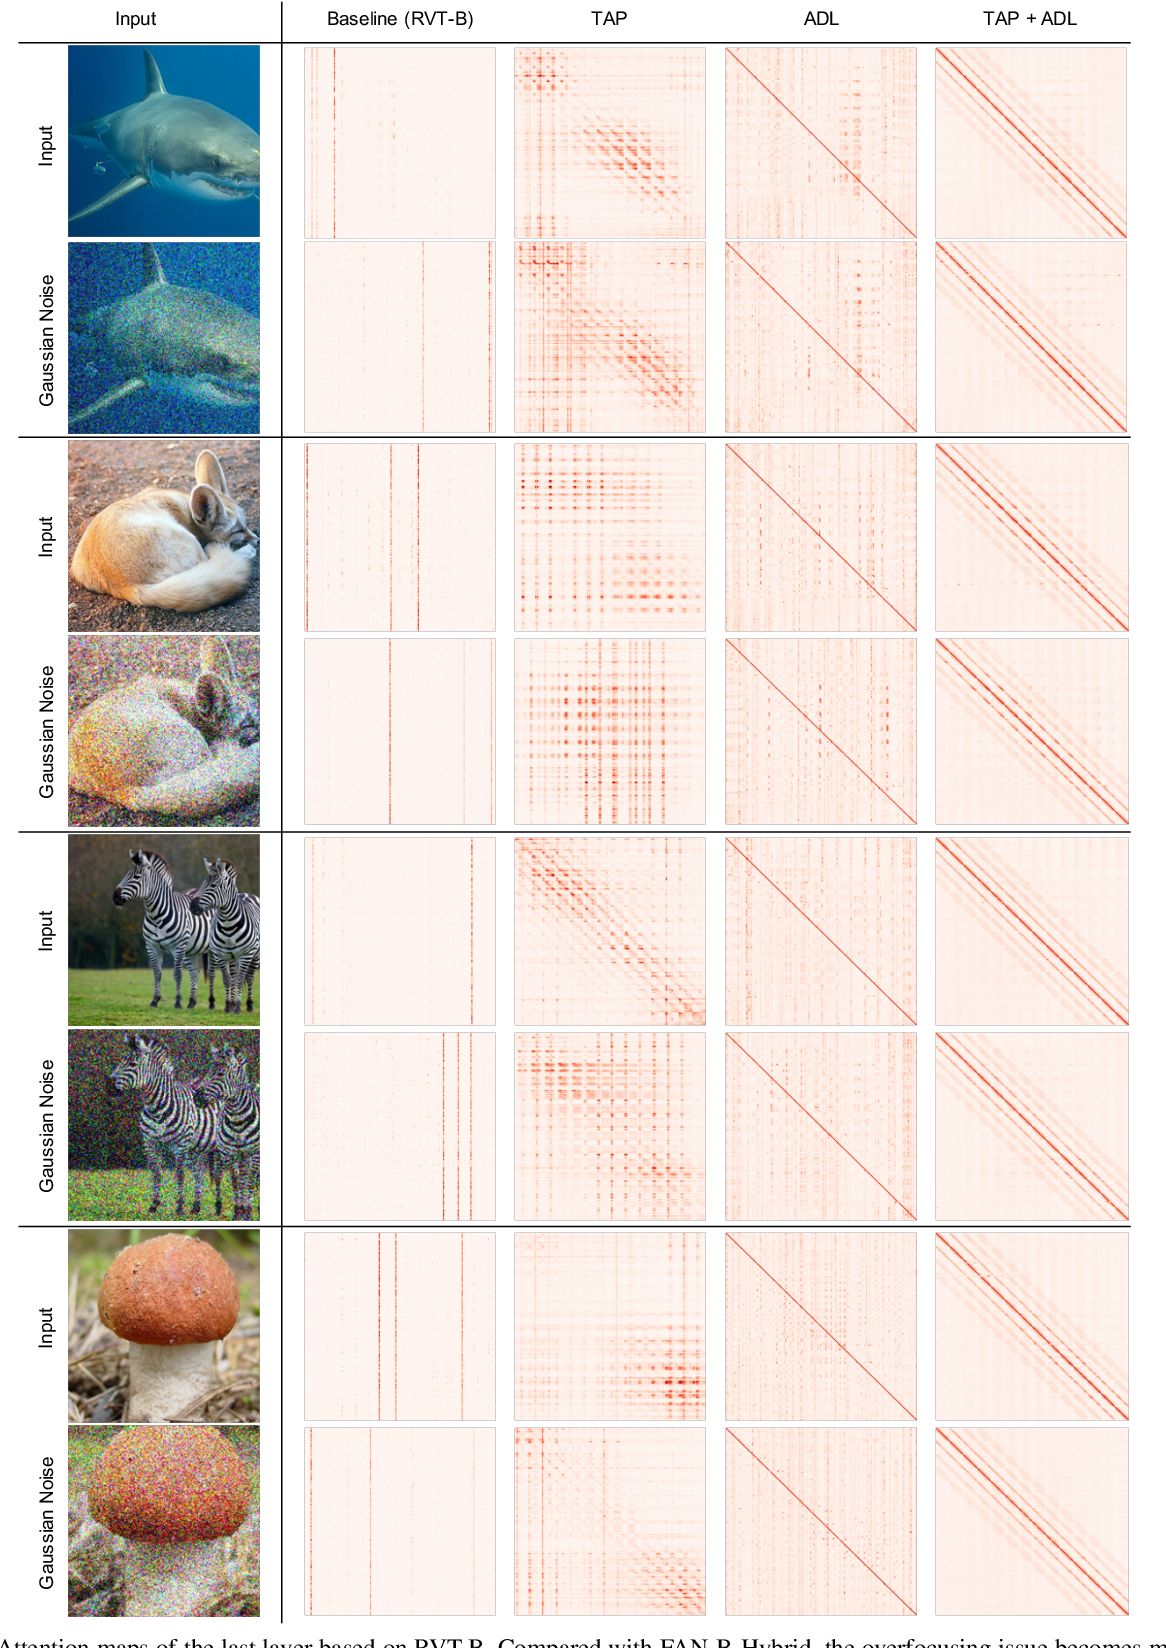
Figure II from Supplementary Materials for “Robustifying Token ...

CVPR2023 Making Vision Transformers Efficient from A Token ...
Advertisement Space (336x280)

Figure 1 from Learning to Merge Tokens in Vision Transformers ...

Figure 1 from Bidirectional Alignment for Domain Adaptive Detection ...
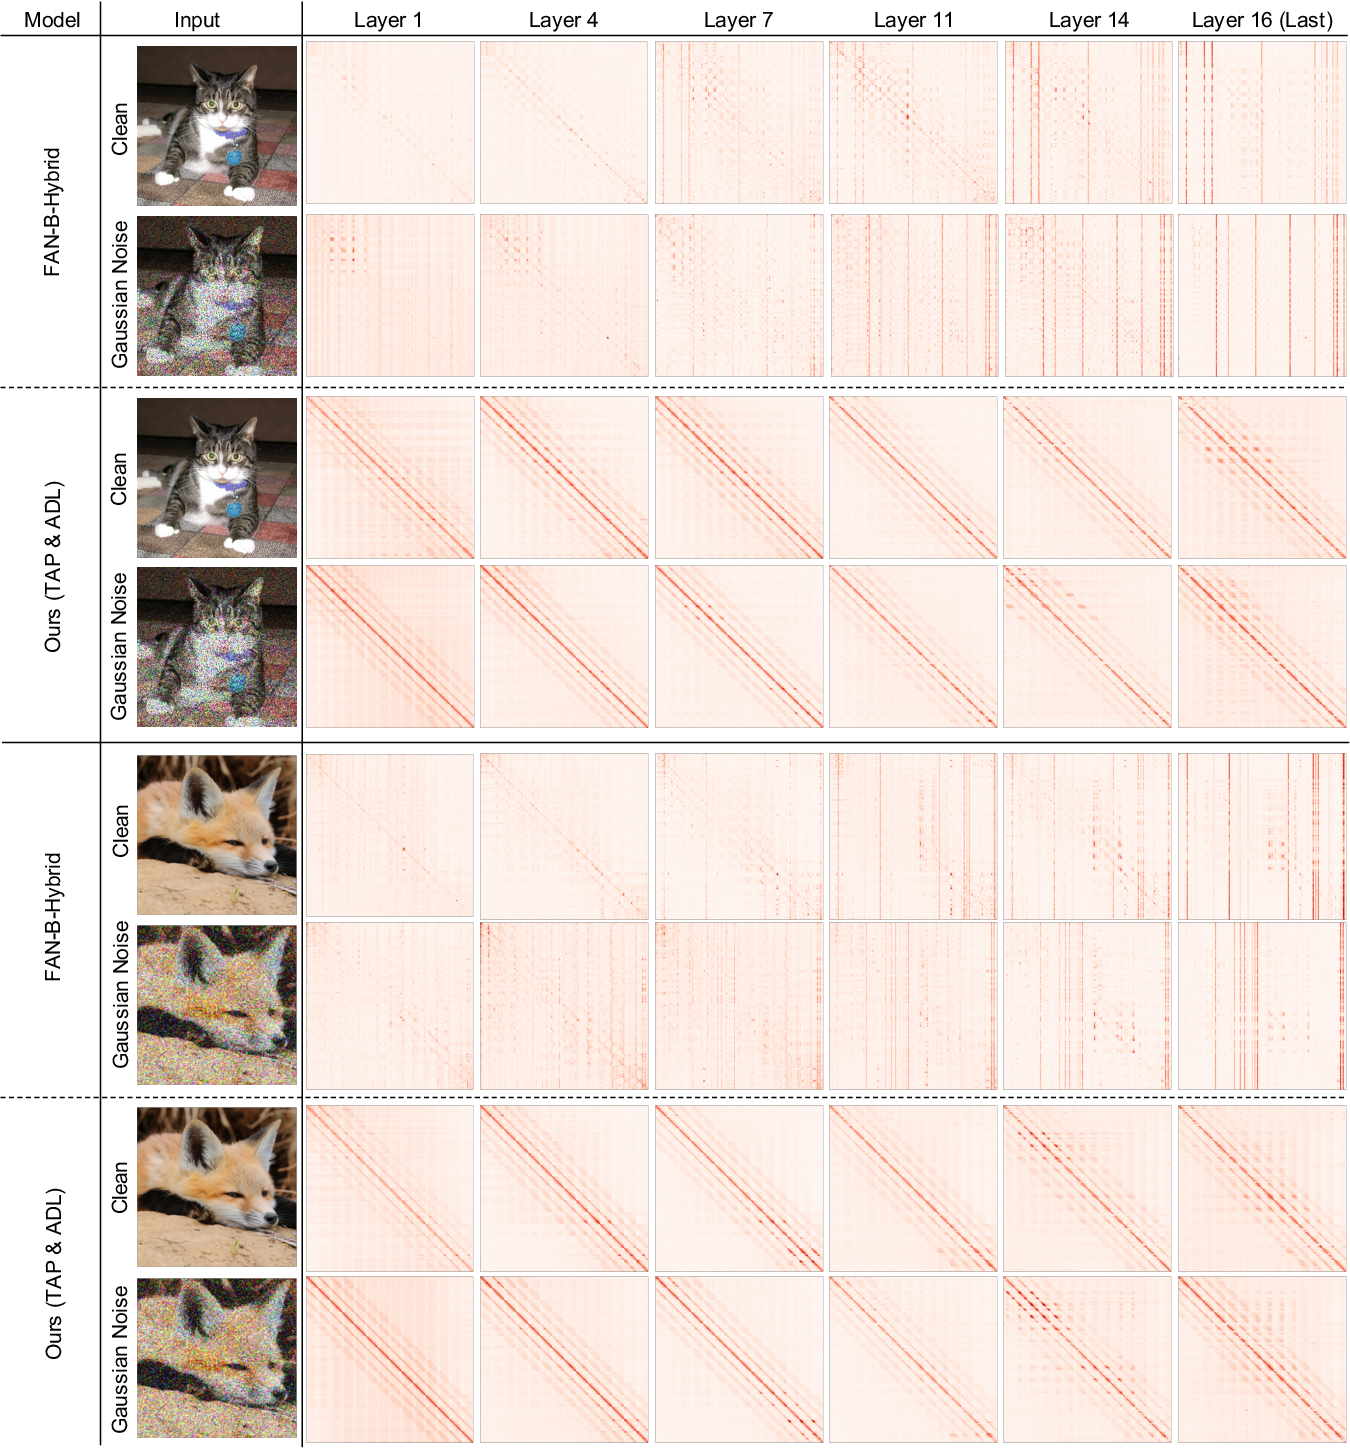
Figure I from Supplementary Materials for “Robustifying Token Attention ...
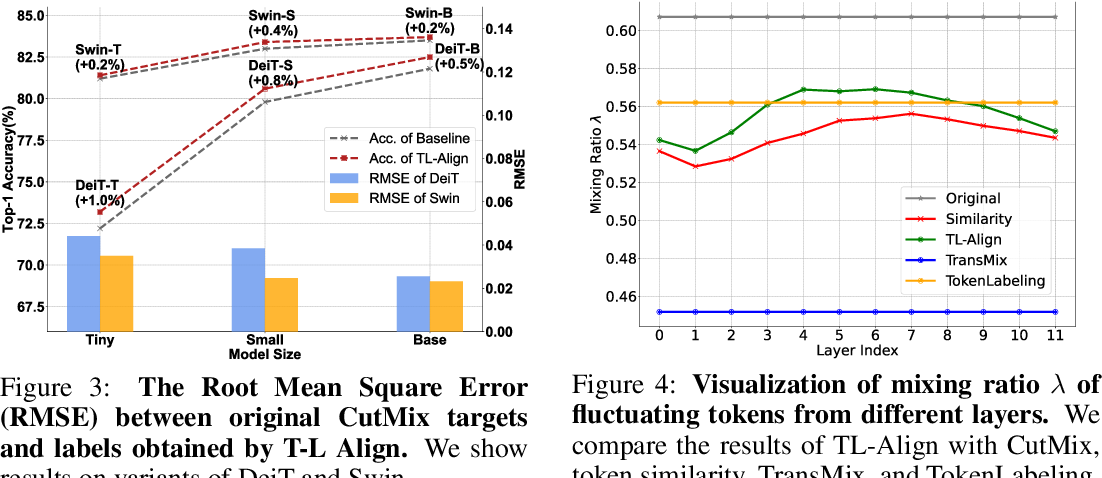
Token-Label Alignment for Vision Transformers

Figure 2 from Trajectory Alignment based Multi-Scaled Temporal ...

Figure 2 from Multi-Level Representation Learning with Semantic ...