
Figure 2 From Vision Transformers Need Registers Semantic Scholar
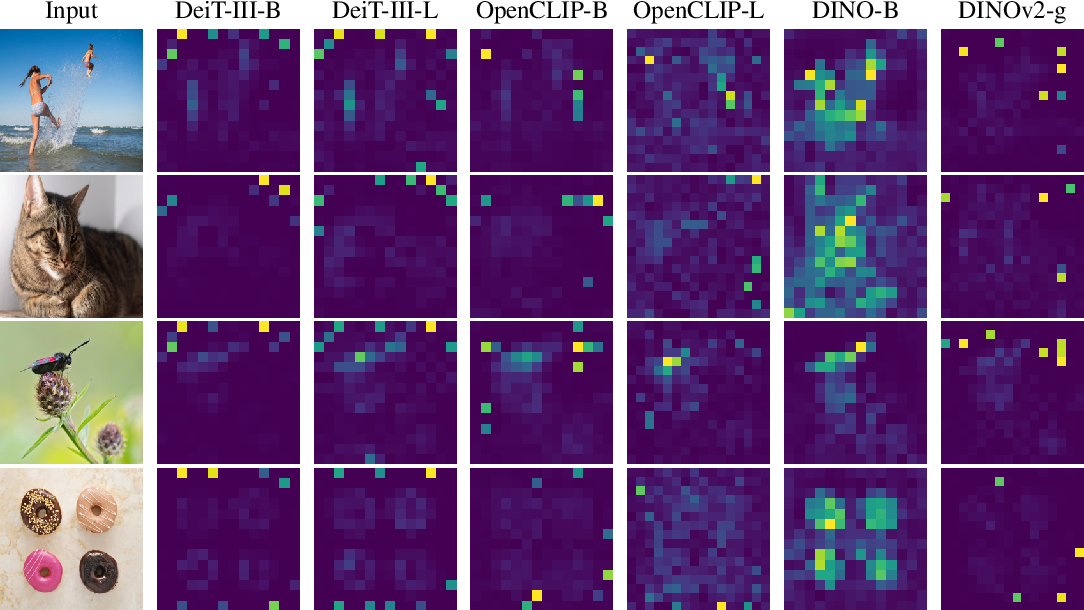
Figure 2 from Vision Transformers Need Registers | Semantic Scholar
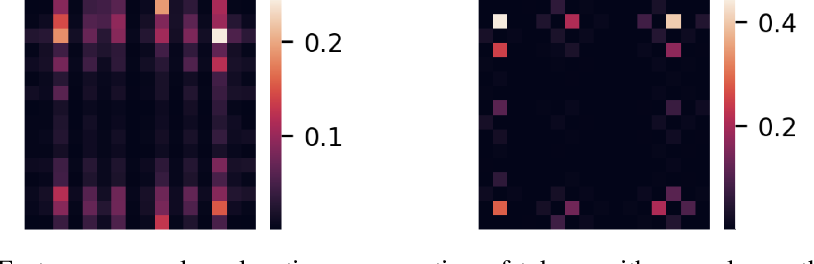
Figure 10 from Vision Transformers Need Registers | Semantic Scholar
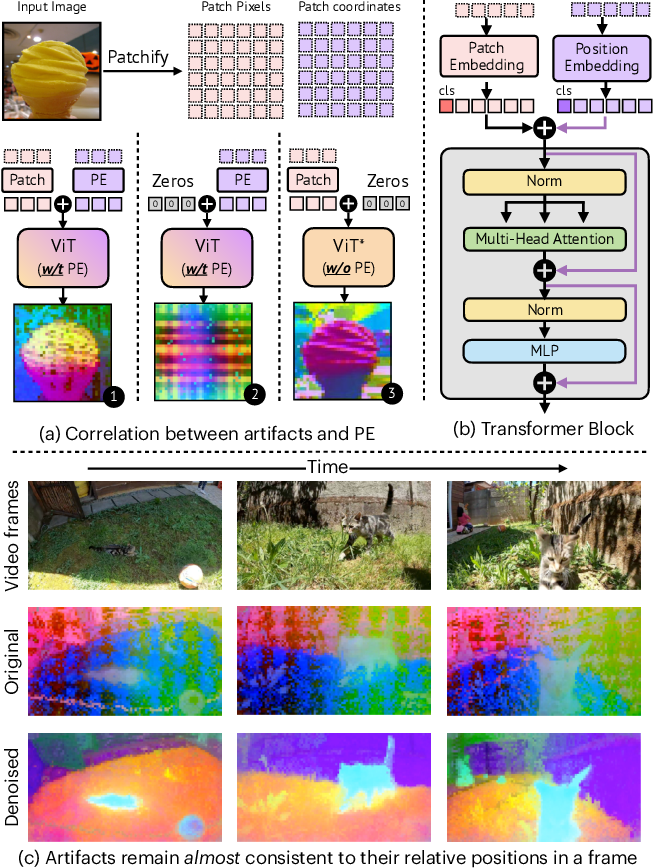
Figure 2 from Denoising Vision Transformers | Semantic Scholar

Figure 2 from Token-Label Alignment for Vision Transformers | Semantic ...

Figure 2 from Vision Transformers with Self-Distilled Registers ...

Figure 2 from Dual Vision Transformer | Semantic Scholar

Figure 2 from Transformers for Image-Goal Navigation | Semantic Scholar

Figure 2 from Vision Transformers with Self-Distilled Registers ...
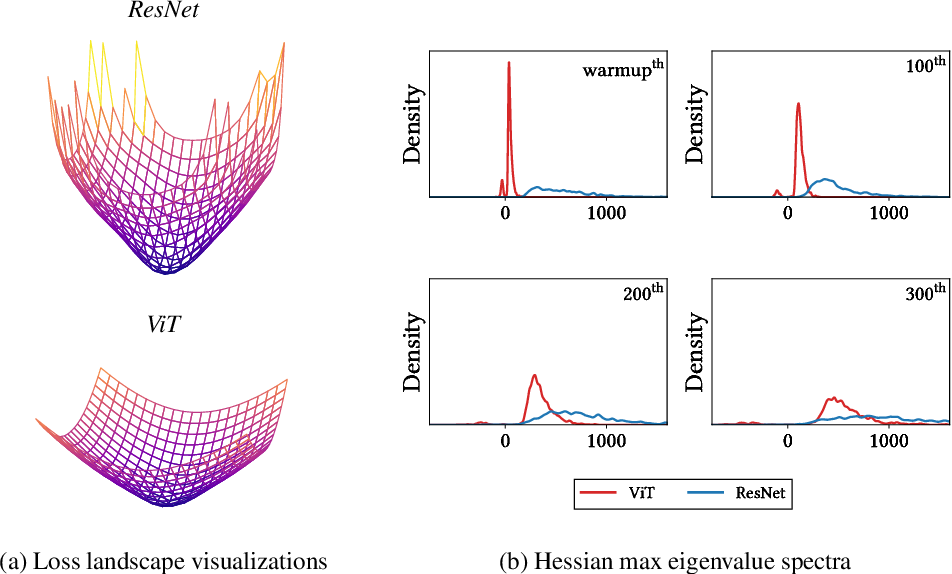
Figure 1 from How Do Vision Transformers Work? | Semantic Scholar
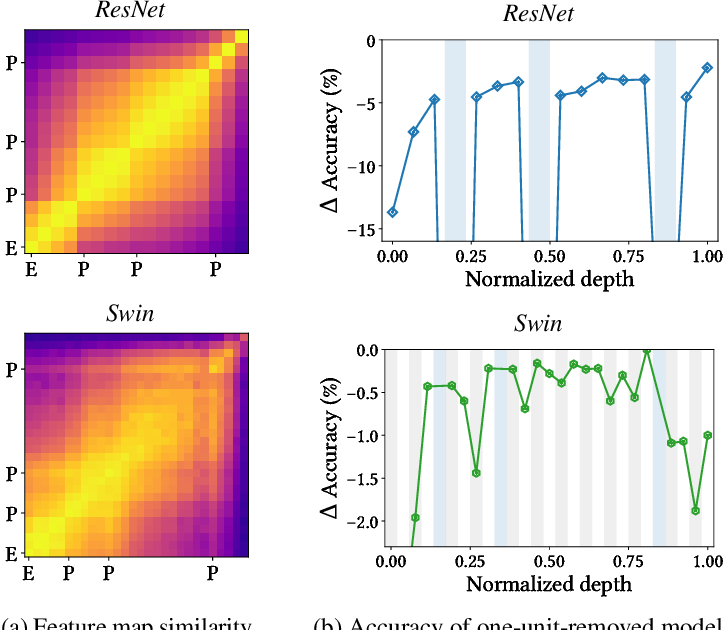
Figure 10 from How Do Vision Transformers Work? | Semantic Scholar
Advertisement Space (300x250)

Figure 2 from A Convolutional Vision Transformer for Semantic ...

Figure 2 from Token Pooling in Vision Transformers for Image ...
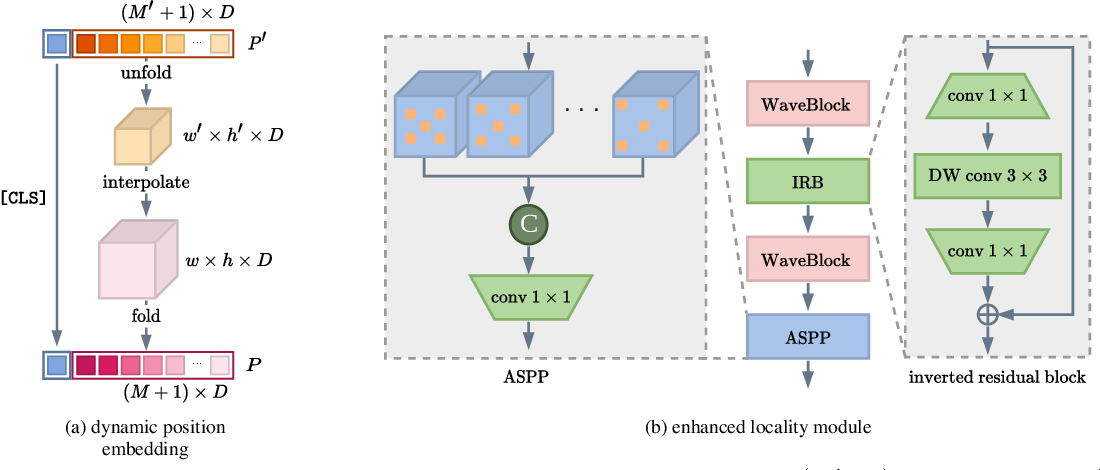
Figure 2 from Boosting vision transformers for image retrieval ...

Figure 2 from Multi-Scale Convolutional Vision Transformer for Semantic ...

Figure 2 from An Overview of Vision Transformers for Image Processing ...

Figure 2 from Exploring Vision Transformer Layer Choosing for Semantic ...
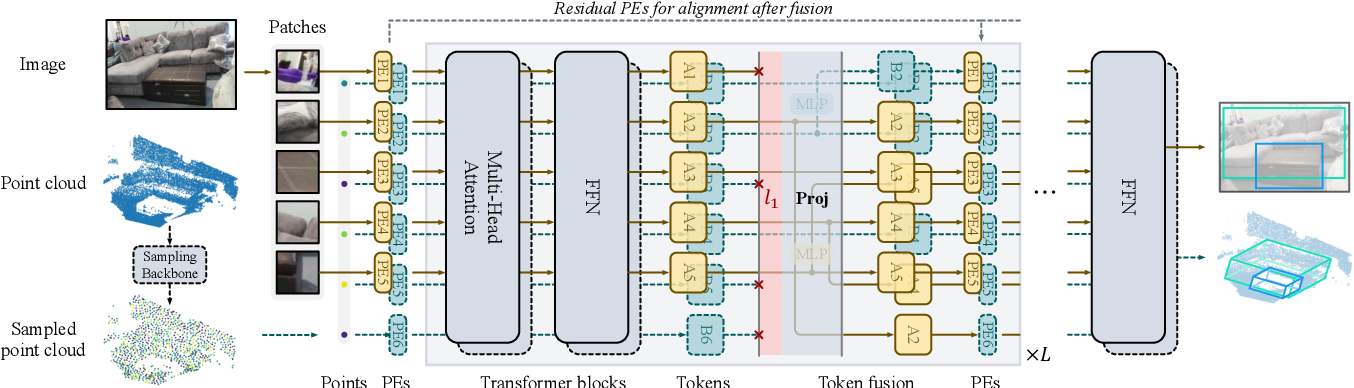
Figure 2 from Multimodal Token Fusion for Vision Transformers ...
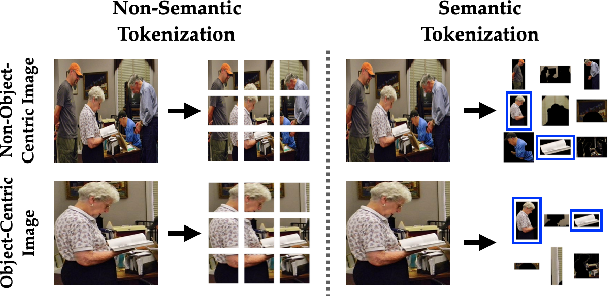
Figure 2 from Vision Transformers with Natural Language Semantics ...
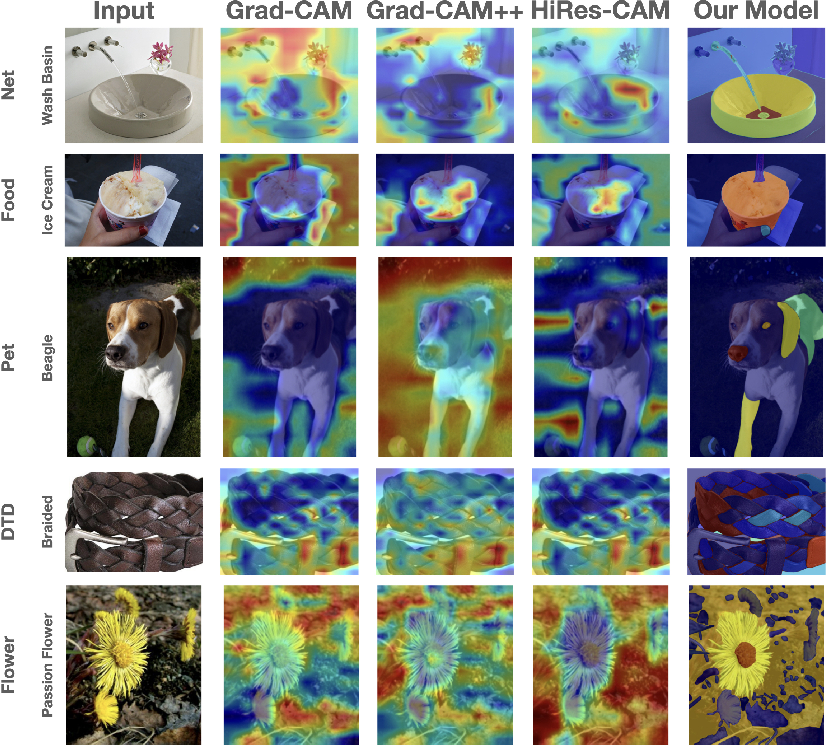
Figure 2 from Vision Transformers with Natural Language Semantics ...

Figure 1 from Dual Vision Transformer | Semantic Scholar
Advertisement Space (336x280)

Figure 2 from A Survey of Vision Transformers in Autonomous Driving ...
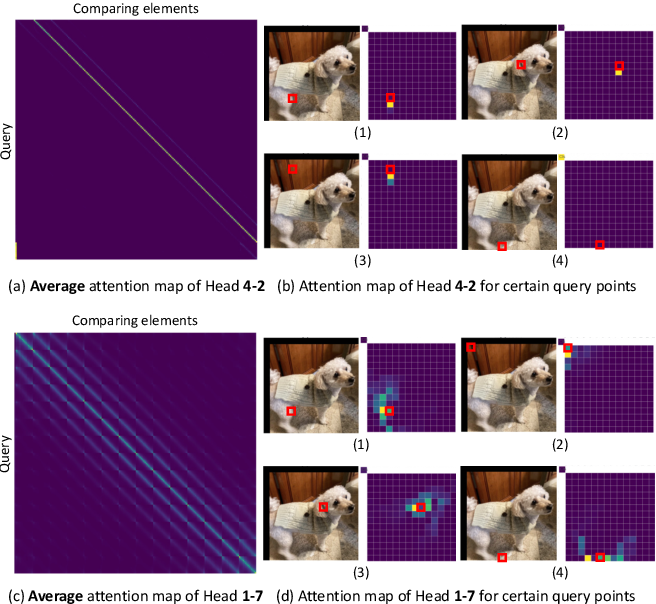
Figure 2 from Rethinking the Self-Attention in Vision Transformers ...
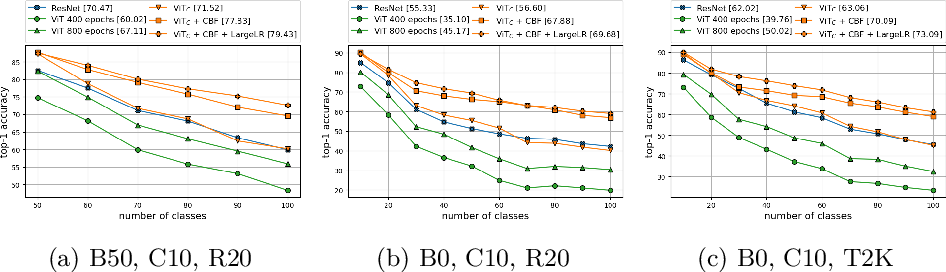
Figure 2 from Improving Vision Transformers for Incremental Learning ...
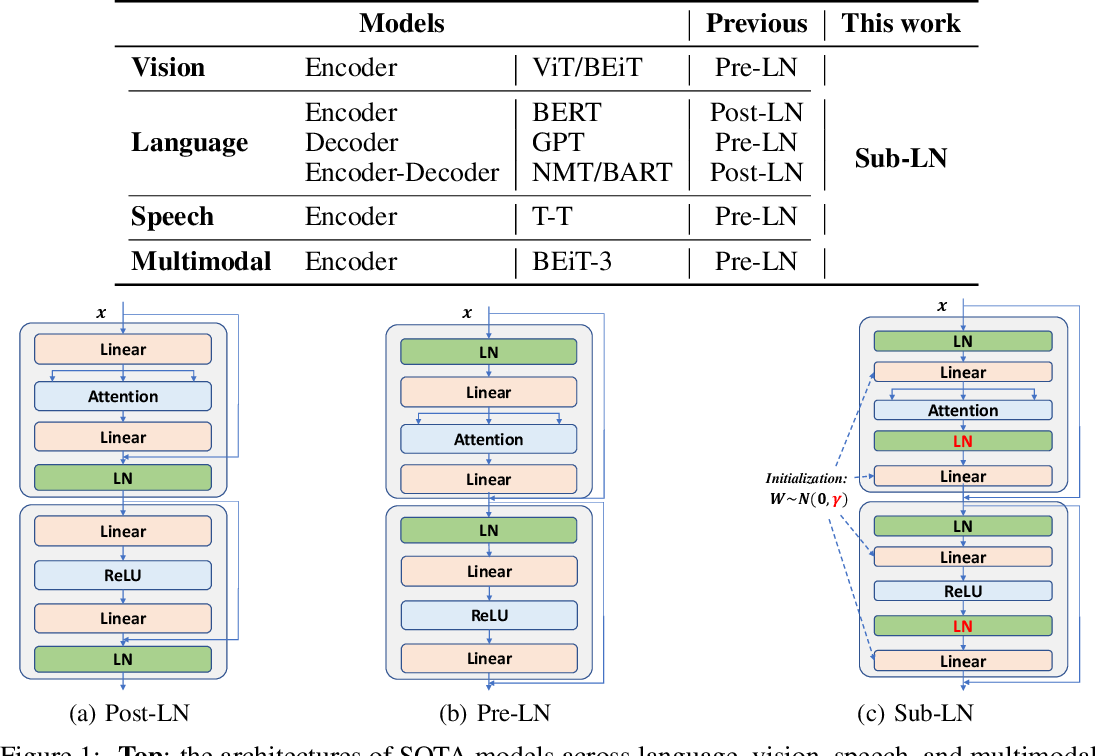
Figure 1 from Foundation Transformers | Semantic Scholar

Figure 1 from Memorizing Transformers | Semantic Scholar

Figure 2 from AU-Aware Vision Transformers for Biased Facial Expression ...
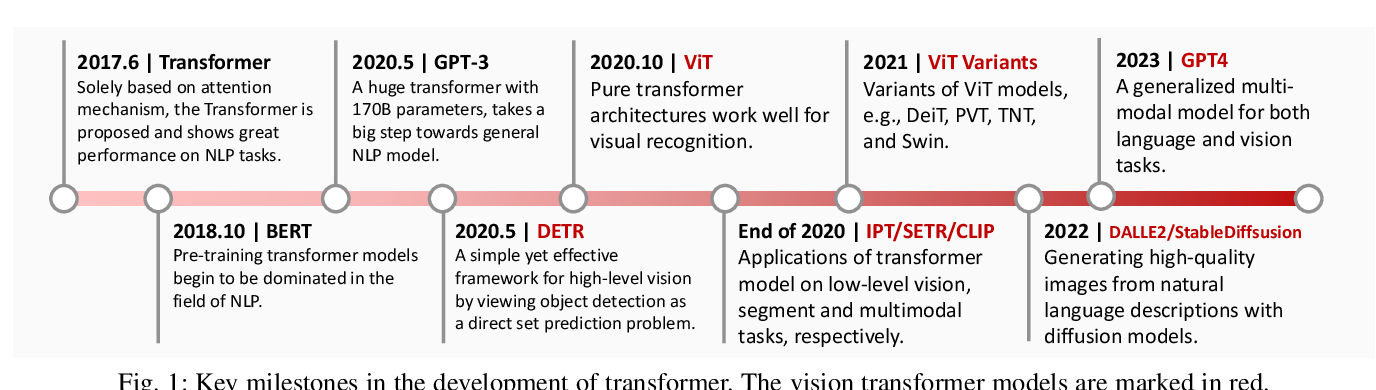
Figure 1 from A Survey on Vision Transformer | Semantic Scholar

Figure 1 from Holistically Explainable Vision Transformers | Semantic ...
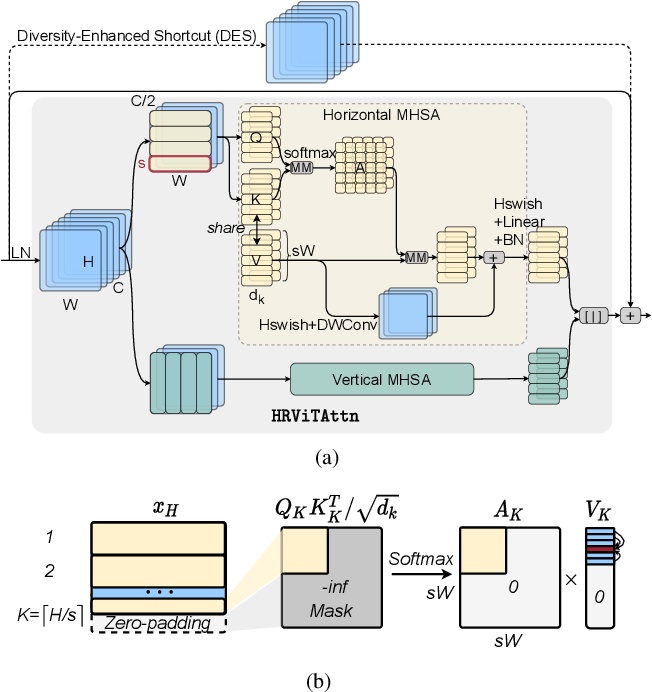
Figure 2 from Multi-Scale High-Resolution Vision Transformer for ...
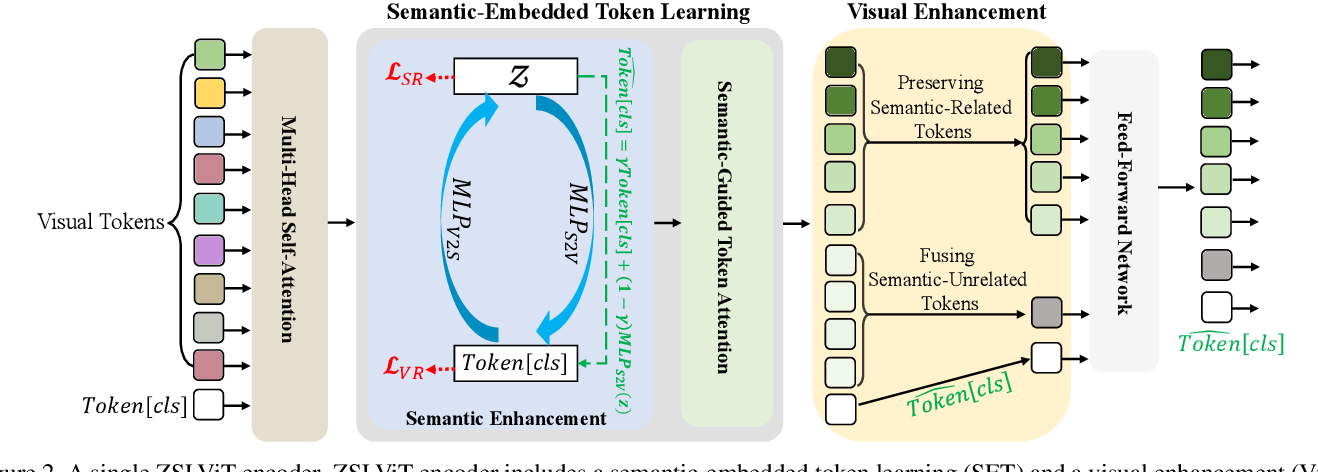
Figure 2 from Progressive Semantic-Guided Vision Transformer for Zero ...
Advertisement Space (336x280)

Figure 2 from A 3D U-Net Based on a Vision Transformer for Radar ...
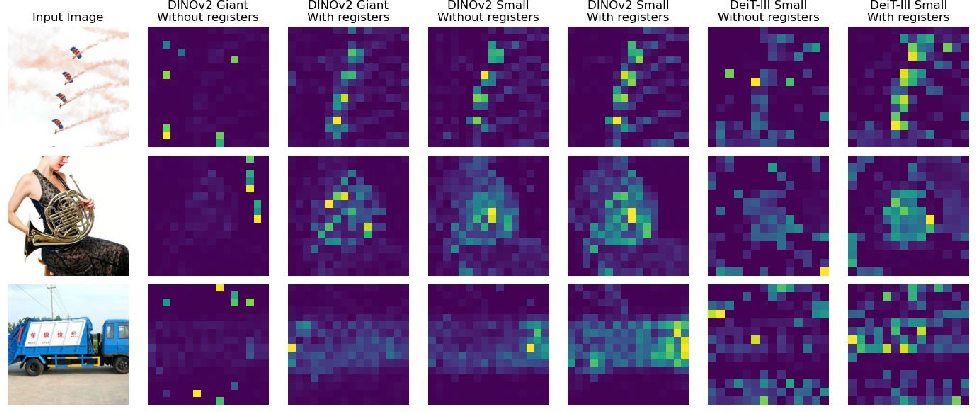
Figure 1 from Registers in Small Vision Transformers: A Reproducibility ...

Figure 1 from Using Vision Transformers in 3-D Medical Image ...

Figure 1 from Semantic Segmentation using Vision Transformers: A survey ...
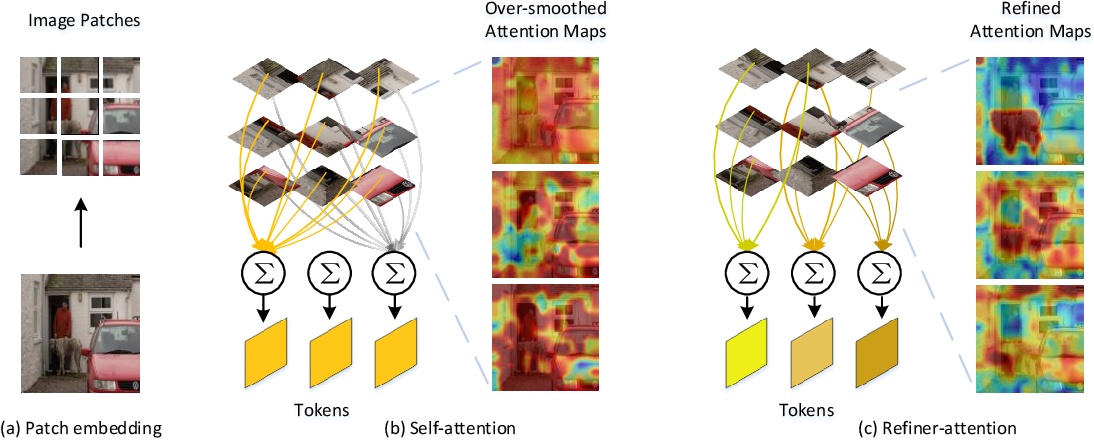
Figure 1 from Refiner: Refining Self-attention for Vision Transformers ...
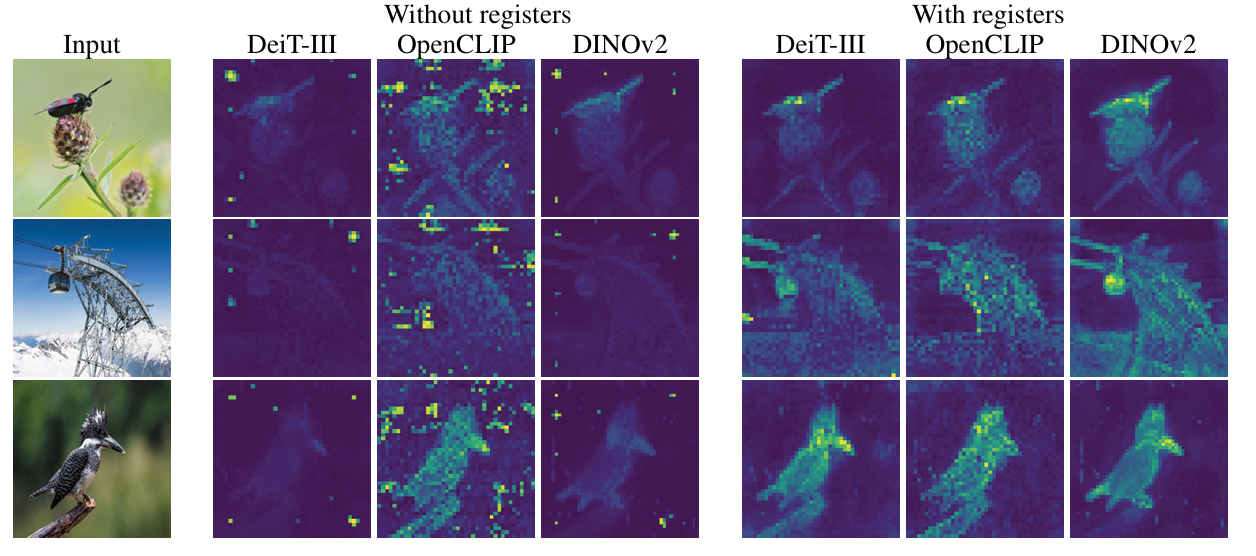
Vision Transformers Need Registers