
Table Iv From Vision Transformer For Pansharpening Semantic Scholar
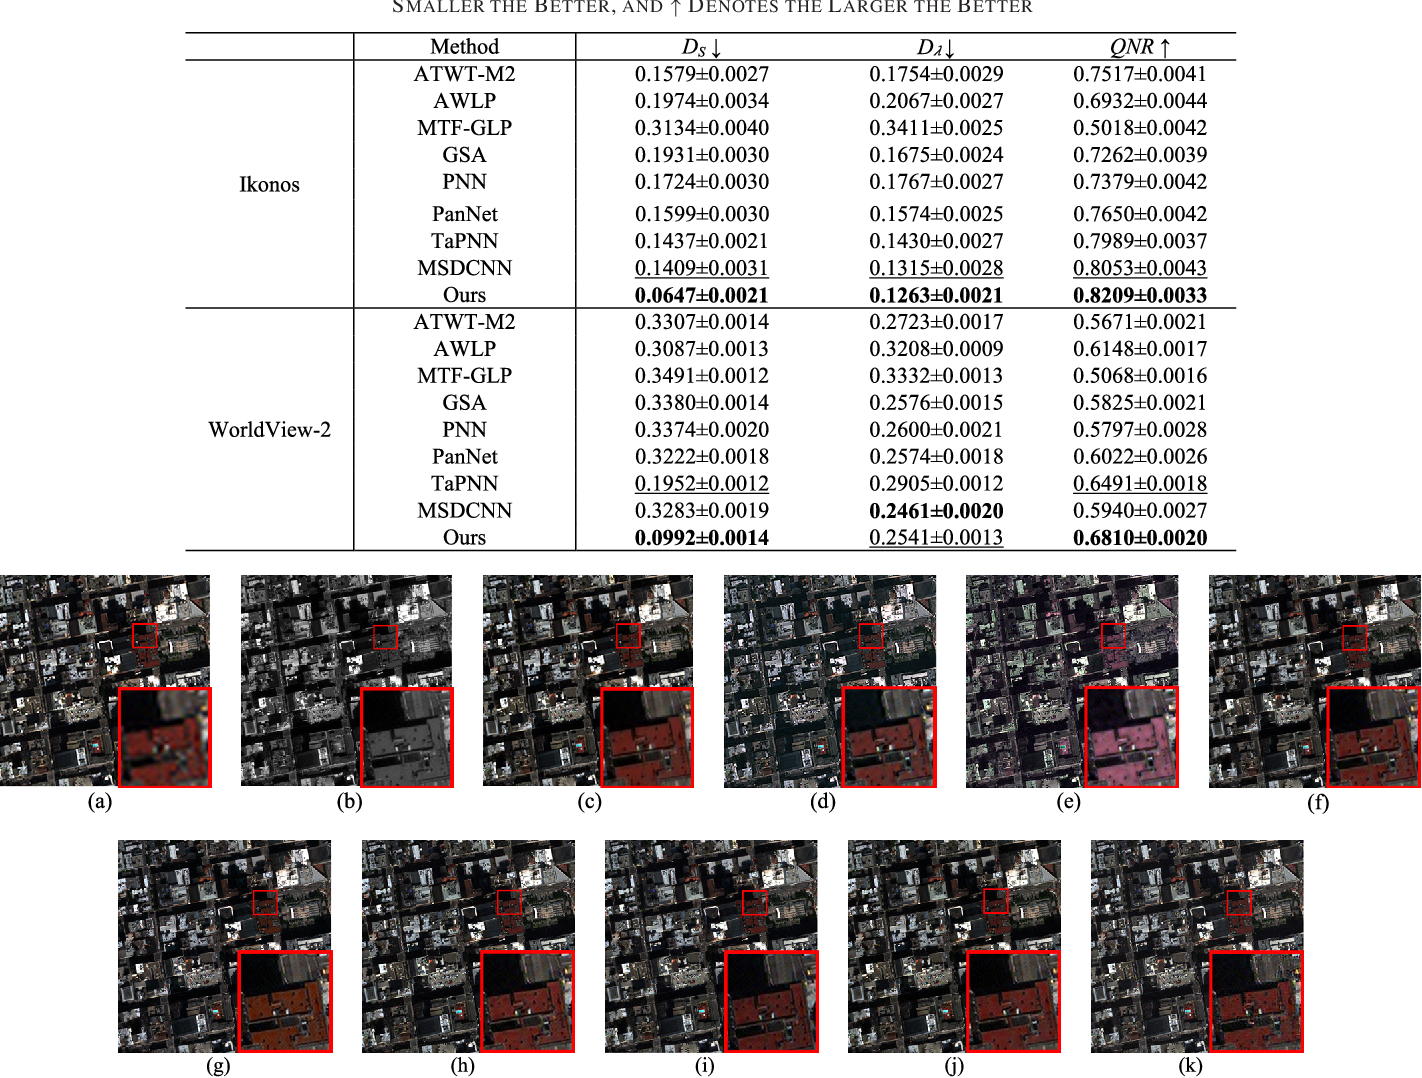
Table IV from Vision Transformer for Pansharpening | Semantic Scholar
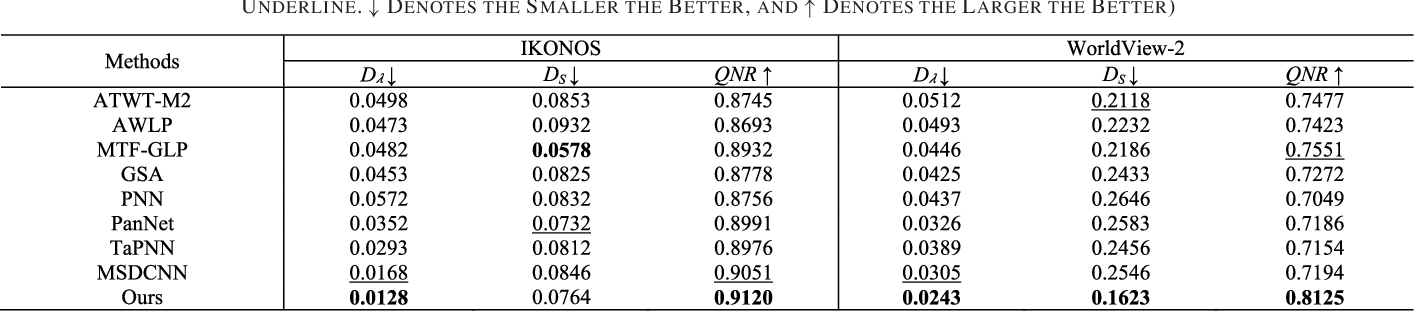
Table III from Vision Transformer for Pansharpening | Semantic Scholar
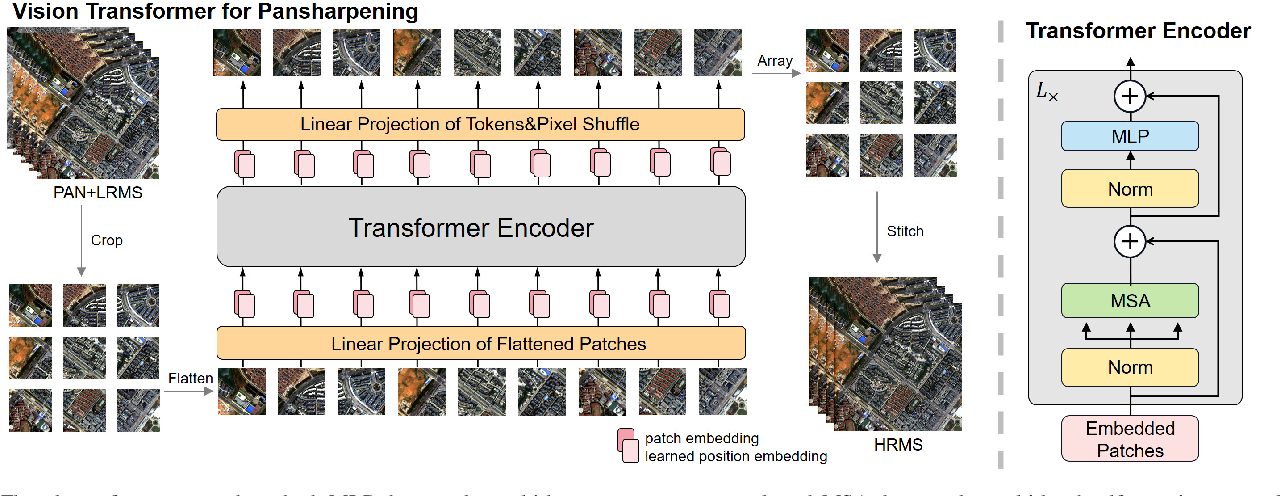
Figure 2 from Vision Transformer for Pansharpening | Semantic Scholar
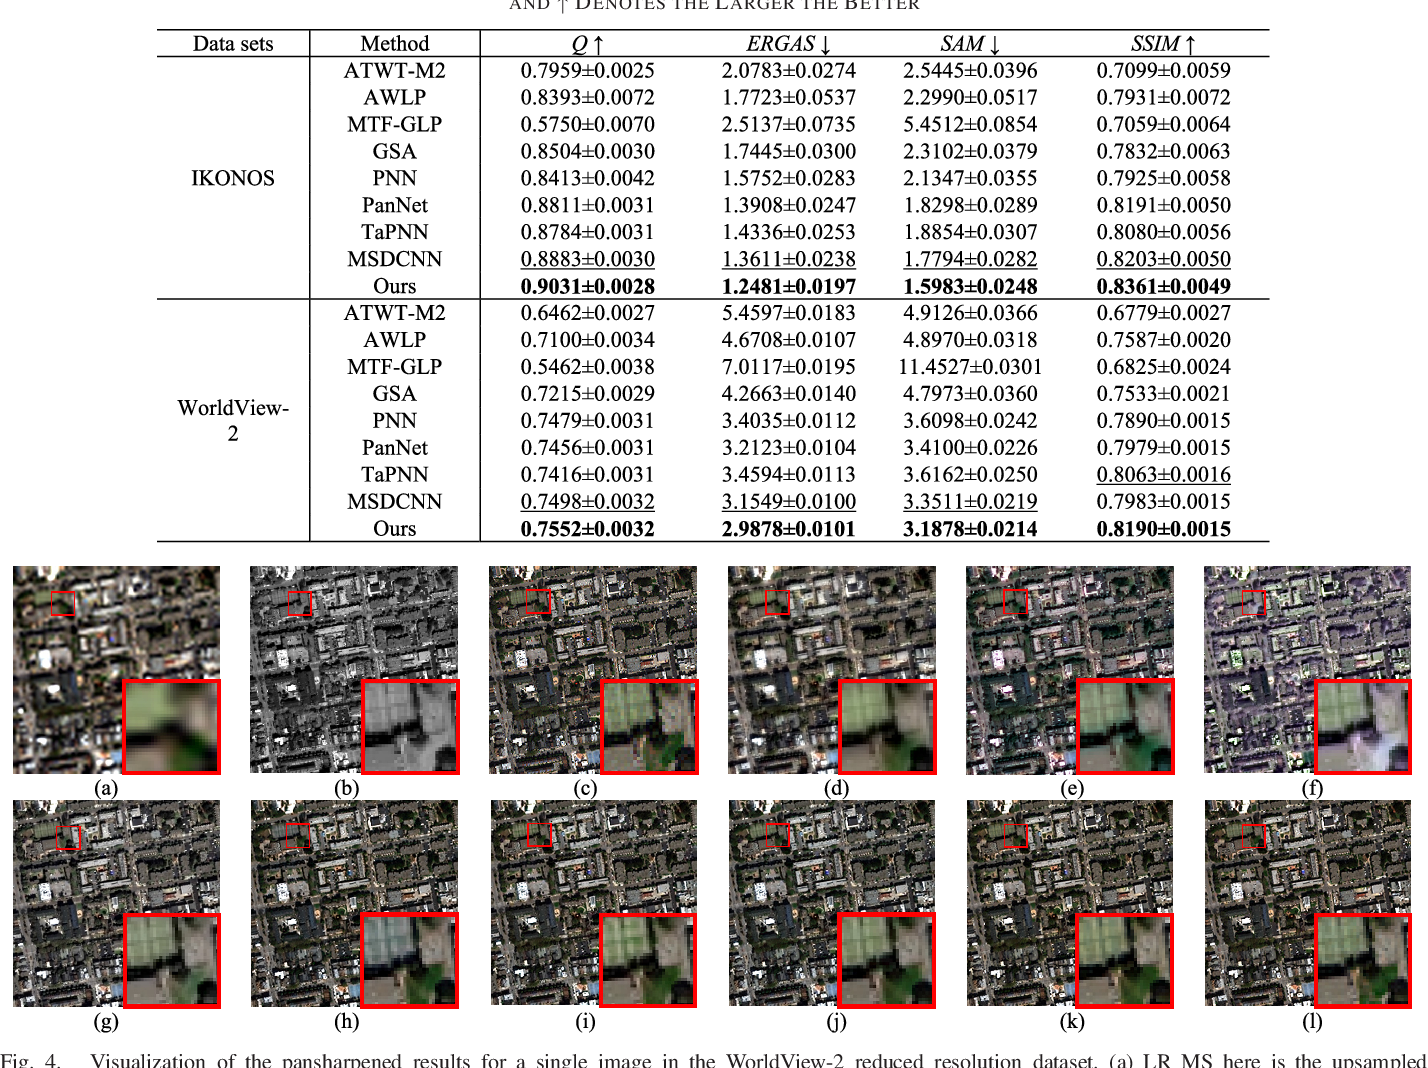
Figure 4 from Vision Transformer for Pansharpening | Semantic Scholar

Figure 1 from Vision Transformer for Pansharpening | Semantic Scholar

Figure 1 from Vision Transformer for Pansharpening | Semantic Scholar

Figure 1 from Vision Transformer for Pansharpening | Semantic Scholar

Figure 1 from Vision Transformer for Pansharpening | Semantic Scholar

Figure 1 from Vision Transformer for Pansharpening | Semantic Scholar
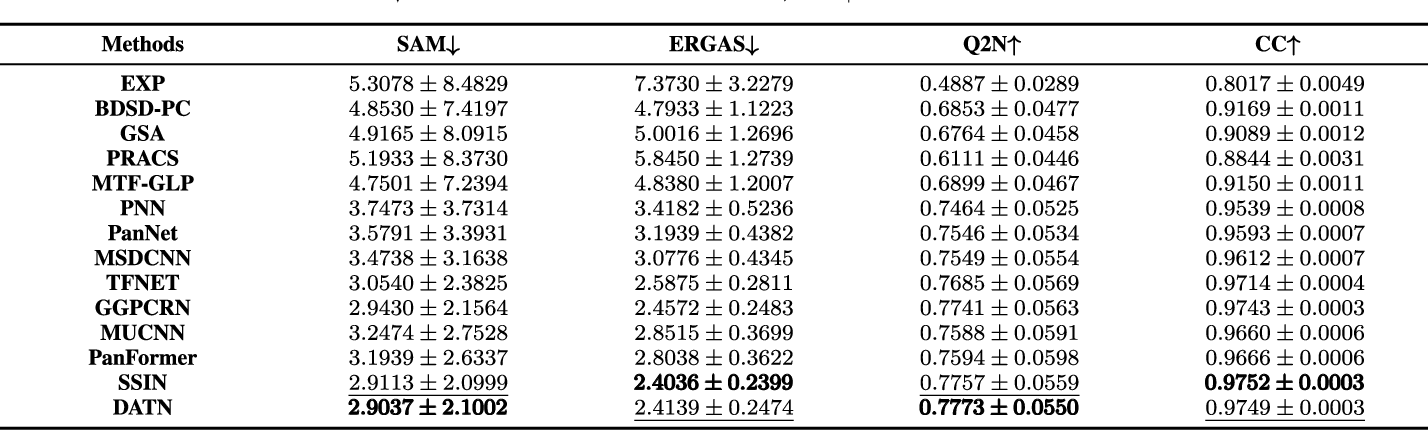
Table IV from A Dual-Attention Transformer Network for Pansharpening ...
Advertisement Space (300x250)
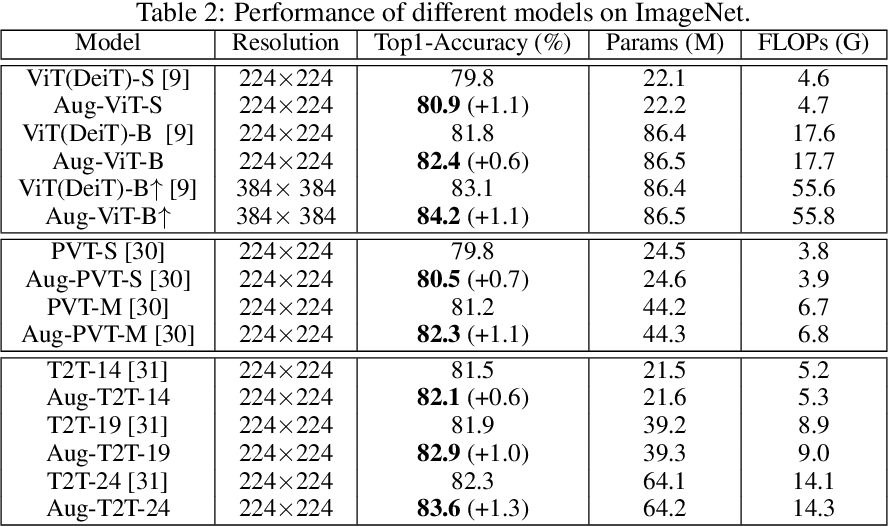
Table 1 from Augmented Shortcuts for Vision Transformers | Semantic Scholar

Table I from Multi-Scale Convolutional Vision Transformer for Semantic ...

Table 1 from Exploring Vision Transformer Layer Choosing for Semantic ...

Table 3 from Exploring Vision Transformer Layer Choosing for Semantic ...

Table I from Multi-Scale Convolutional Vision Transformer for Semantic ...
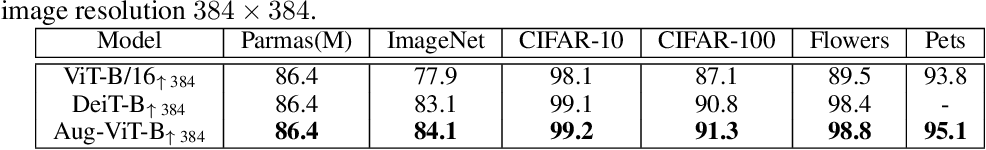
Table 1 from Augmented Shortcuts for Vision Transformers | Semantic Scholar

Table I from Vision Transformers for Single Image Dehazing | Semantic ...

Table 1 from A Simple Vision Transformer for Weakly Semi-supervised 3D ...

Table 1 from Vision Grid Transformer for Document Layout Analysis ...
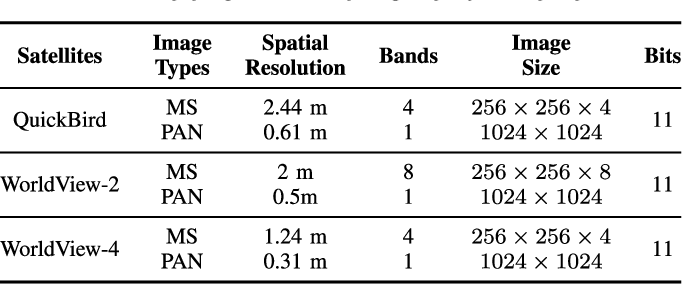
Table I from A Dual-Attention Transformer Network for Pansharpening ...
Advertisement Space (336x280)

Table 4 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 1 from Vision Transformer With Quadrangle Attention | Semantic ...

Table 10 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 1 from CTCP: Cross Transformer and CNN for Pansharpening ...

Table 2 from Vision Transformer With Quadrangle Attention | Semantic ...
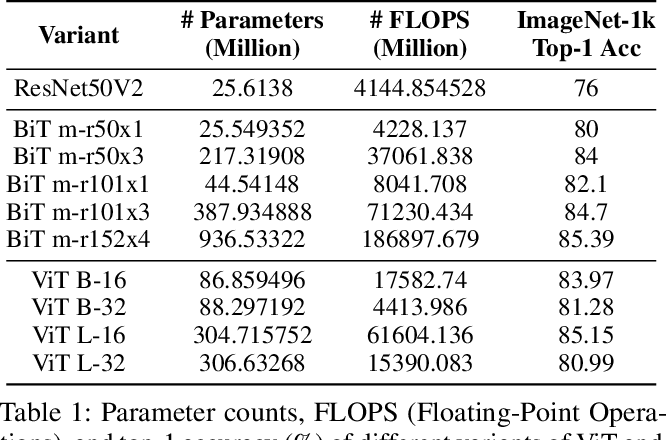
Table 1 from Vision Transformers are Robust Learners | Semantic Scholar
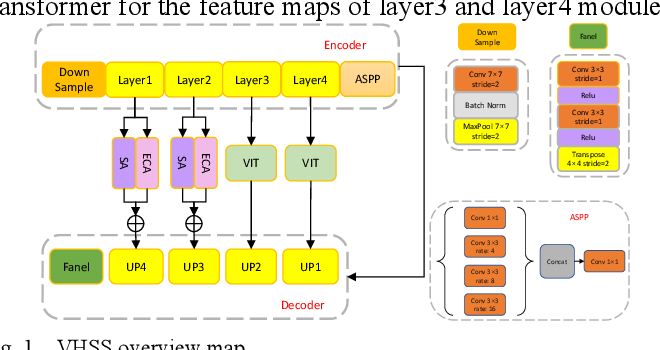
Figure 1 from Vision Transformer is Required for Hyperspectral Semantic ...

Table VIII from A Dual-Attention Transformer Network for Pansharpening ...

Table 11 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 2 from CTCP: Cross Transformer and CNN for Pansharpening ...
Advertisement Space (336x280)
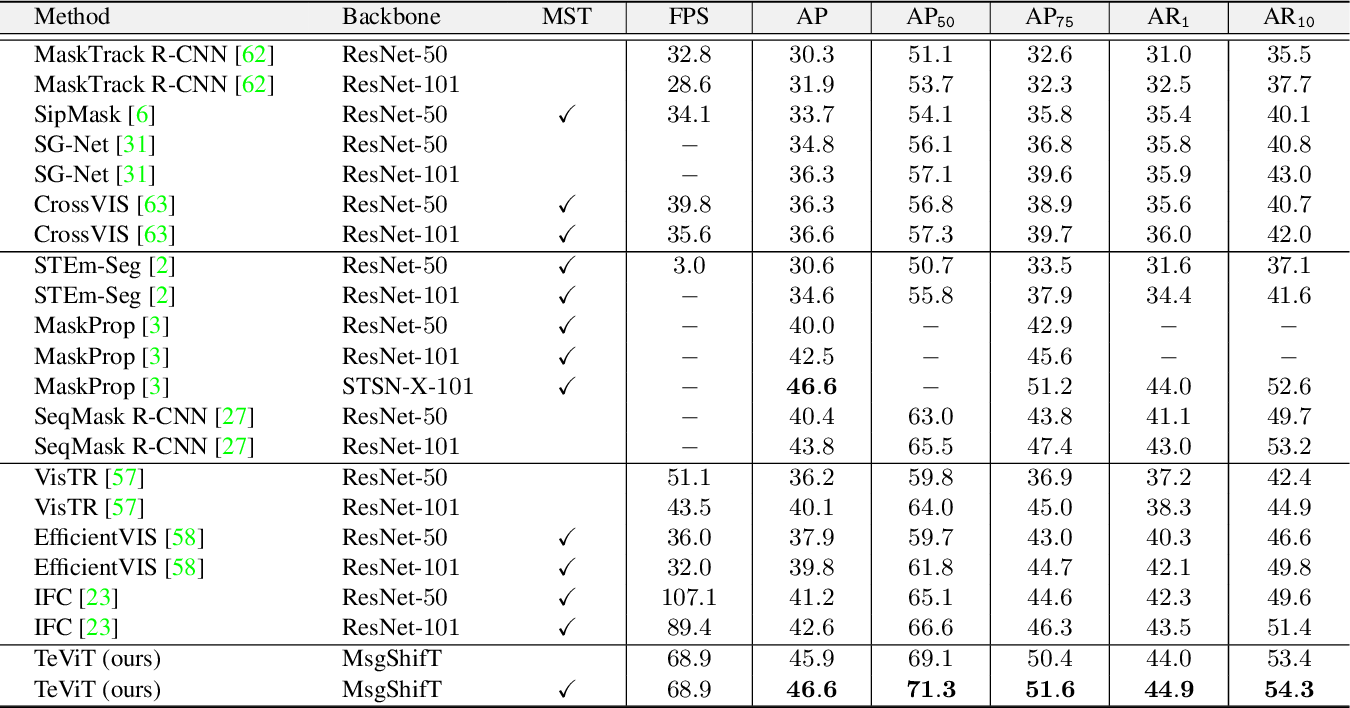
Table 1 from Temporally Efficient Vision Transformer for Video Instance ...
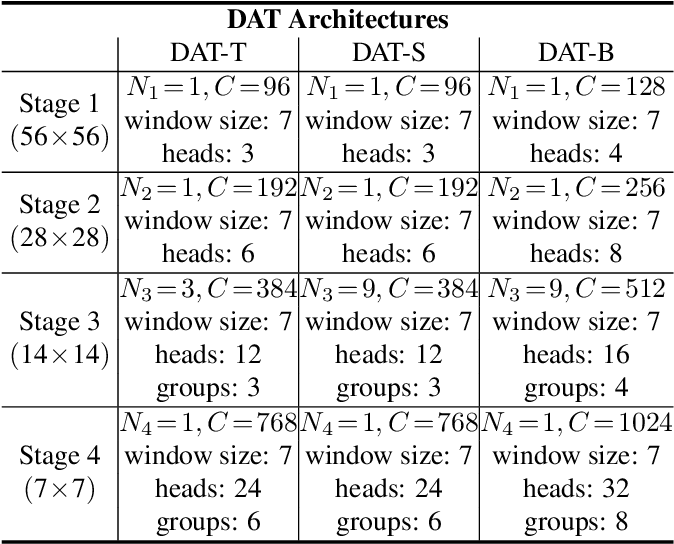
Table 1 from Vision Transformer with Deformable Attention | Semantic ...
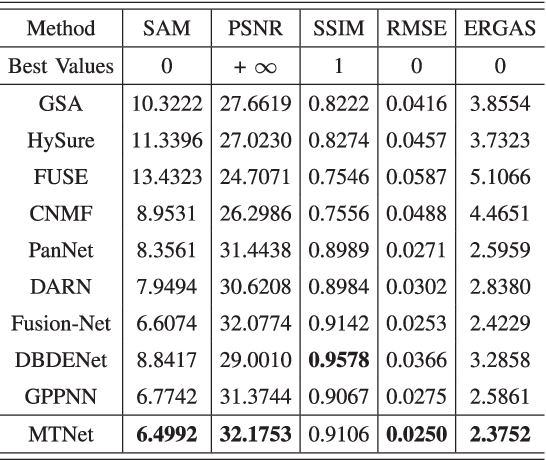
Table IV from A Model-Inspired Approach With Transformers for ...
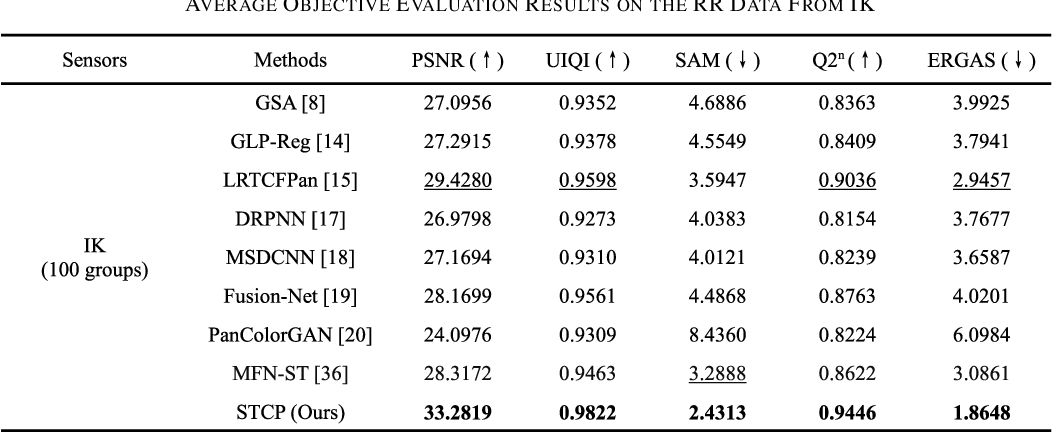
Table IV from STCP: Synergistic Transformer and Convolutional Neural ...
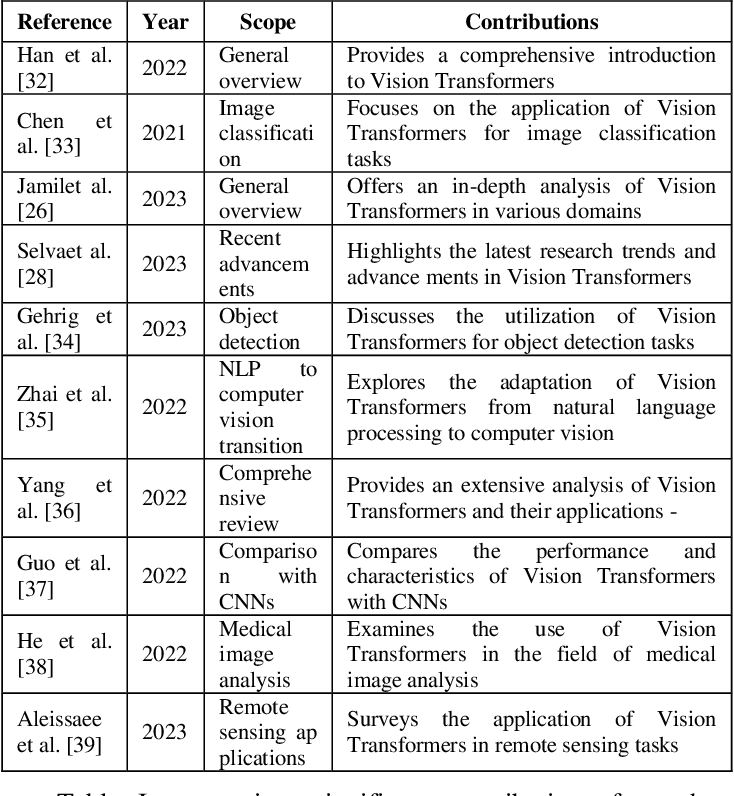
Table I from An Overview of Vision Transformers for Image Processing: A ...
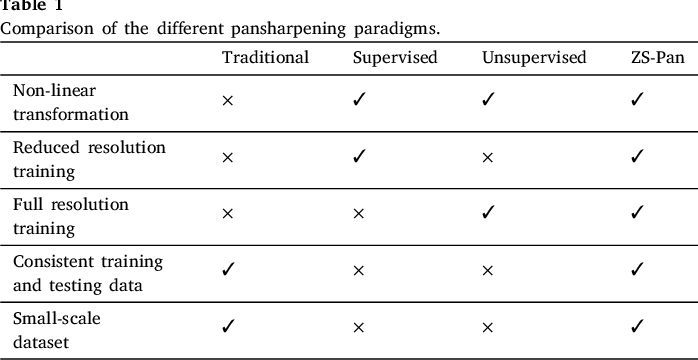
Table 1 from Zero-shot semi-supervised learning for pansharpening ...