
Figure 3 From A Foundational Multimodal Vision Language Ai Assistant
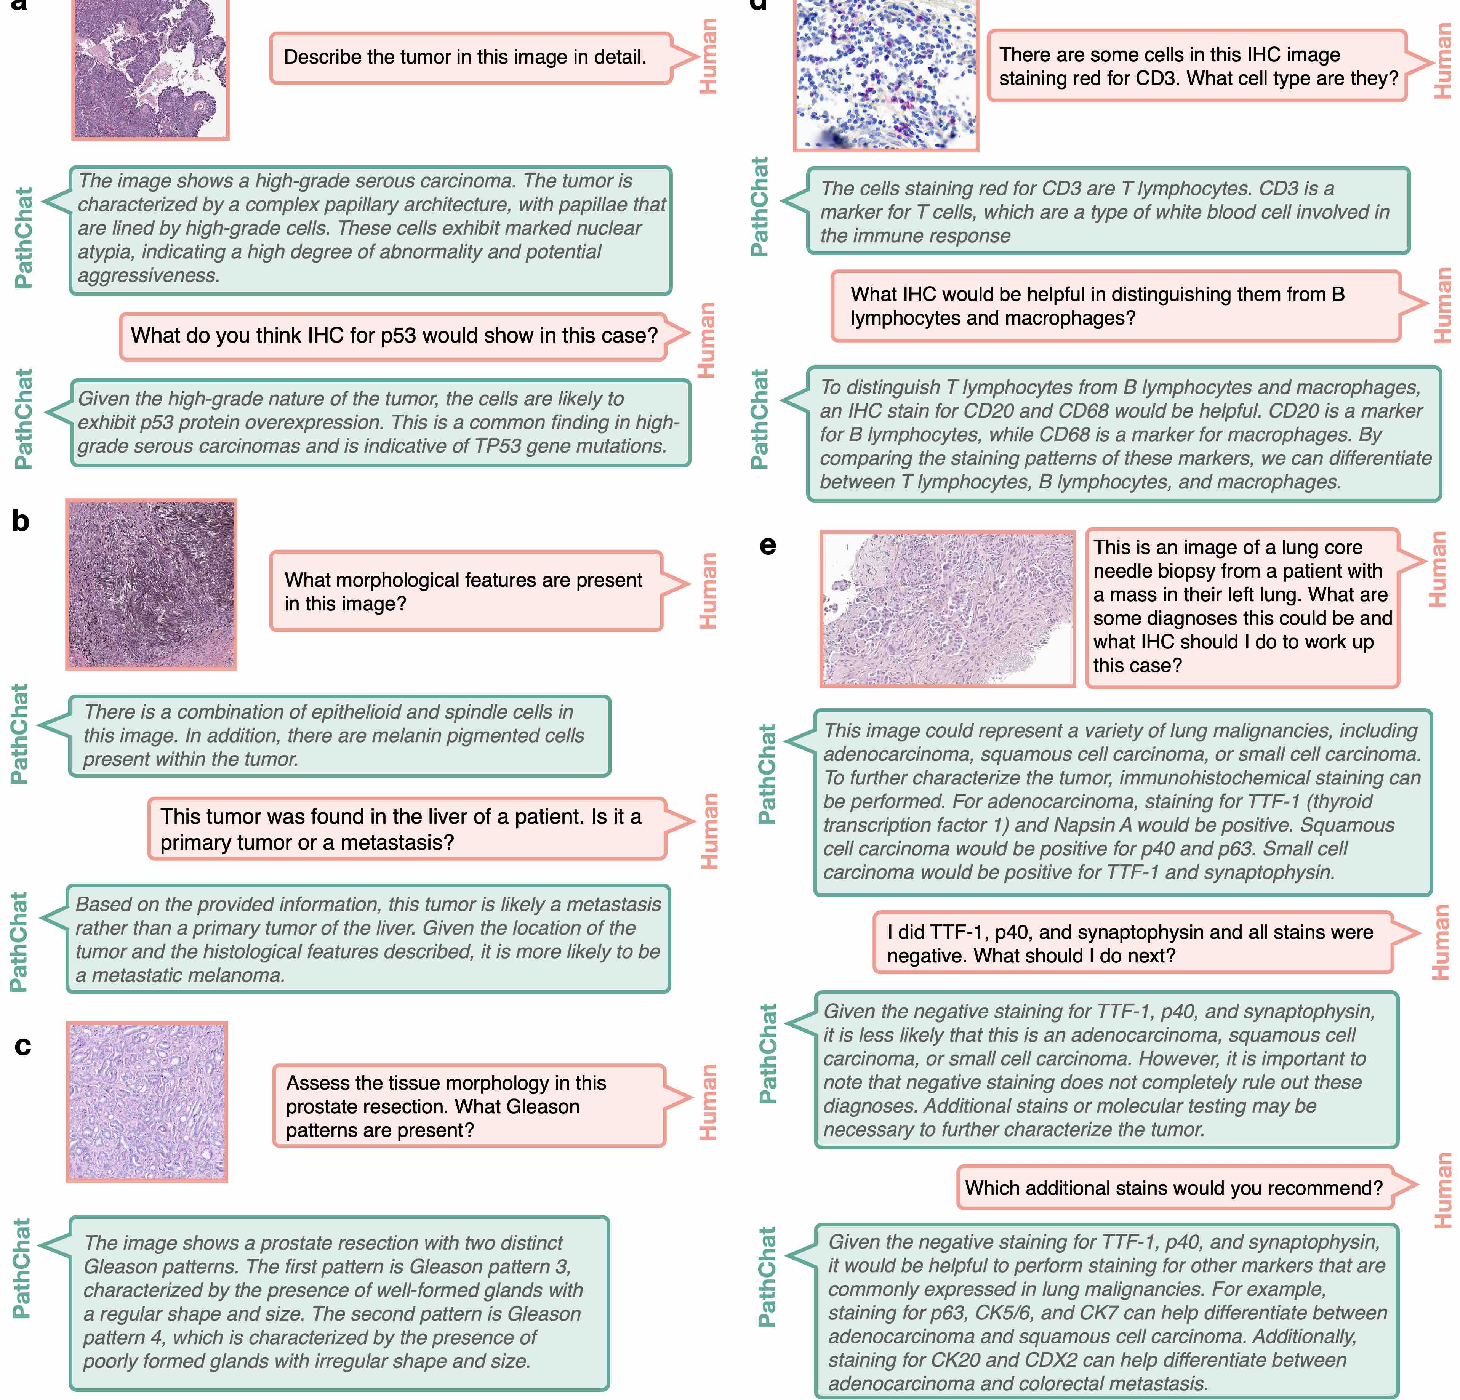
Figure 3 from A Foundational Multimodal Vision Language AI Assistant ...

A Foundational Multimodal Vision Language AI Assistant for Human ...

A Foundational Multimodal Vision Language AI Assistant for Human ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...

[2312.07814] A Foundational Multimodal Vision Language AI Assistant for ...
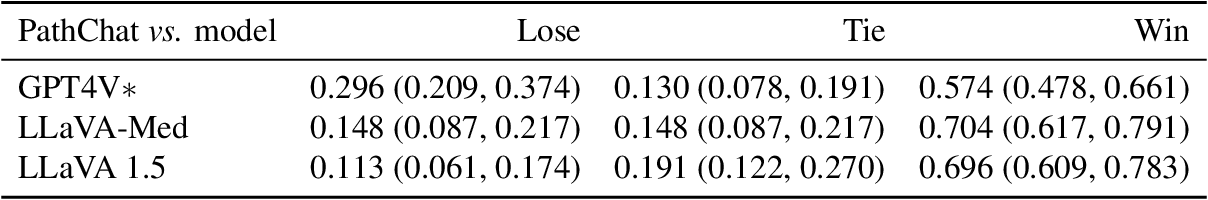
A Foundational Multimodal Vision Language AI Assistant for Human Pathology

Figure 3 from Multimodal Sensing-Enabled Large Language Models for ...
Multimodal AI: A Guide to Open-Source Vision Language Models
Advertisement Space (300x250)
Demystifying Vision Language Models (VLMs): The Core of Multimodal AI

Vision Language Models: The Future Of Multimodal AI 2025 - FireXCore
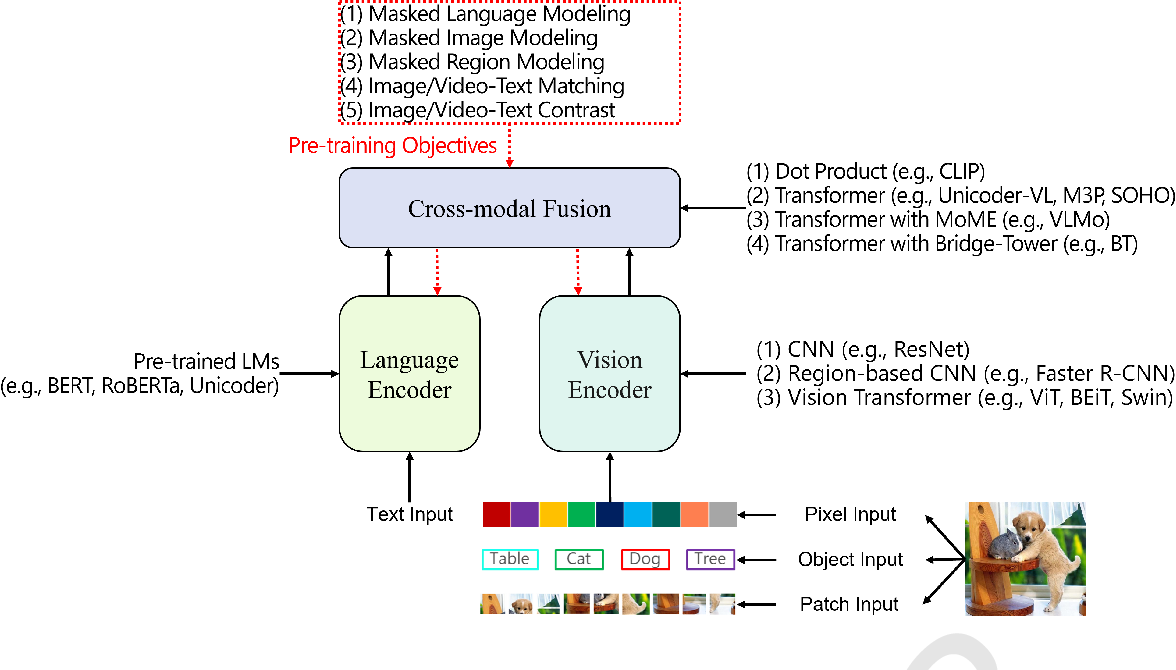
Figure 1 from Frontier Review of Multimodal AI | Semantic Scholar
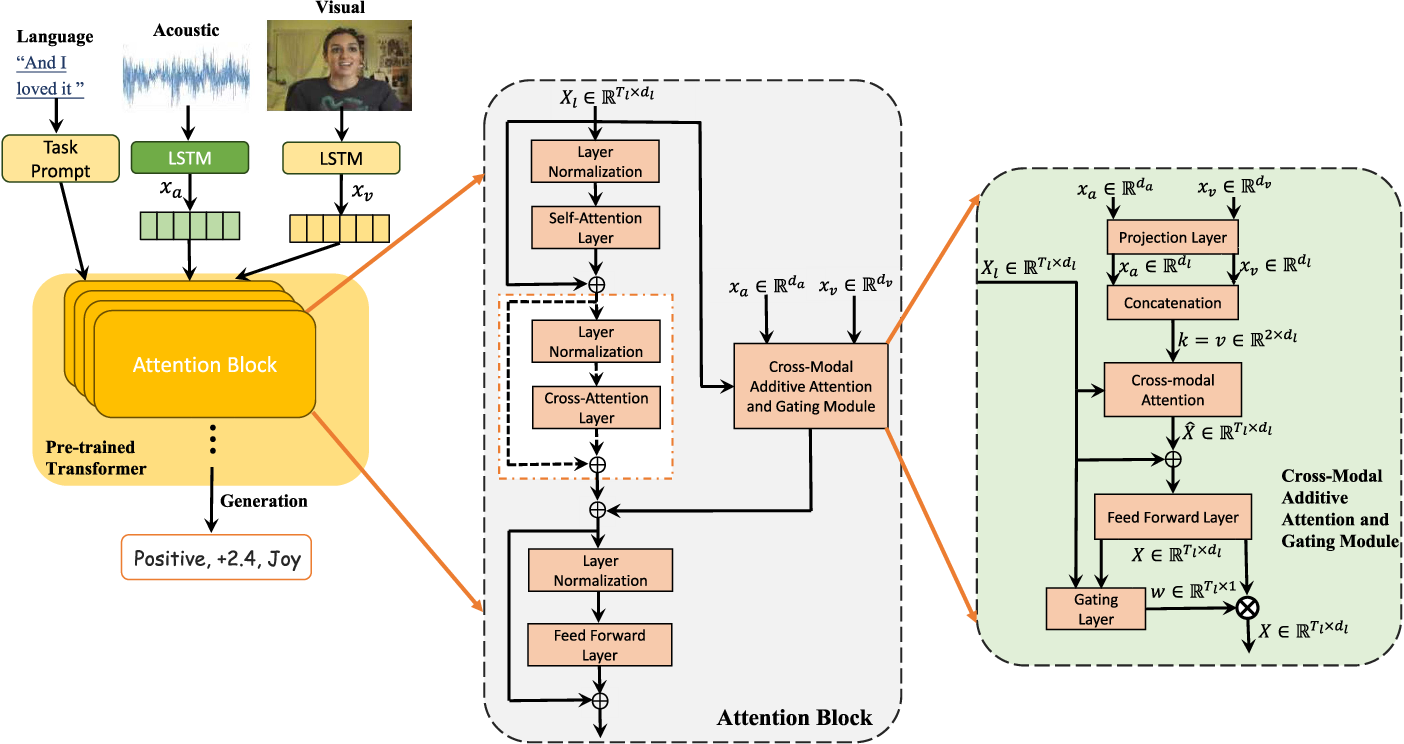
Figure 3 from Injecting Multimodal Information Into Pre-Trained ...
Best Vision Language Models 2026 - Multimodal AI Comparison | EvoArt.ai ...

Figure 1 from Design of Generative Multimodal AI Agents to Enable ...
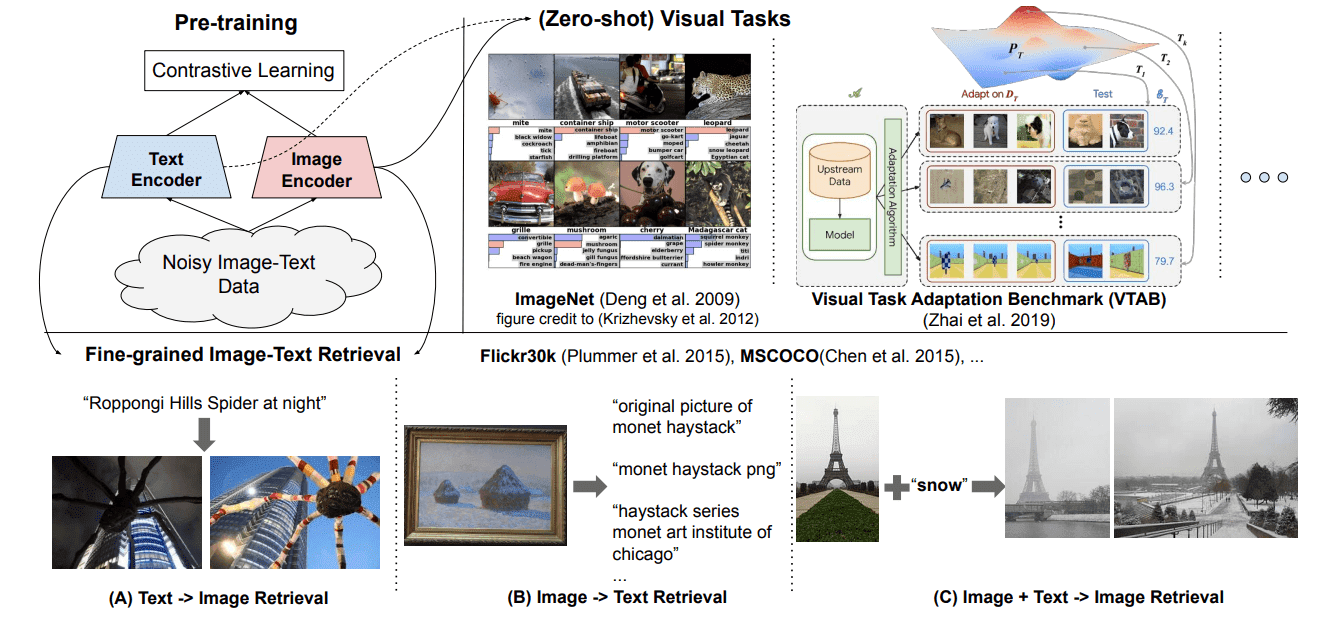
Vision Language models: towards multi-modal deep learning | AI Summer
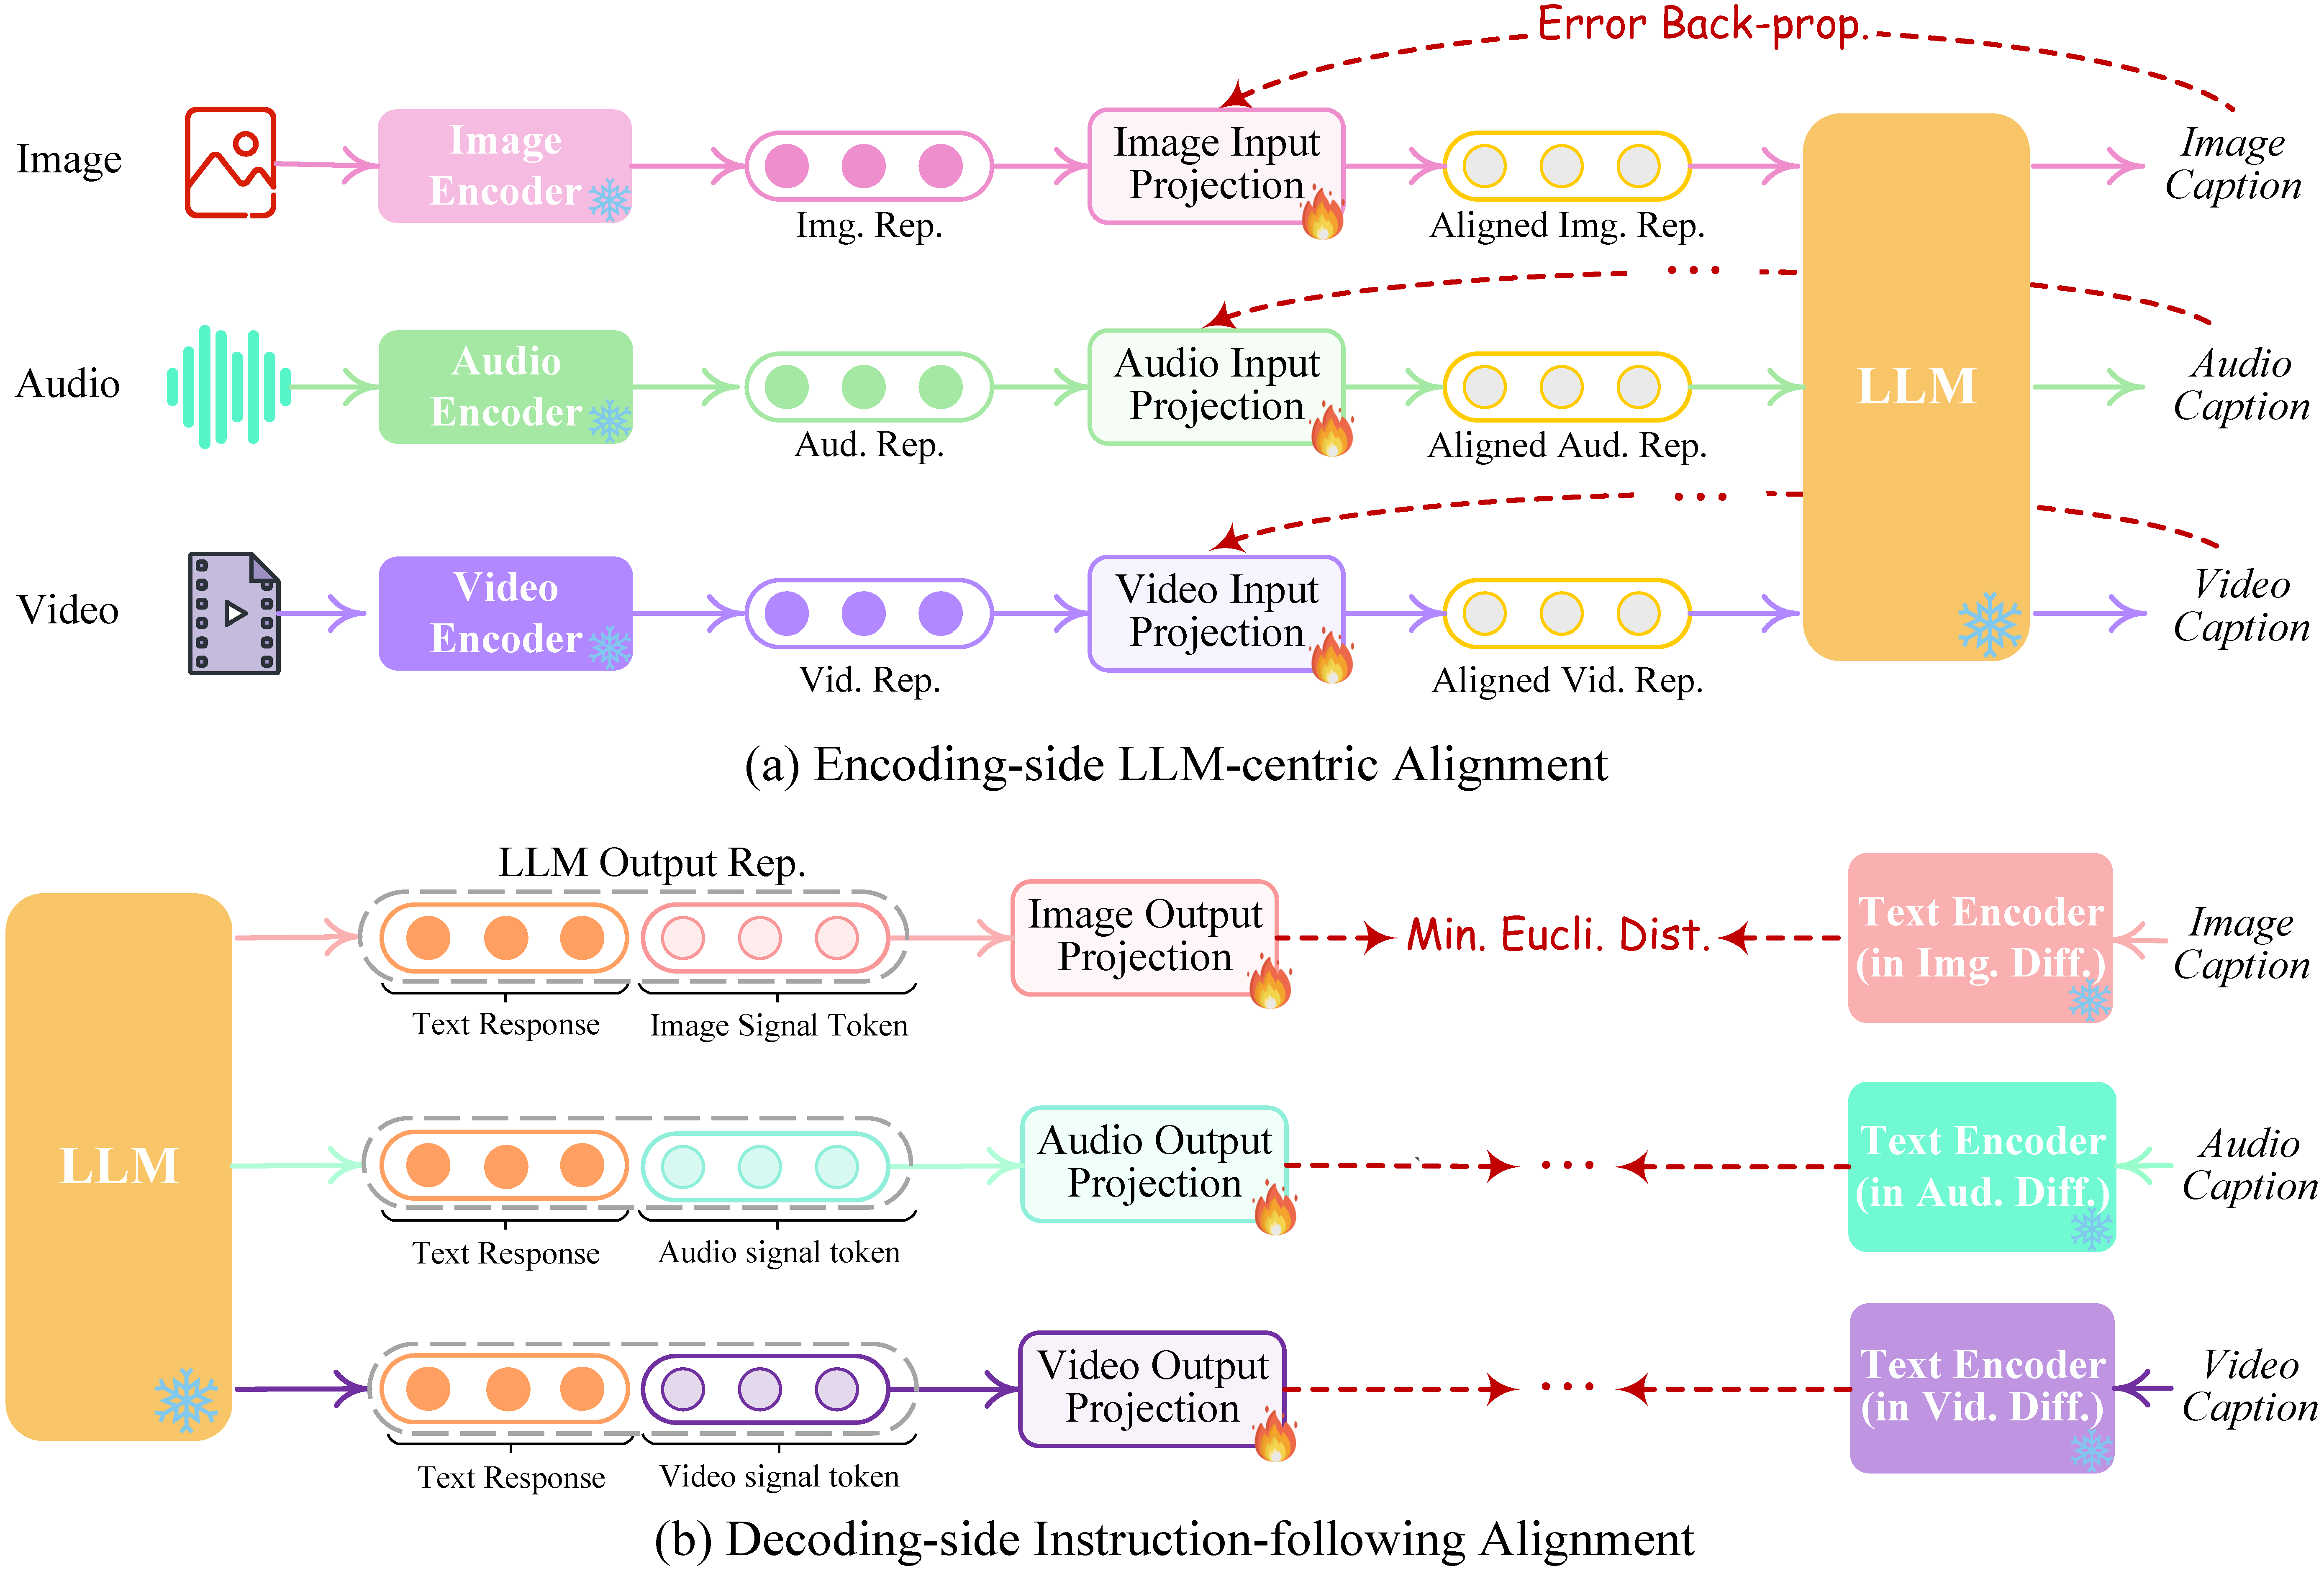
Aman's AI Journal • Primers • Vision Language Models
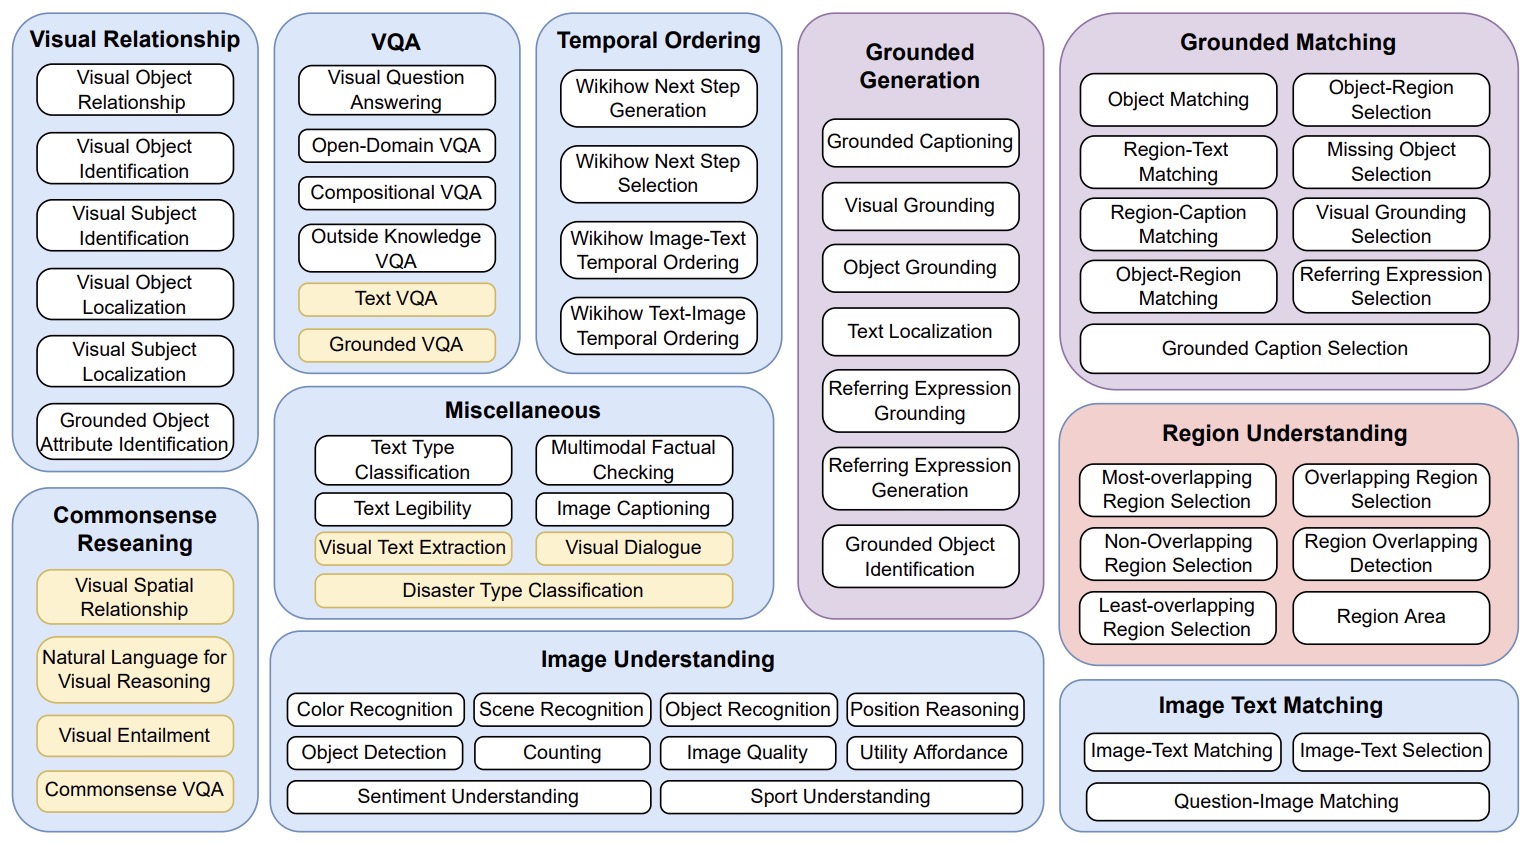
Aman's AI Journal • Primers • Vision Language Models

Multimodal Fusion and Vision-Language Models: A Survey for Robot Vision ...
Advertisement Space (336x280)

Multimodal & Foundation Vision AI

Figure 1 from Are Vision-Language Transformers Learning Multimodal ...

From Large Language Models to Foundation Models: The Multimodal Future ...
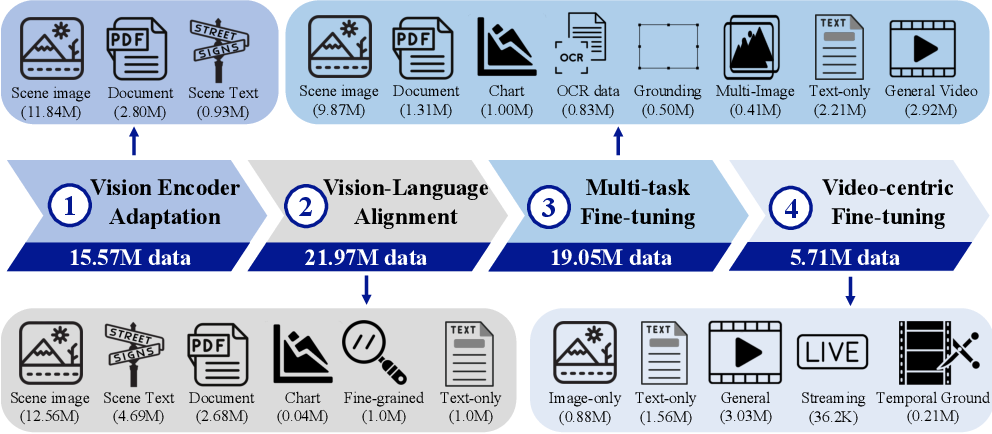
Figure 2 from VideoLLaMA 3: Frontier Multimodal Foundation Models for ...
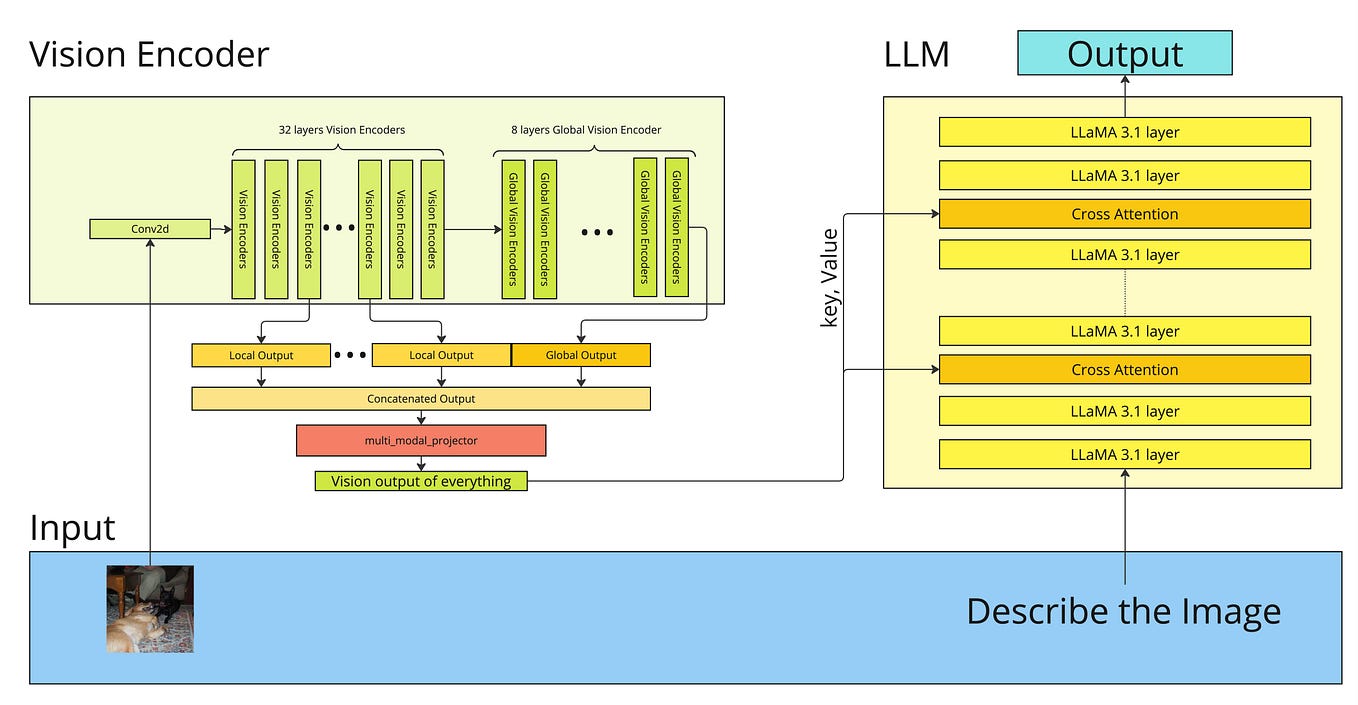
Introduction to LLaVA: A Multimodal AI Model | by Uddeshya Singh | Medium

Build Your Own Multimodal AI: A Complete Guide to Customizing Vision ...

Publications | Vision & Language for Autonomous AI (VL4AI) Research
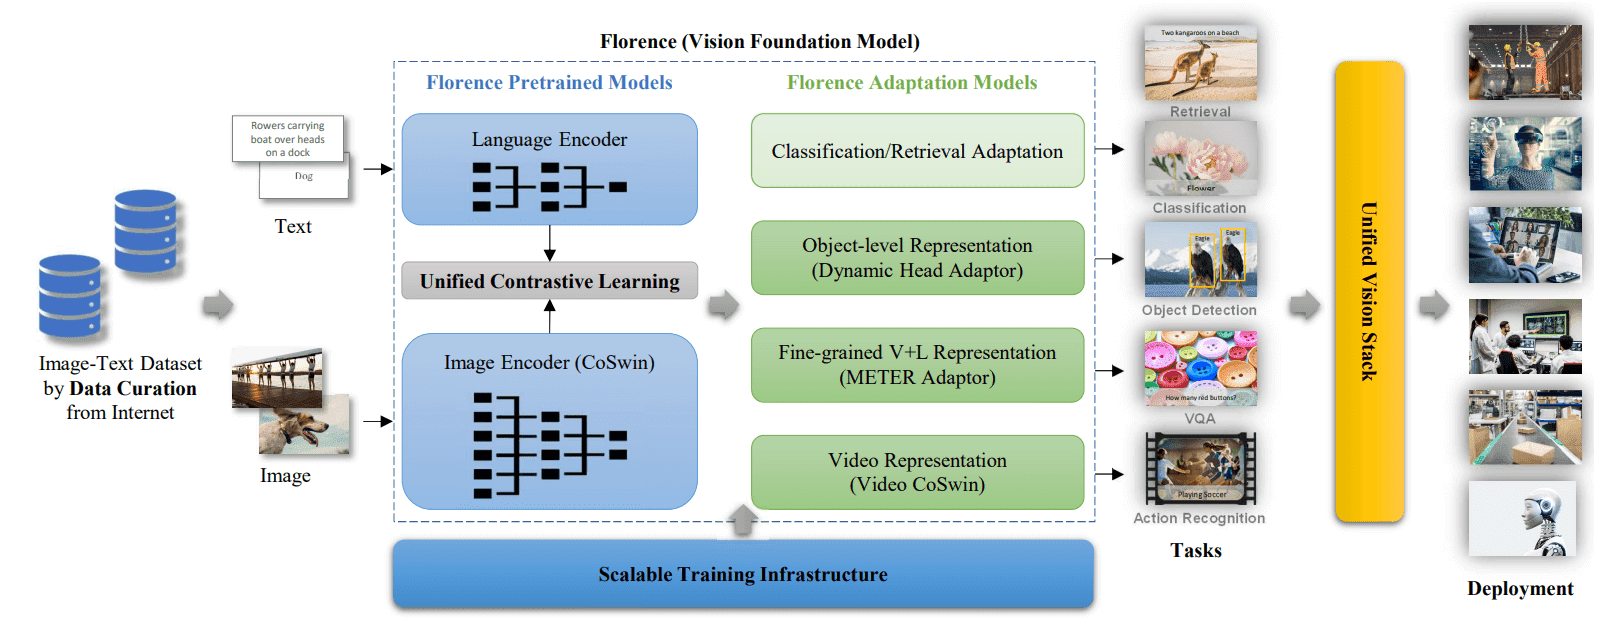
Vision Language models: towards multi-modal deep learning | AI Summer

Multimodal AI Breakthroughs: Gemini 3, AlphaFold 3 & GPT-4o
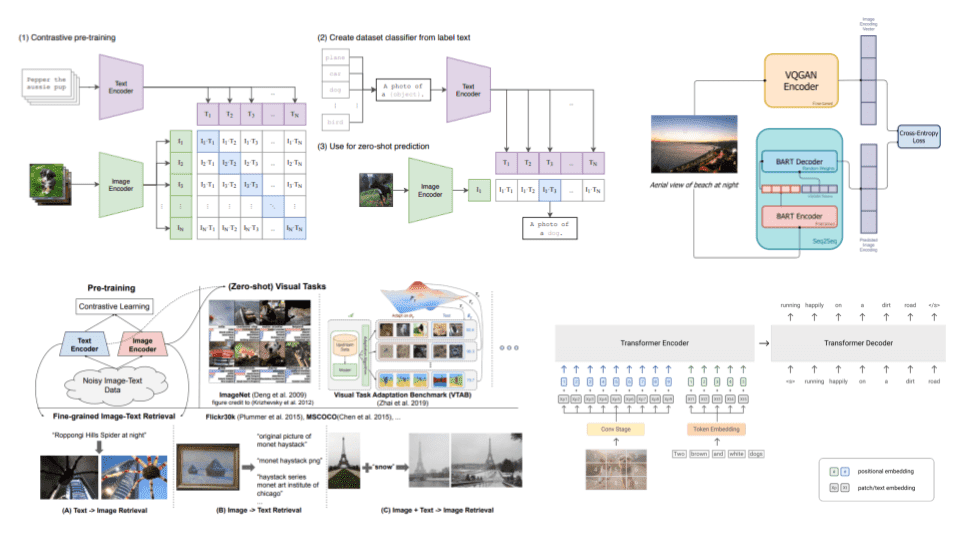
Vision Language models: towards multi-modal deep learning | AI Summer
Advertisement Space (336x280)

Multimodal Large Language Models: Transforming Computer Vision - Edge ...

Microsoft Researchers Present Magma: A Multimodal AI Model Integrating ...

Meta AI Introduces AnyMAL: The Future of Multimodal Language Models ...
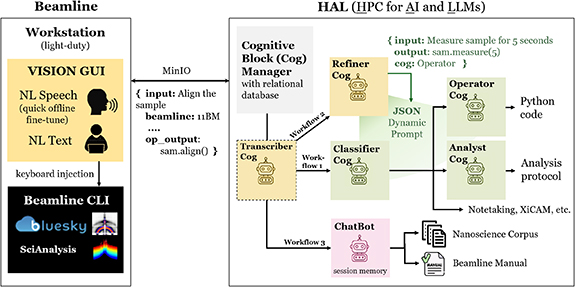
VISION: a modular AI assistant for natural human-instrument interaction ...
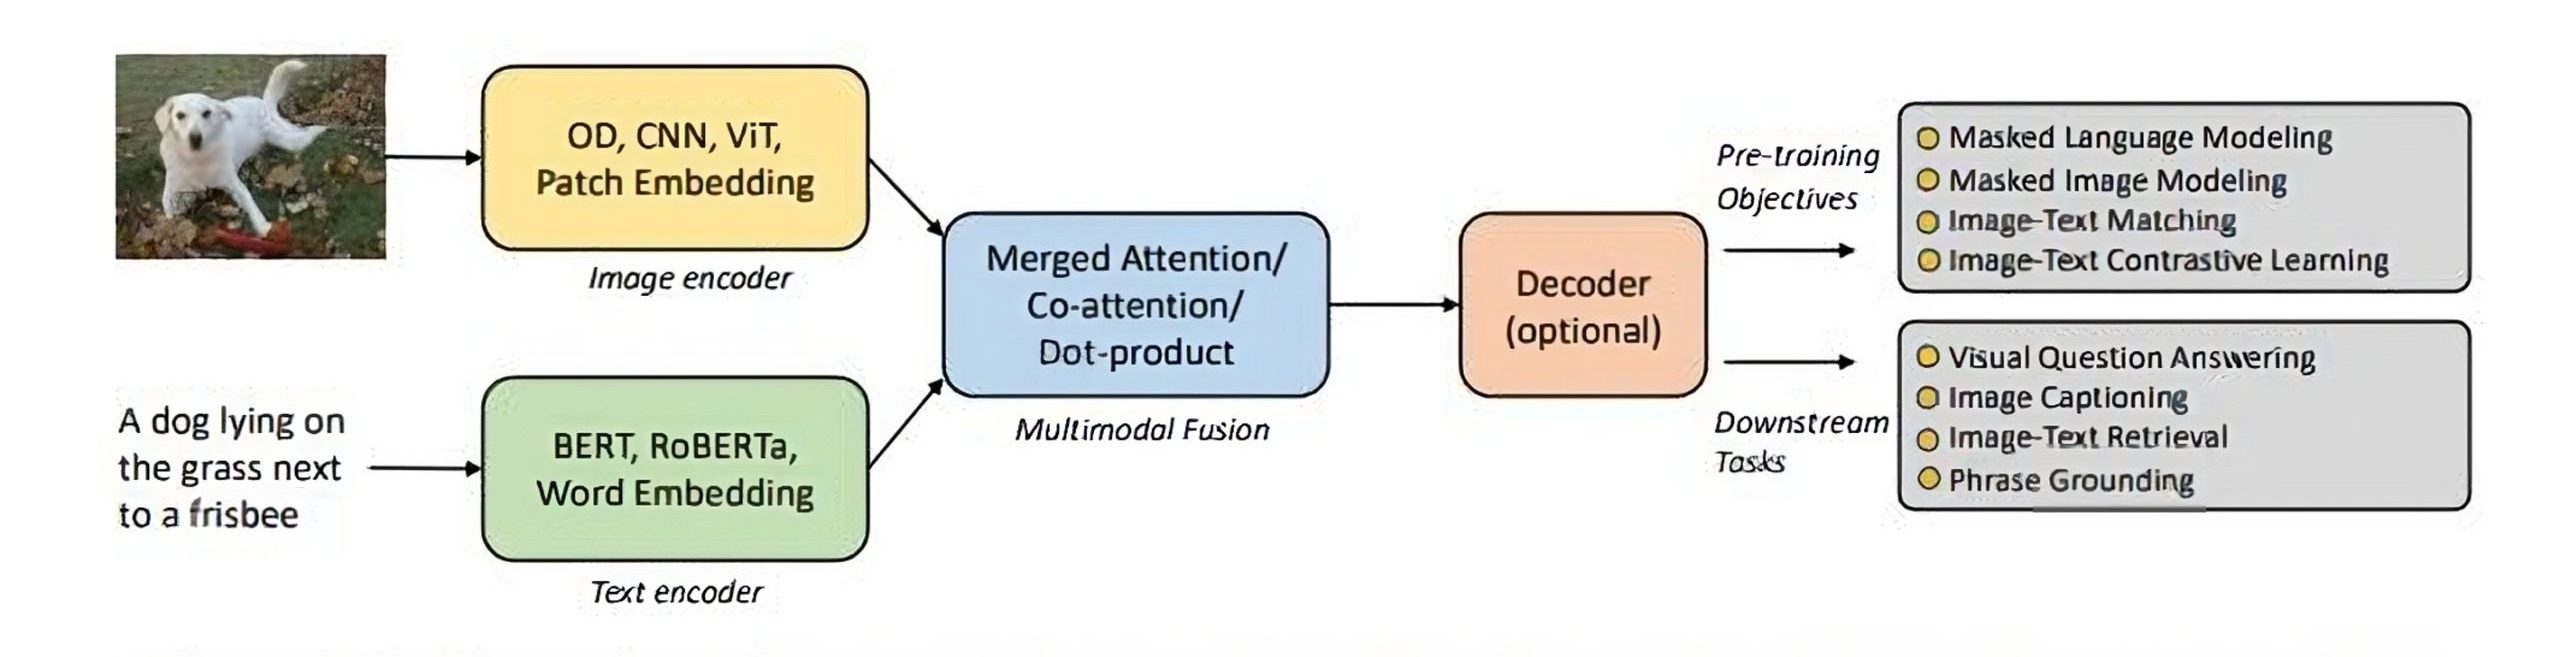
Unlock AI Potential with Vision Language Models
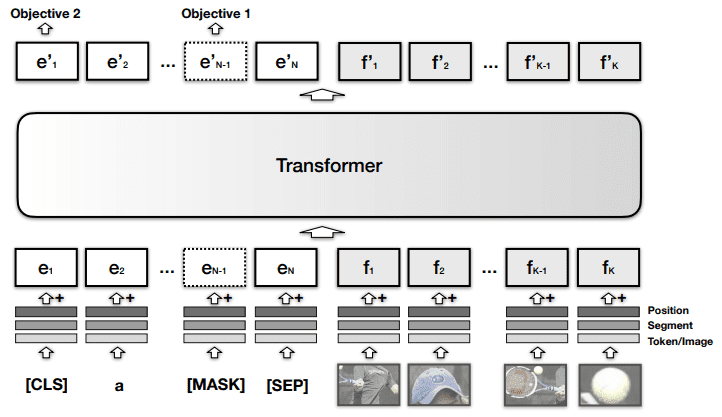
Vision Language models: towards multi-modal deep learning | AI Summer