
Figure 3 From Prompting Multi Modal Image Segmentation With Semantic

Figure 3 from Prompting Multi-Modal Image Segmentation with Semantic ...

Figure 2 from Prompting Multi-Modal Image Segmentation with Semantic ...

Figure 2 from Prompting Multi-Modal Image Segmentation with Semantic ...

Figure 4 from Prompting Multi-Modal Image Segmentation with Semantic ...

Figure 6 from Prompting Multi-Modal Image Segmentation with Semantic ...

Table 3 from Prompting Multi-Modal Image Segmentation with Semantic ...

Figure 3 from Enhancing Weakly Supervised Semantic Segmentation with ...
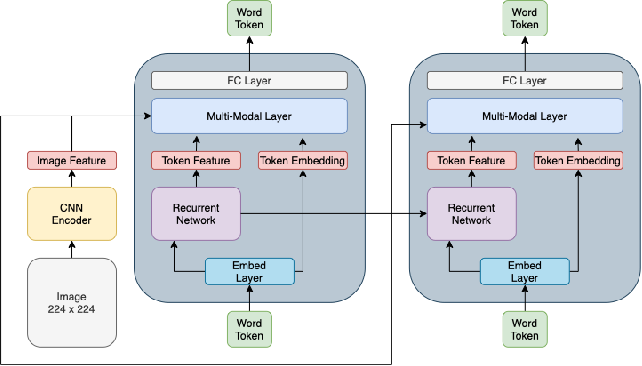
Figure 3 from Multi-Modal Image Captioning | Semantic Scholar

Figure 3 from A 3D Framework for Brain Tumor Segmentation from Multi ...

Prompting Multi-Modal Image Segmentation with Semantic Grouping | Underline
Advertisement Space (300x250)
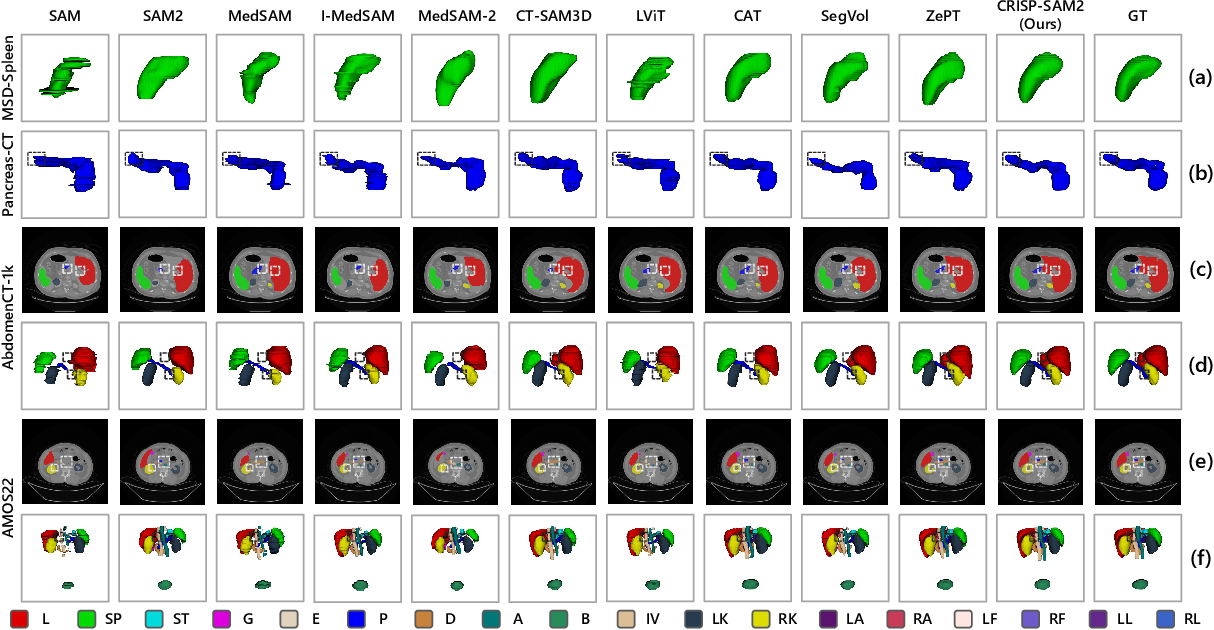
Figure 3 from CRISP-SAM2: SAM2 with Cross-Modal Interaction and ...

Figure 3 from Multi-Modal Attribute Prompting for Vision-Language ...

Figure 1 from Prompting for Multi-Modal Tracking | Semantic Scholar

Figure 3 from Visual Prompt Multi-Modal Tracking | Semantic Scholar

Figure 2 from Multi-Modal Prototypes for Open-Set Semantic Segmentation ...
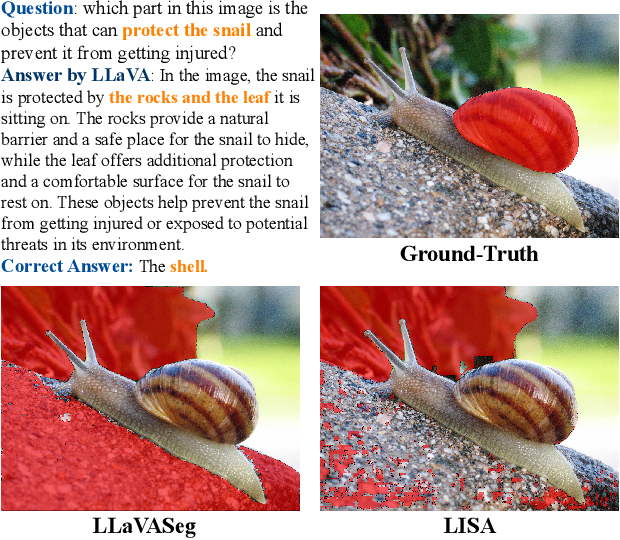
Figure 3 from Empowering Segmentation Ability to Multi-modal Large ...

Figure 3 from Class-Prompting Transformer for Incremental Semantic ...

Figure 2 from Prompting for Multi-Modal Tracking | Semantic Scholar

Figure 1 from Continual Road-Scene Semantic Segmentation via Feature ...

Multi Modal Semantic Segmentation using Synthetic Data | DeepAI
Advertisement Space (336x280)

Figure 1 from MULTI-MODAL SEMANTIC MESH SEGMENTATION IN URBAN SCENES ...

Figure 3 from MMSFormer: Multimodal Transformer for Material and ...

Figure 3 from Uncertainty Estimation and Visualization for Multi-modal ...
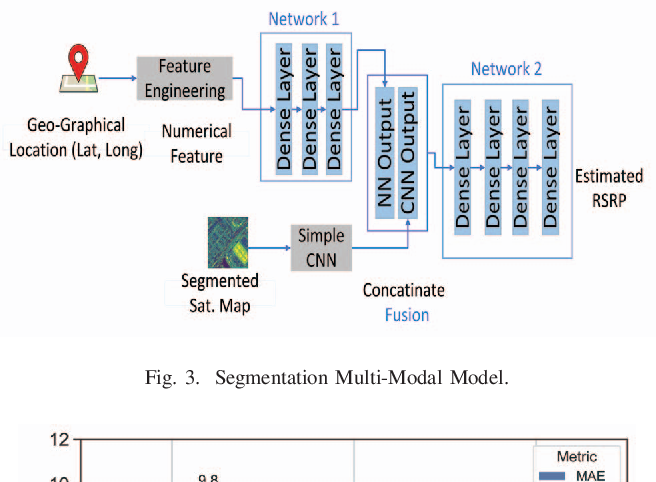
Figure 3 from Highly Accurate Multi-Modal LTE Channel Prediction via ...

Figure 3 from Learning Aligned Cross-modal Representations for ...

Figure 1 from Visual Prompting for Generalized Few-shot Segmentation: A ...

Figure 1 from Modal-aware Visual Prompting for Incomplete Multi-modal ...

Figure 3 from Specific-Modal Spatial Guidance and Feature Enhancement ...

Figure 1 from Modal-aware Visual Prompting for Incomplete Multi-modal ...

Multimodal Image Segmentation with Dynamic Adaptive Window and Cross ...
Advertisement Space (336x280)

ASGT-Net: A Multi-Modal Semantic Segmentation Network with Symmetric ...

Figure 1 from Modal-aware Visual Prompting for Incomplete Multi-modal ...

Figure 2 from Adaptive Multi-Modal Visual Tracking With Dynamic ...

Figure 2 from Customize Segment Anything Model for Multi-Modal Semantic ...

Figure 1 from AutoProSAM: Automated Prompting SAM for 3D Multi-Organ ...

Figure 2 from CRISP-SAM2: SAM2 with Cross-Modal Interaction and ...