
Figure 4 From Glid Pre Training A Generalist Encoder Decoder Vision

Figure 4 from GLID: Pre-training a Generalist Encoder-Decoder Vision ...
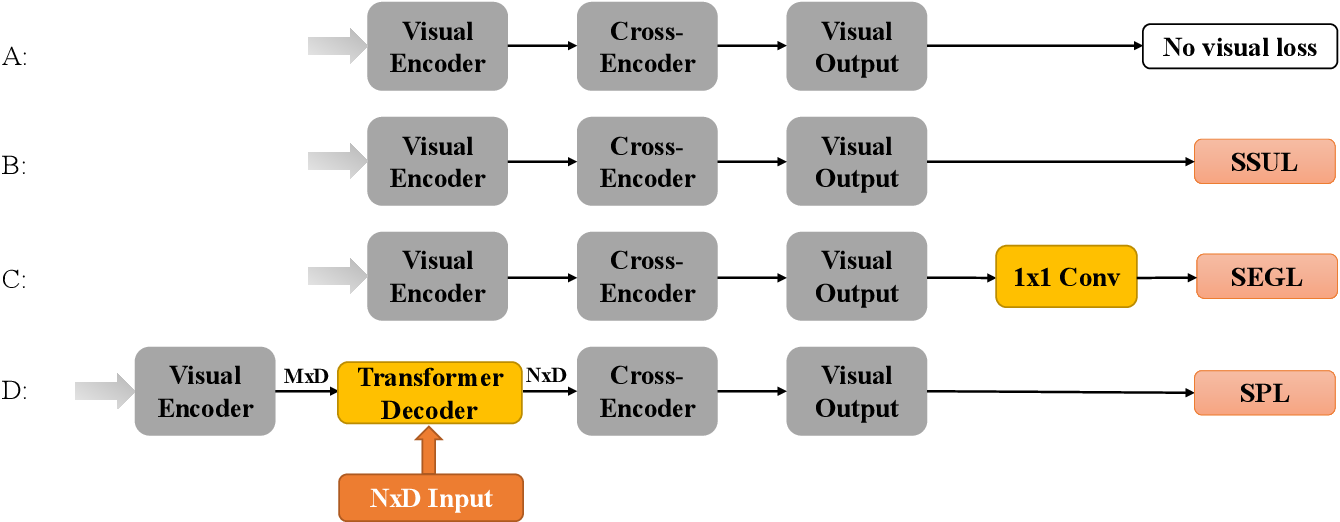
Figure 4 from Effective End-to-End Vision Language Pretraining With ...

Table 1 from GLID: Pre-training a Generalist Encoder-Decoder Vision ...

Figure 10 from GiT: Towards Generalist Vision Transformer through ...
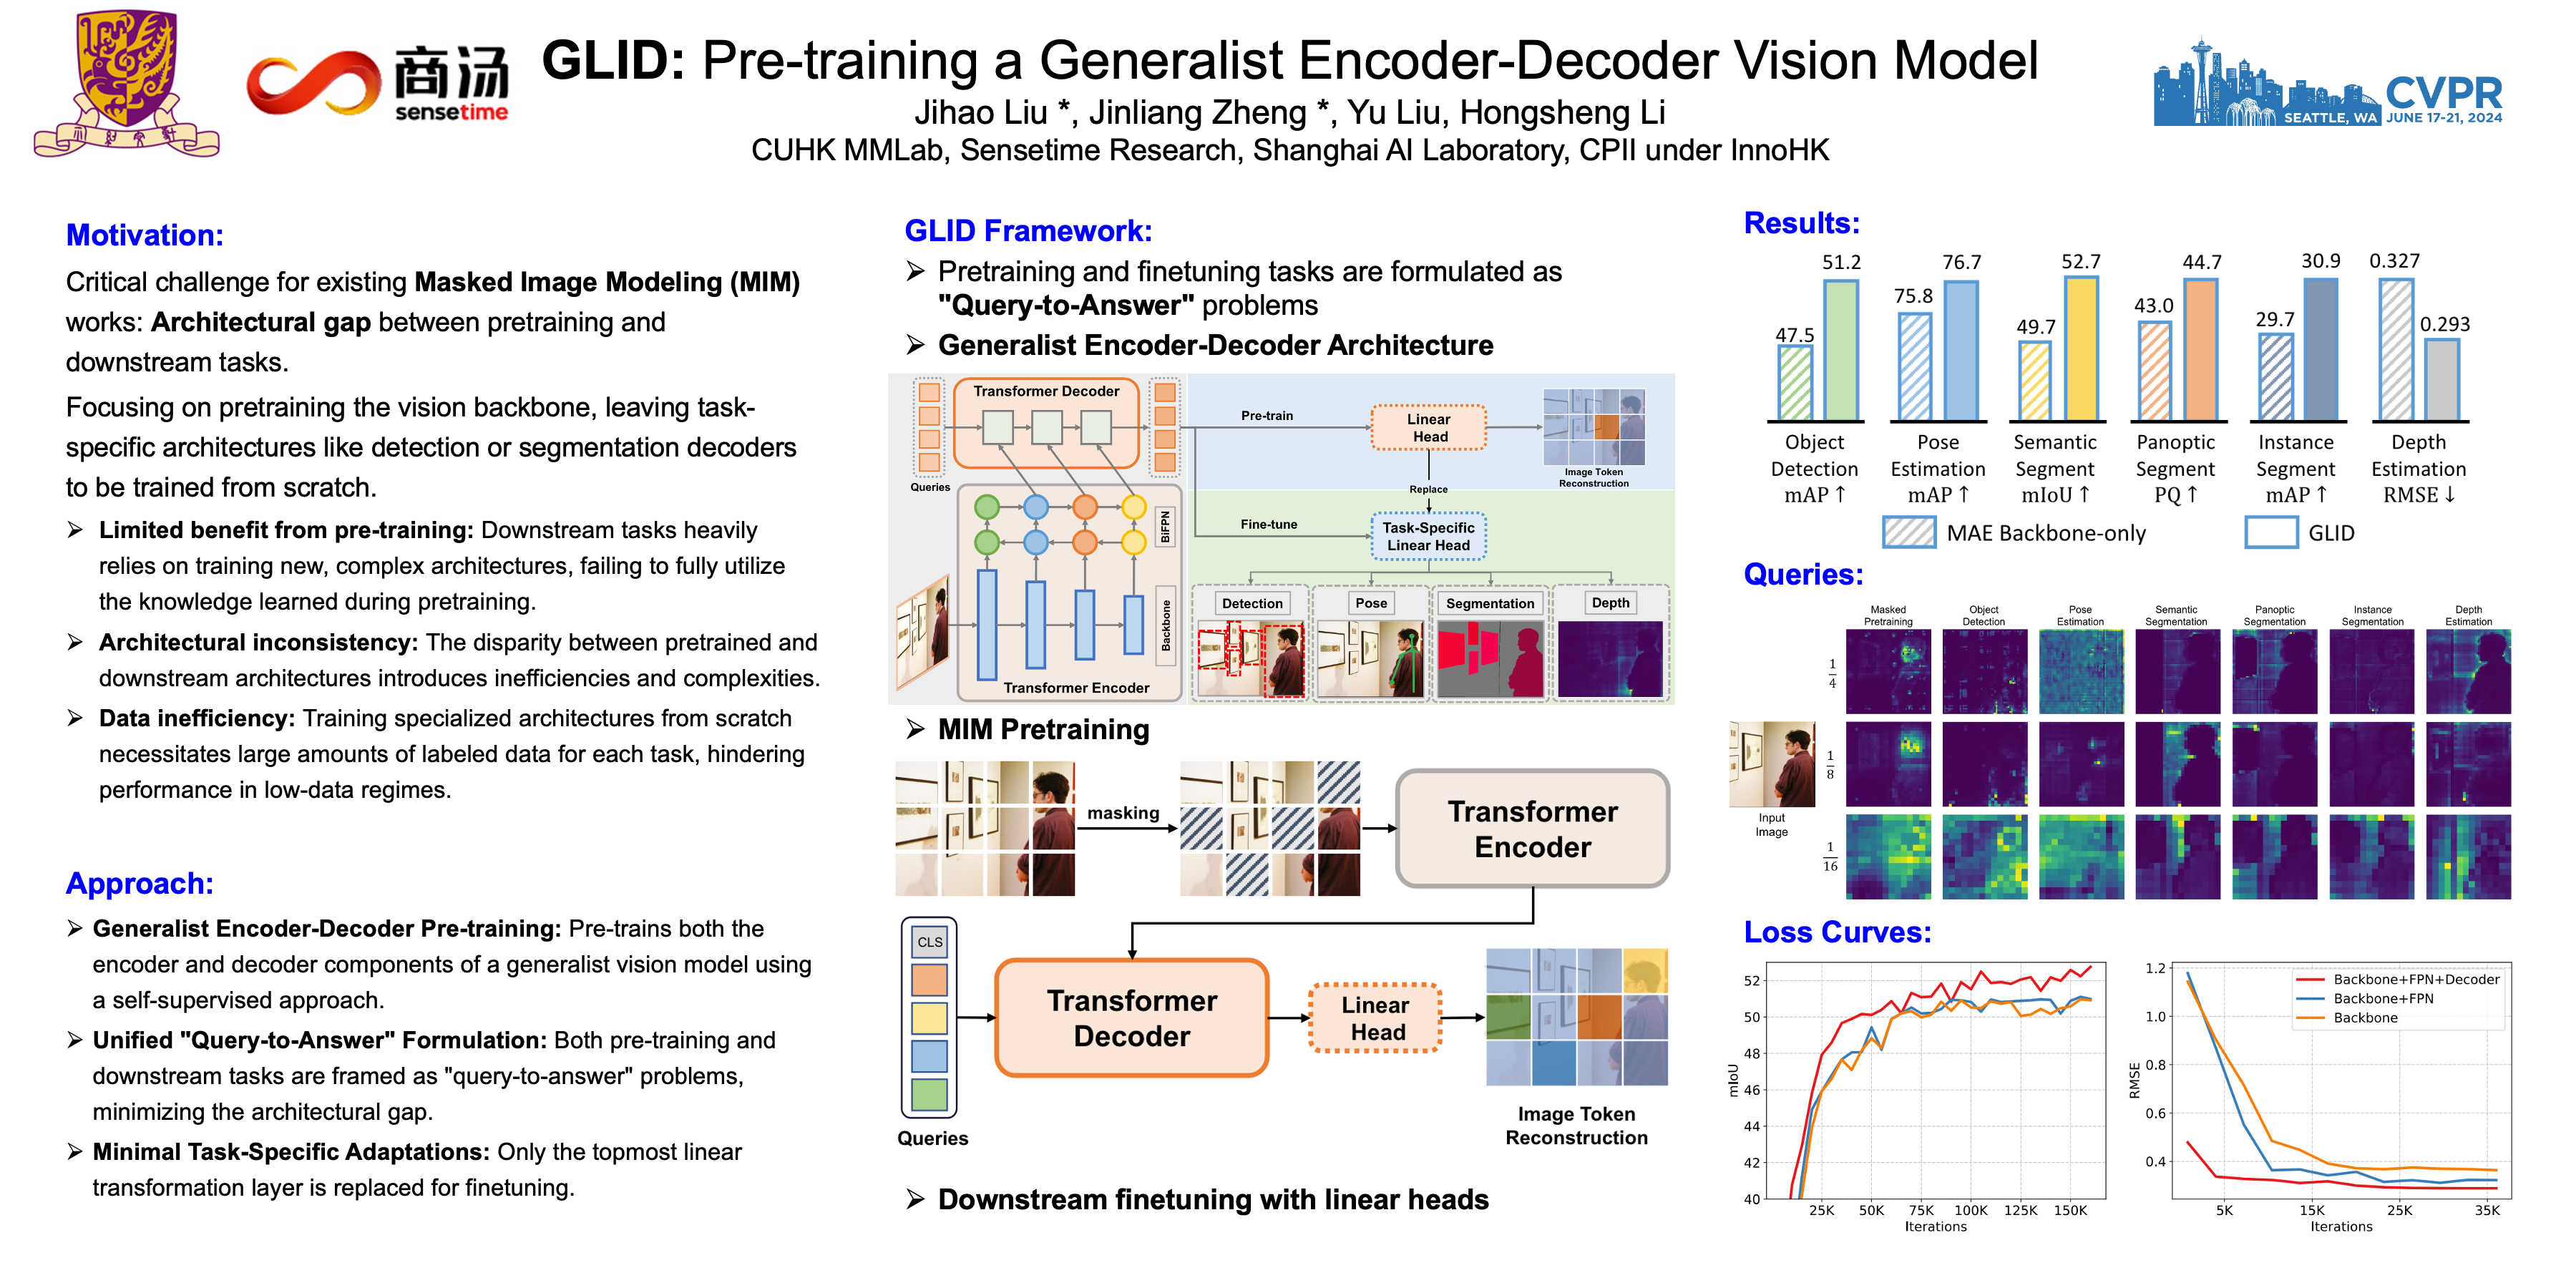
CVPR Poster GLID: Pre-training a Generalist Encoder-Decoder Vision Model
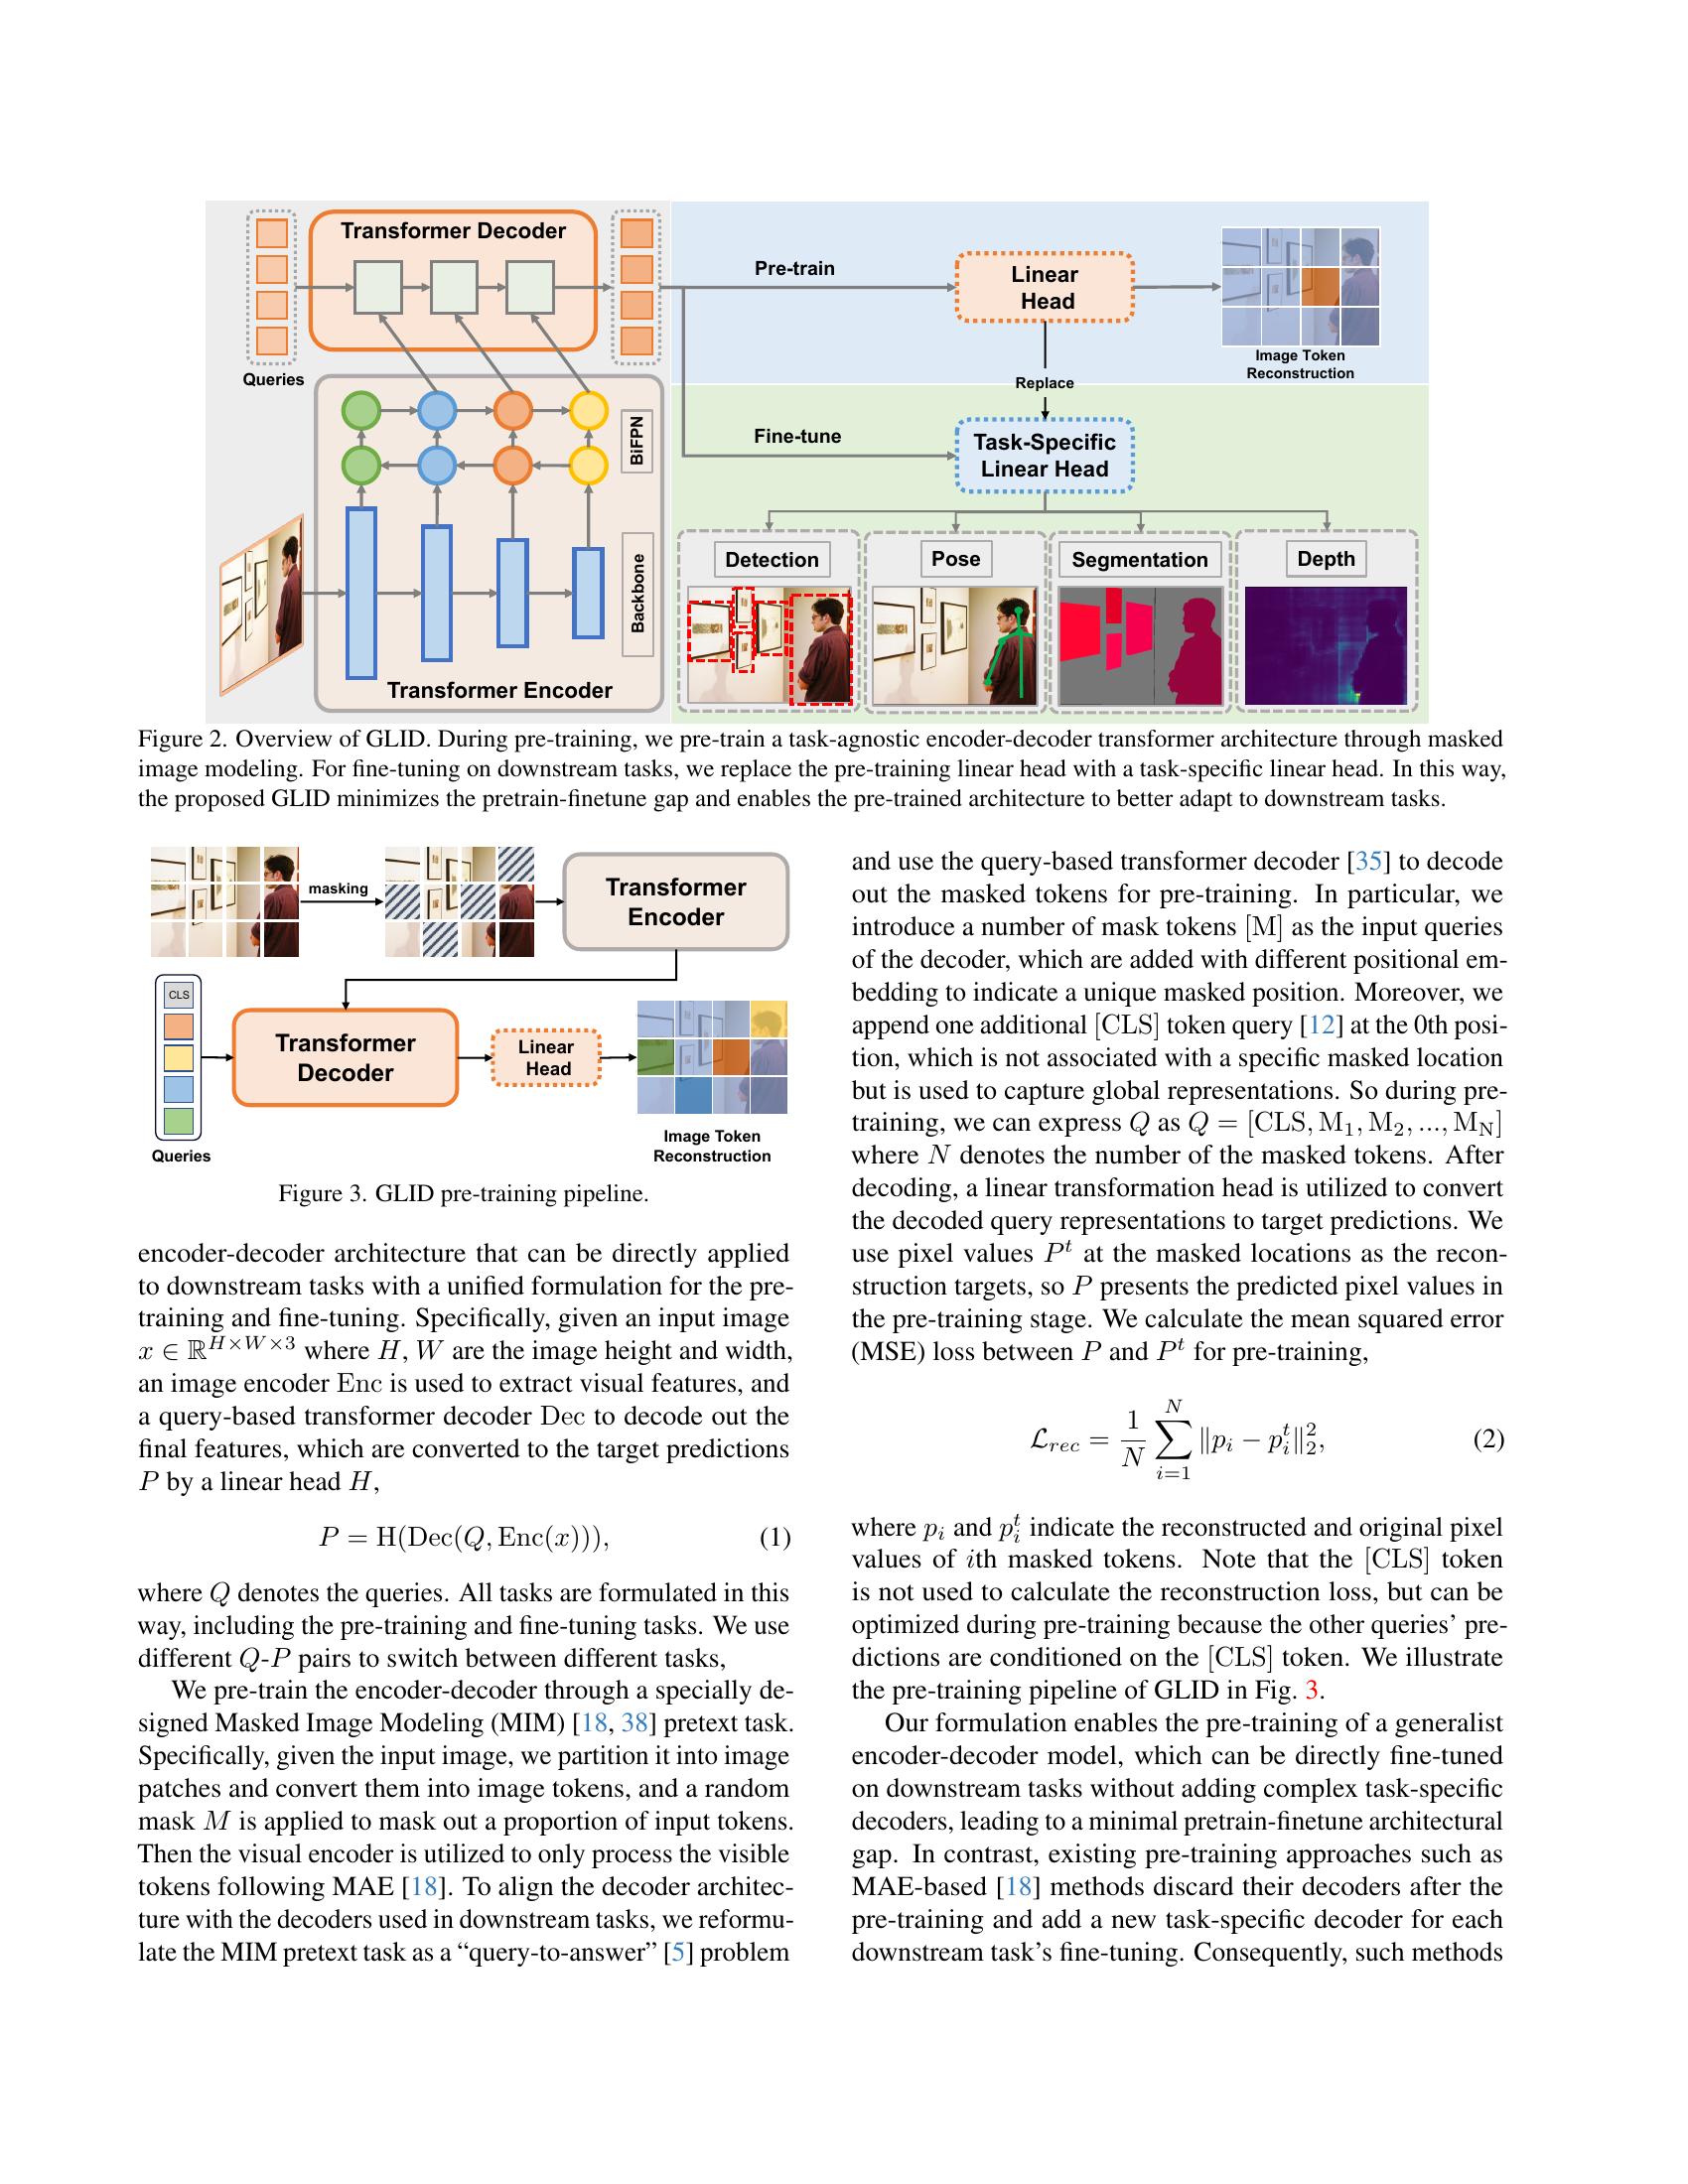
GLID: Pre-training a Generalist Encoder-Decoder Vision Model - 智源社区论文

GLID: Pre-training a Generalist Encoder-Decoder Vision Model | AI ...

[논문 리뷰] GLID: Pre-training a Generalist Encoder-Decoder Vision Model
Self supervised decoder training. (a) We train a video-to-fMRI Encoder ...

Figure 1.1 from Vision Encoders in Visual Question Answering | Semantic ...
Advertisement Space (300x250)

GLID: Pre-training a Generalist Encoder-Decoder Vision Model

Figure 1 from Bengali Image Captioning Using Vision Encoder-Decoder ...

Figure 1 from Vision Encoder-Decoder Models for AI Coaching | Semantic ...

Figure 2 from Bengali Image Captioning Using Vision Encoder-Decoder ...

Optimization procedure of a semantic encoder and decoder without a ...

Pre-trained vision transformer vs training from scratch | Download ...

Figure 1 from Contrastive encoder pre-training-based clustered ...

Figure 1 from Self-Supervised Pretraining Vision Transformer With ...

Training and generation steps: Training steps of encoder and decoder of ...

the proposed network with encoder and decoder layers in the end-to-end ...
Advertisement Space (336x280)

The encoder and decoder structure. The proposed architecture is built ...

Training Design for Text-to-Image Models: Lessons from Ablations
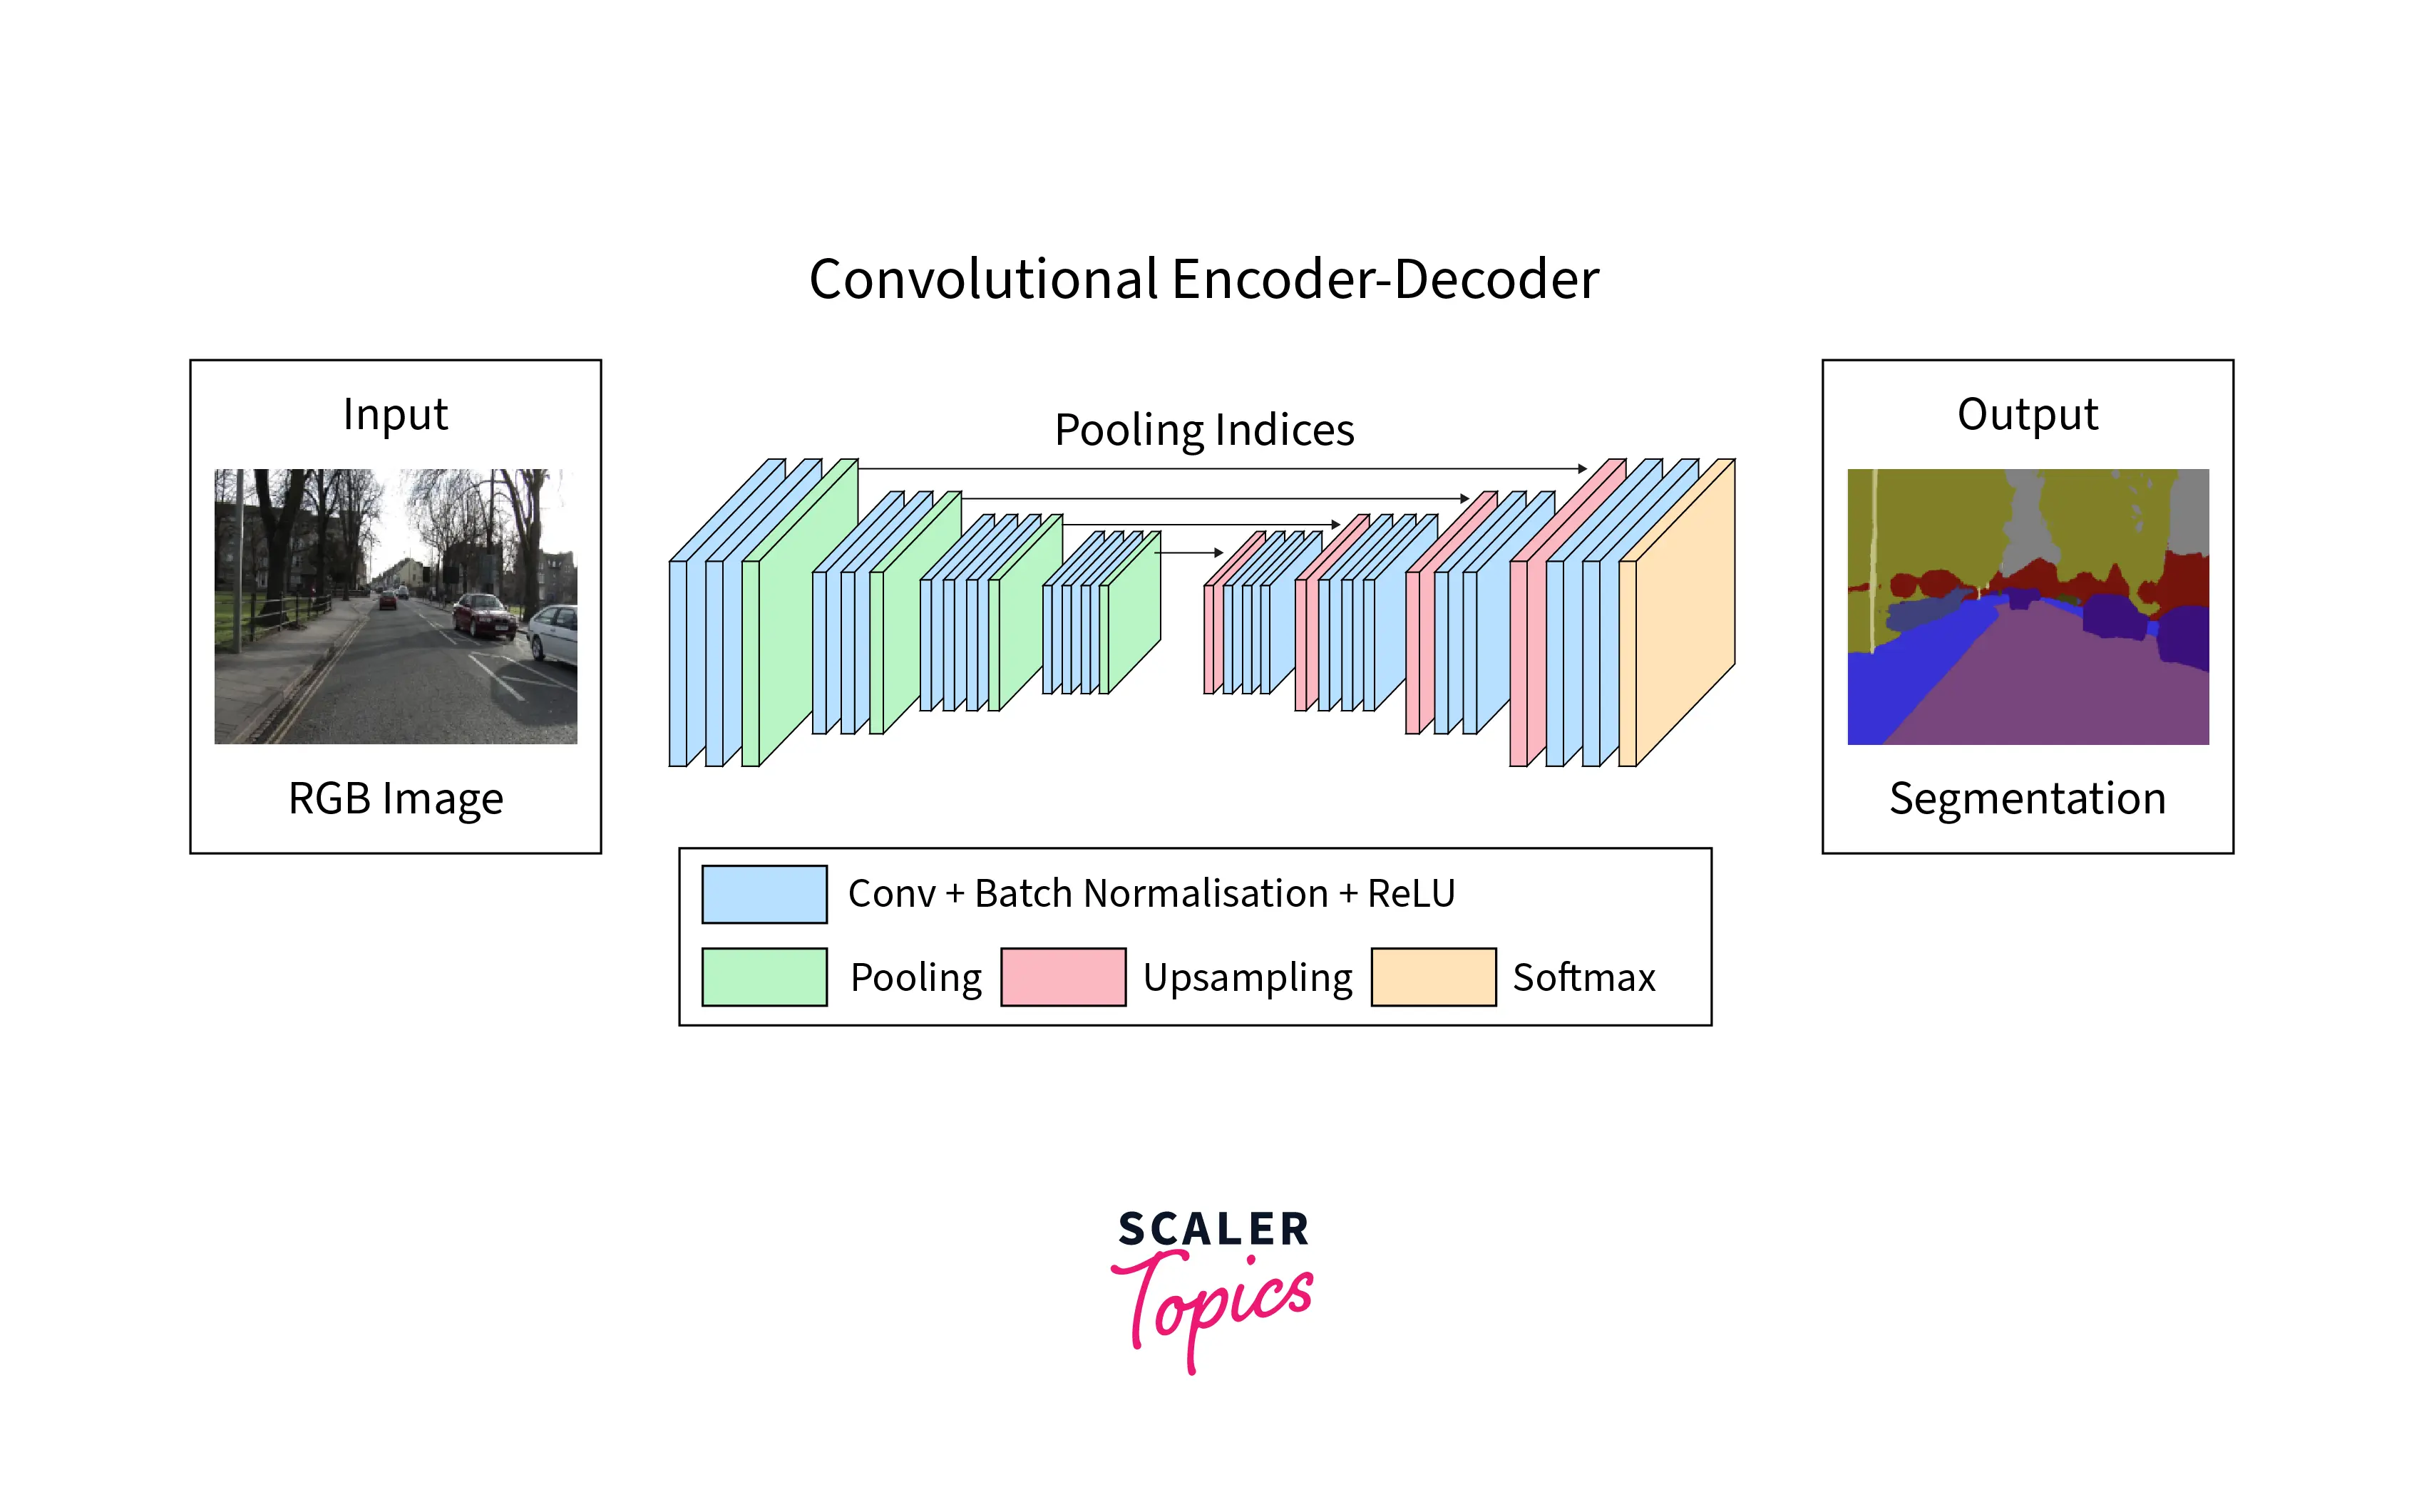
Putting Encoder - Decoder Together - Scaler Topics

(PDF) Sequential Vision to Language as Story: A Storytelling Dataset ...

(a) The modular training starts by optimizing the first encoder and ...

A generalist vision–language foundation model for diverse biomedical ...

Simultaneous training of the text and image encoder to learn visual ...

What Is Encoder Decoder Model at Qiana Flowers blog

Figure 1 from Instruction-Following Agents with Jointly Pre-Trained ...

Figure 1 from Generative Text-Guided 3D Vision-Language Pretraining for ...
Advertisement Space (336x280)
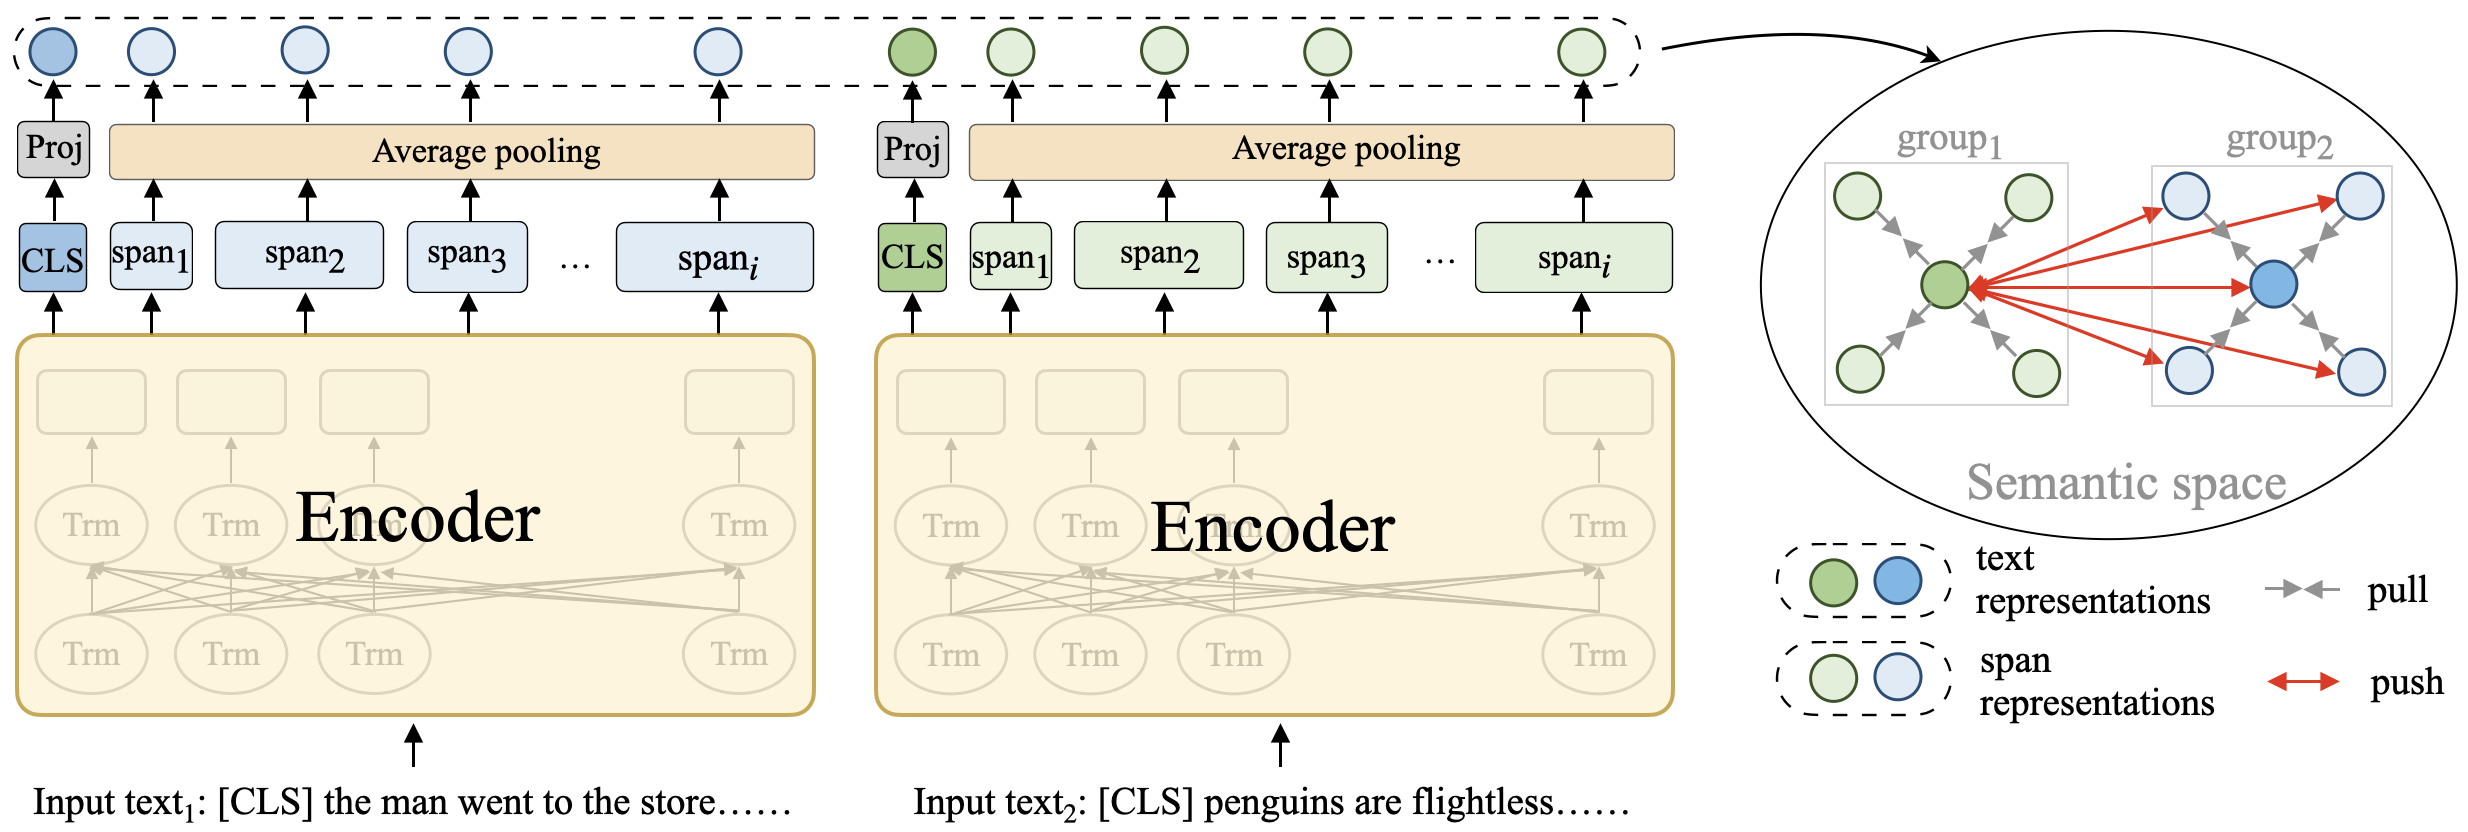
[2204.10641] Pre-train a Discriminative Text Encoder for Dense ...

Results from the Pre-Train Stage: the proposed encoder encodes the ...

Figure 1 from Generative Text-Guided 3D Vision-Language Pretraining for ...
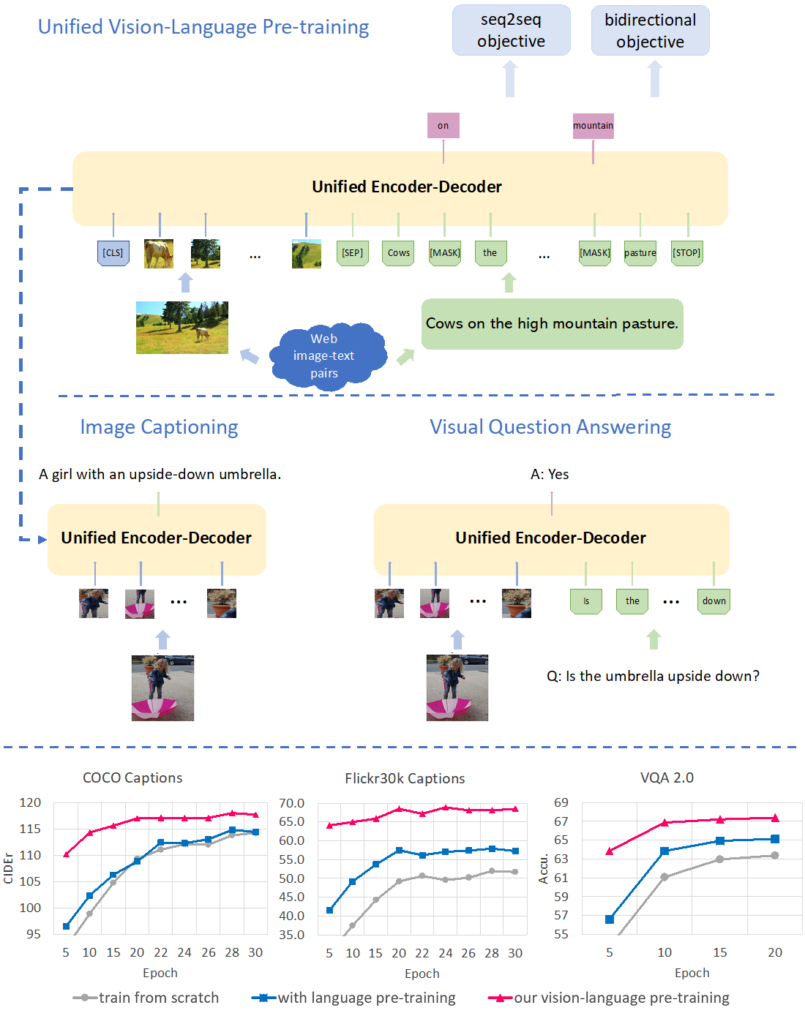
Expanding scene and language understanding with large-scale pre ...

Hierarchical Pre-Training of Vision Encoders with Large Language Models

Vision Transformer Image Classification | MindSpore 2.4.0 Tutorials ...