
Figure 5 From A Re Parameterized Vision Transformer Revt For Domain

Figure 5 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 12 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 11 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 2 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 9 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 7 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 10 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...
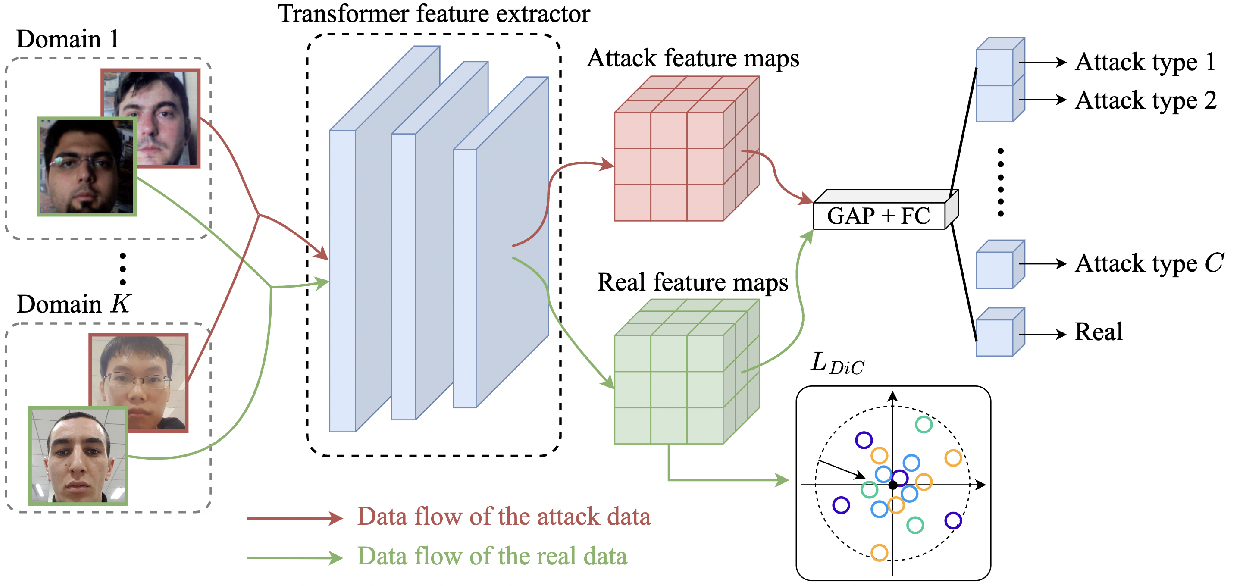
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...

Table 4 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...
Advertisement Space (300x250)

Table 11 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 2 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 3 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 8 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 2 from Prompt Vision Transformer for Domain Generalization ...

Figure 2 from Vision Transformers in Domain Adaptation and ...

A Step-Wise Domain Adaptation Detection Transformer for Object ...

Figure 1 from RePre: Improving Self-Supervised Vision Transformer with ...
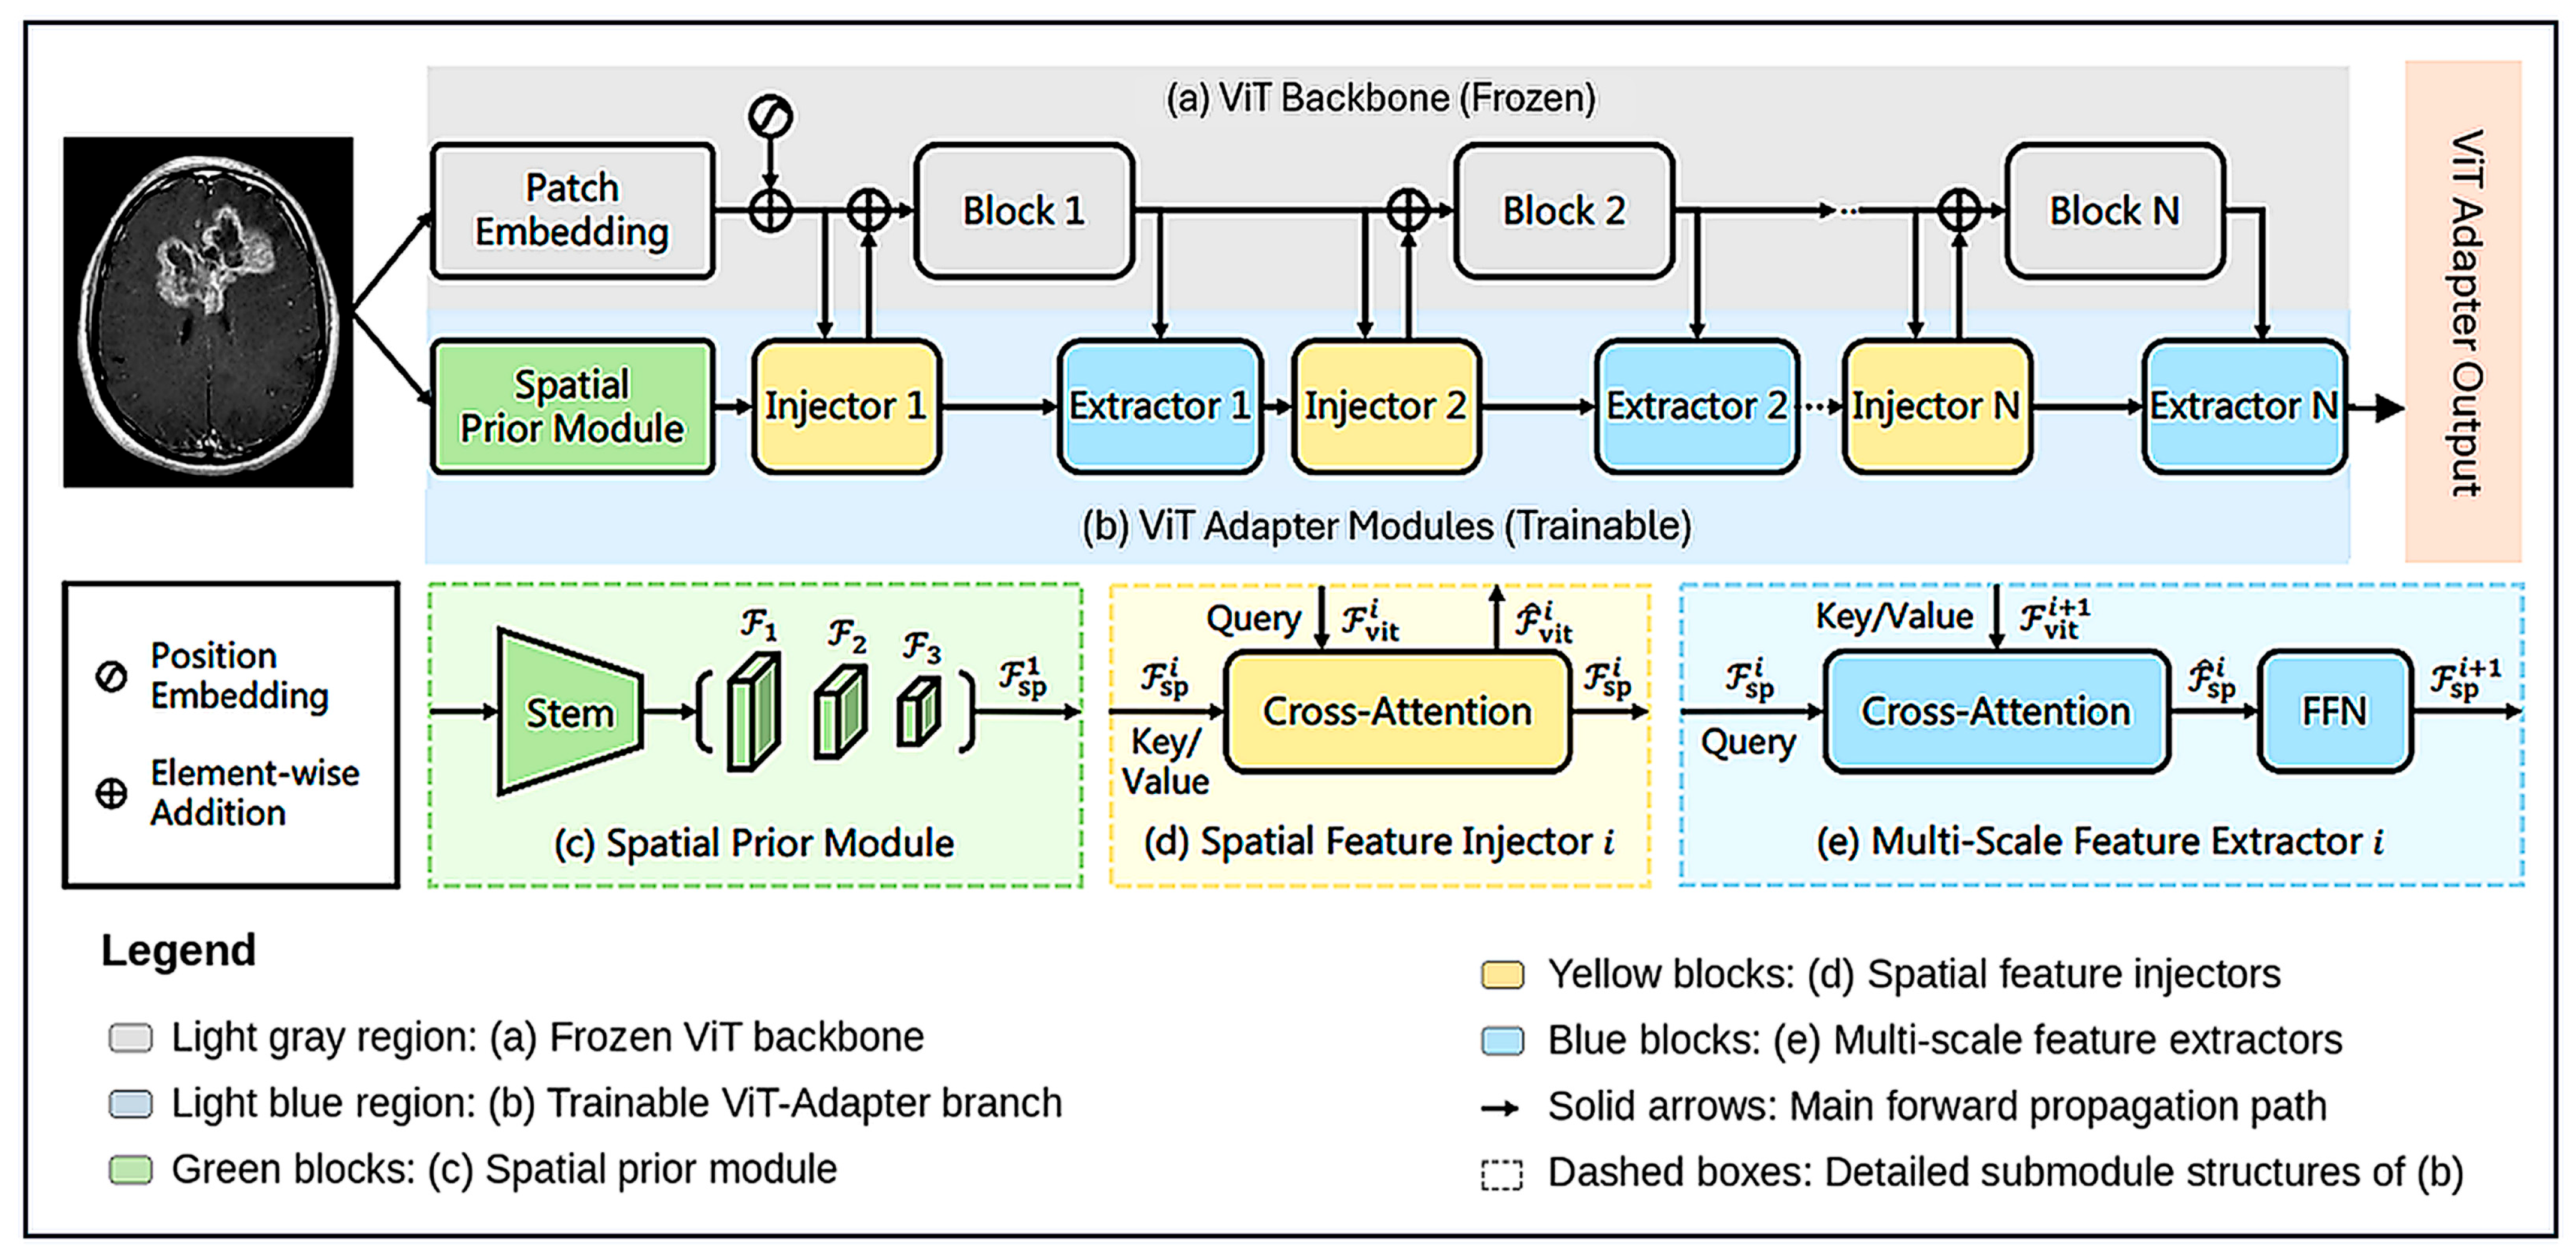
Adapter-Based Vision Transformer for Cross Domain Few-Shot ...
Advertisement Space (336x280)

Figure 1 from Pretraining the Vision Transformer using self-supervised ...

Vision transformers in domain adaptation and domain generalization: a ...
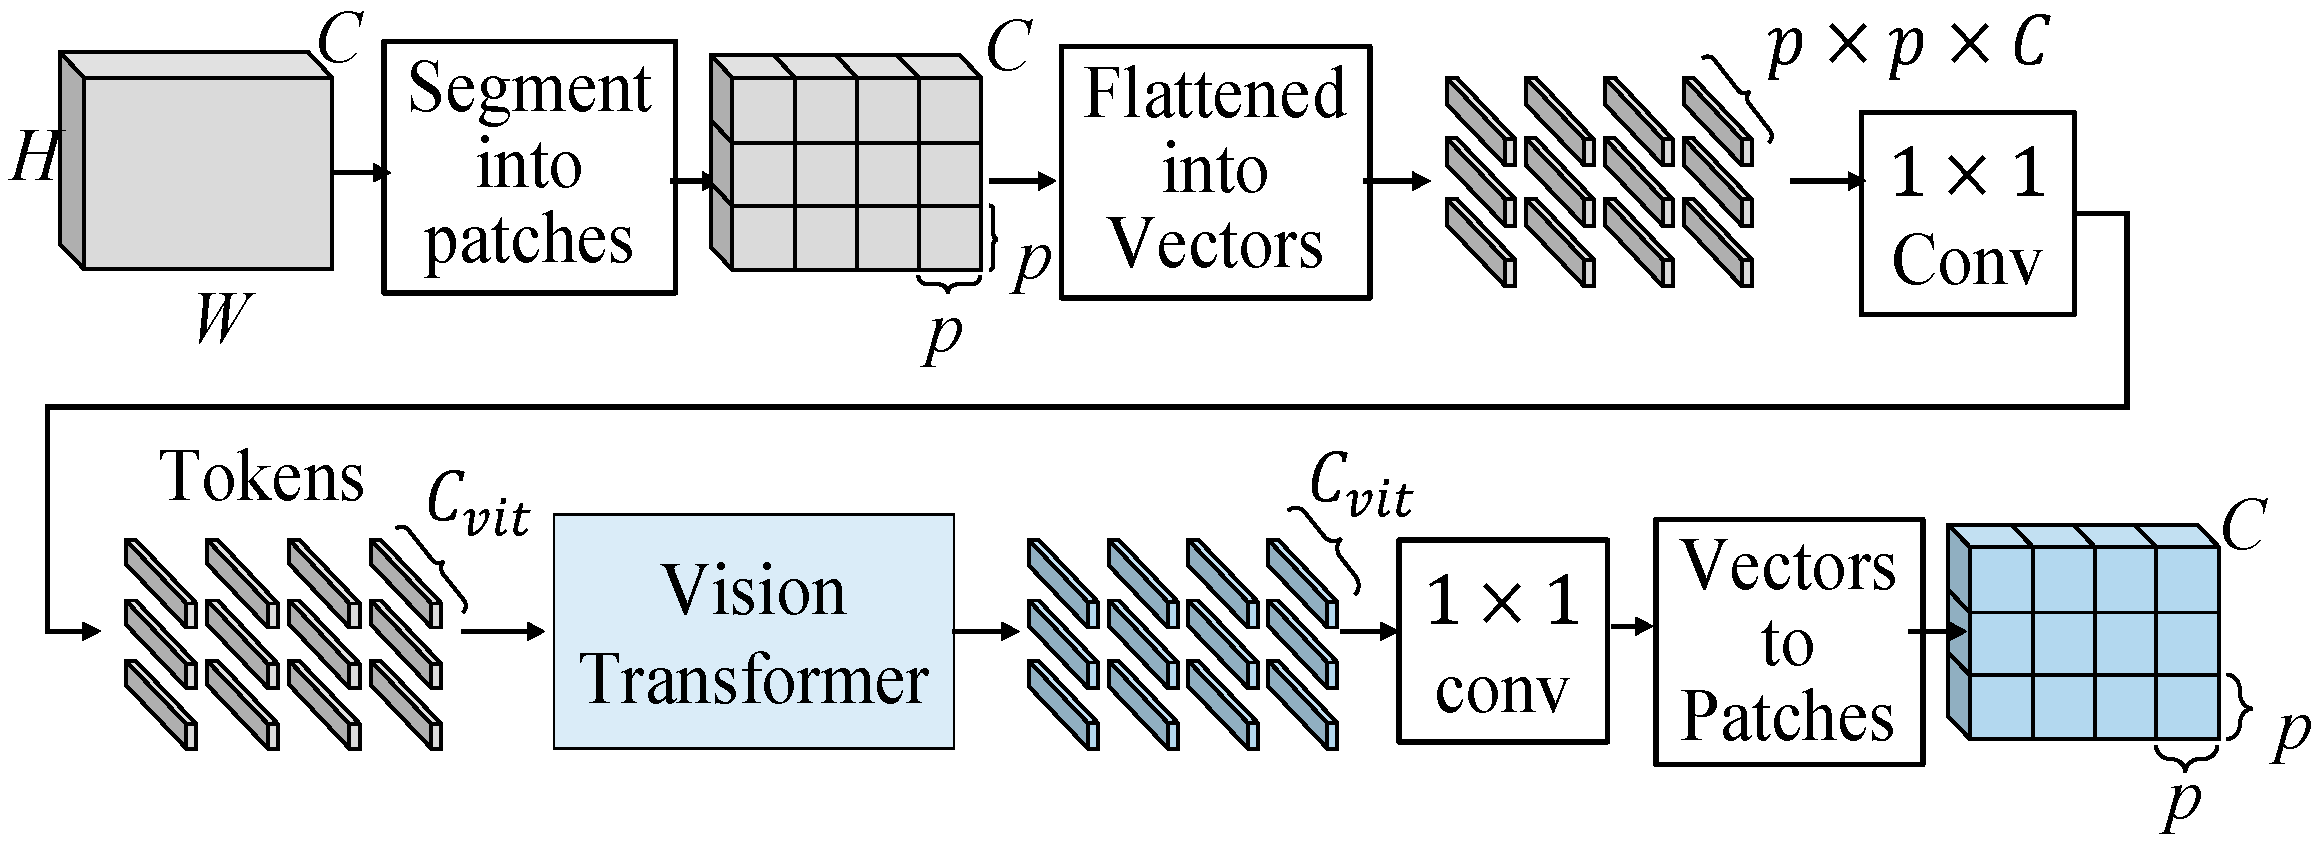
RVTAF: Residual Vision Transformer and Adaptive Fusion Autoencoders for ...

The architecture of Vision Transformer Model for image classification ...

Vision transformer for object detection beats state-of-art ResNet-50

Vision Transformers. Vision Transformer (ViT) is a type of… | by ...
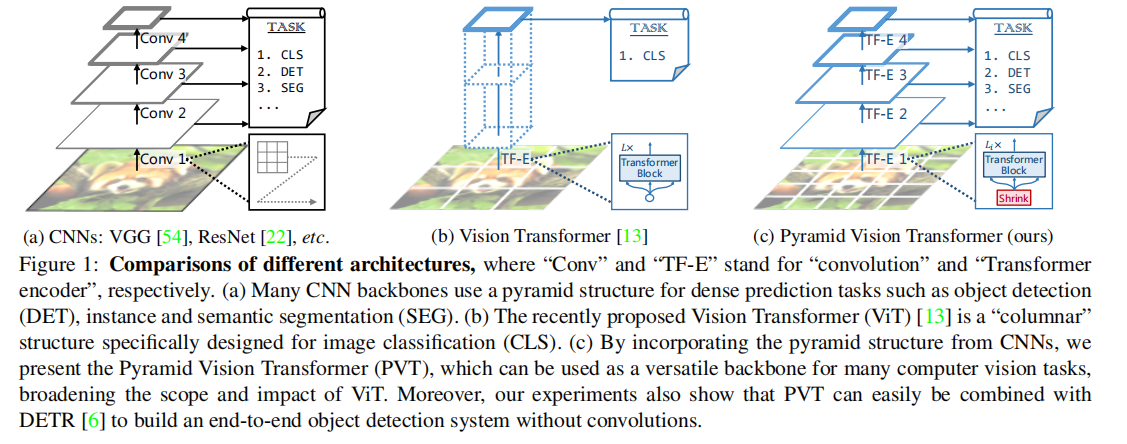
PVT论文精读:Pyramid Vision Transformer: A Versatile Backbone for Dense ...
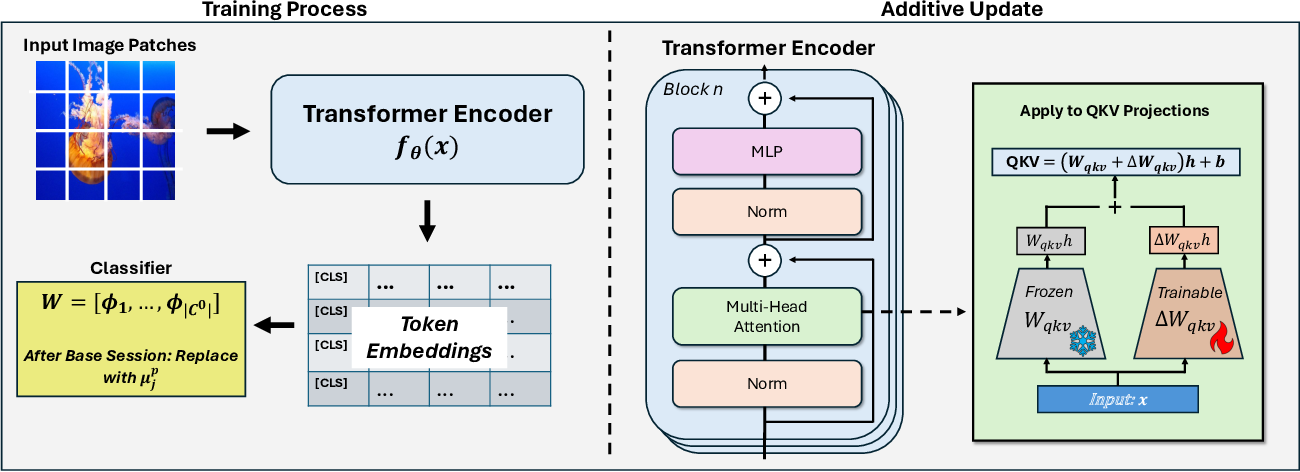
Figure 1 from Adaptive Additive Parameter Updates of Vision ...

TransAdapter: Vision Transformer for Feature-Centric Unsupervised ...

Learning cross-domain representations by vision transformer for ...
Advertisement Space (336x280)

Empowering Vision Transformer by Network Hyper-Parameter Selection for ...

Figure 1 from Improving Source-Free Target Adaptation with Vision ...

A Comprehensive Survey of Transformers for Computer Vision

3 -The vision transformer that Wu et al. (2020) proposed for either ...

Empowering Vision Transformer by Network Hyper-Parameter Selection for ...

Vision Transformers in Domain Adaptation and Generalization: A Study of ...