
Figure 1 From A Re Parameterized Vision Transformer Revt For Domain

Figure 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 12 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...
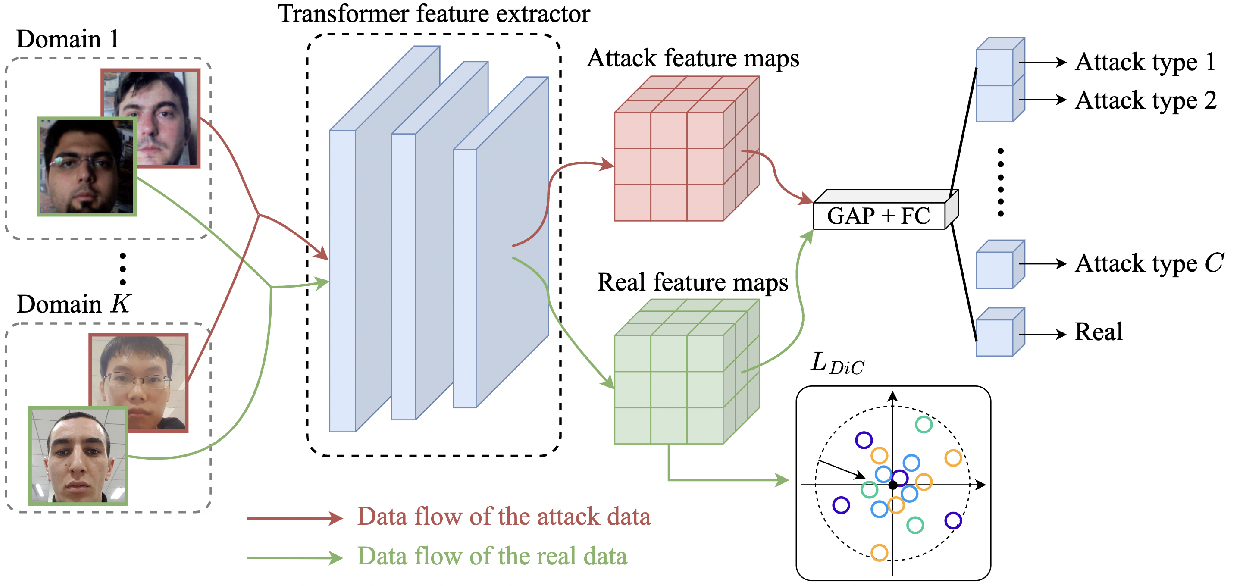
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...

Figure 2 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 11 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 9 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 5 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 1 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 7 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...
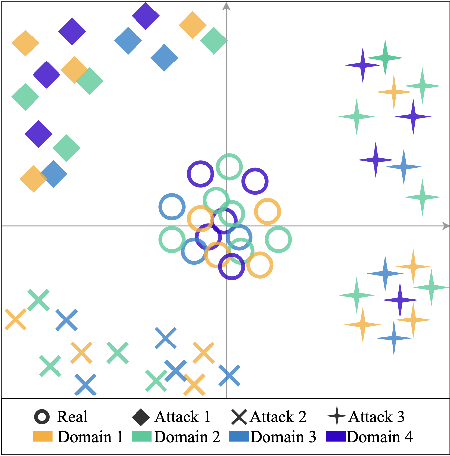
Figure 1 from Domain Invariant Vision Transformer Learning for Face ...
Advertisement Space (300x250)

Figure 1 from Progressive Domain Adaptation for Robot Vision Person Re ...
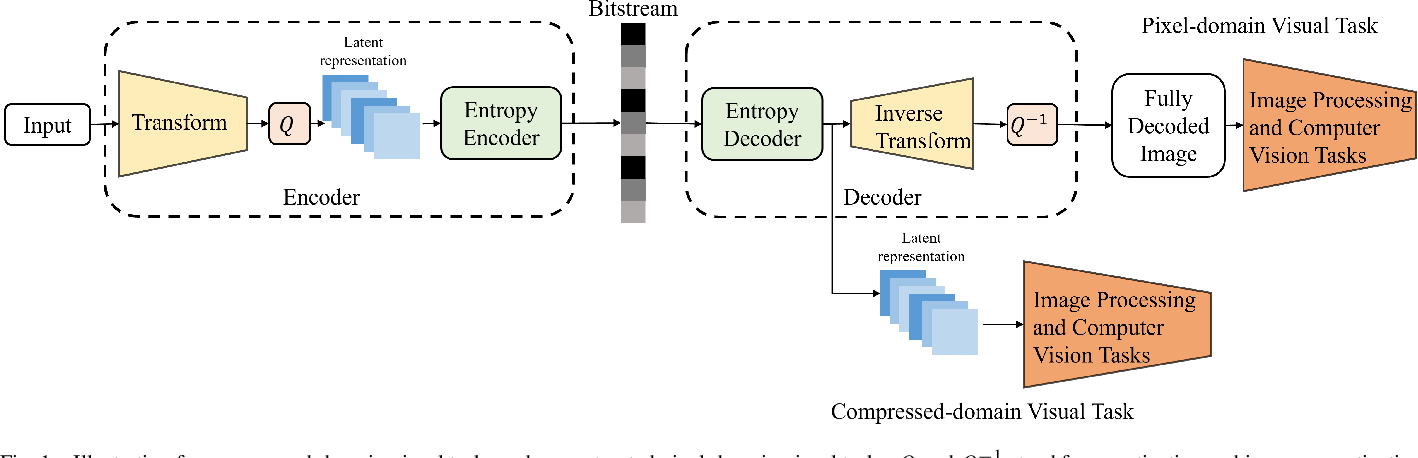
Figure 1 from Compressed-Domain Vision Transformer for Image ...

Table 10 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 2 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 3 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 11 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 8 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Table 4 from A Re-Parameterized Vision Transformer (ReVT) for Domain ...

Figure 1 from Evaluating Vision Transformer Methods for Deep ...

Figure 1 from Efficient Fine-Tuning with Domain Adaptation for Privacy ...
Advertisement Space (336x280)

Figure 1 from Pretraining the Vision Transformer using self-supervised ...

Figure 1 from RePre: Improving Self-Supervised Vision Transformer with ...

Figure 1 from Vision Transformer-based Adversarial Domain Adaptation ...
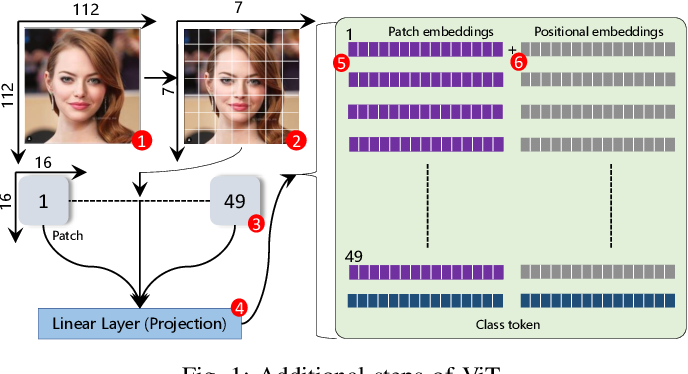
Figure 1 from Recent Advances in Vision Transformer: A Survey and ...

Figure 1 from Improving Source-Free Target Adaptation with Vision ...
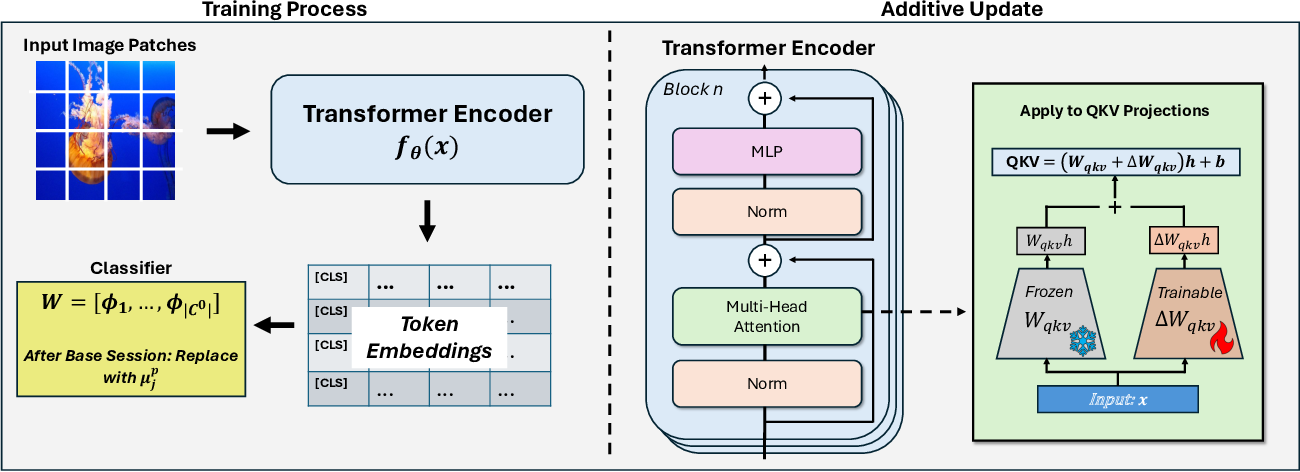
Figure 1 from Adaptive Additive Parameter Updates of Vision ...
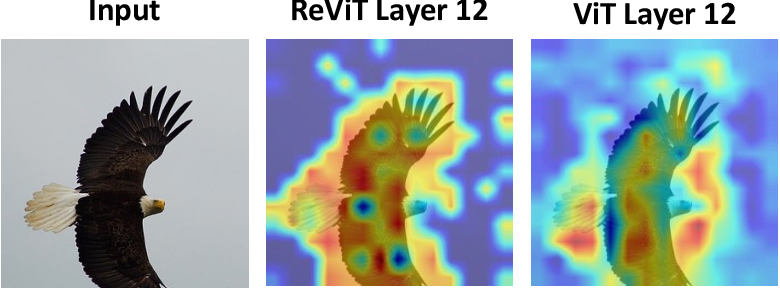
Figure 1 from ReViT: Enhancing vision transformers feature diversity ...

Figure 1 from Vision Transformers are Parameter-Efficient Audio-Visual ...

Figure 1 from Enhancing Parameter-Efficient Fine-Tuning of Vision ...

Figure 1 from Vision Transformers are Parameter-Efficient Audio-Visual ...
Advertisement Space (336x280)
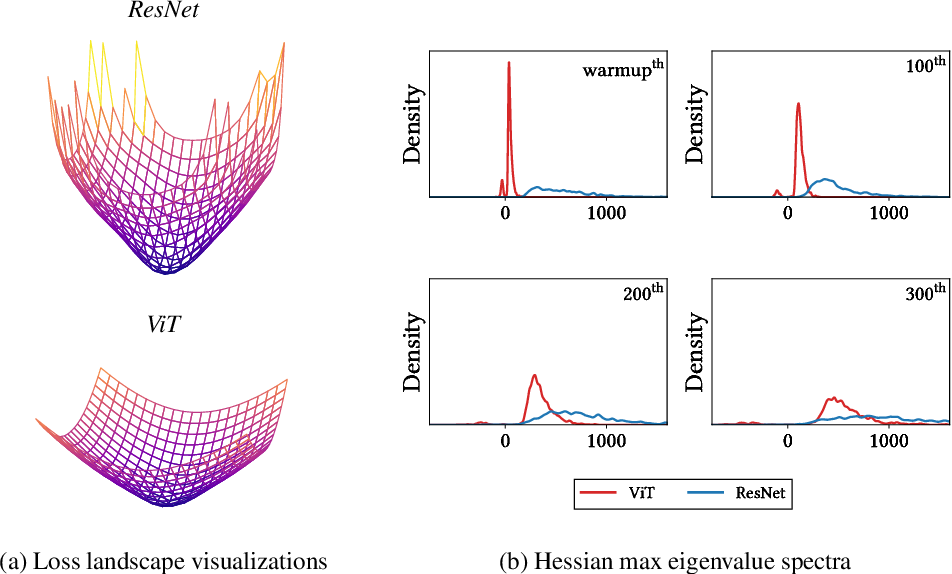
Figure 1 from How Do Vision Transformers Work? | Semantic Scholar

Figure 2 from Vision Transformers in Domain Adaptation and ...
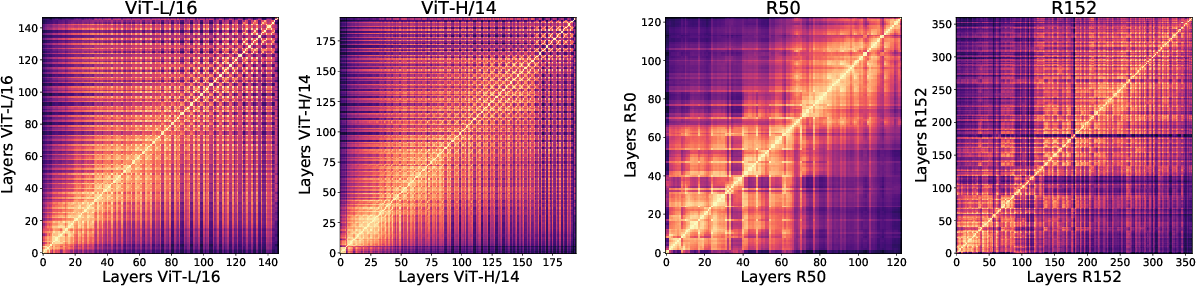
Figure 1 from Do Vision Transformers See Like Convolutional Neural ...

The architecture of Vision Transformer Model for image classification ...

Vision Transformers for Image Classification: A Comparative Survey

Learning cross-domain representations by vision transformer for ...