
Github Amd Agipard Pard Accelerating Llm Inference With Low Cost
GitHub - AMD-AGI/PARD: PARD: Accelerating LLM Inference with Low-Cost ...
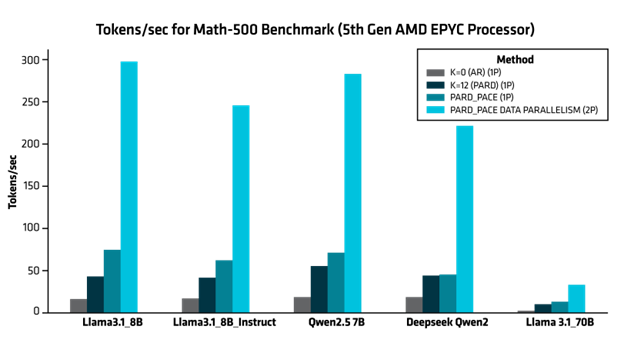
Speculative LLM Inference on the 5th Gen AMD EPYC Processors with PARD ...
Accelerating LLM Inference on AMD GPUs with Low-Latency GEMMs — ROCm Blogs
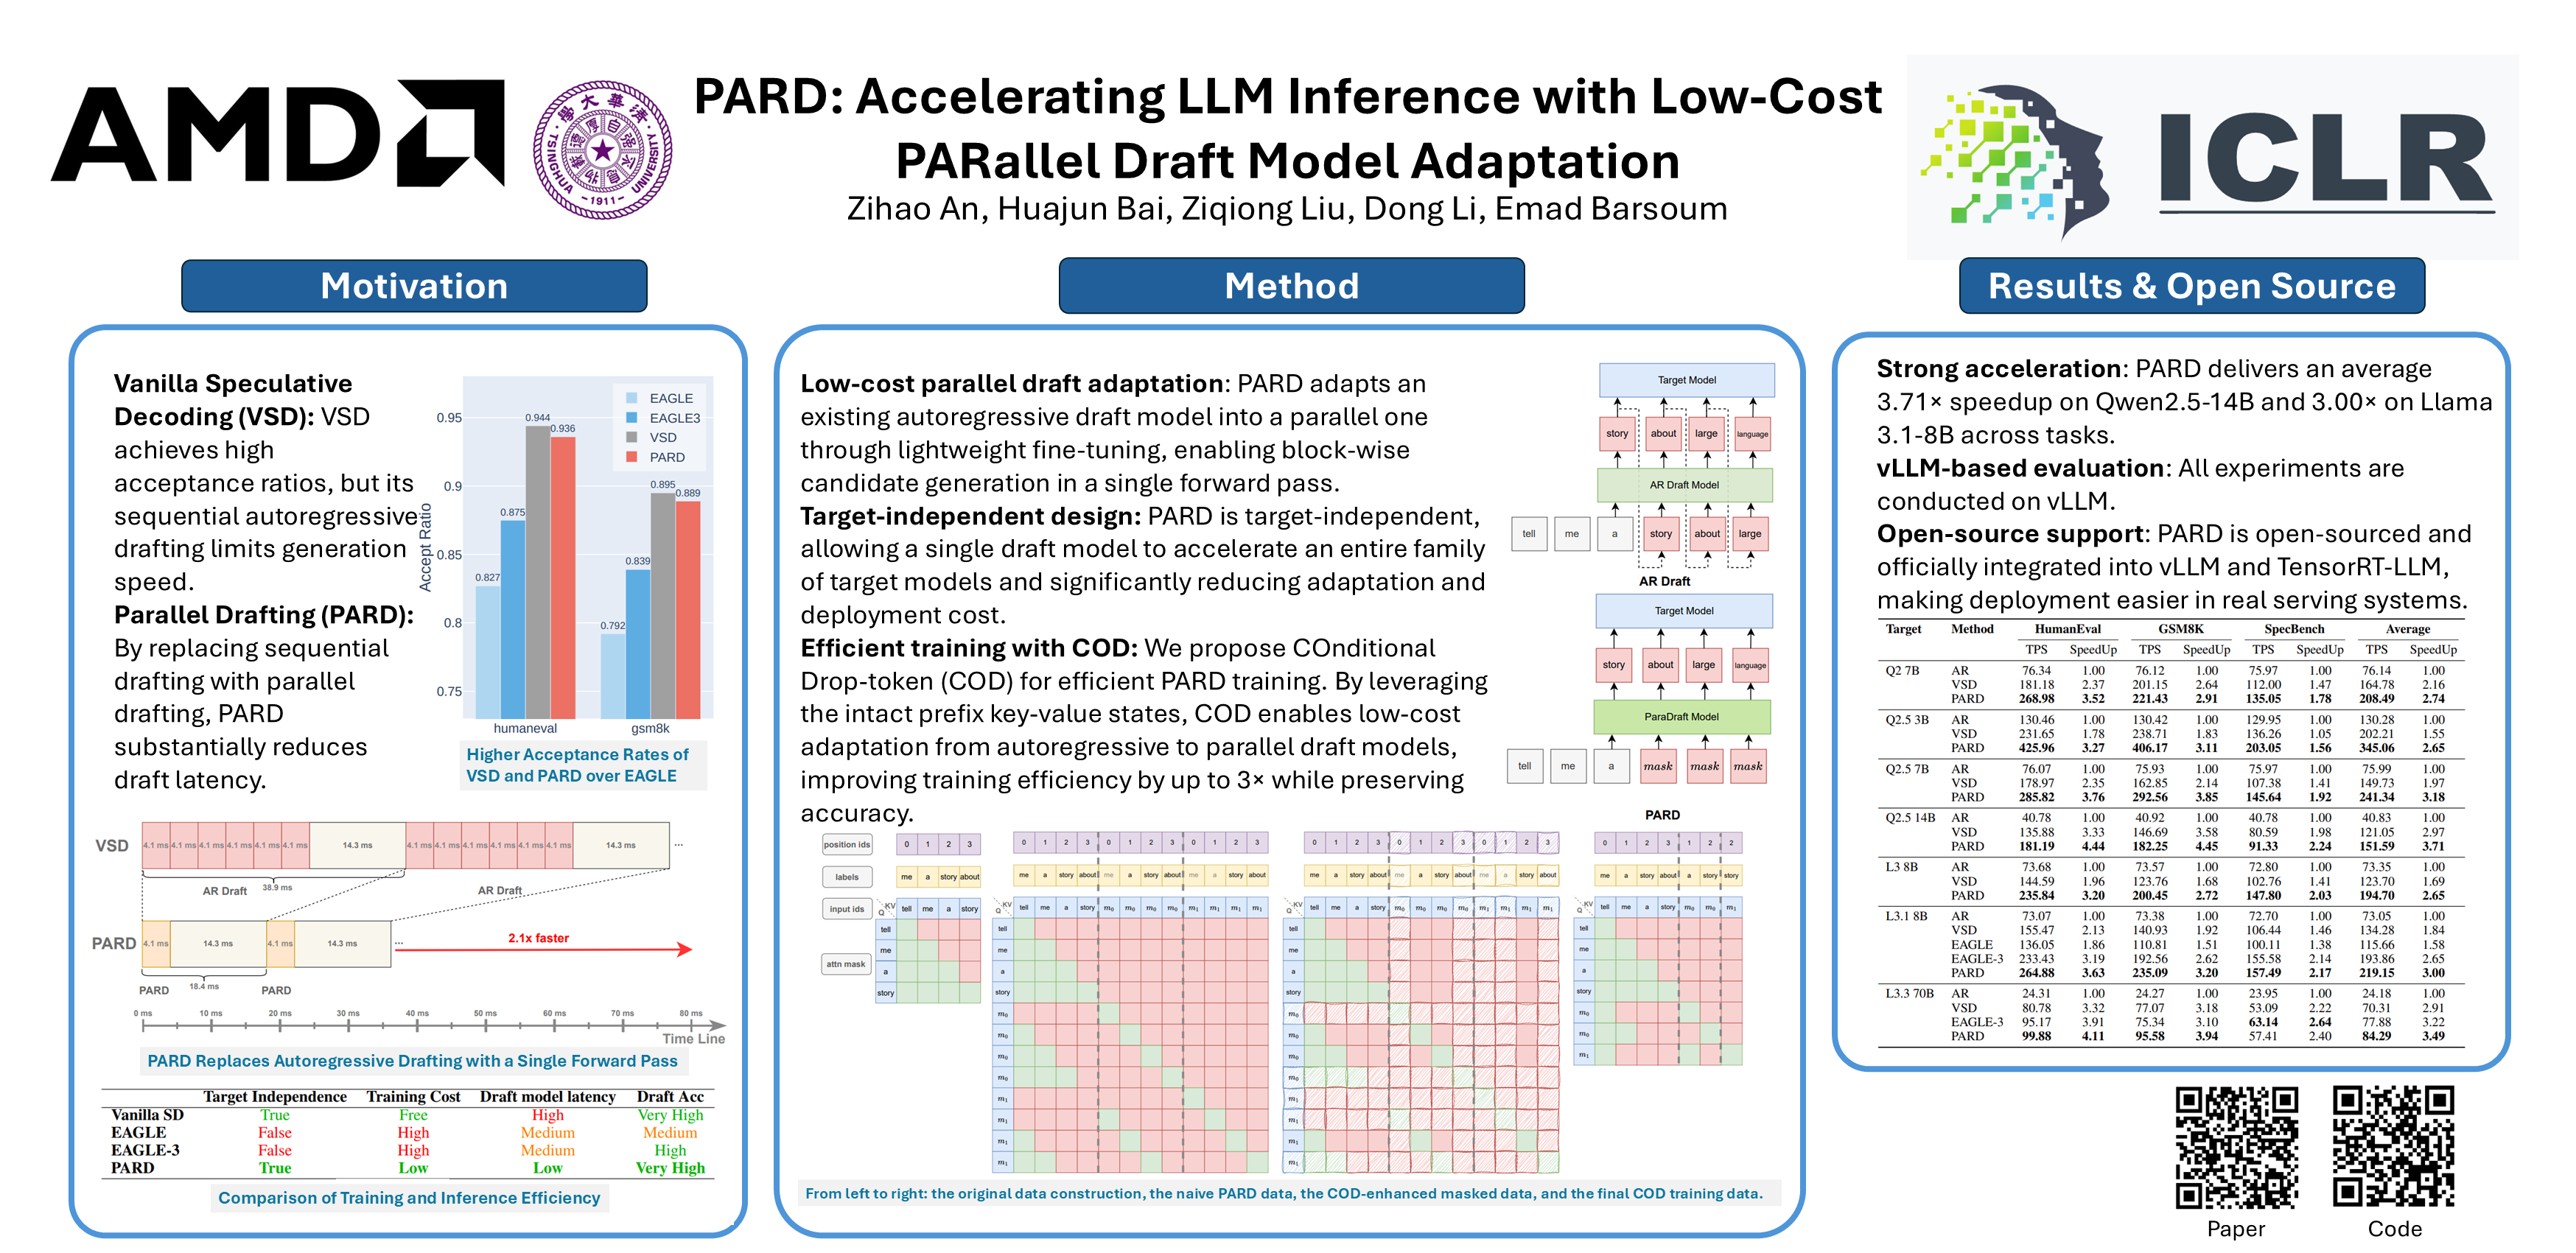
ICLR Poster PARD: Accelerating LLM Inference with Low‑Cost PARallel ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...
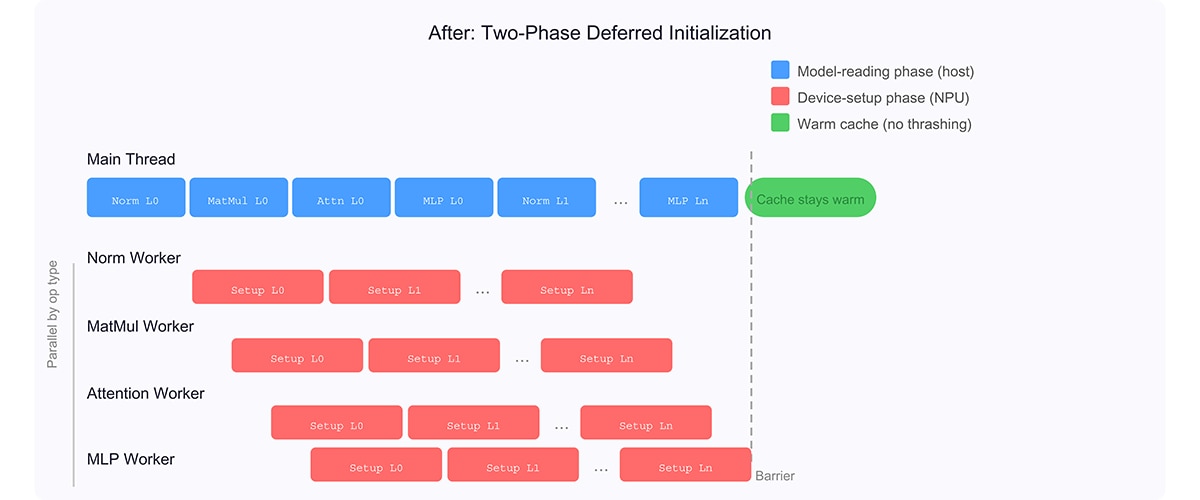
Accelerating LLM Startup on AMD Ryzen AI with Two-Phase Custom Op ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

Paper page - PARD: Accelerating LLM Inference with Low-Cost PARallel ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...
Advertisement Space (300x250)
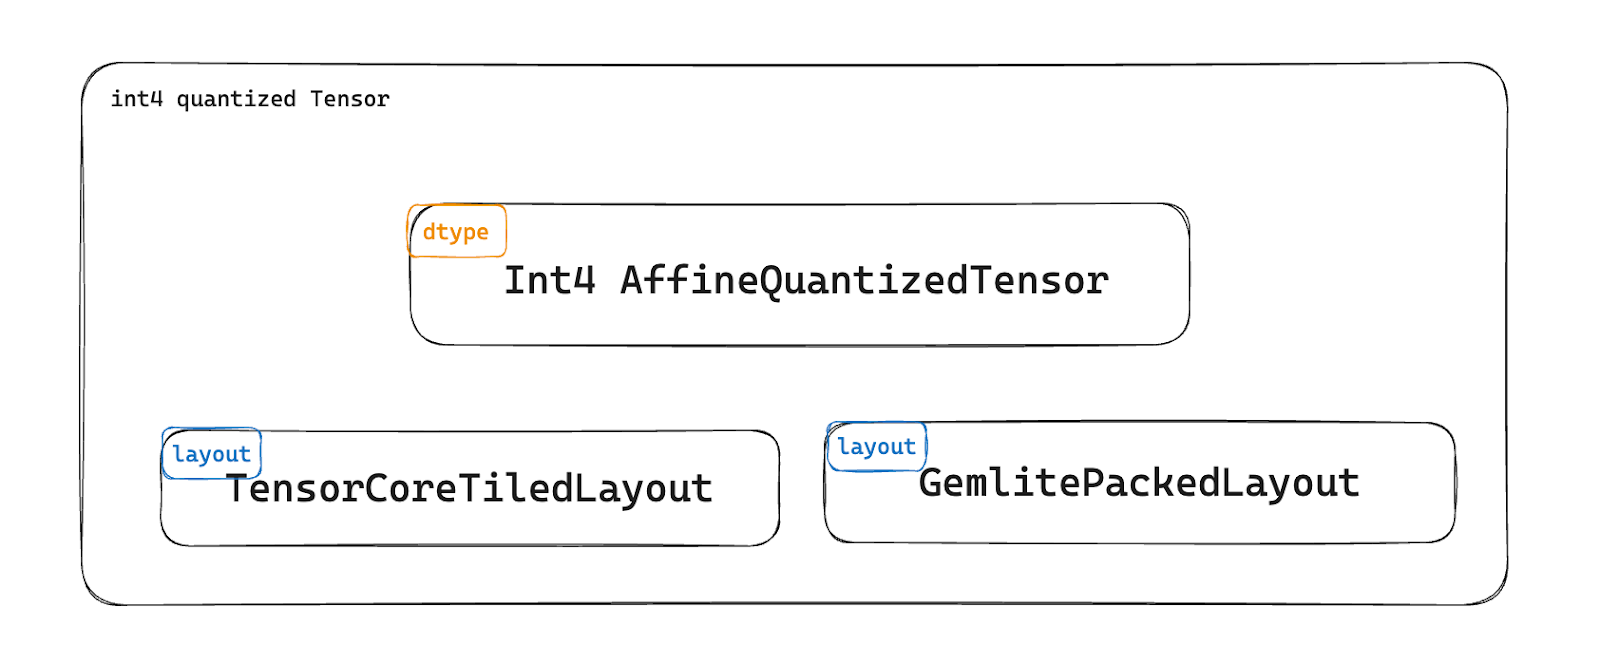
Accelerating LLM Inference with GemLite, TorchAO and SGLang | PyTorch

OpenRouter - Use The LLM Inference API with the Lowest Cost - YouTube
GitHub - shishishu/LLM-Inference-Acceleration: LLM Inference with Deep ...
Accelerating LLM Startup on AMD Ryzen AI with Two-Phase Custom Op ...

AMD Achieves LLM Inference Parity with Nvidia! : r/AMD_Stock
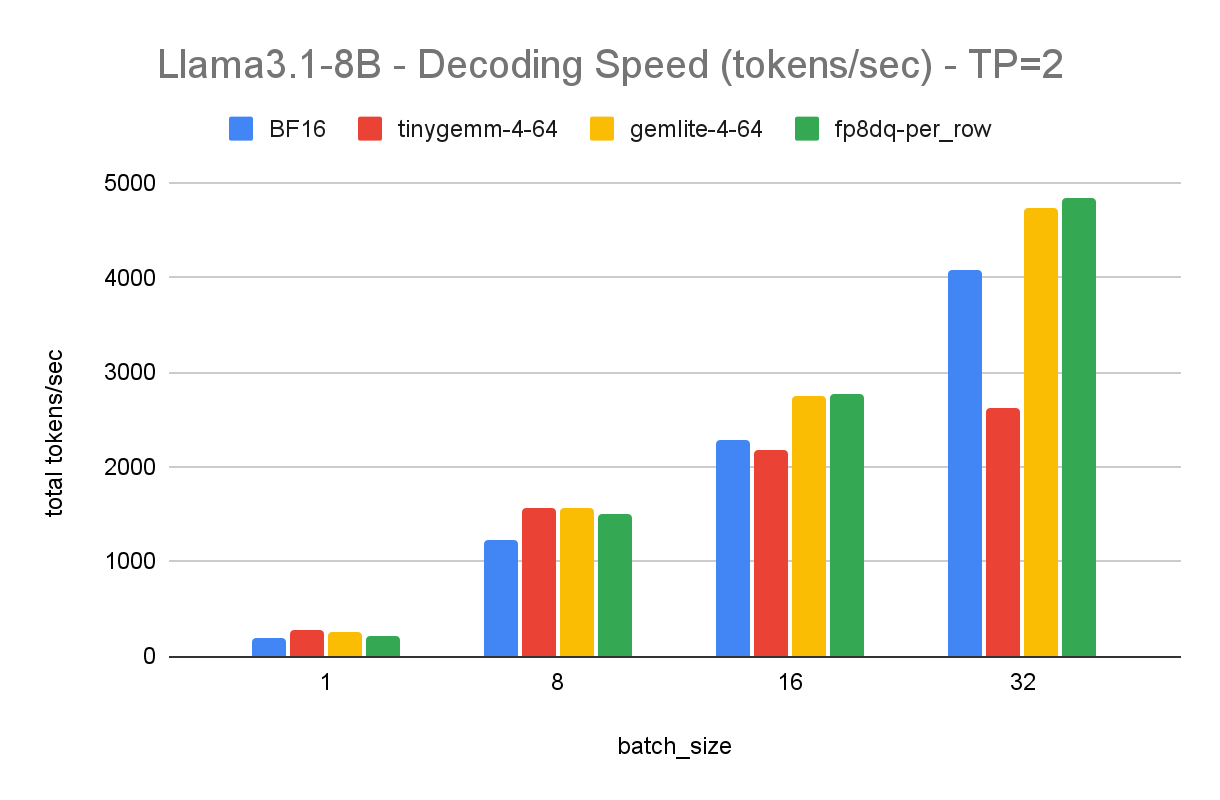
Accelerating LLM Inference with GemLite, TorchAO and SGLang | PyTorch

Accelerating LLM Inference with vLLM chords - Databricks
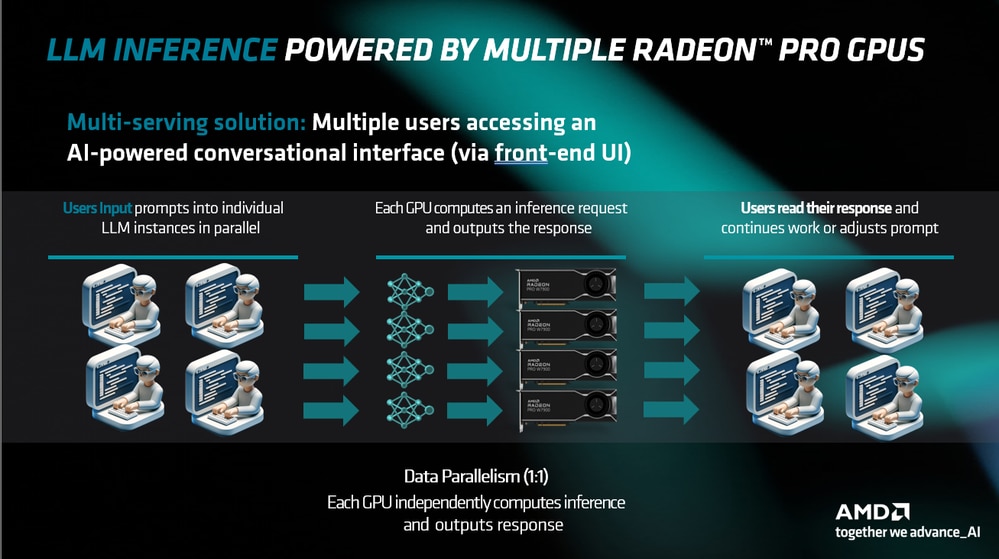
AMD Radeon™ PRO GPUs and ROCm™ Software for LLM Inference
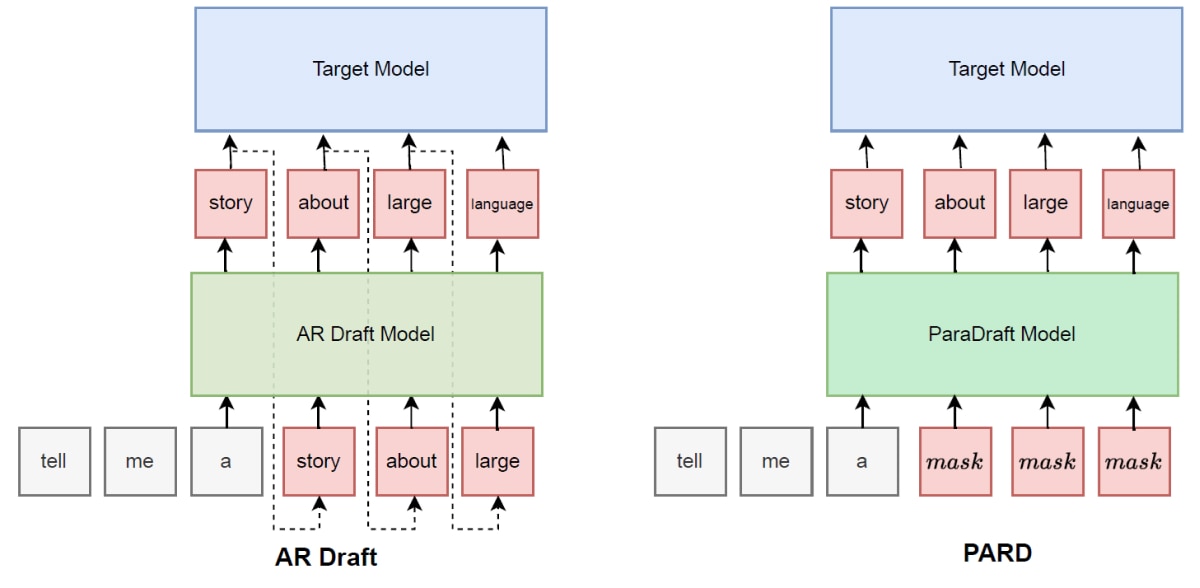
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
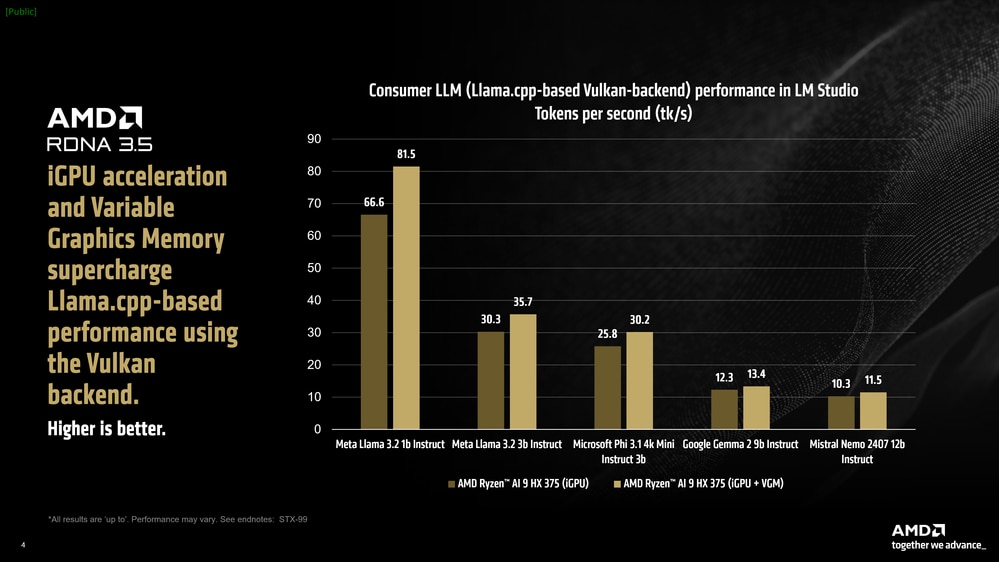
Accelerating Llama.cpp Performance in Consumer LLM Applications with ...
Advertisement Space (336x280)
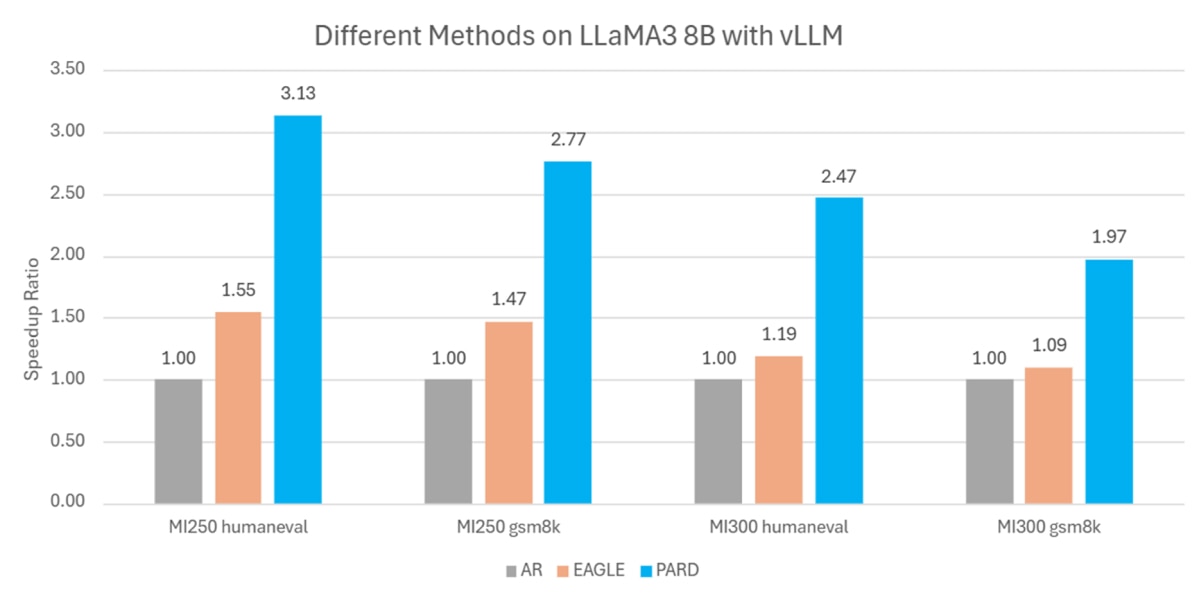
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
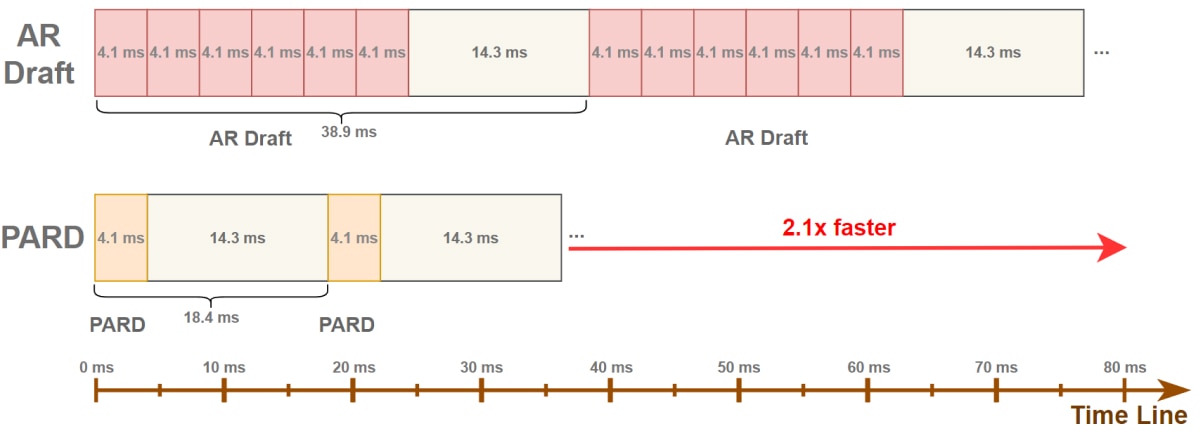
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
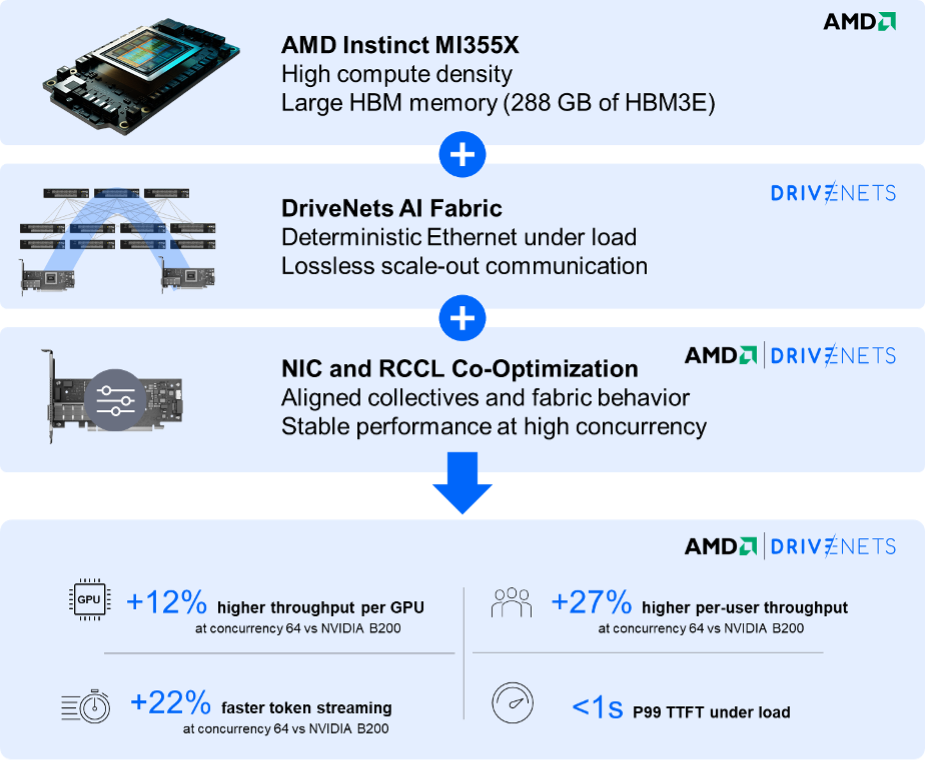
How AMD Instinct Shines in Real-World LLM Inference
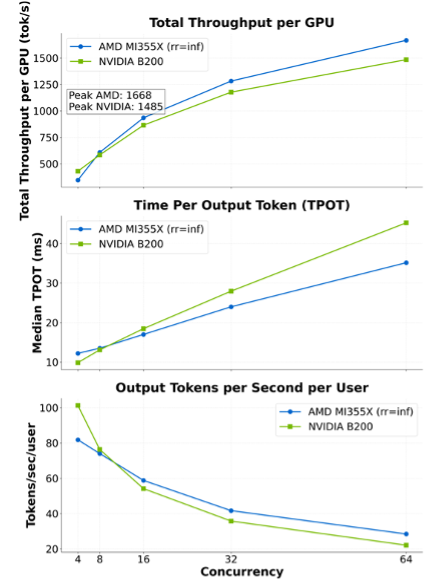
How AMD Instinct Shines in Real-World LLM Inference
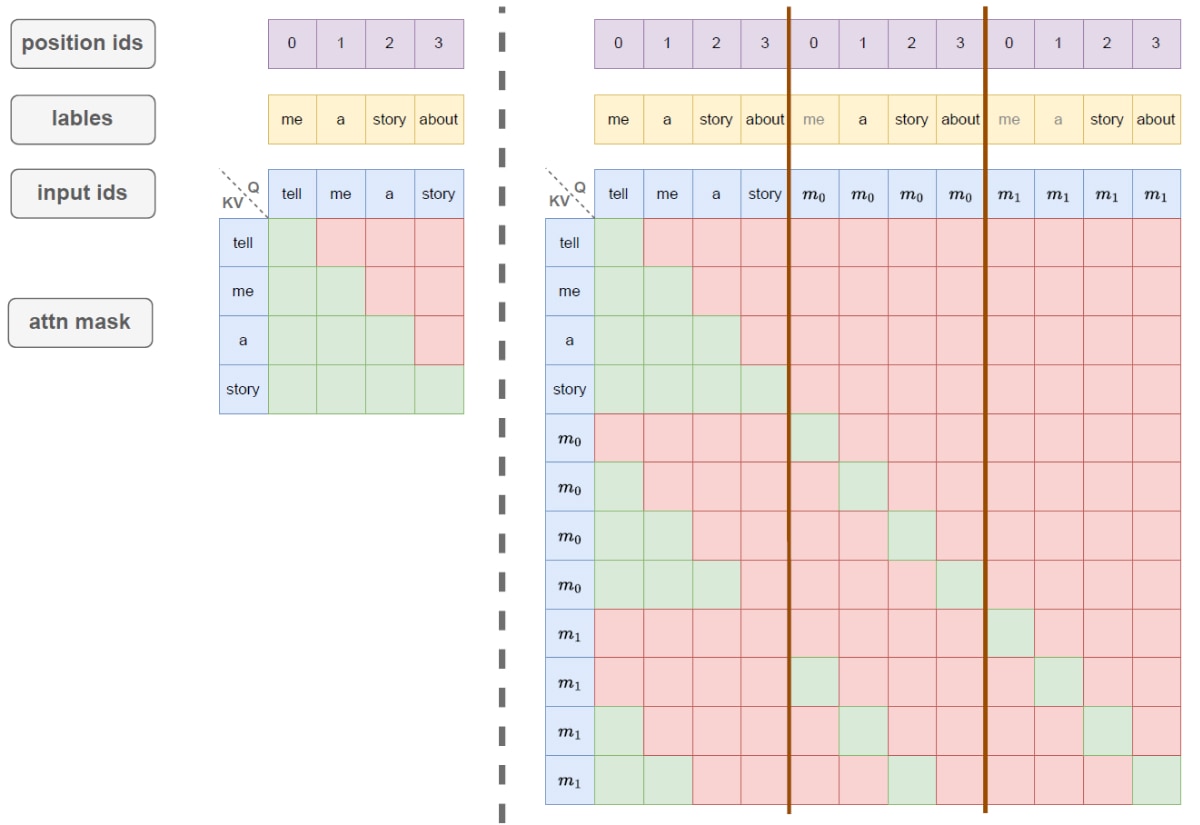
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
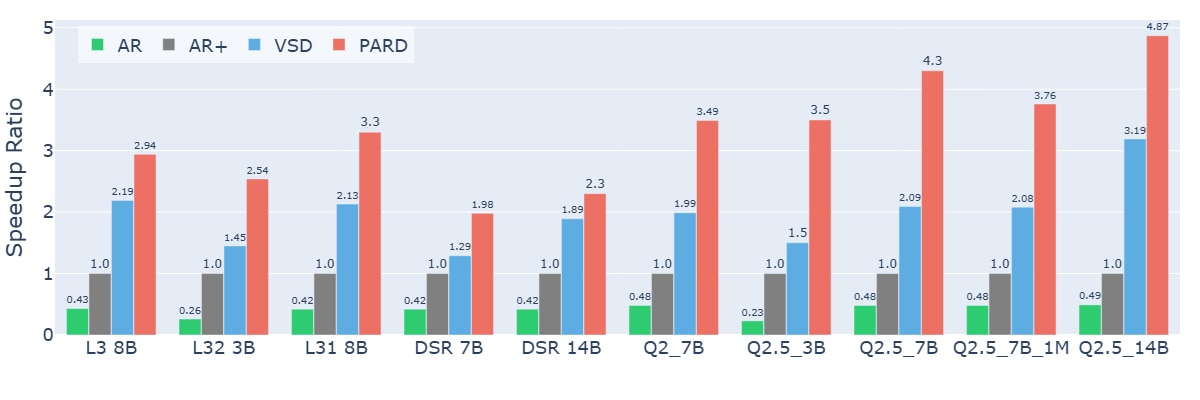
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
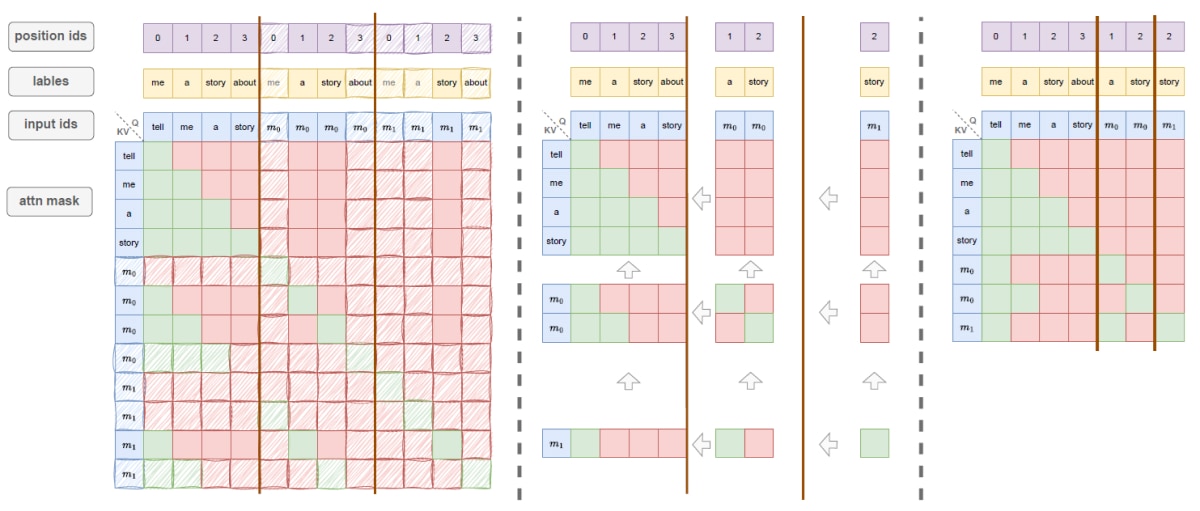
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
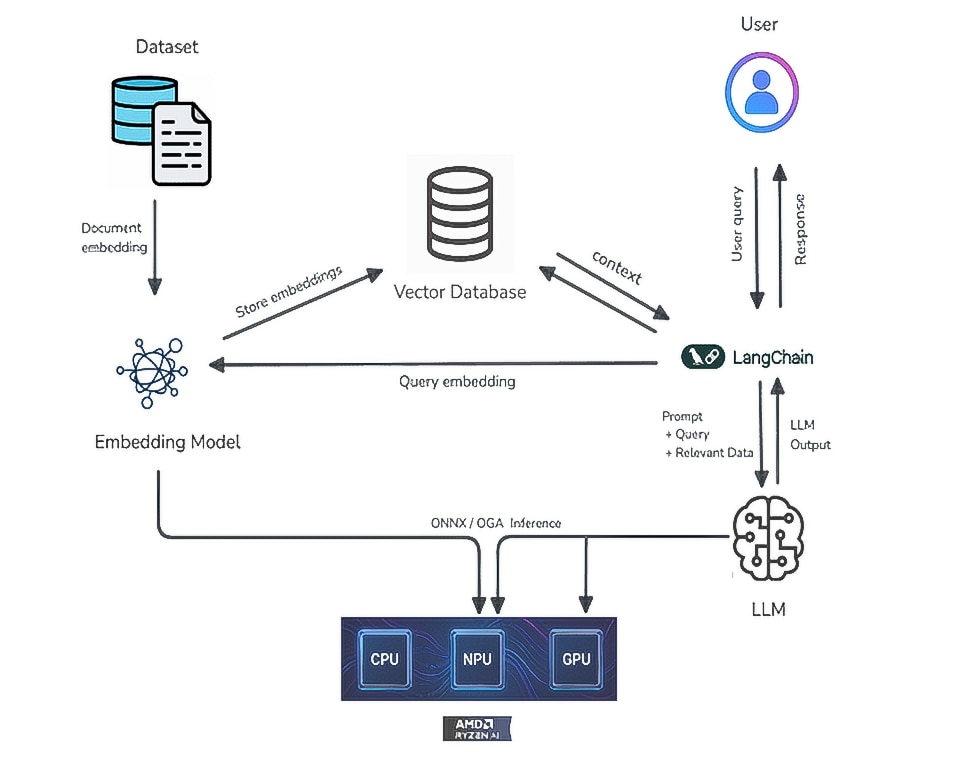
RAG with Hybrid LLM on AMD Ryzen AI Processors
Accelerate Deep Learning and LLM Inference with Apache Spark in the ...
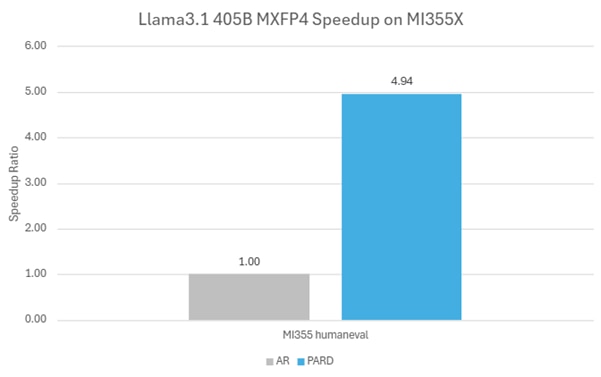
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Advertisement Space (336x280)

LIA: A Single-GPU LLM Inference Acceleration with Cooperative AMX ...
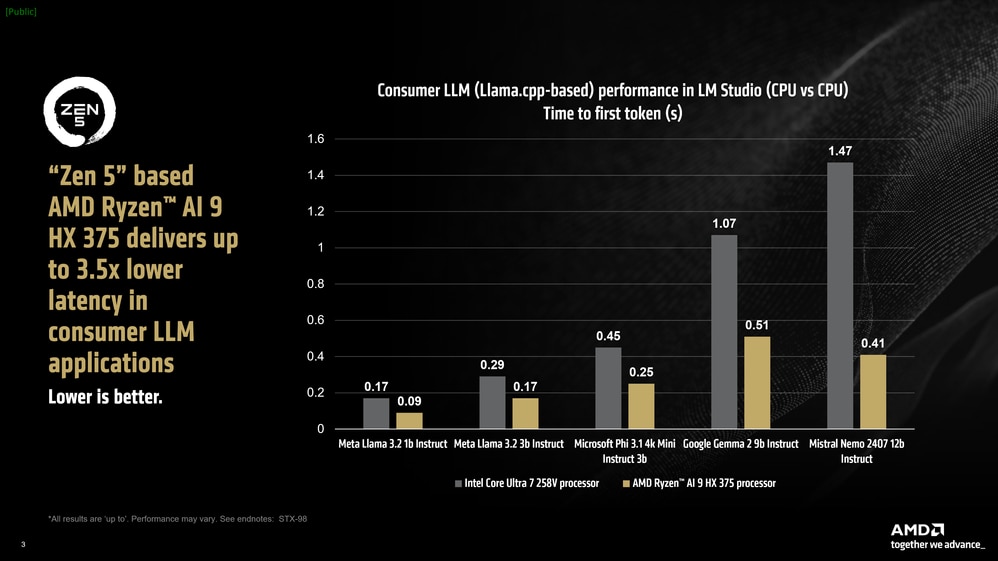
Accelerating Llama.cpp Performance in Consumer LLM Applications with ...
GitHub - oliverv/collabmind-ipex-llm: Accelerate local LLM inference ...

Accelerating LLM Inference - Tradeoffs, Design, and New Ideas
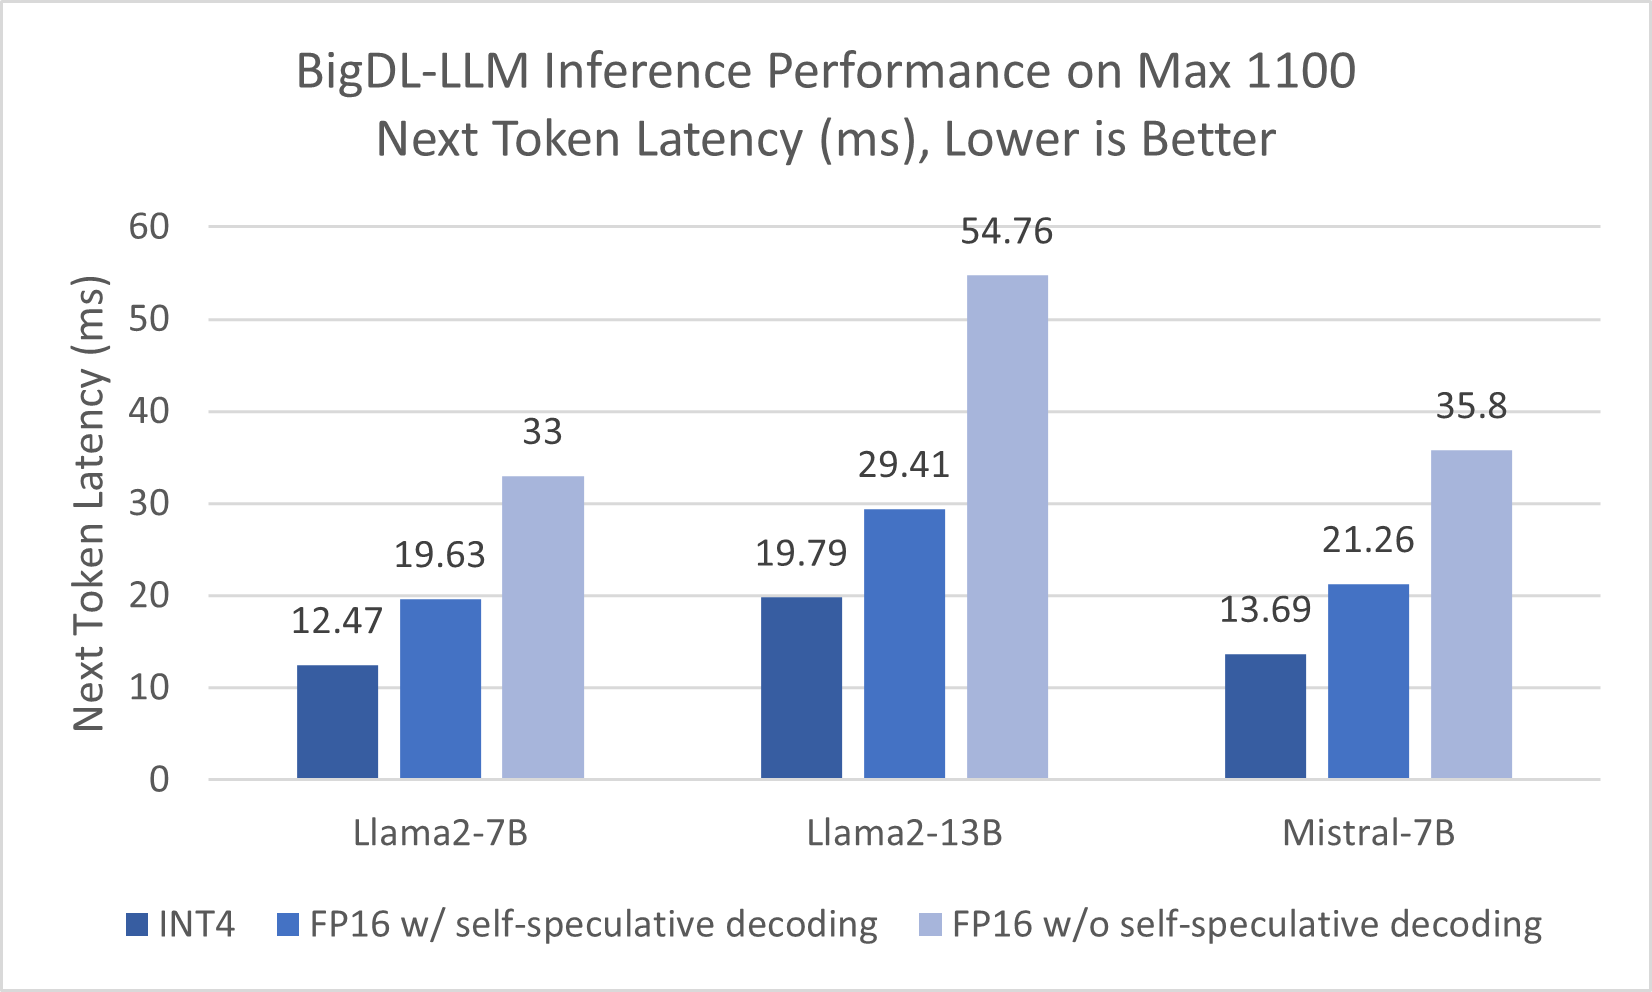
Accelerating LLM Inference on Intel Data Center GPUs using BigDL LLM

Paper page - Architecture-Aware LLM Inference Optimization on AMD ...