
Pard Accelerating Llm Inference With Low Cost Parallel Draft Model

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...

PARD: Accelerating LLM Inference with Low-Cost PARallel Draft Model ...
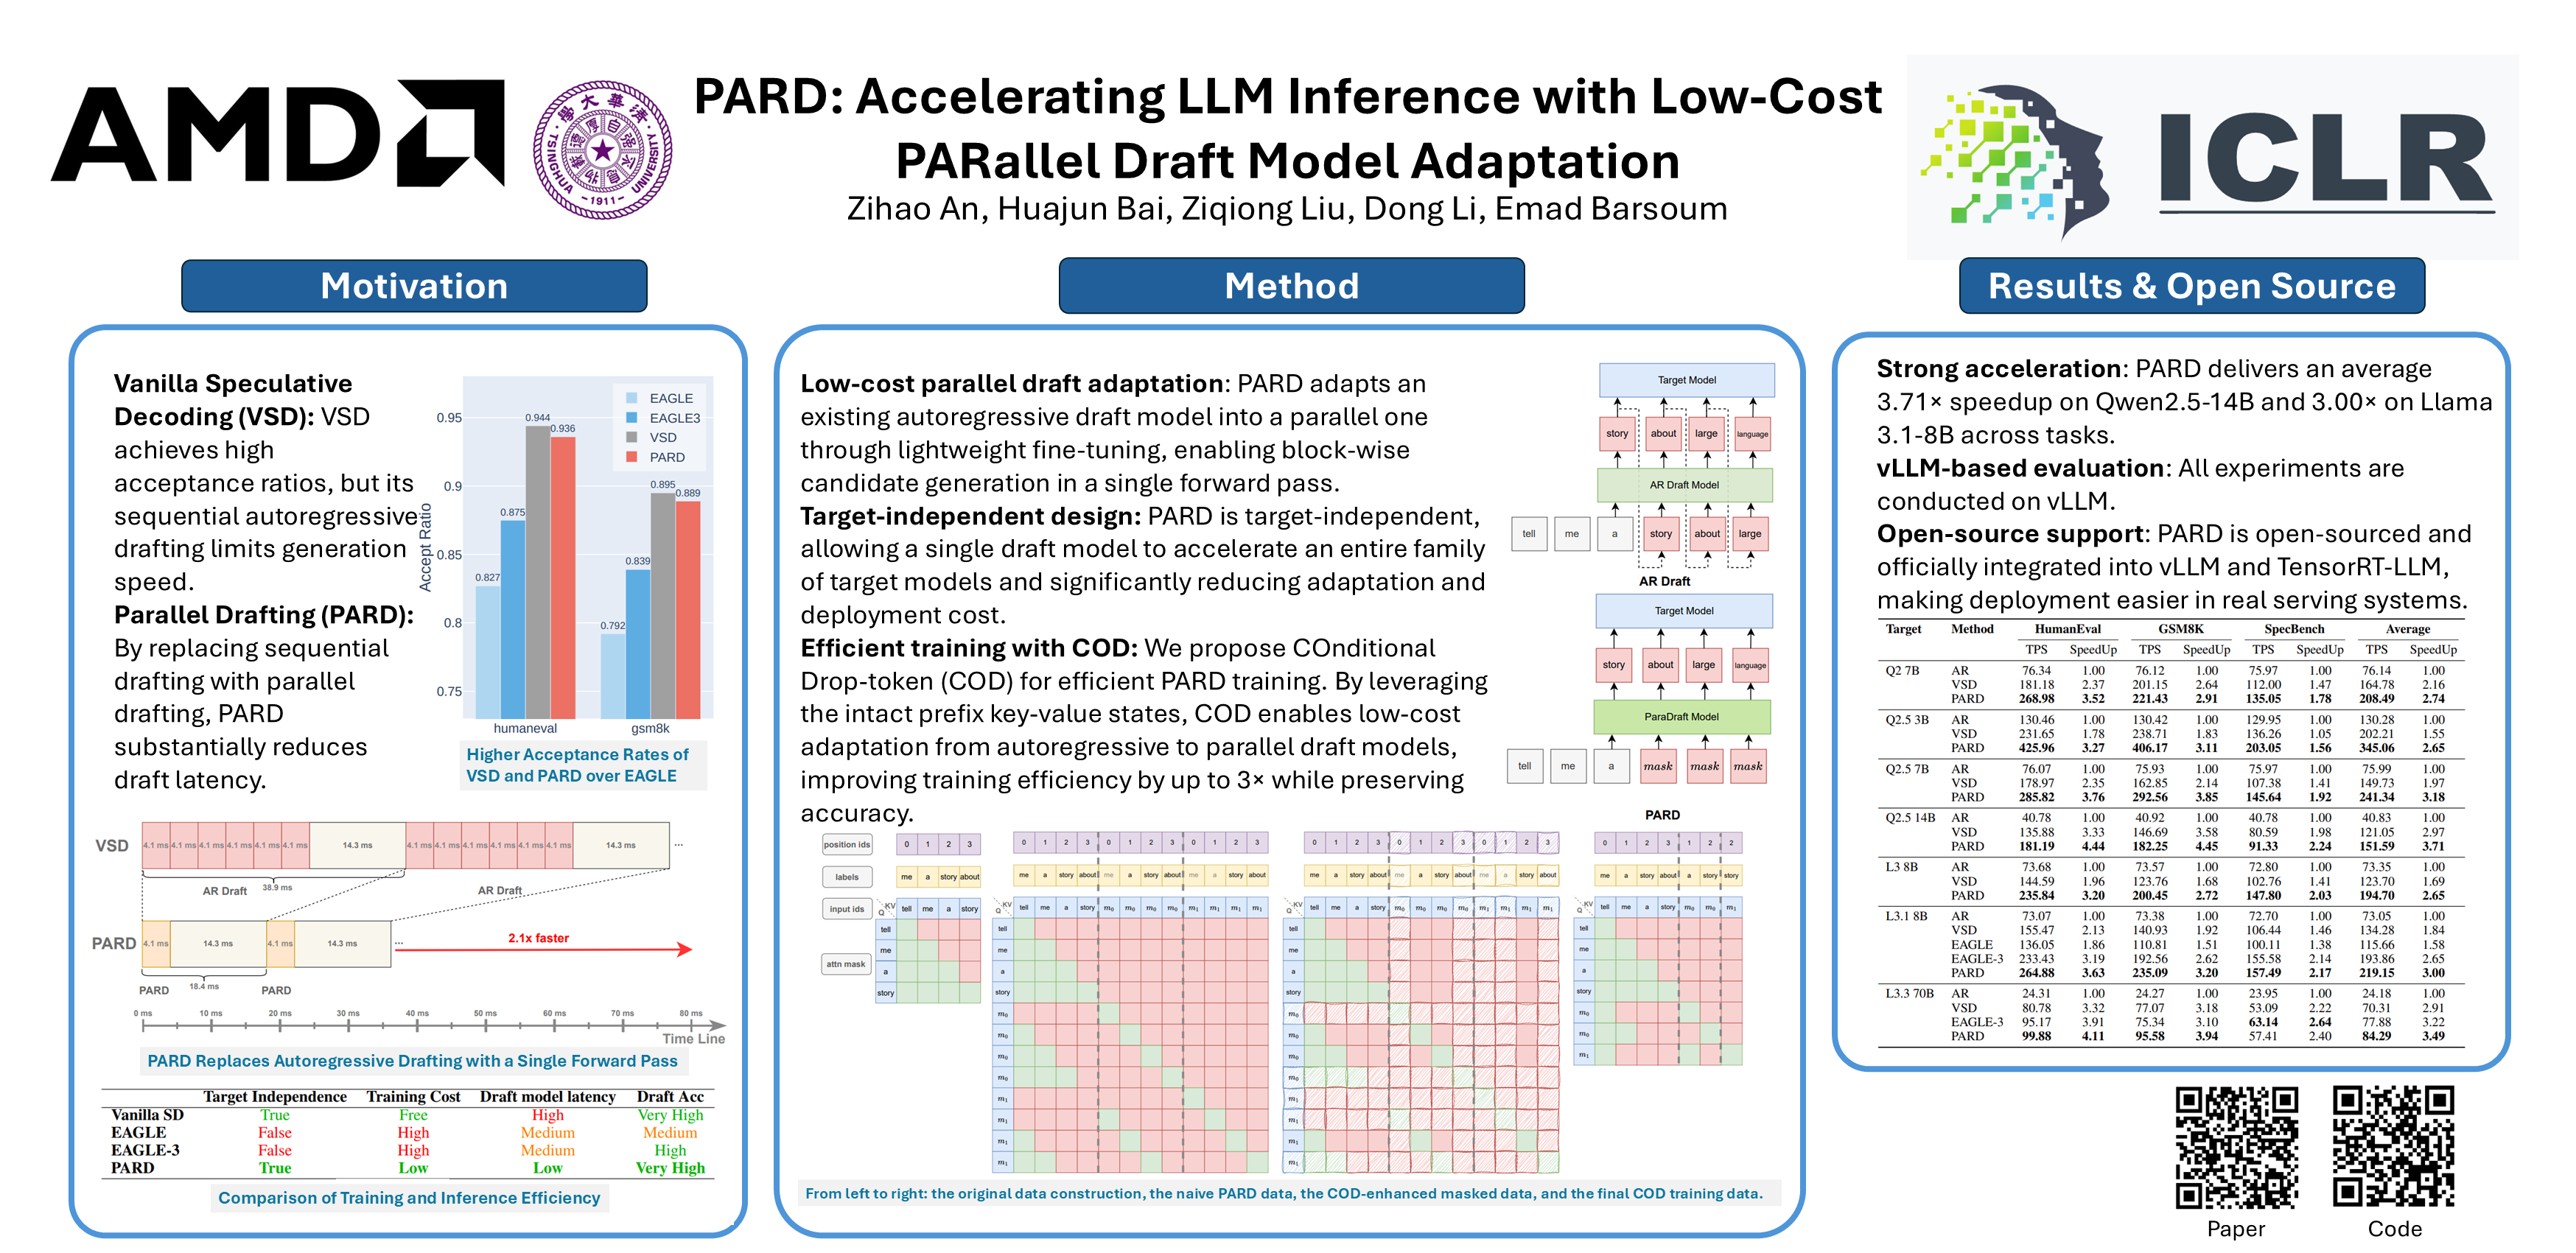
ICLR Poster PARD: Accelerating LLM Inference with Low‑Cost PARallel ...
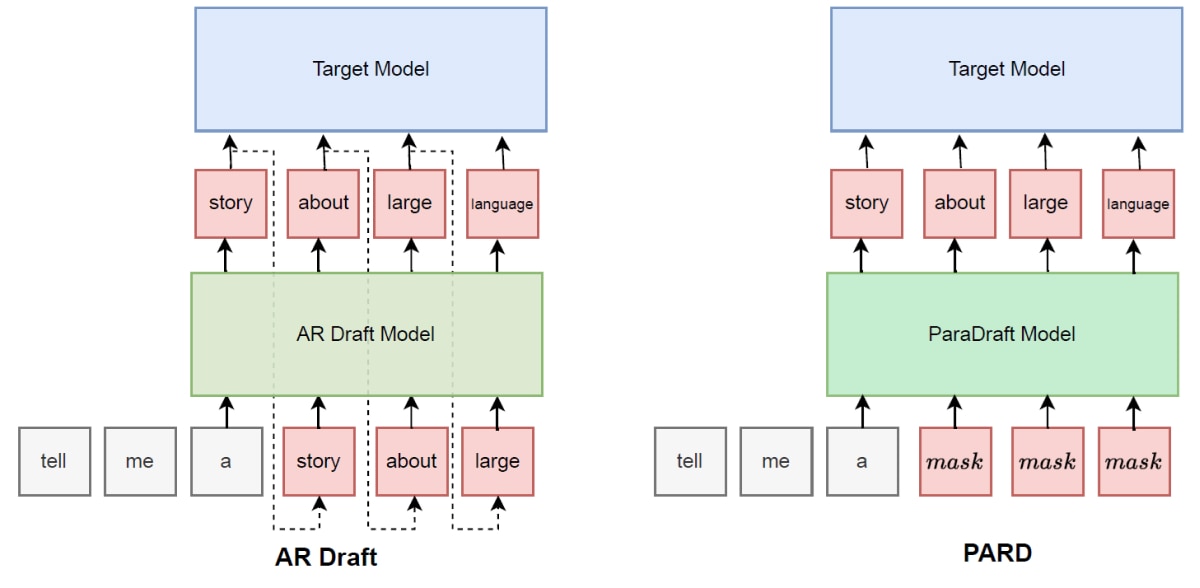
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)

Paper page - PARD: Accelerating LLM Inference with Low-Cost PARallel ...
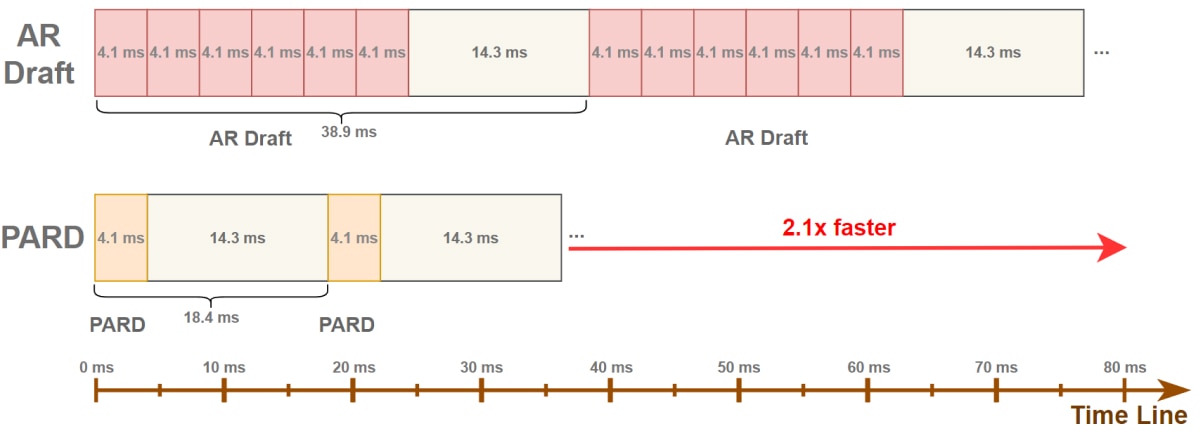
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
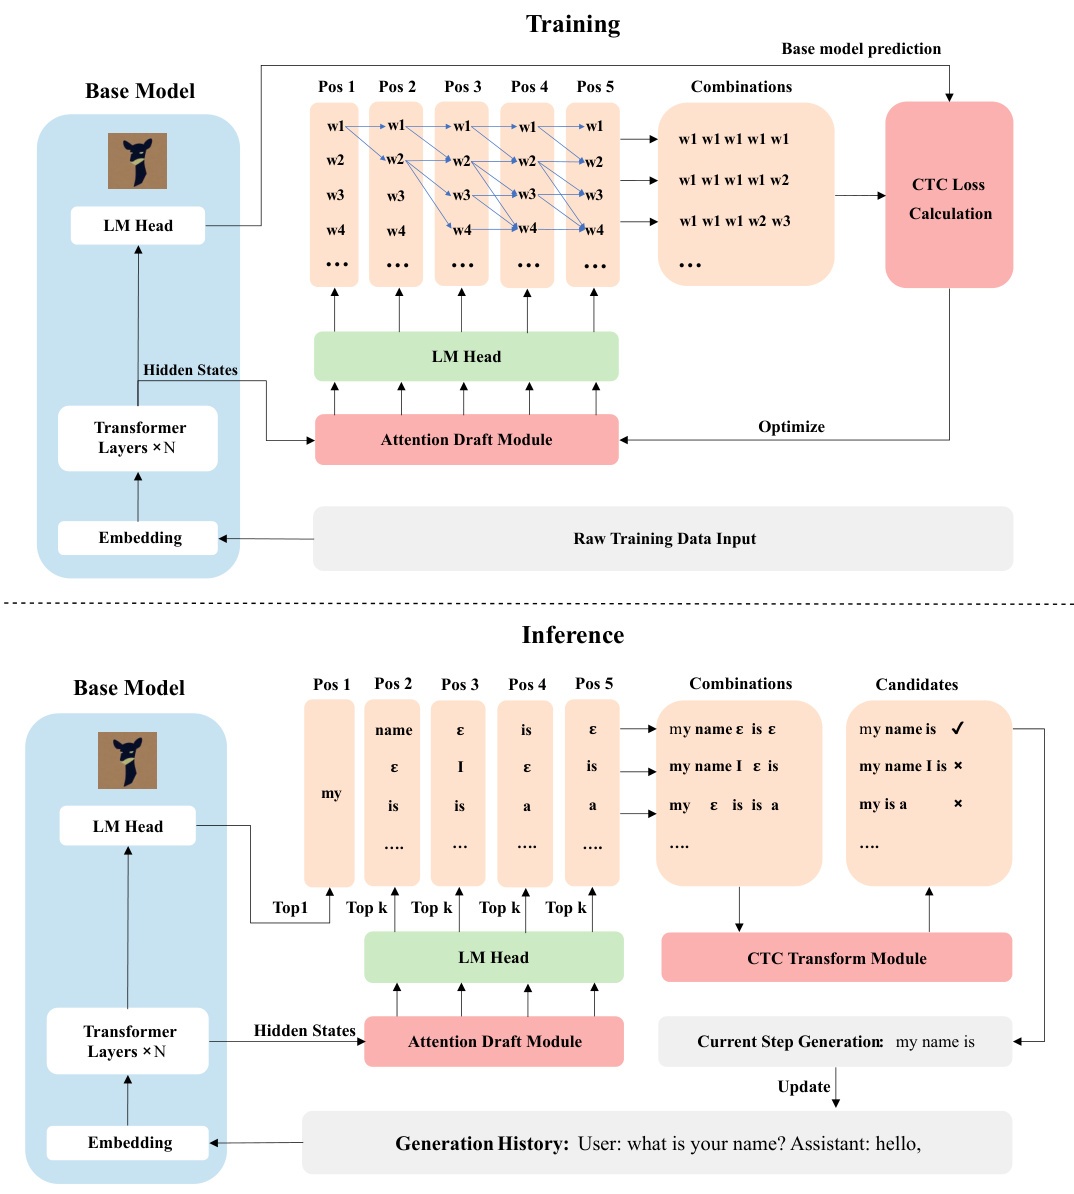
Speculative Decoding with CTC-based Draft Model for LLM Inference ...
Advertisement Space (300x250)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
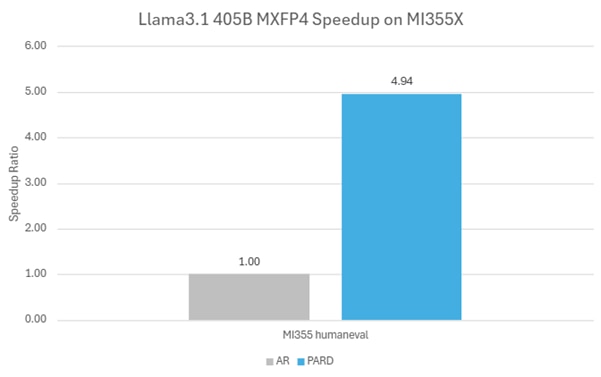
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
Accelerating Generative LLMs Inference with Parallel Draft Models (PARD)
GitHub - AMD-AGI/PARD: PARD: Accelerating LLM Inference with Low-Cost ...
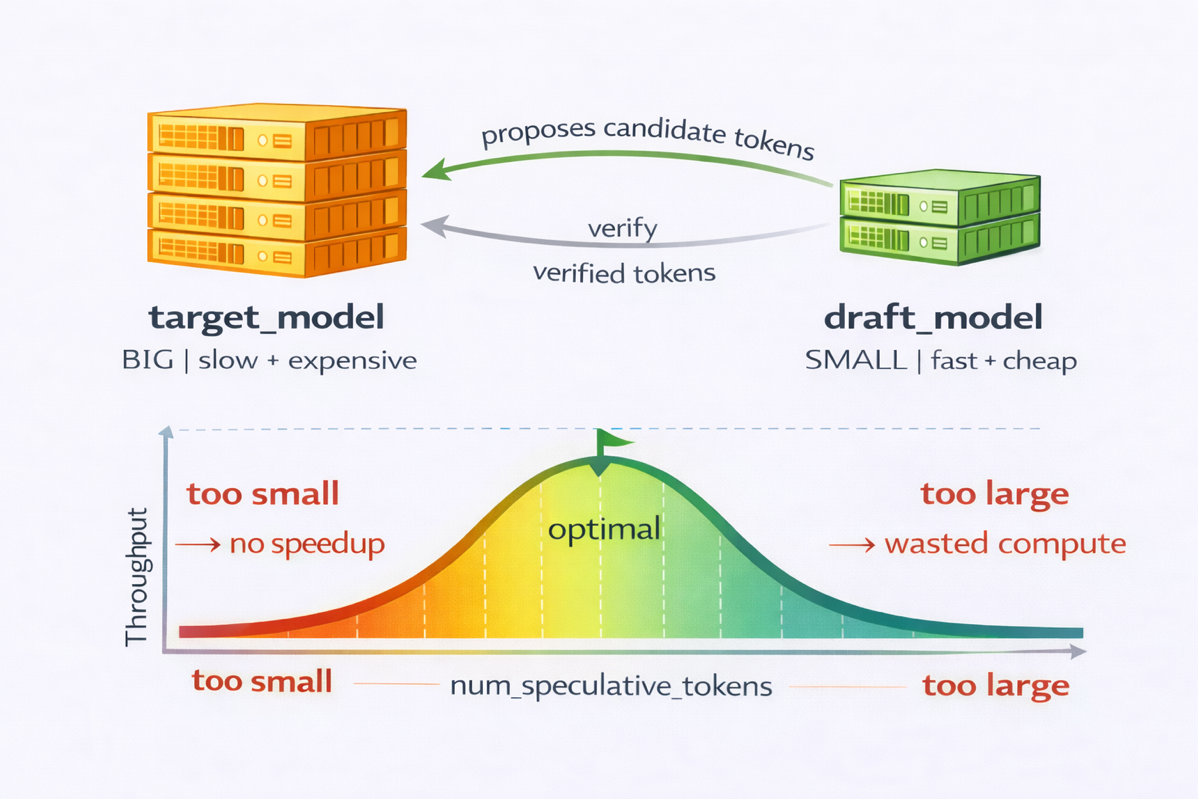
Tuto Startup - Accelerating decode-heavy LLM inference with speculative dec
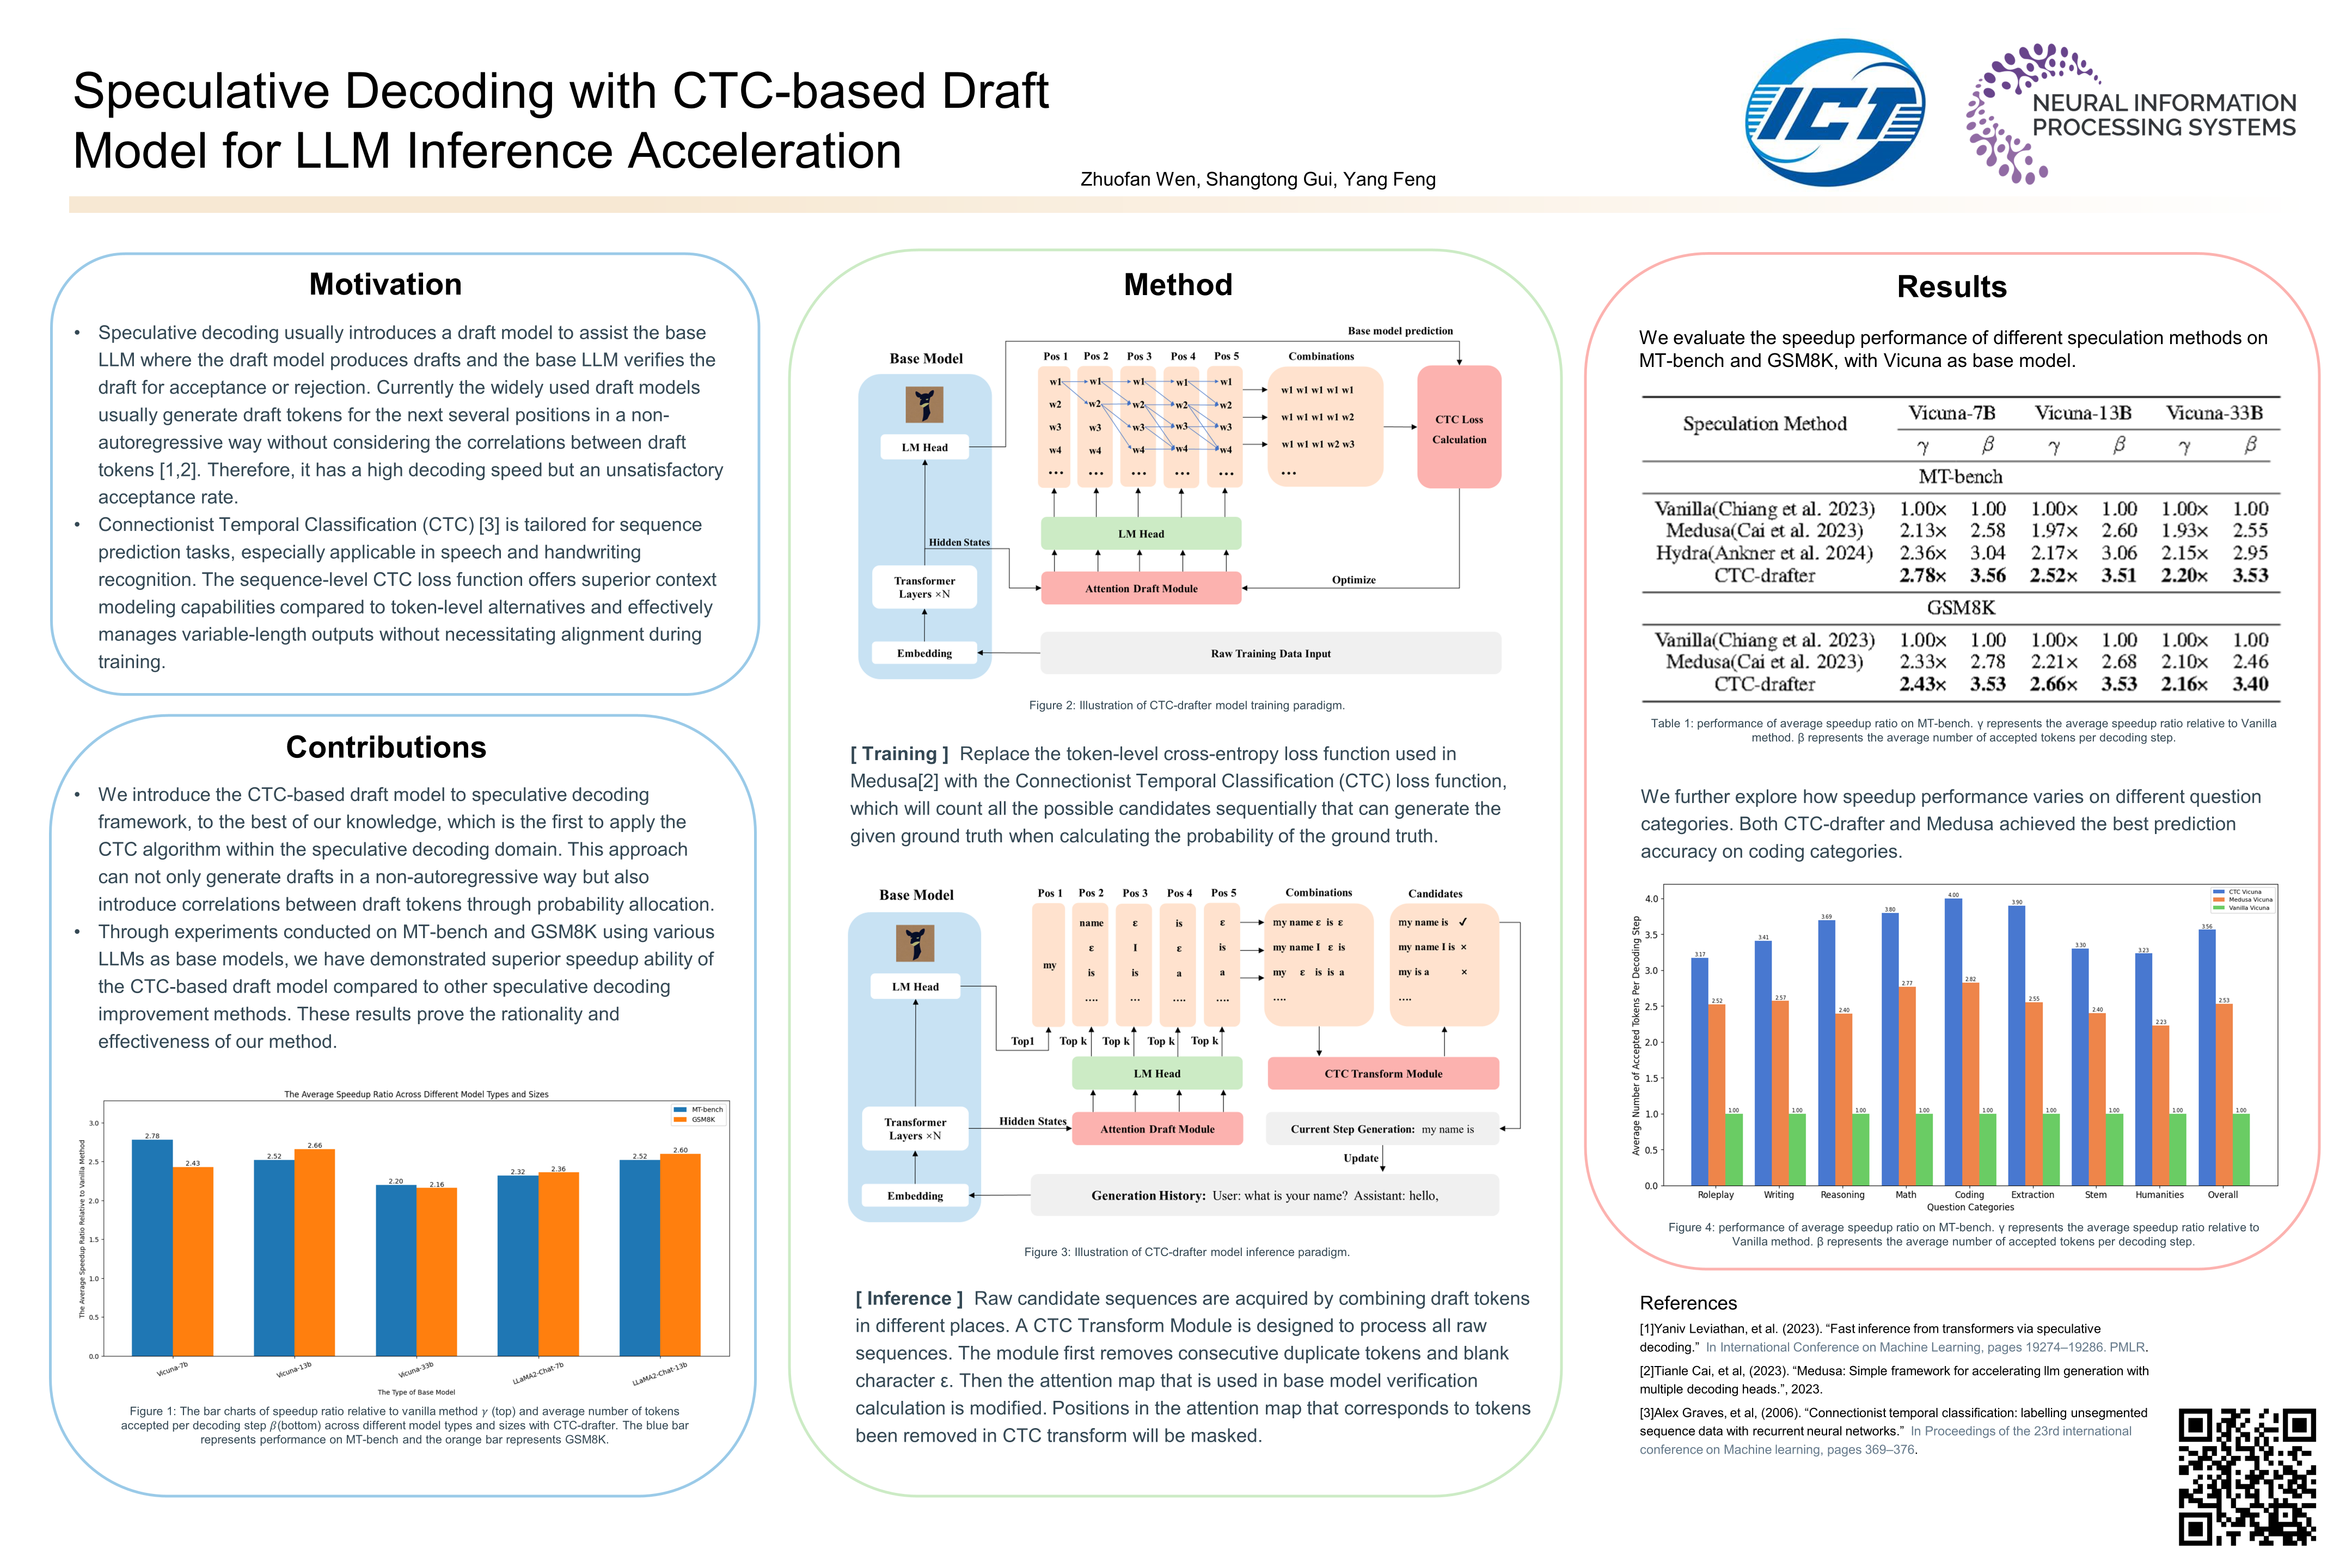
NeurIPS Poster Speculative Decoding with CTC-based Draft Model for LLM ...
Accelerating LLM Inference with Prompt Caching for Open‑Source Models ...
Advertisement Space (336x280)
P-EAGLE: Accelerating LLM Inference via Parallel Speculative Decoding ...
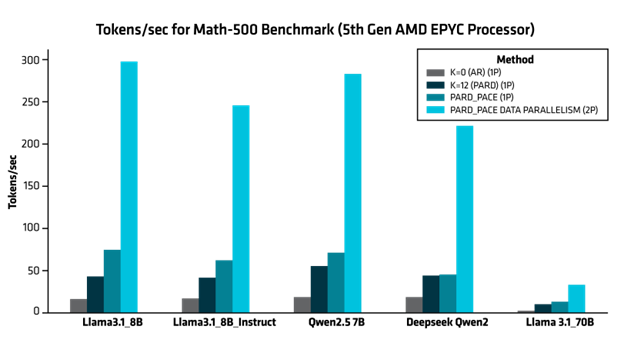
Speculative LLM Inference on the 5th Gen AMD EPYC Processors with PARD ...
Paper page - Accelerating LLM Inference with Staged Speculative Decoding
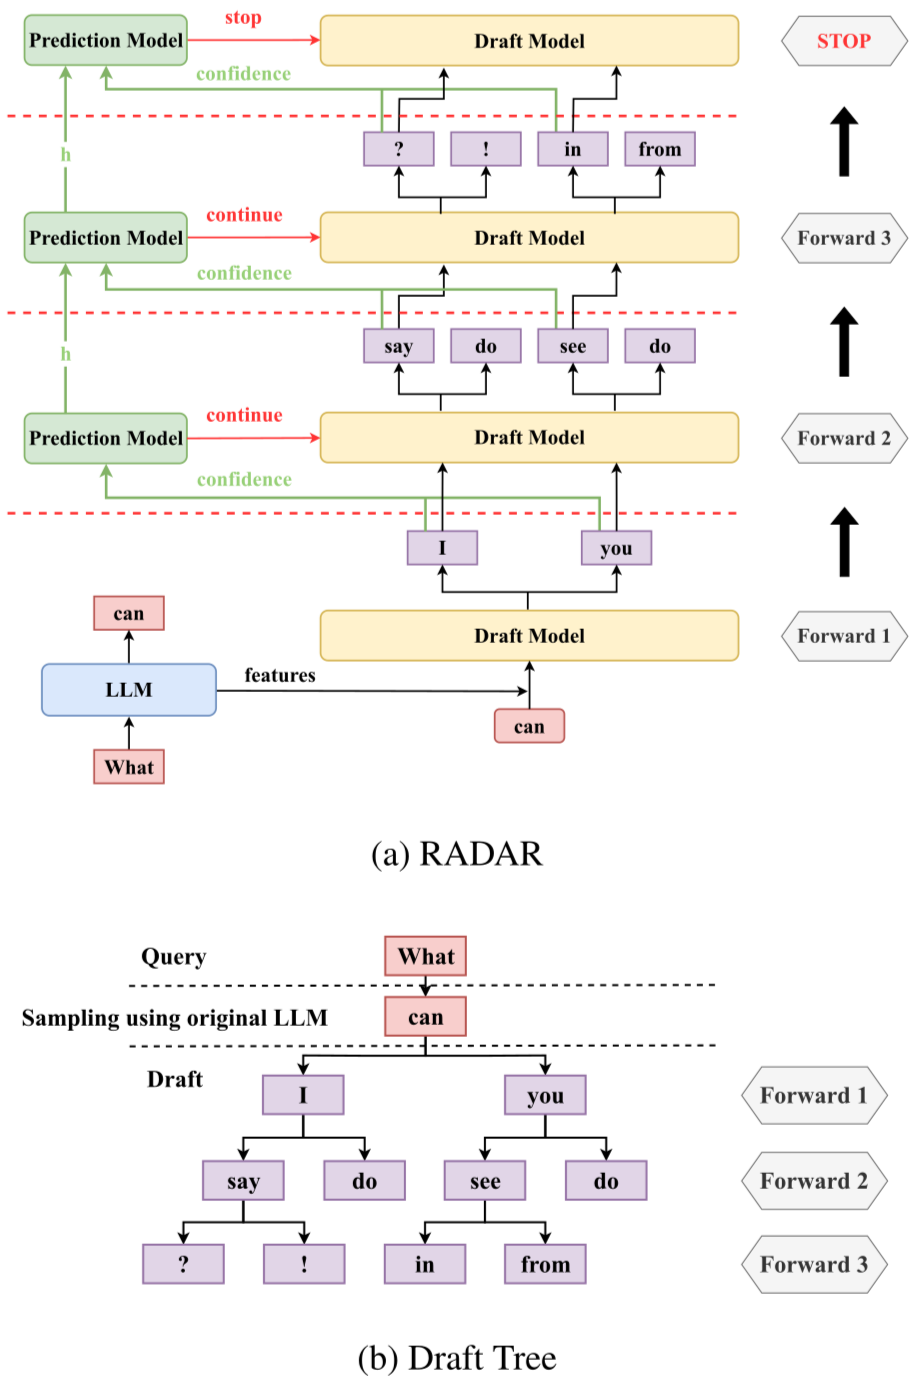
[논문 리뷰] RADAR: Accelerating Large Language Model Inference With RL ...
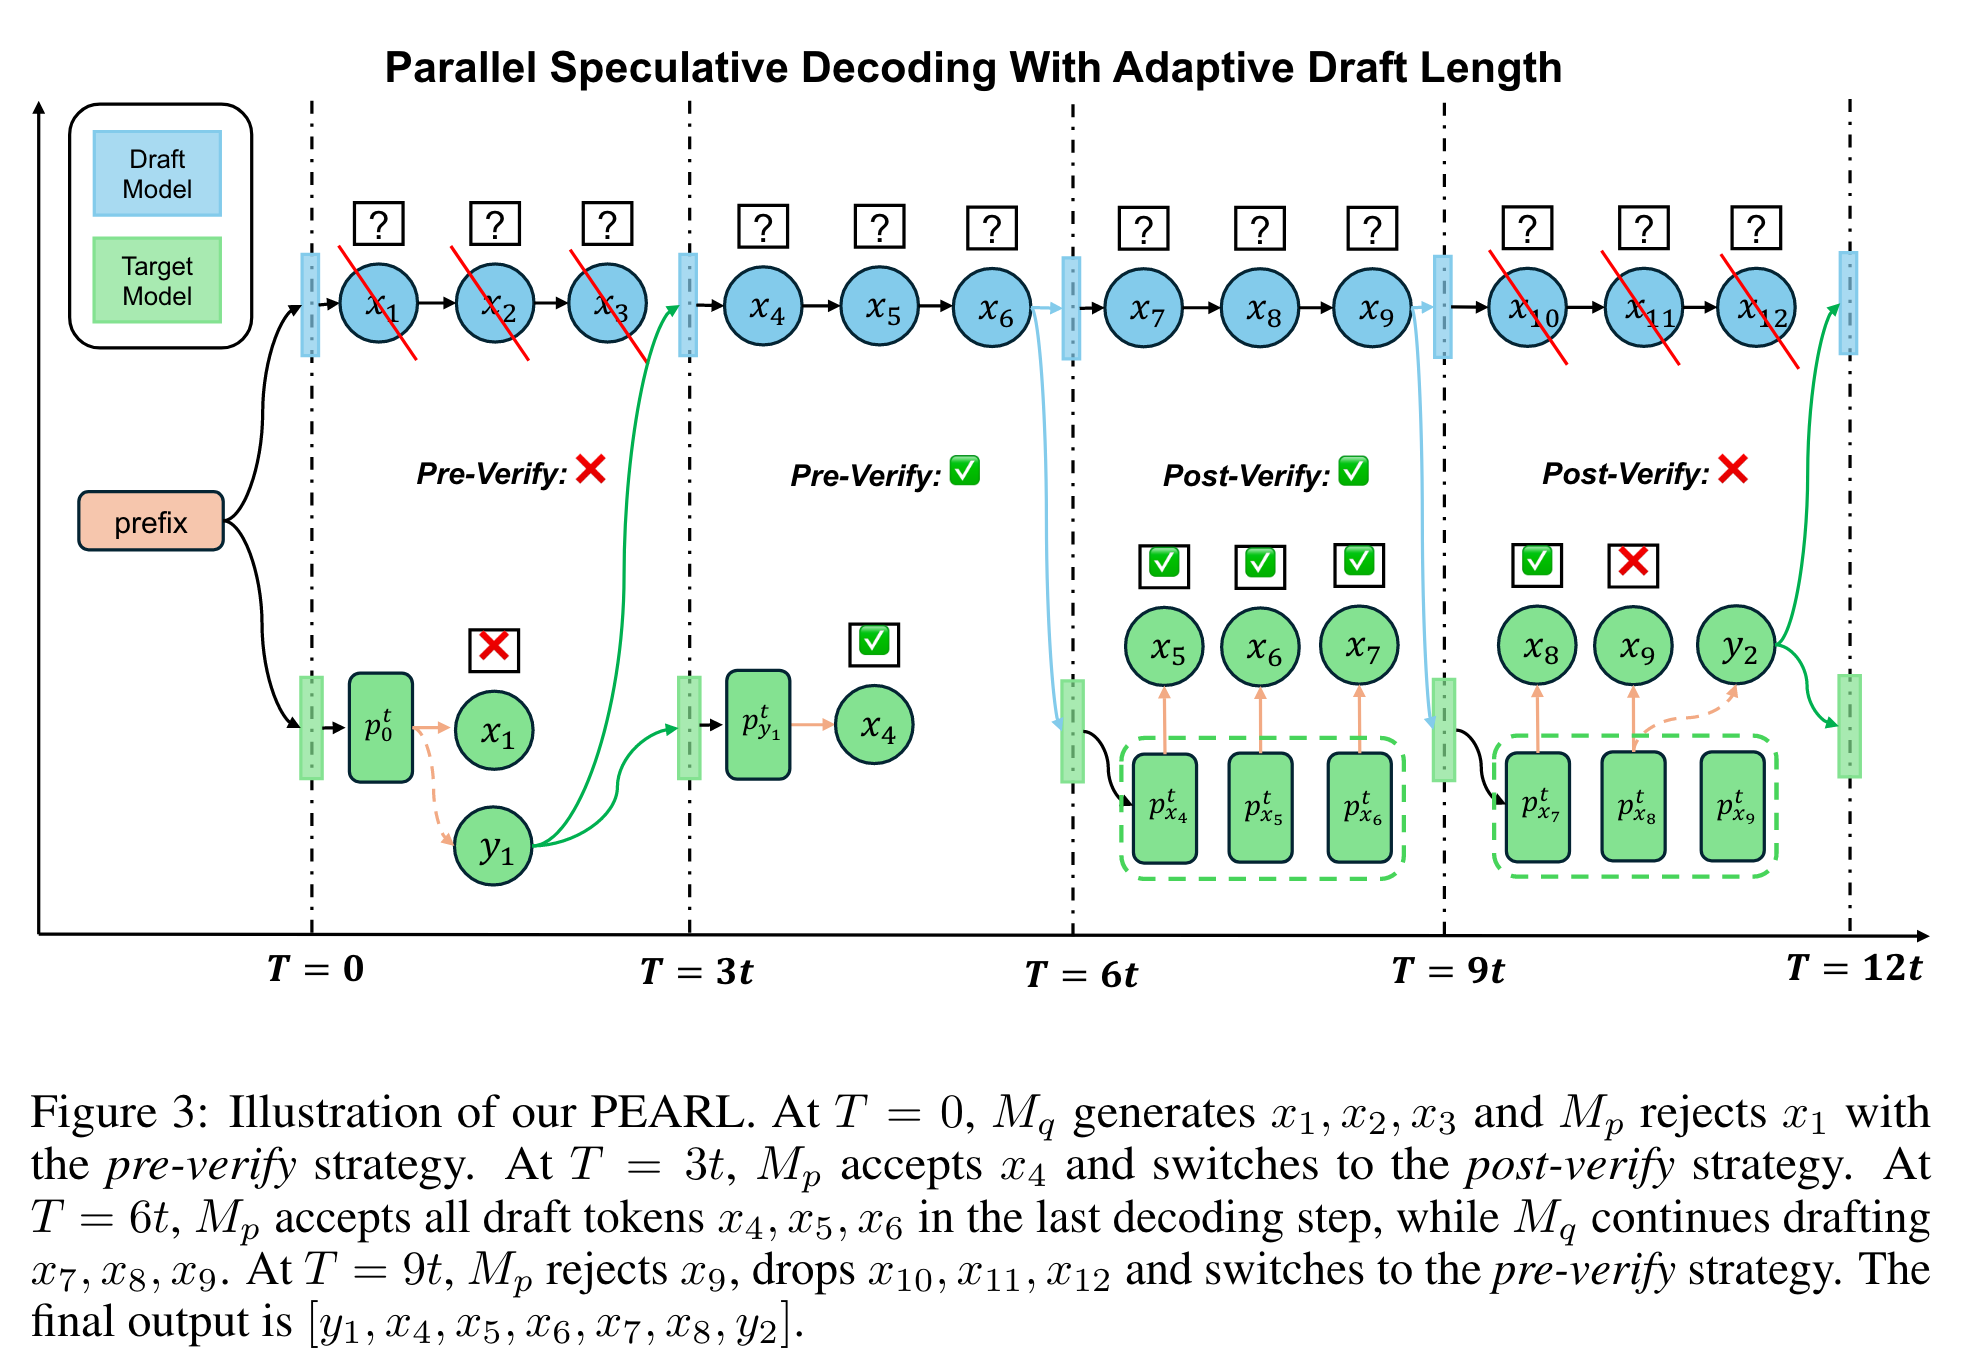
PEARL: Parallel Speculative Decoding with Adaptive Draft Length - 知乎
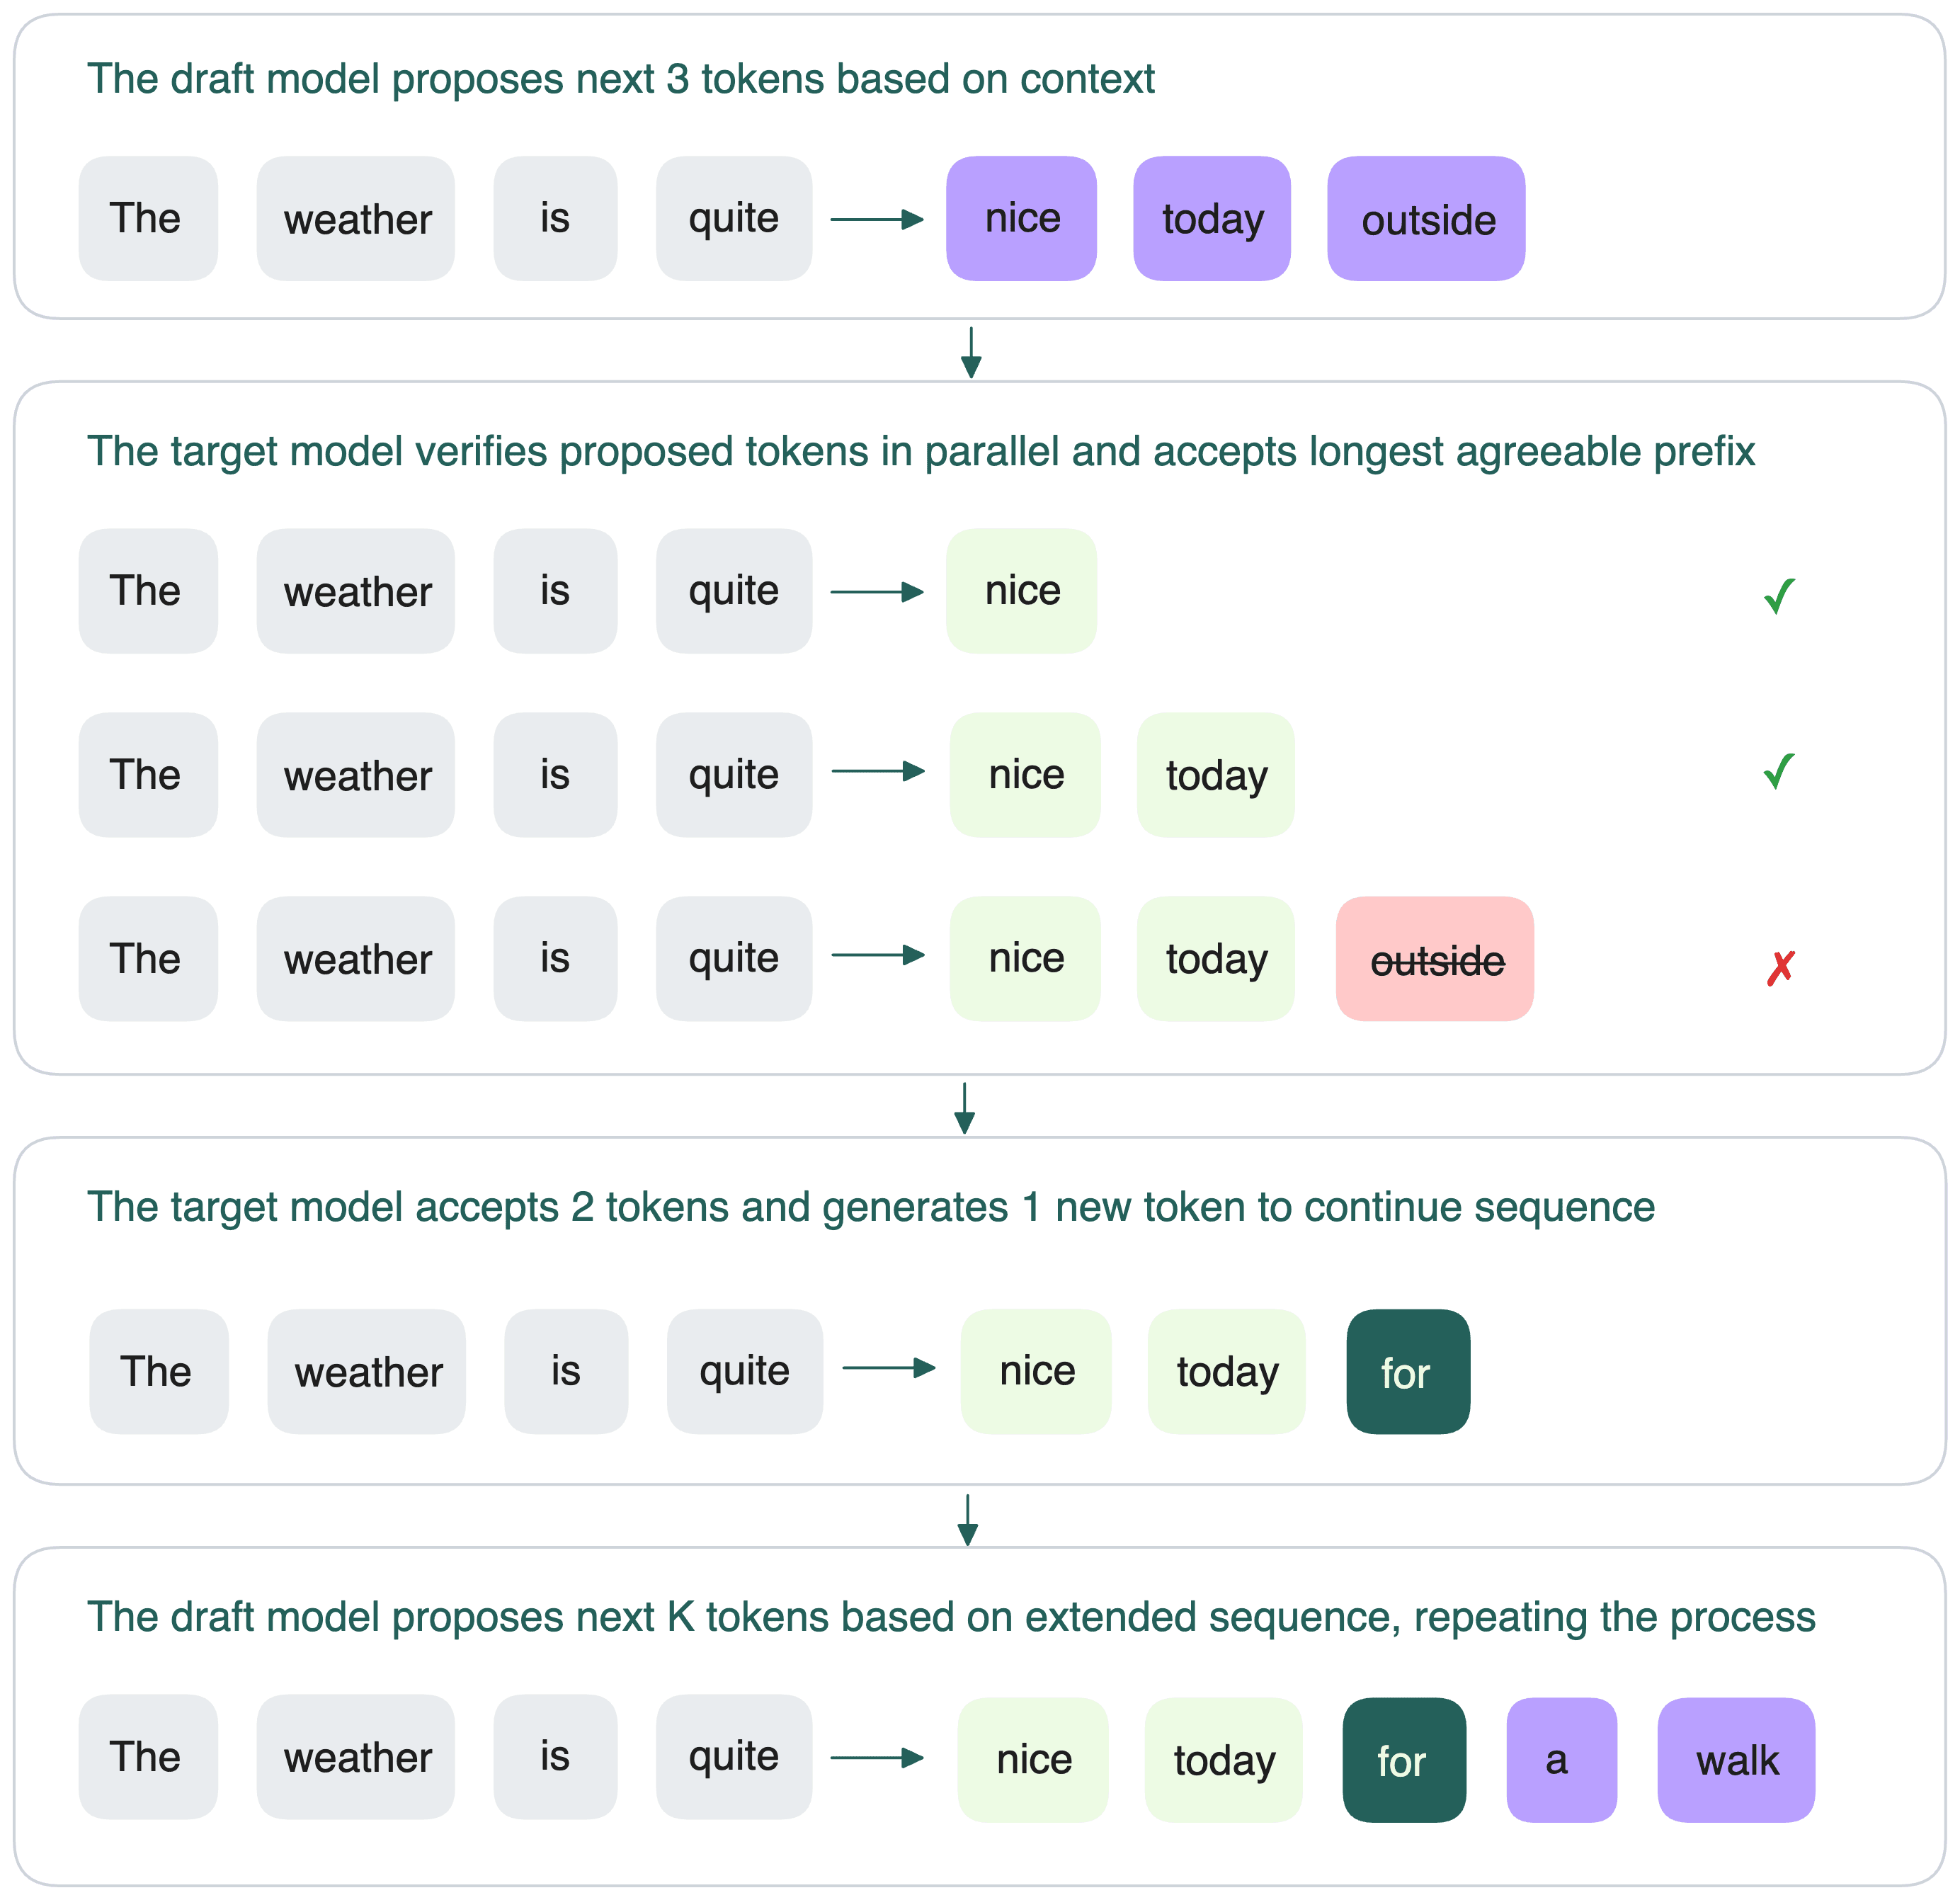
Get 3× Faster LLM Inference with Speculative Decoding Using the Right ...

Model Parallelism for LLM Inference | LeetLLM

PARD-2: Target-Aligned Parallel Draft Model for Dual-Mode Speculative ...
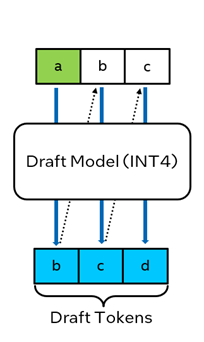
Accelerating LLM Inference on Intel Data Center GPUs using BigDL LLM

Model Parallelism for LLM Inference | LeetLLM
Advertisement Space (336x280)
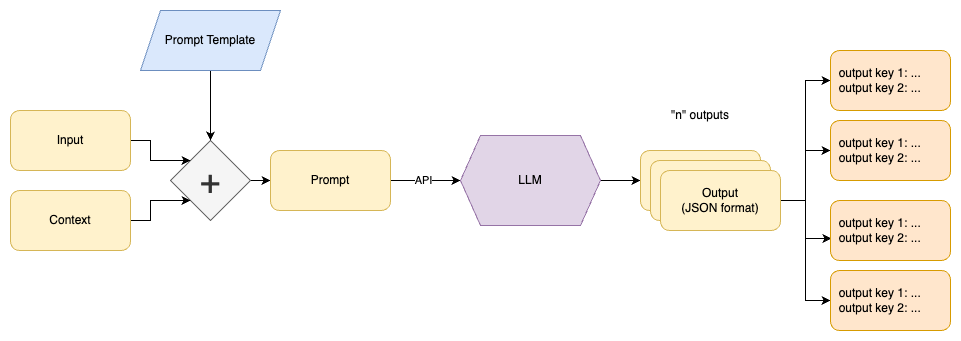
Accelerating LLM operations with parallel-parrot

Accelerating Diffusion LLM Inference via Local Determinism Propagation ...

LLM Inference Benchmarking: How Much Does Your LLM Inference Cost ...
Accelerating LLM Inference on Intel Data Center GPUs using BigDL LLM

Paper page - AccLLM: Accelerating Long-Context LLM Inference Via ...

Parallel CPU-GPU Execution for LLM Inference on Constrained GPUs | AI ...