
Github Modelcloudgptqmodel Llm Model Quantization Compression
GitHub - ModelCloud/GPTQModel: LLM model quantization (compression ...
Model Compression Economics: How Quantization and Distillation Cut LLM ...

LLM Inference, Quantization, and Model Compression
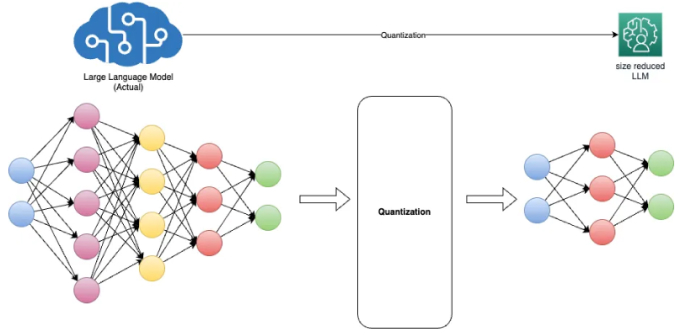
Top LLM Quantization Methods and Their Impact on Model Quality

GitHub - HuangOwen/Awesome-LLM-Compression: Awesome LLM compression ...
Model Quantization Guide: Reduce LLM Size and Cost | DevOpsNess

LLM Model Compression Techniques - Best Generative AI & Machine ...
GitHub - Lyun-Huang/model-compression: model compression based on ...
Quantization and Model Compression Making Neural Networks Deployable ...

LLM inference optimization: Model Quantization and Distillation - YouTube
Advertisement Space (300x250)

AWQ: Activation-aware Weight Quantization for LLM Compression and ...
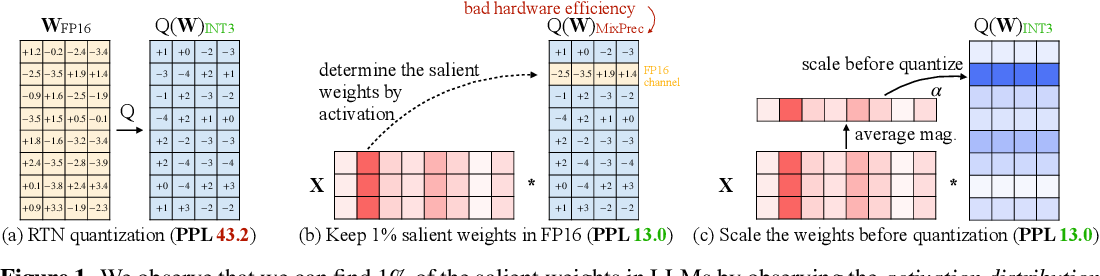
AWQ: Activation-aware Weight Quantization for LLM Compression and ...
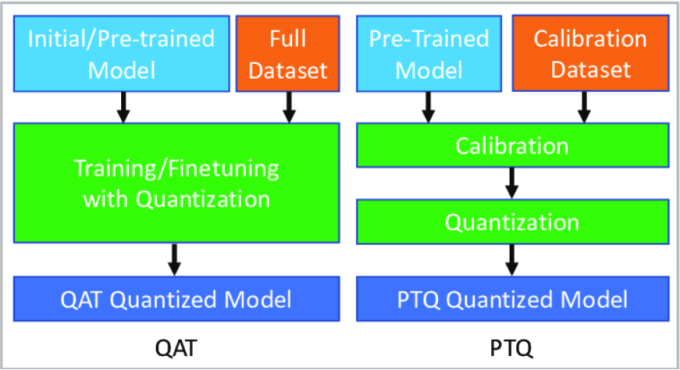
Top LLM Quantization Methods and Their Impact on Model Quality
LLM Quantization: A Comprehensive Guide to Model Compression for ...
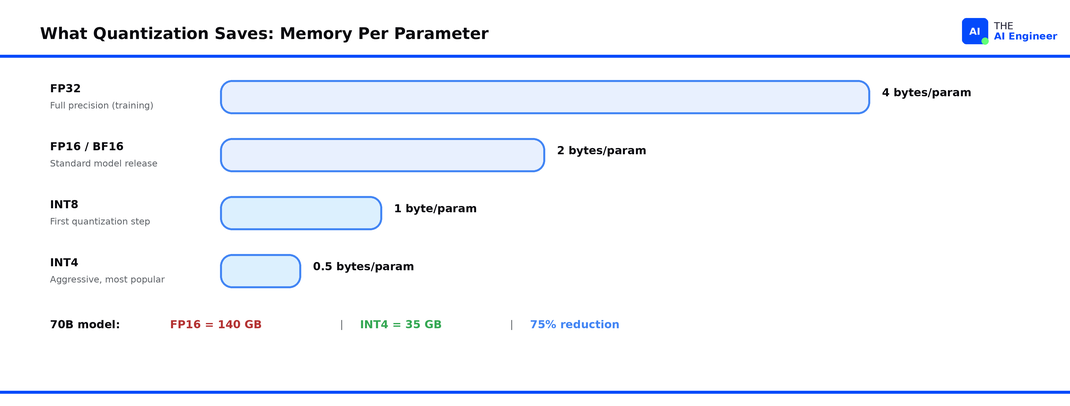
What is Quantization in AI? LLM Compression Explained
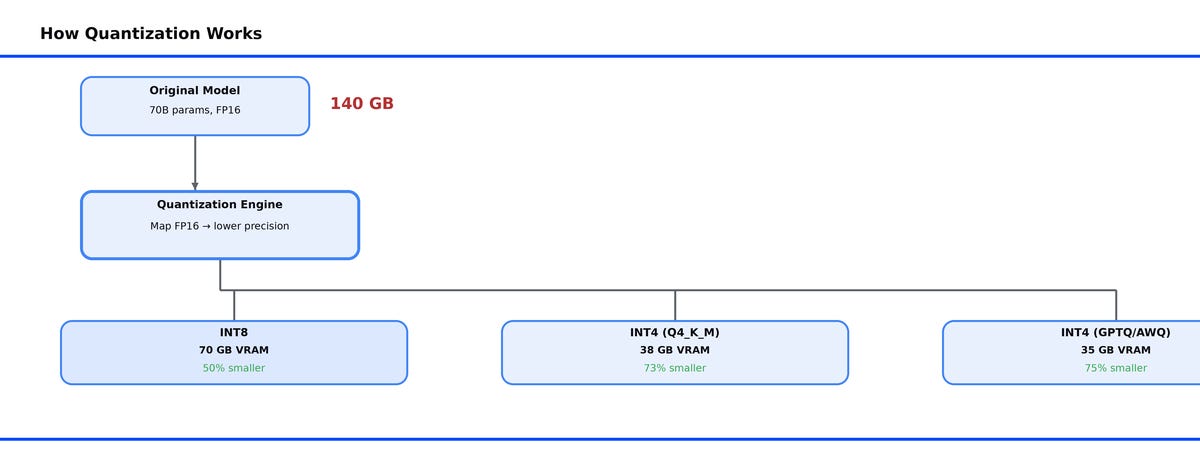
What is Quantization in AI? LLM Compression Explained
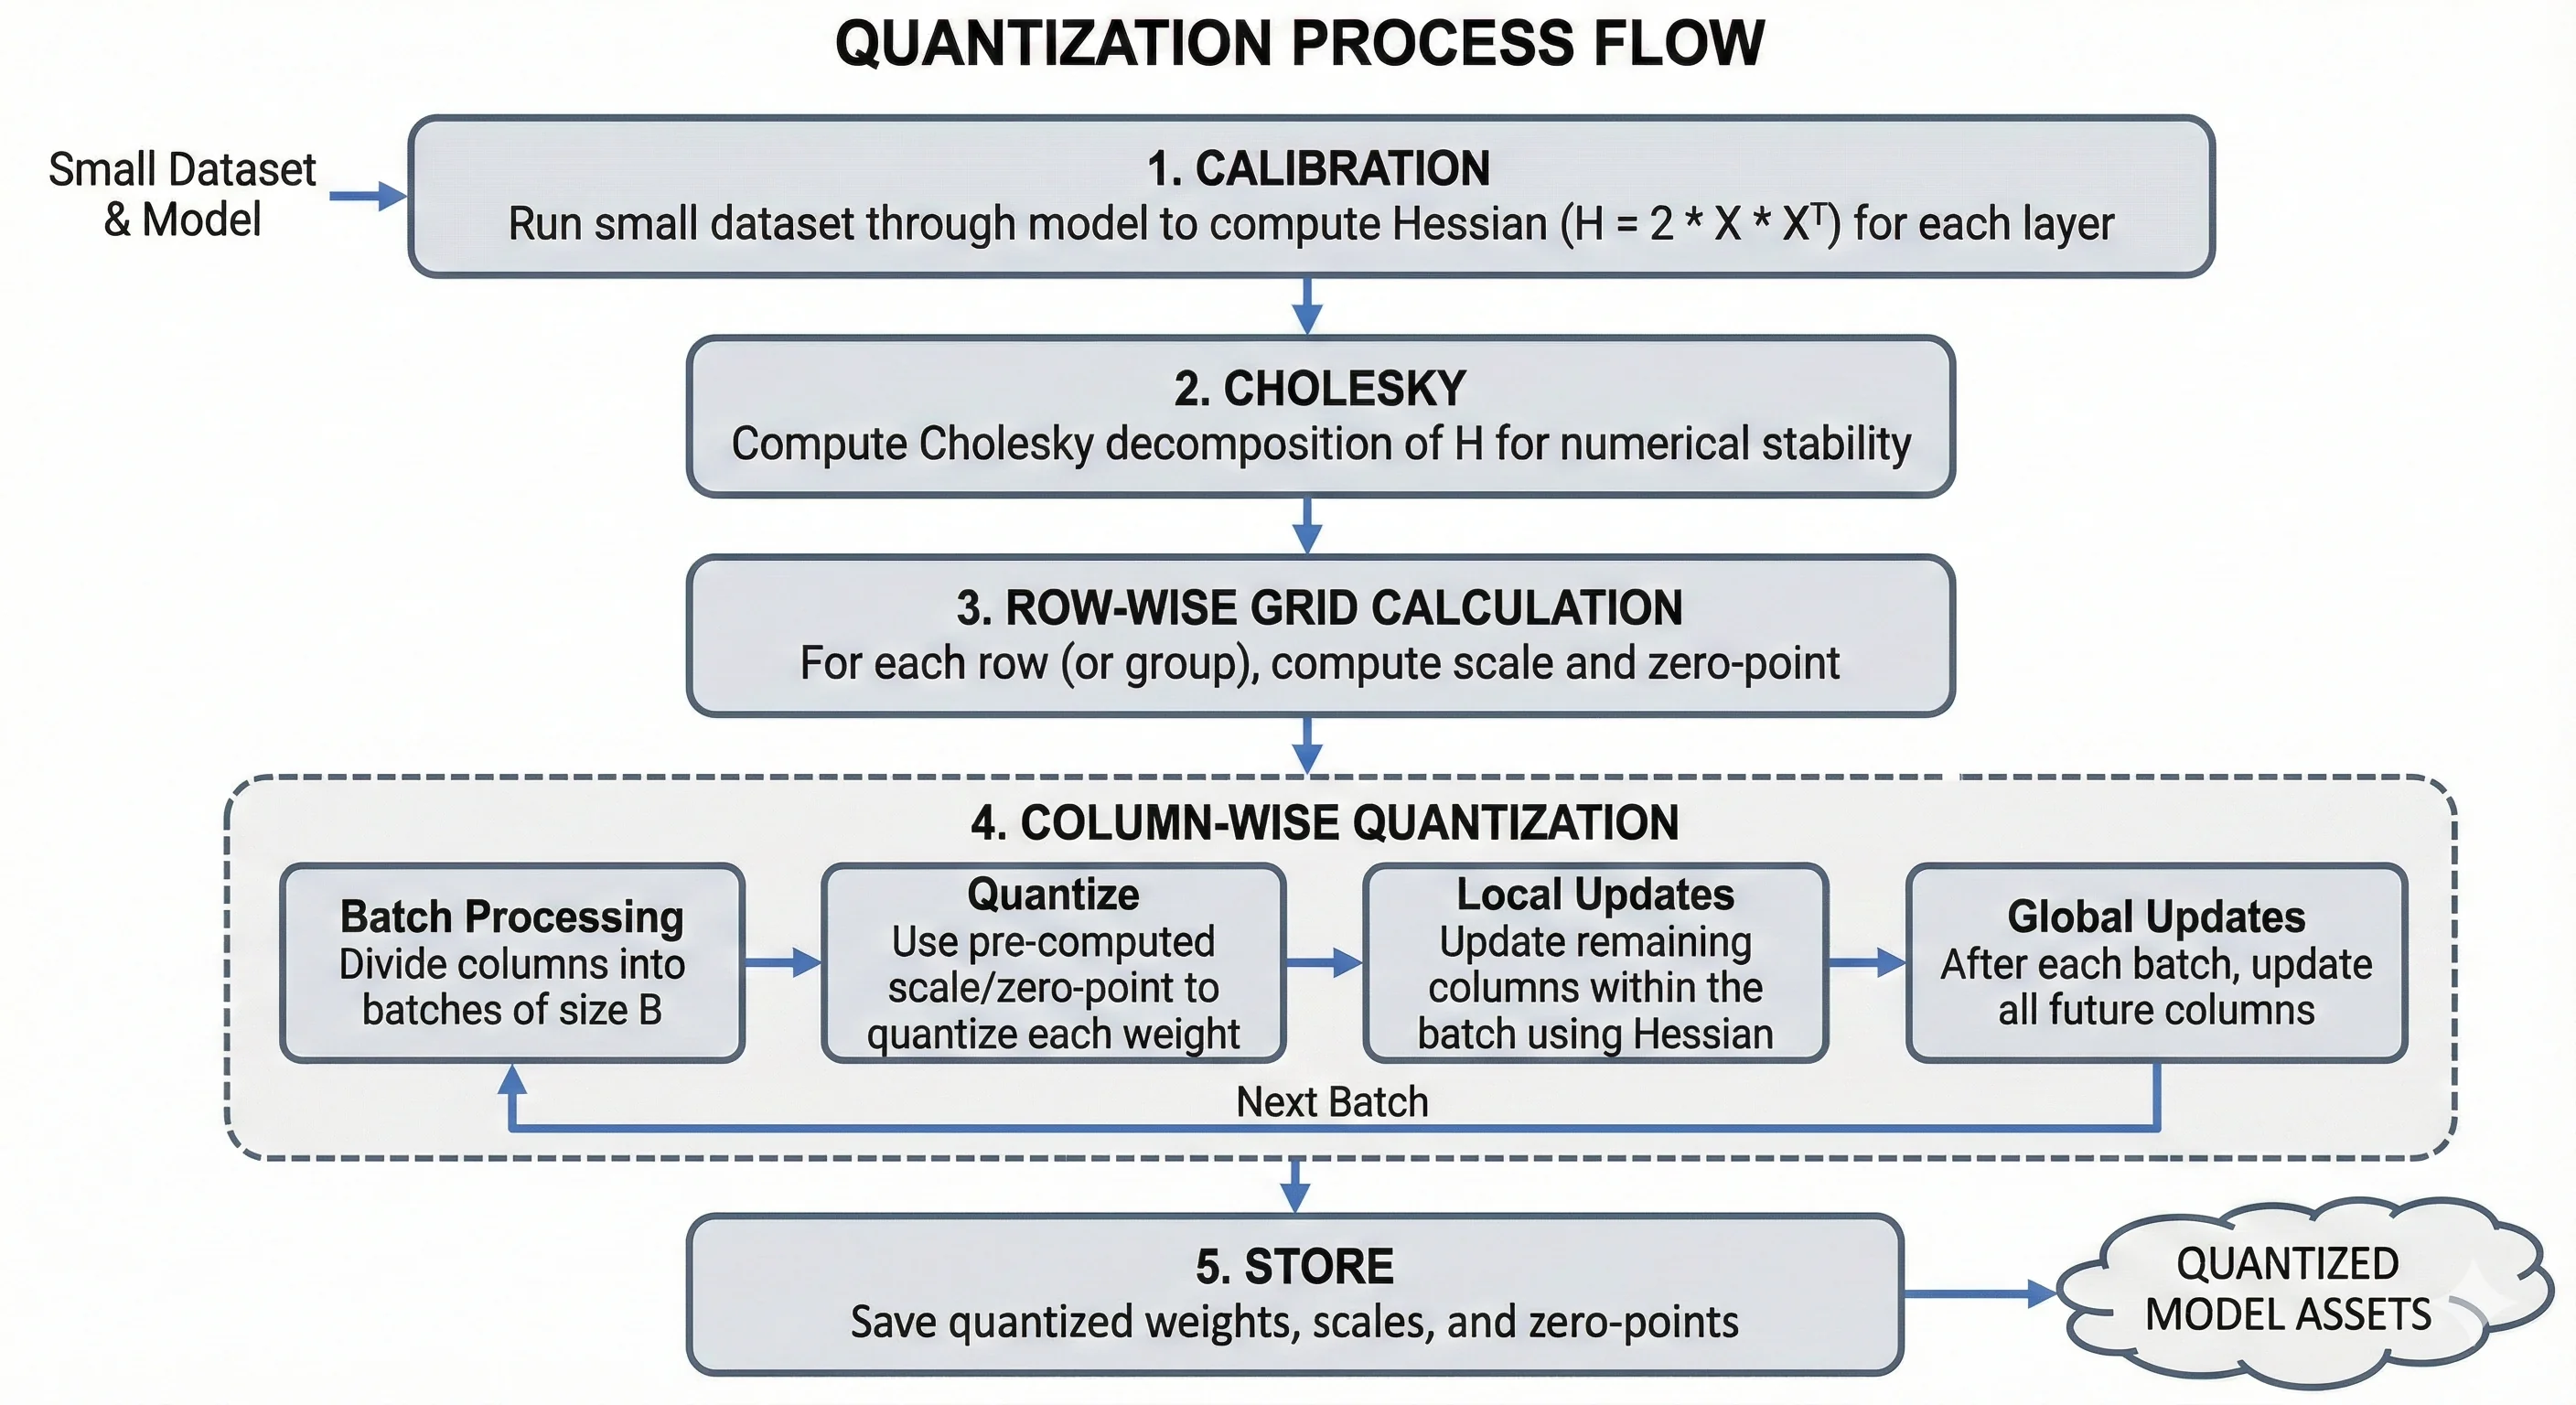
The Complete Guide to LLM Quantization with vLLM: Benchmarks & Best ...

[论文评述] LLMC: Benchmarking Large Language Model Quantization with a ...

Rethinking Residual Errors in Compensation-based LLM Quantization

The Great AI Compression: How LLM Quantization Solves the VRAM Bottleneck
Advertisement Space (336x280)
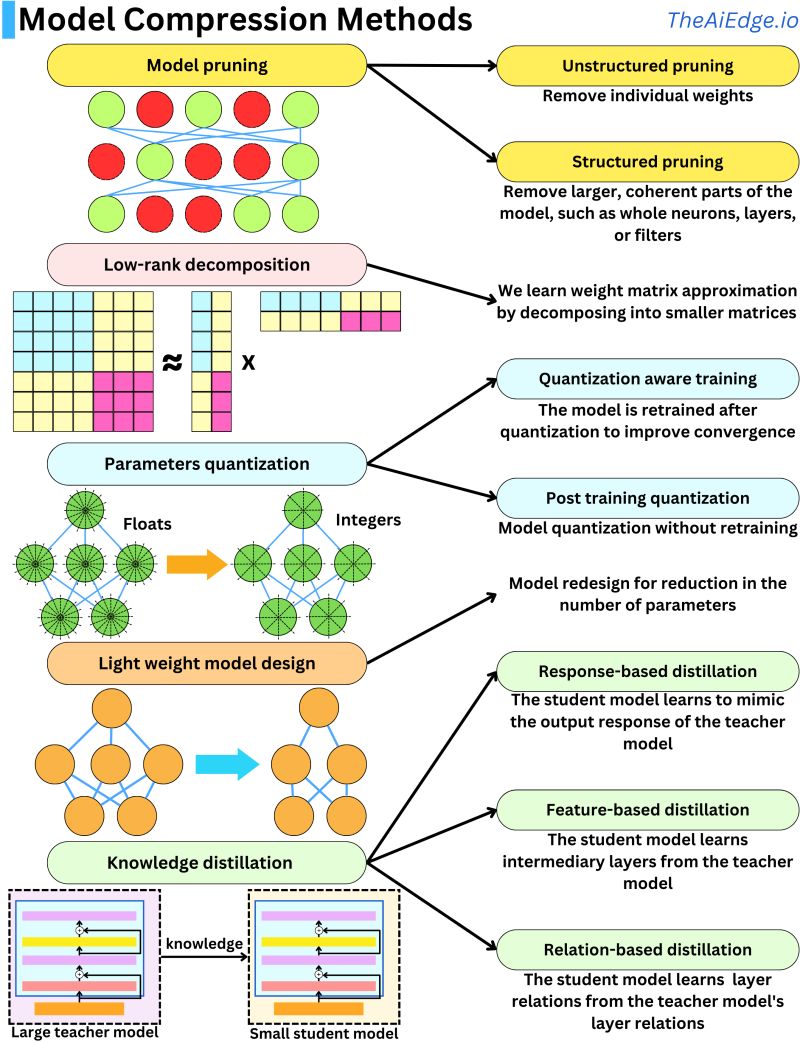
Vinija's Notes • Primers • Model Compression using Inference/Training ...

The Ultimate Handbook for LLM Quantization | Towards Data Science

AI Model Quantization Showdown: GPTQ vs GGML - DigiAlps LTD
Quantizing Models with Activation-Aware Quantization (AWQ) - LLM ...

LLM Quantization Techniques. GGUF GPTQ AWQ BitNet | by joydeep ...

LLM Quantization Methods: GPTQ, AWQ, GGUF - Cast AI
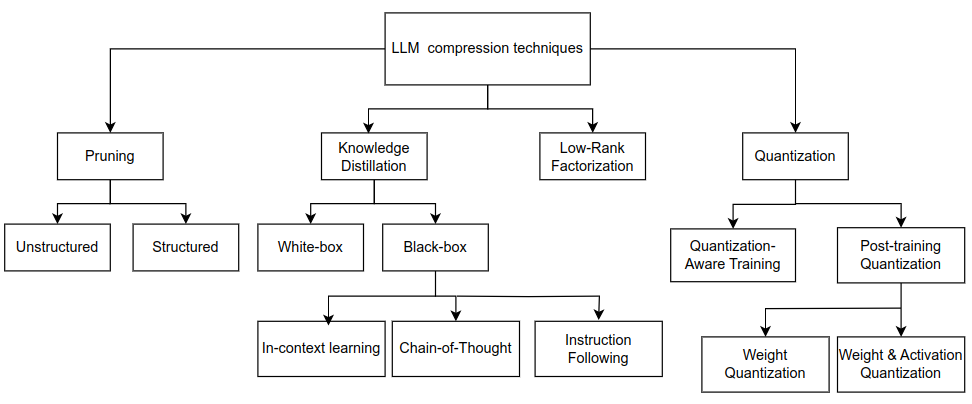
LLM Compression Techniques to Build Faster and Cheaper LLMs
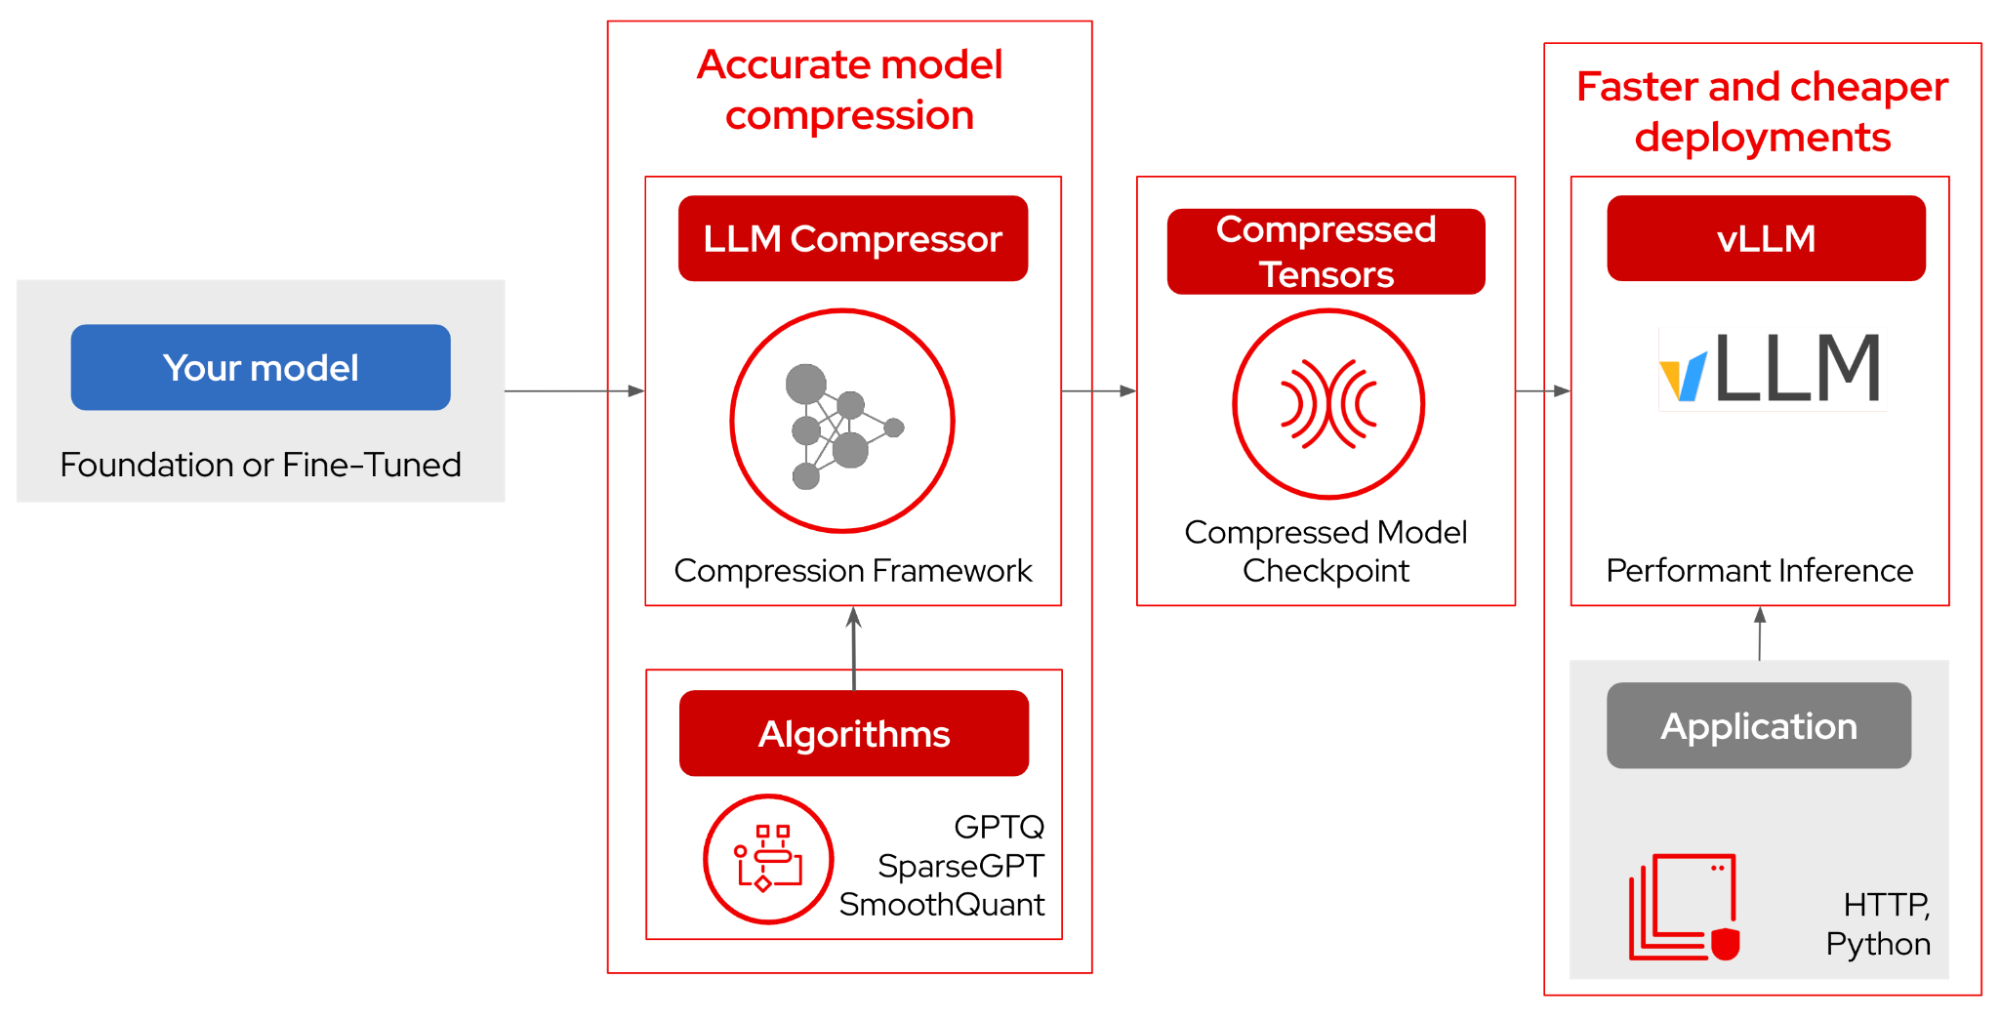
LLM compression and optimization: Cheaper inference with fewer hardware ...
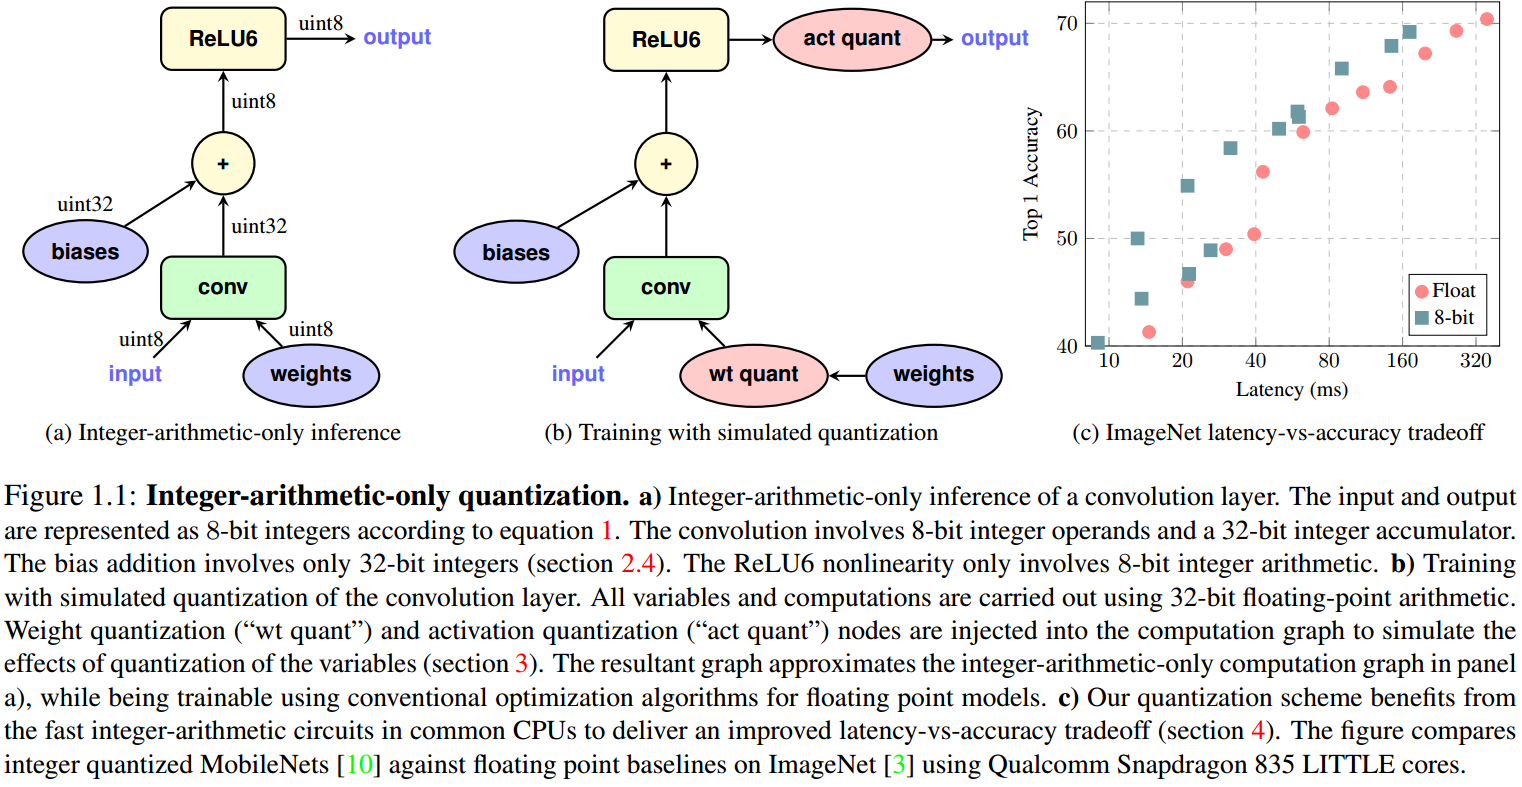
Model Compression - 'Quantization' | LeijieZhang
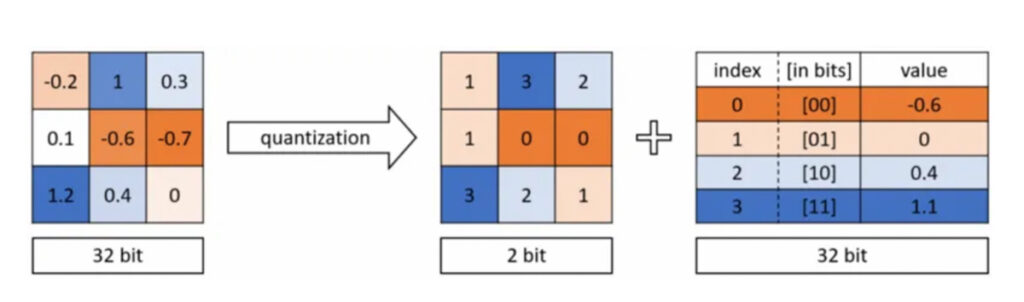
4 Popular Model Compression Techniques Explained | Xailient
Advertisement Space (336x280)
GitHub - ijhan21/custom-AutoGPTQ: An easy-to-use LLMs quantization ...
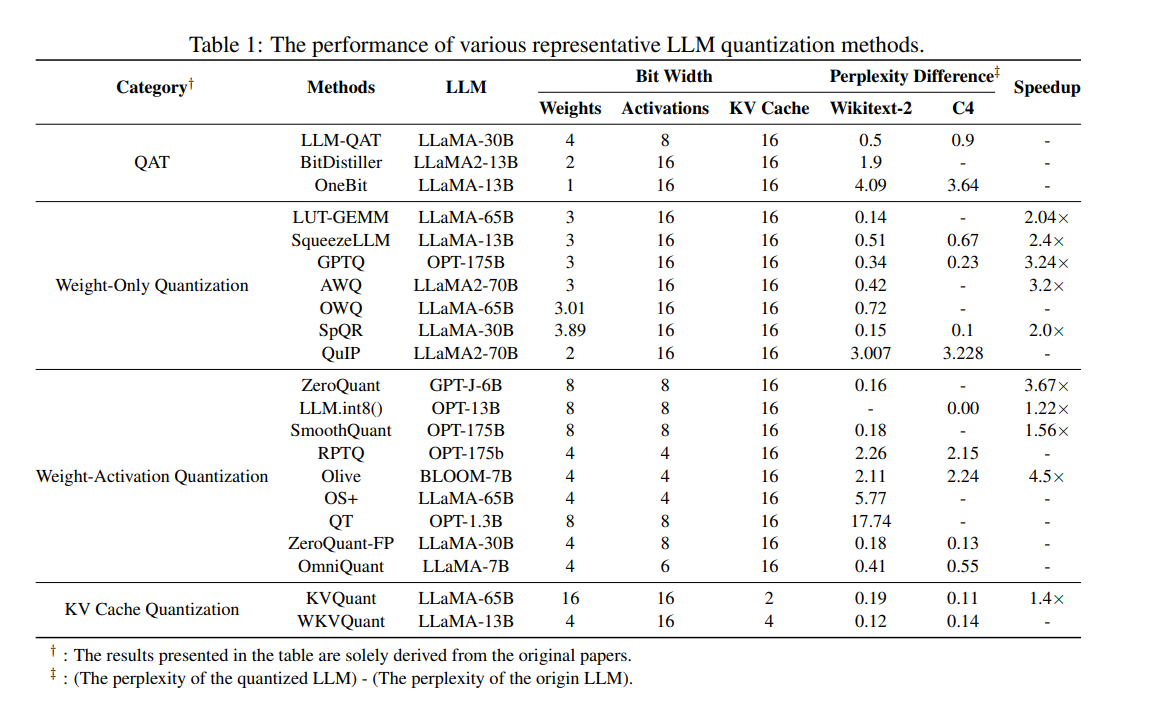
LLM Compression Techniques to Build Faster and Cheaper LLMs

Model Compression for Deep Neural Networks: A Survey
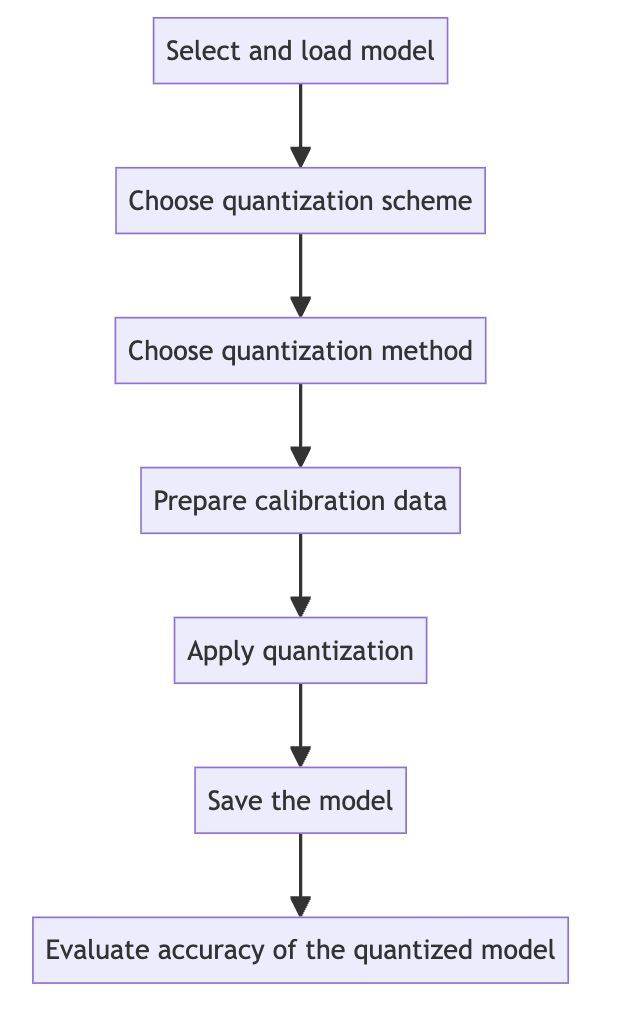
Model optimization :: LLM optimization and inference leveraging

Learnable Cloud-Guided LLM Quantization for Resource-Constrained Edge ...
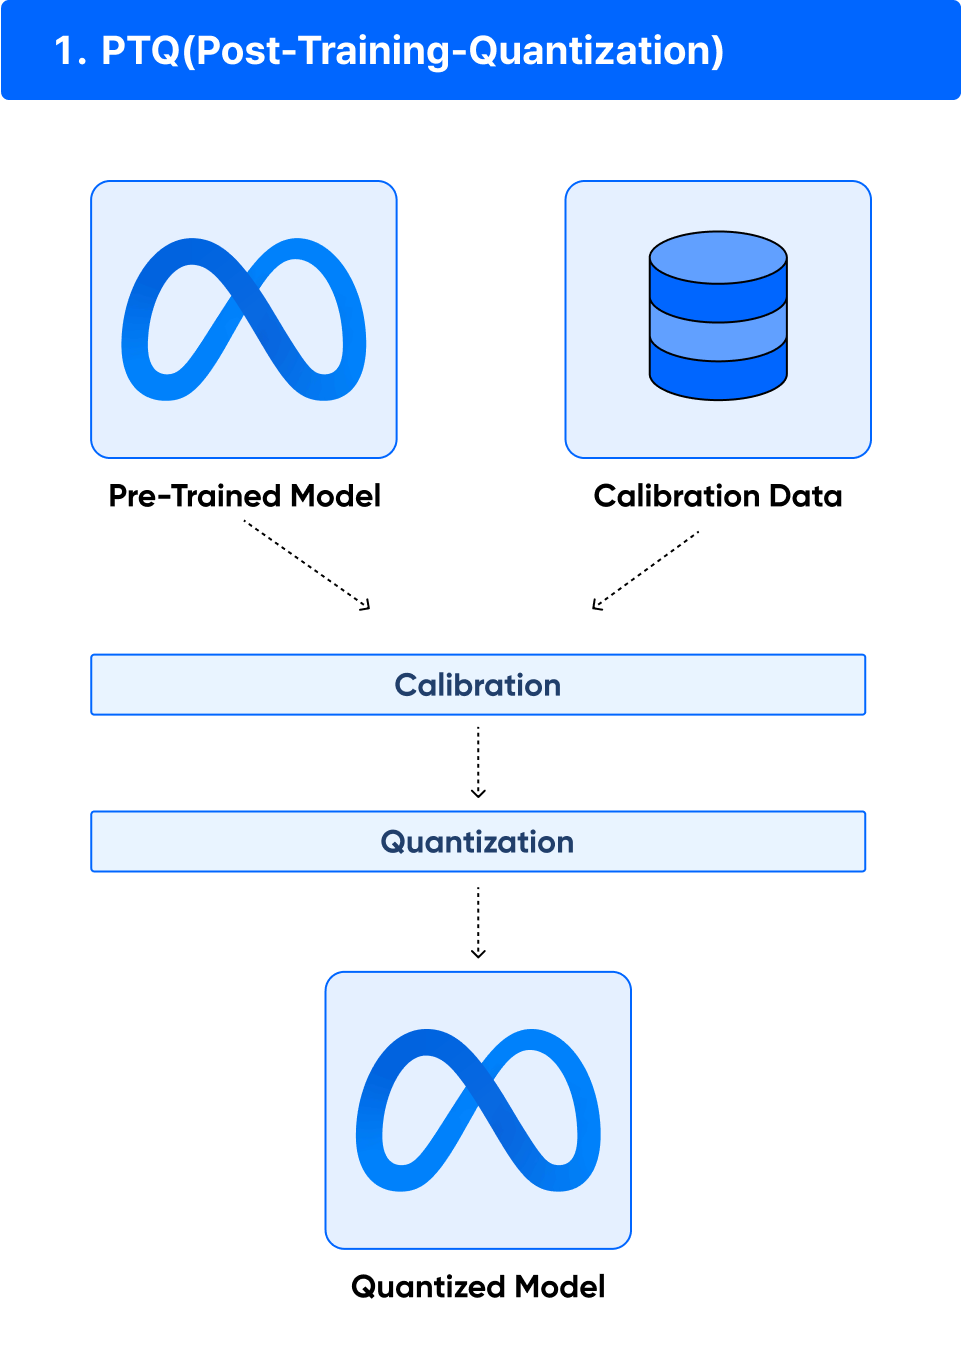
LLM 모델 파인튜닝을 위한 Quantization | 패스트캠퍼스