
How Kv Caching Works In Large Language Models Matterai Blog
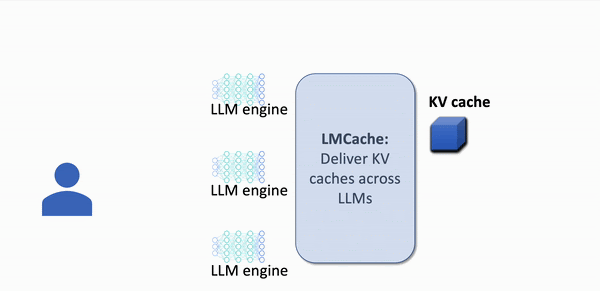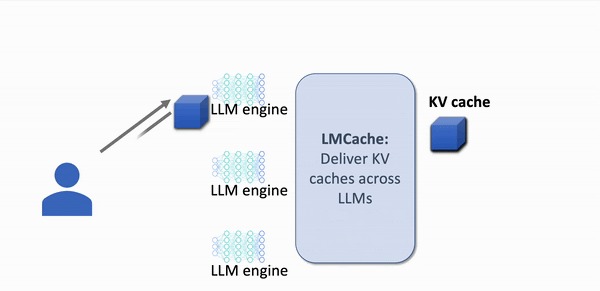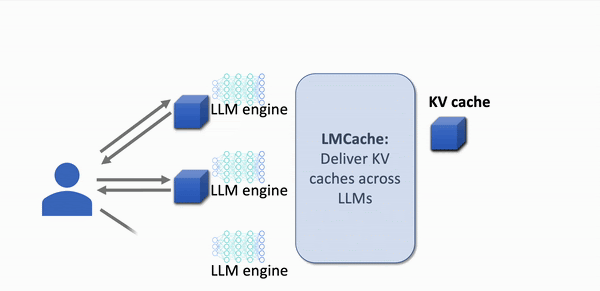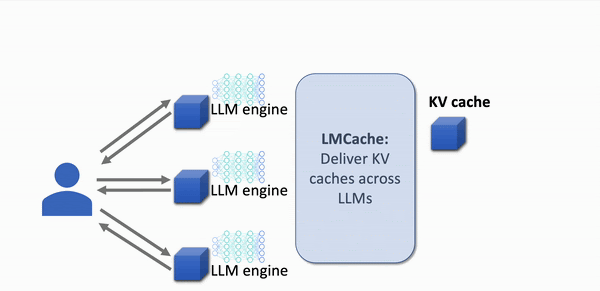
How KV Caching Works in Large Language Models | MatterAI Blog
How KV Caching Works in Large Language Models | MatterAI Blog

How KV Caching Works in Large Language Models | MatterAI Blog
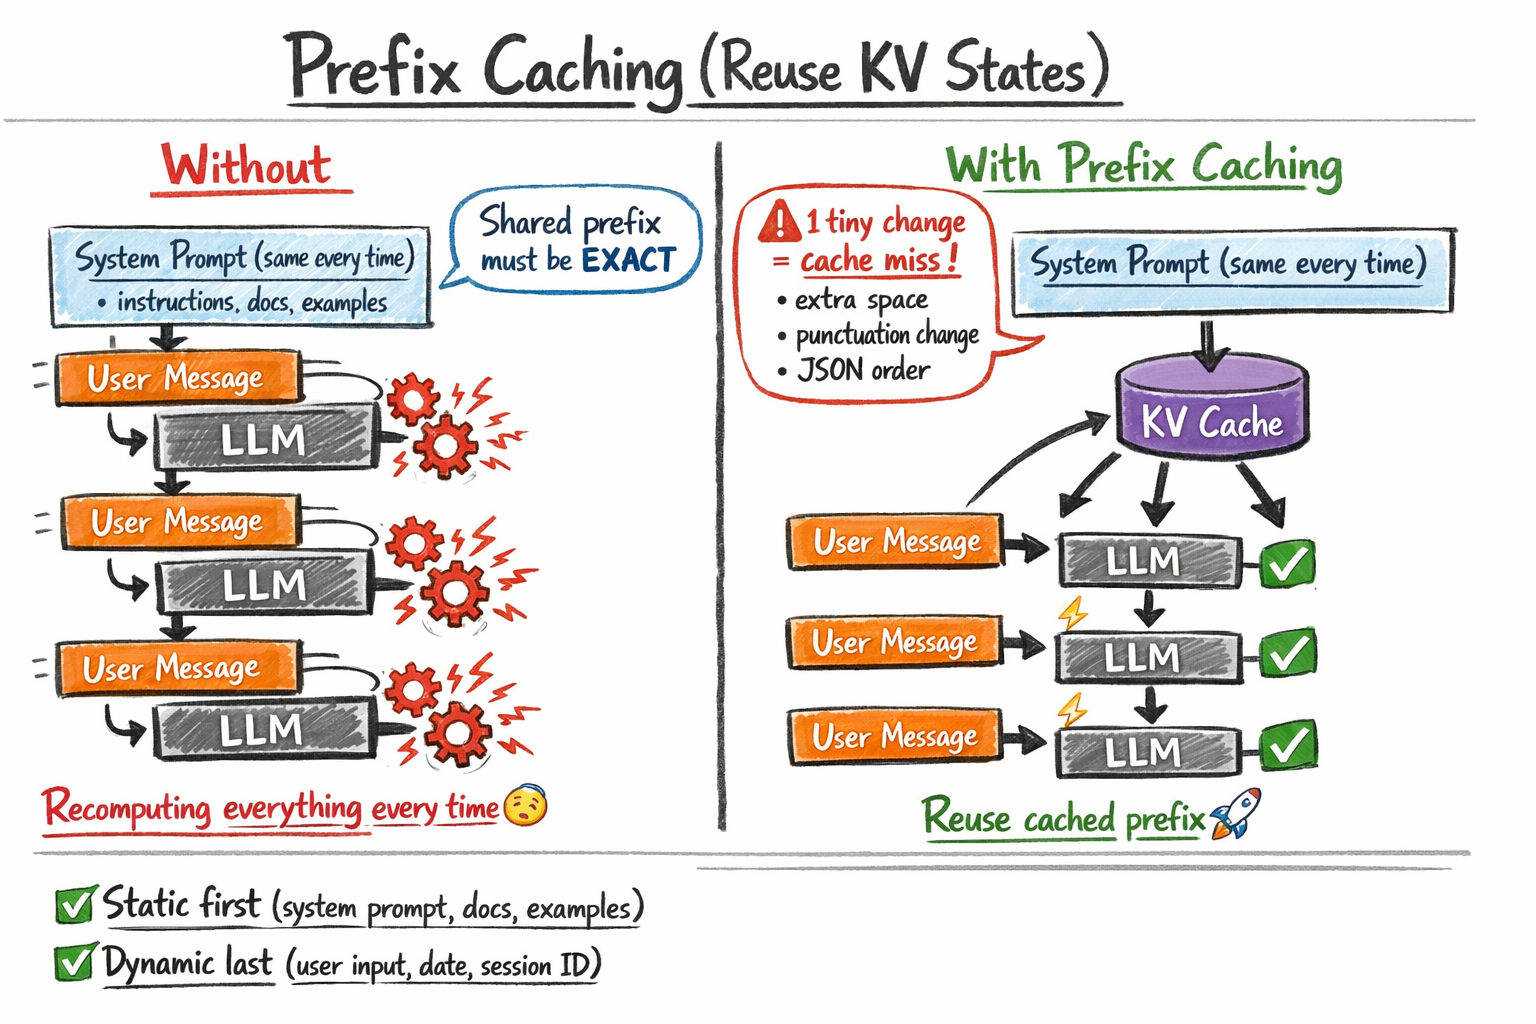
The Complete Guide to Inference Caching in Large Language Models
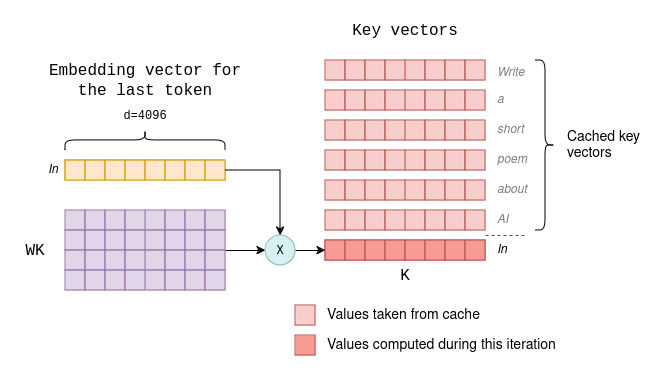
Techniques for KV Cache Optimization in Large Language Models
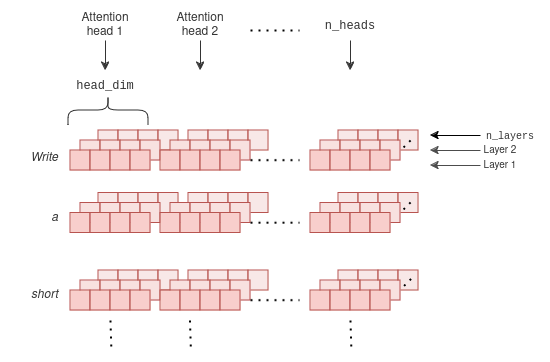
Techniques for KV Cache Optimization in Large Language Models
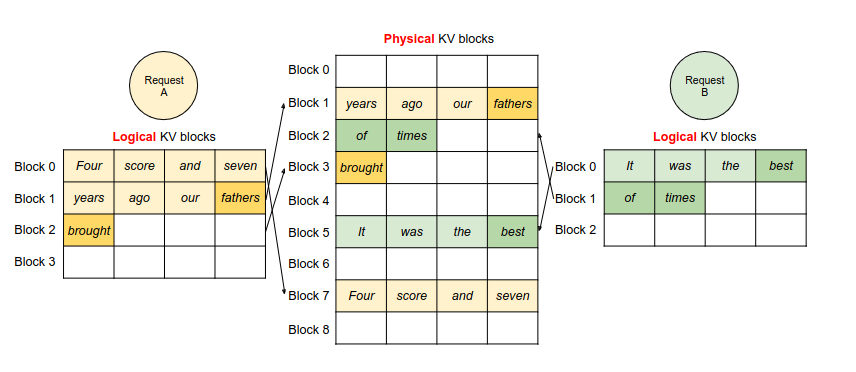
Techniques for KV Cache Optimization in Large Language Models
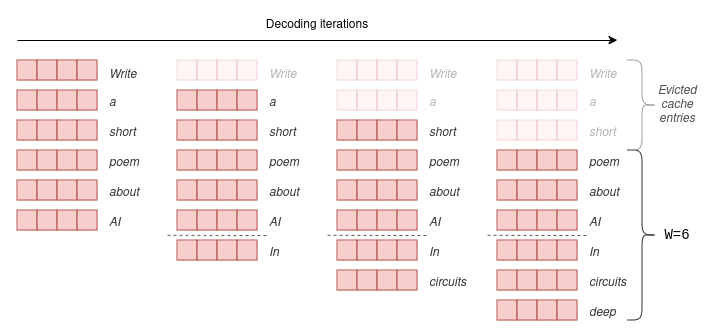
Techniques for KV Cache Optimization in Large Language Models

🚀 Boosting Large Language Models with KV Caching 🚀
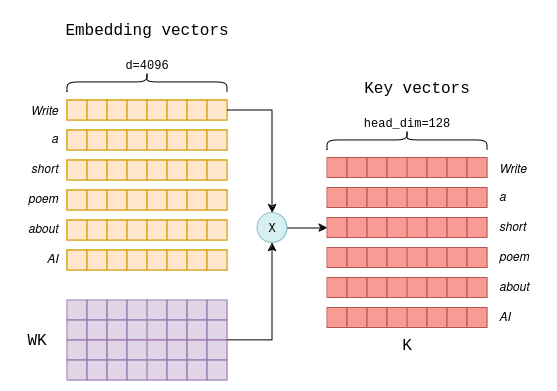
Techniques for KV Cache Optimization in Large Language Models
Advertisement Space (300x250)

[論文レビュー] KVLink: Accelerating Large Language Models via Efficient KV ...

KV Cache Demystified: Speeding Up Large Language Models - YouTube

Mechanics of context windows, memory limits, and KV caching in Large ...
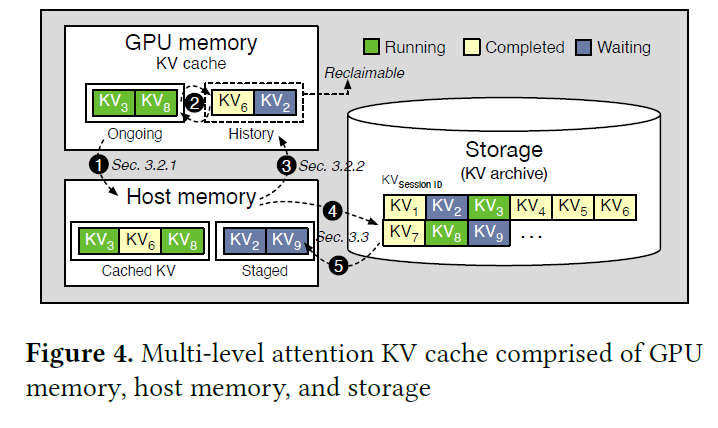
How KV Cache Works & Why It Eats Memory | by M | Foundation Models Deep ...

A Generative Caching System for Large Language Models | AI Research ...

KV Cache in Large Language Models: Design, Optimization, and Inference ...
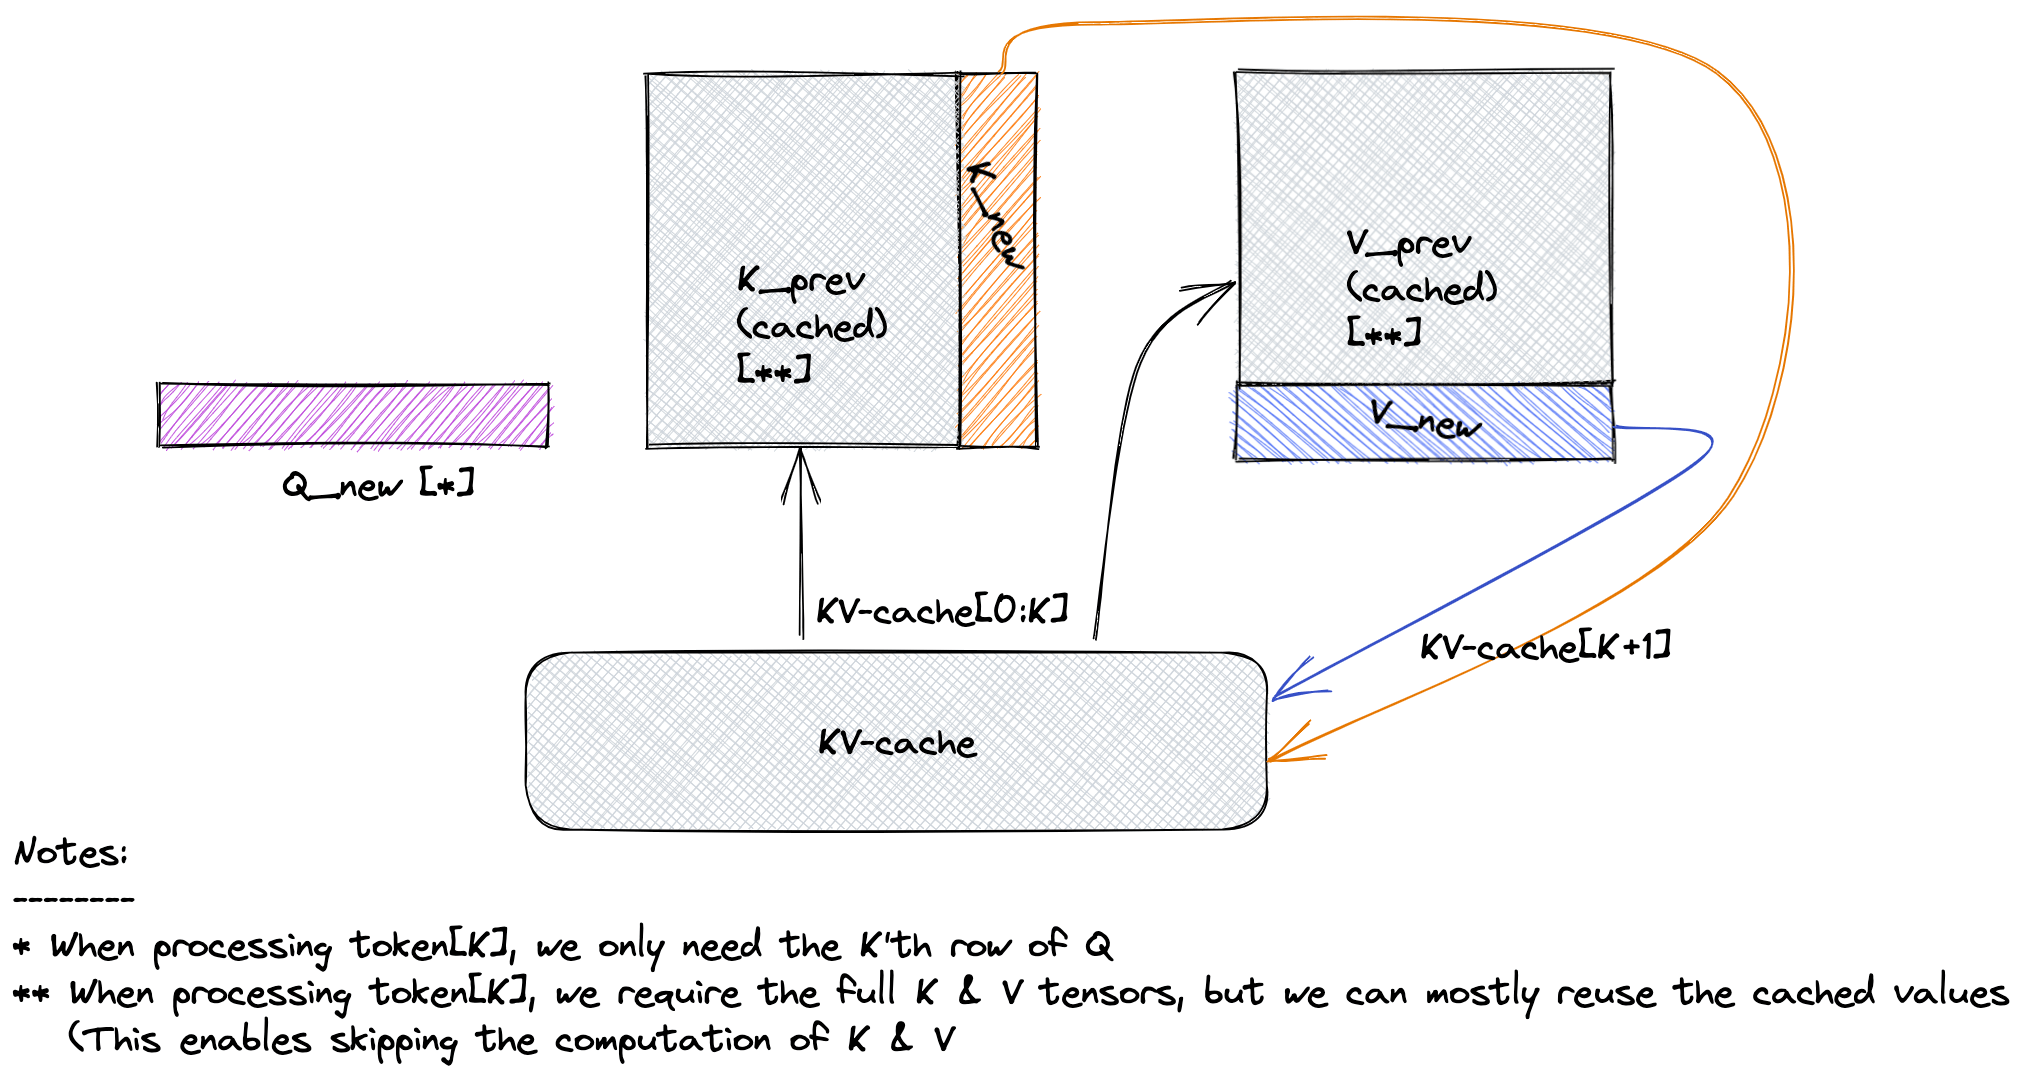
KV Cache in Transformer Models - Data Magic AI Blog

Empowering Large Language Models (LLMs) with KV Cache: A Deep Dive into ...
KV Cache in Transformer Models - Data Magic AI Blog
KV Cache in Transformer Models - Data Magic AI Blog
Advertisement Space (336x280)

A Method for Building Large Language Models with Predefined KV Cache ...
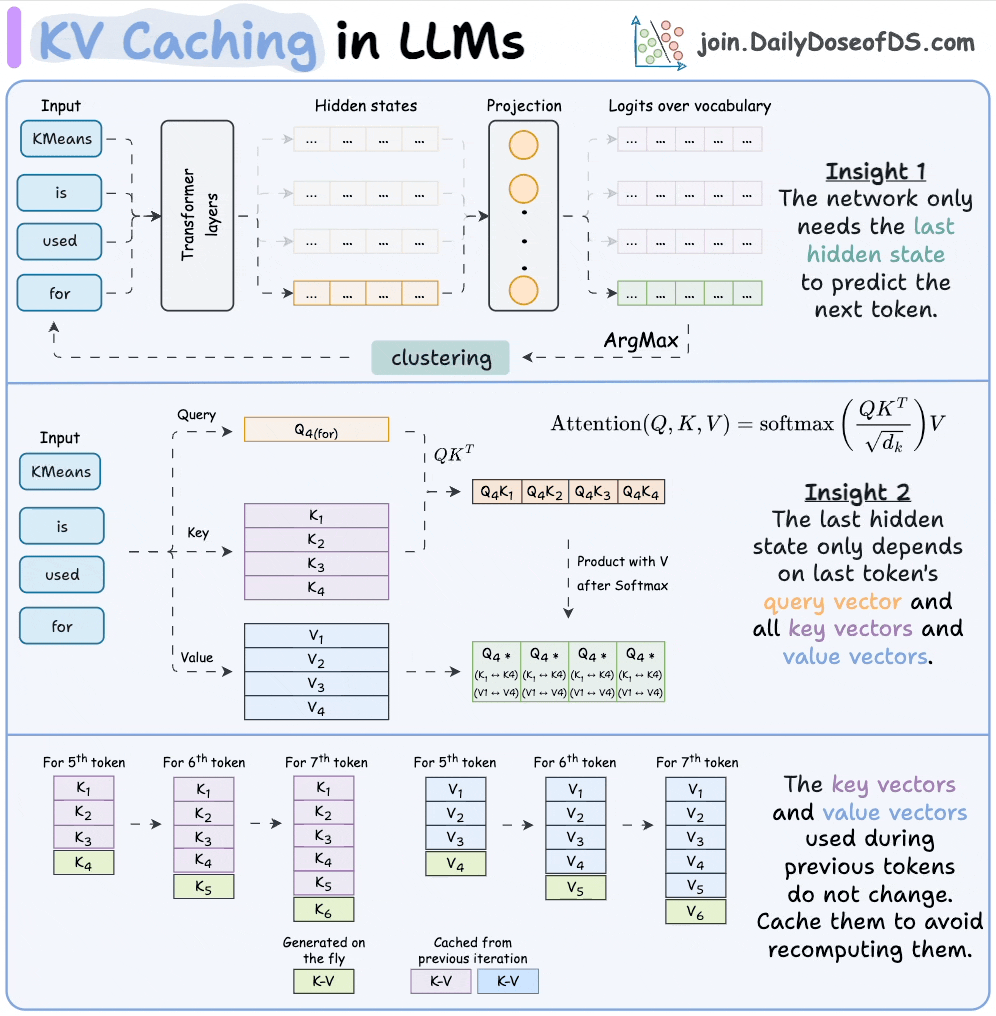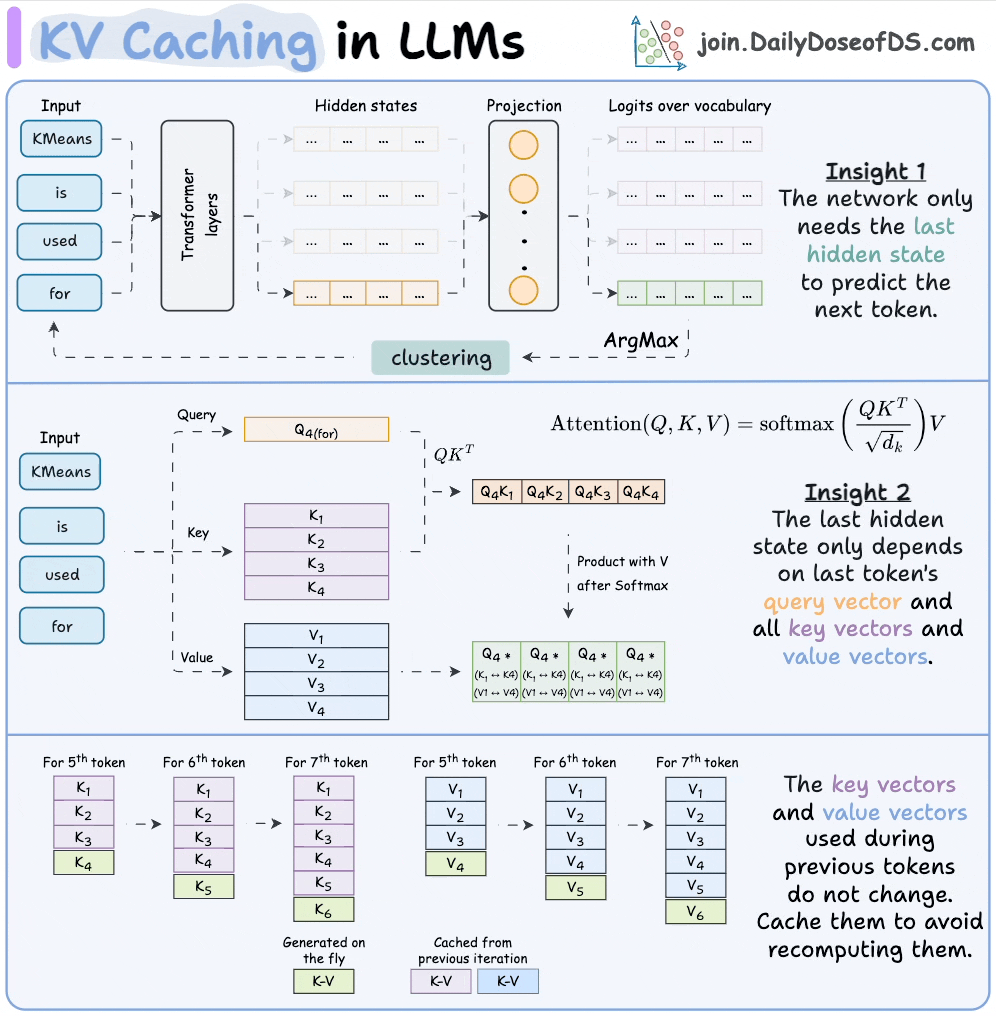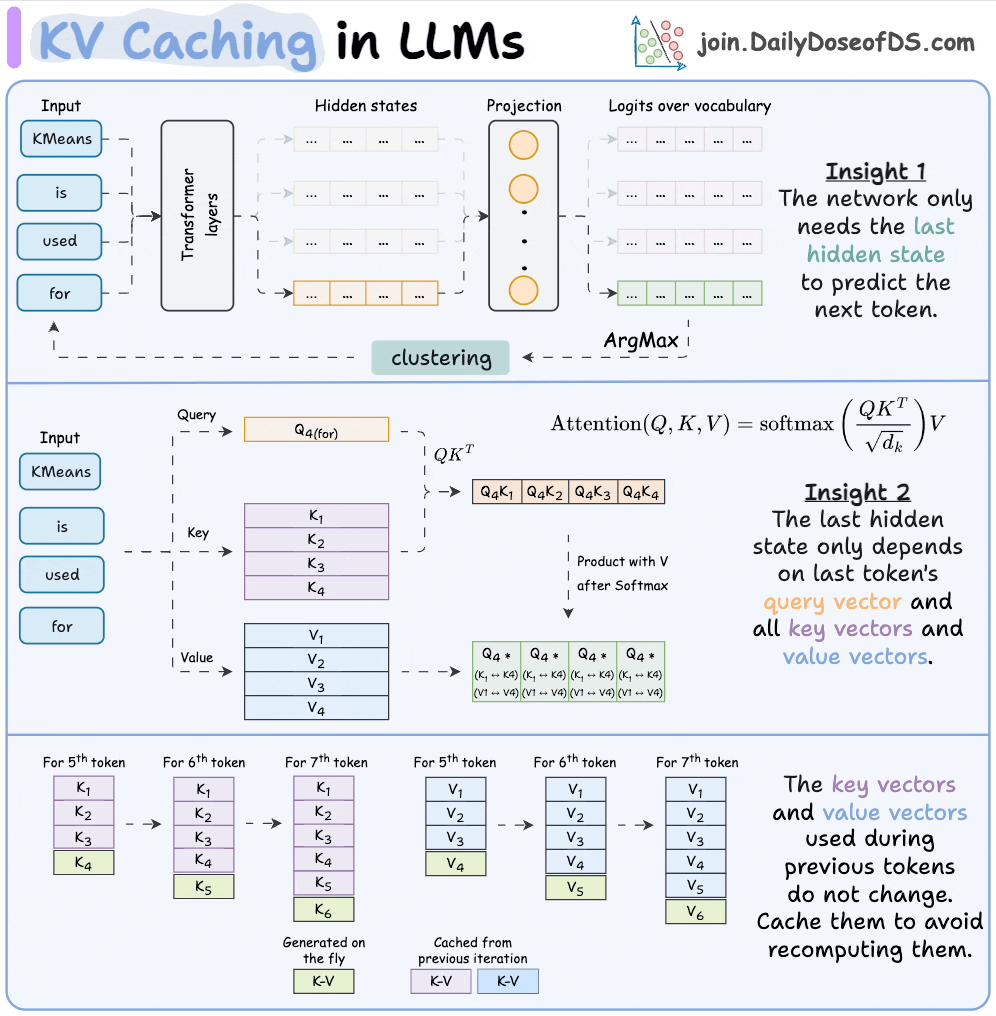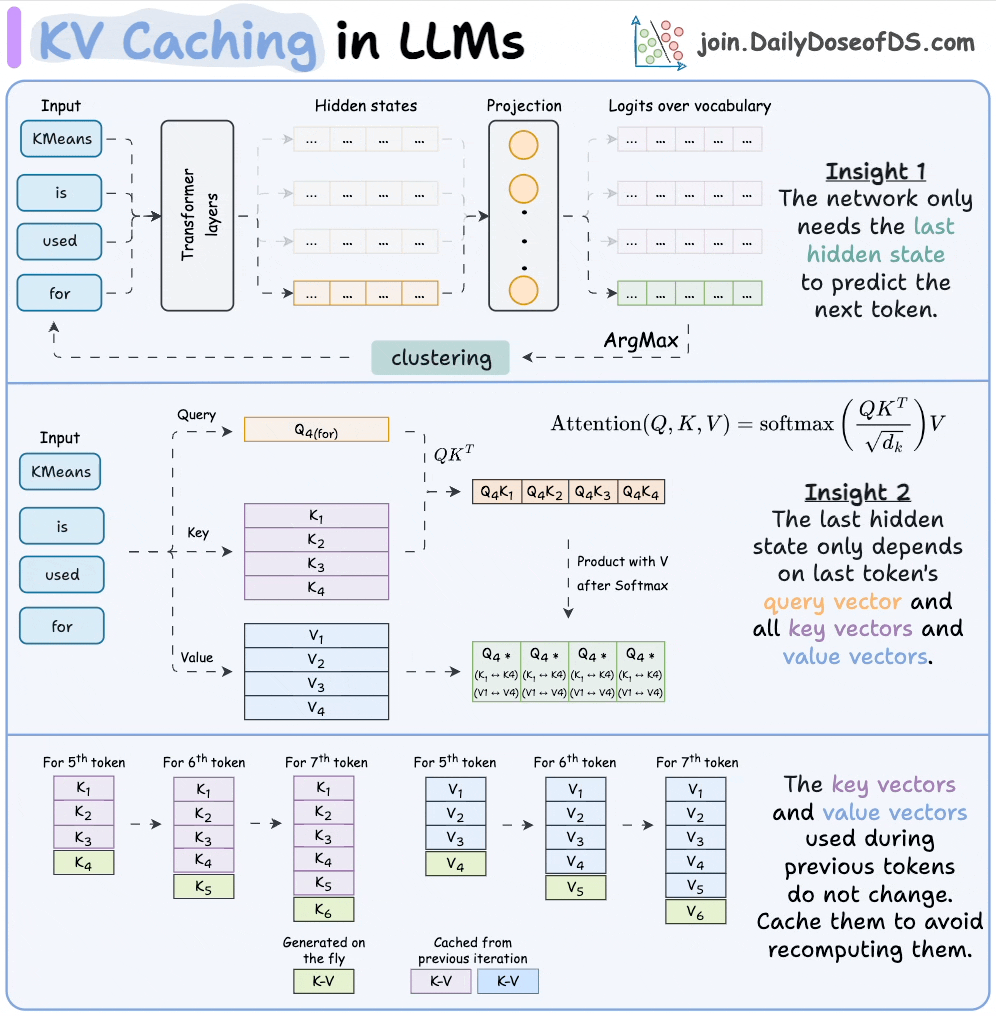
KV Caching in LLMs, explained visually

If you are deploying large language models and trying to optimize for ...

Optimizing Large Language Models: KV Cache, Quantization, and Batching ...
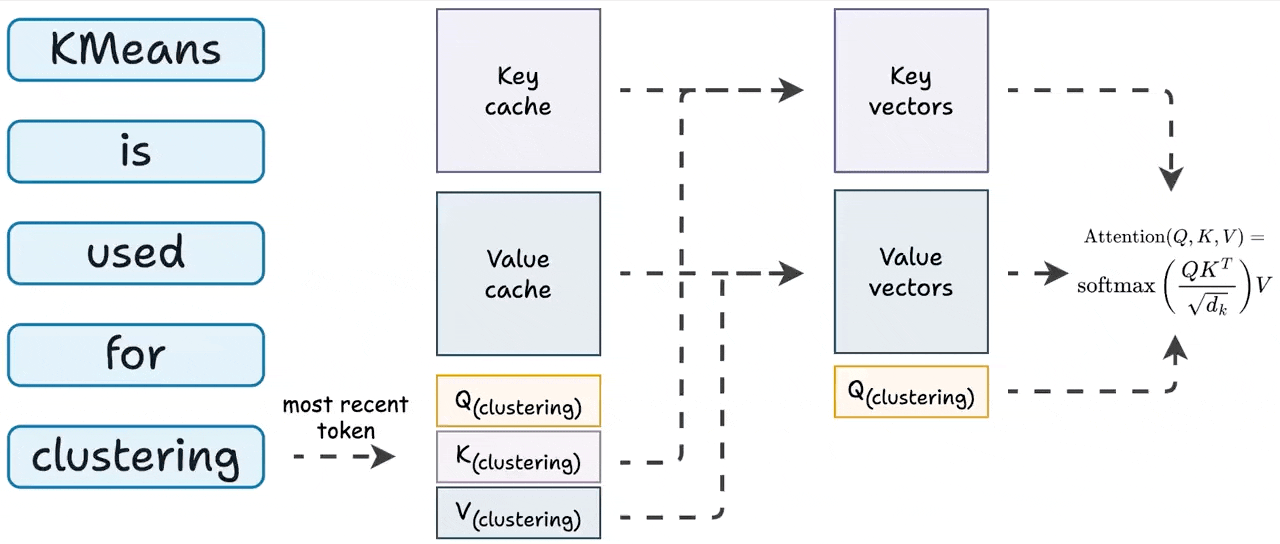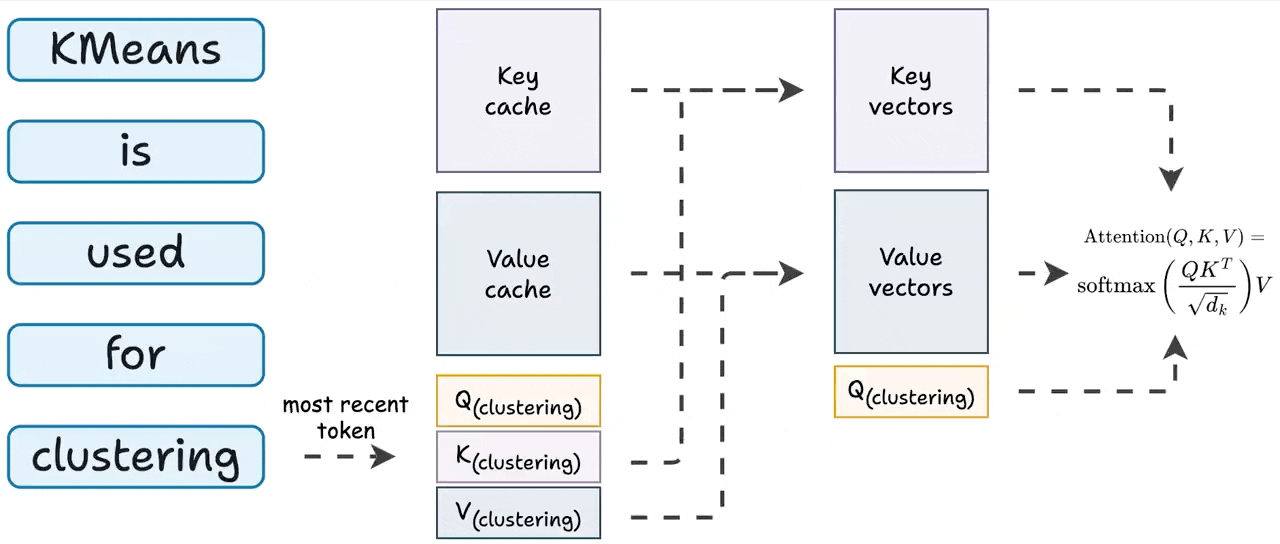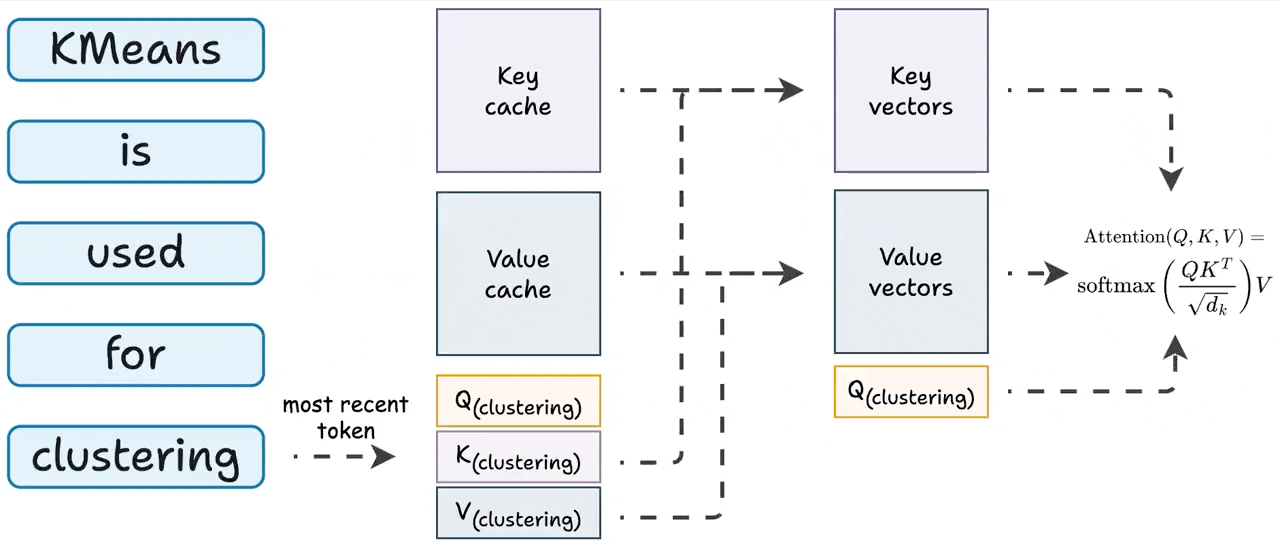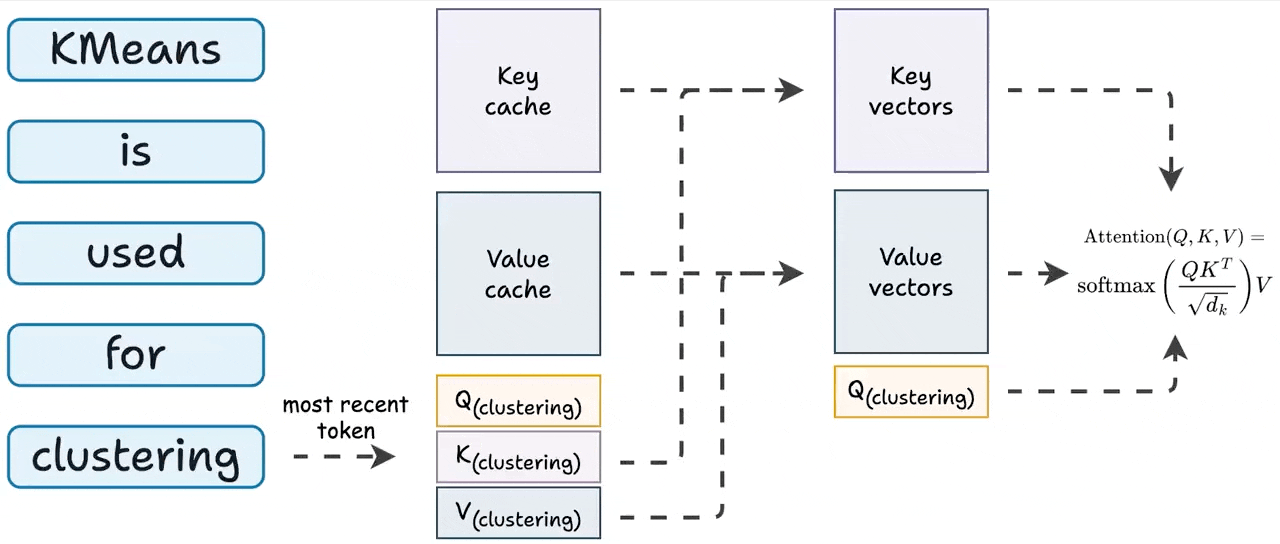
KV Caching in LLMs, Explained Visually. - by Avi Chawla
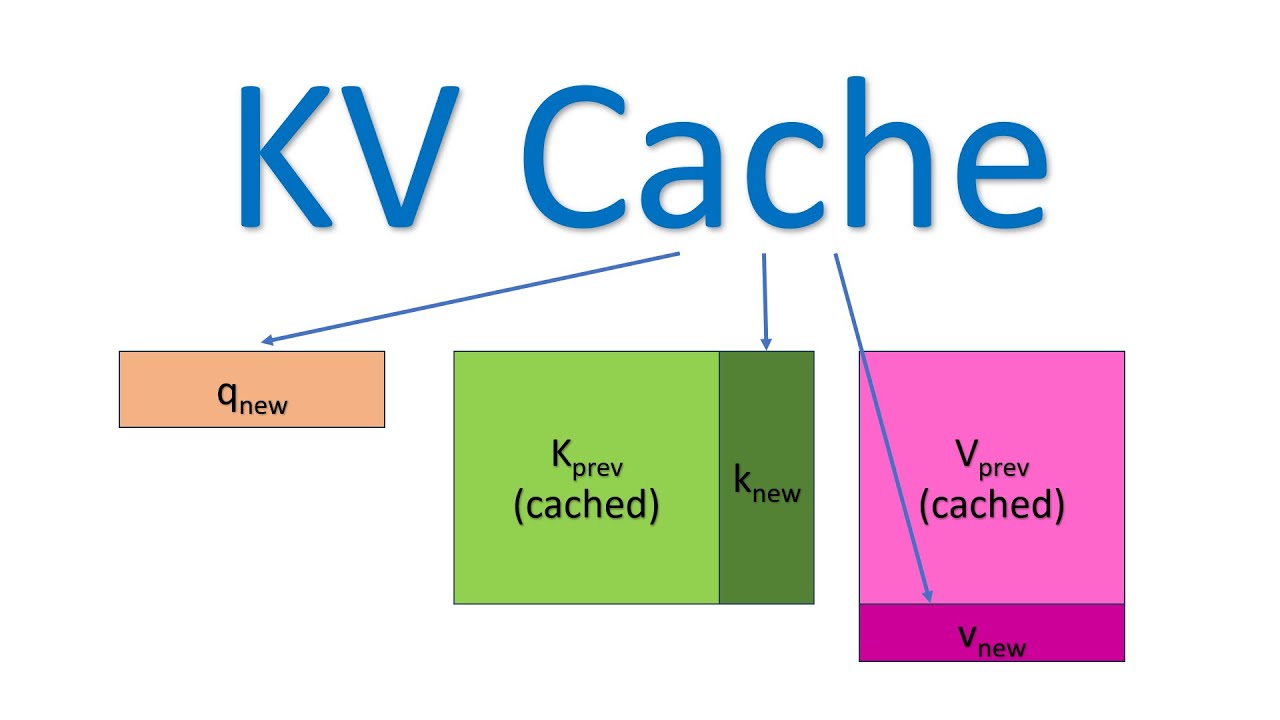
GPU memory requirements for serving Large Language Models | UnfoldAI

SimLayerKV: An Efficient Solution to KV Cache Challenges in Large ...
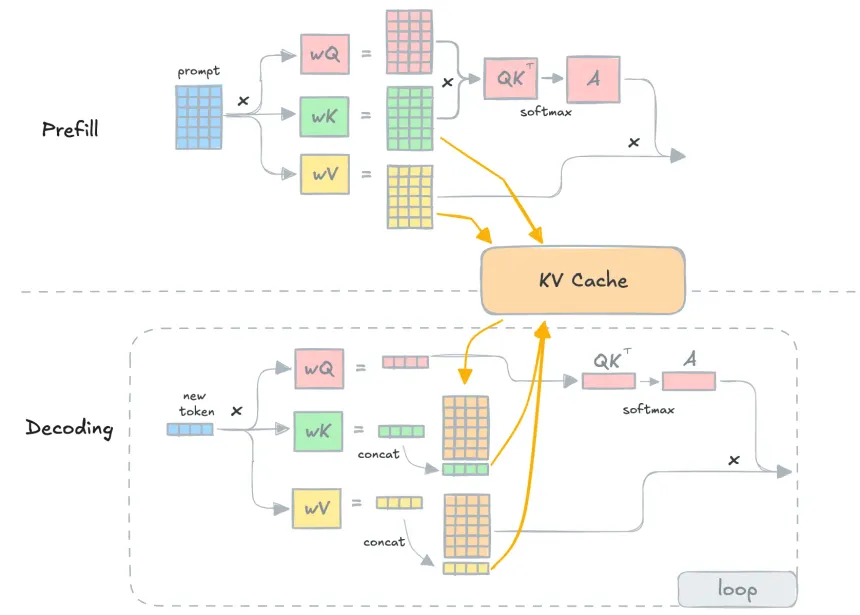
How KV Caching Makes Modern LLMs Fast?

KV Caching in LLMs, Explained Visually. - by Avi Chawla
A Survey on Large Language Model Acceleration based on KV Cache ...
Advertisement Space (336x280)

LayerKV: Optimizing Large Language Model Serving with Layer-wise KV ...

InfiniGen: Efficient Generative Inference of Large Language Models with ...
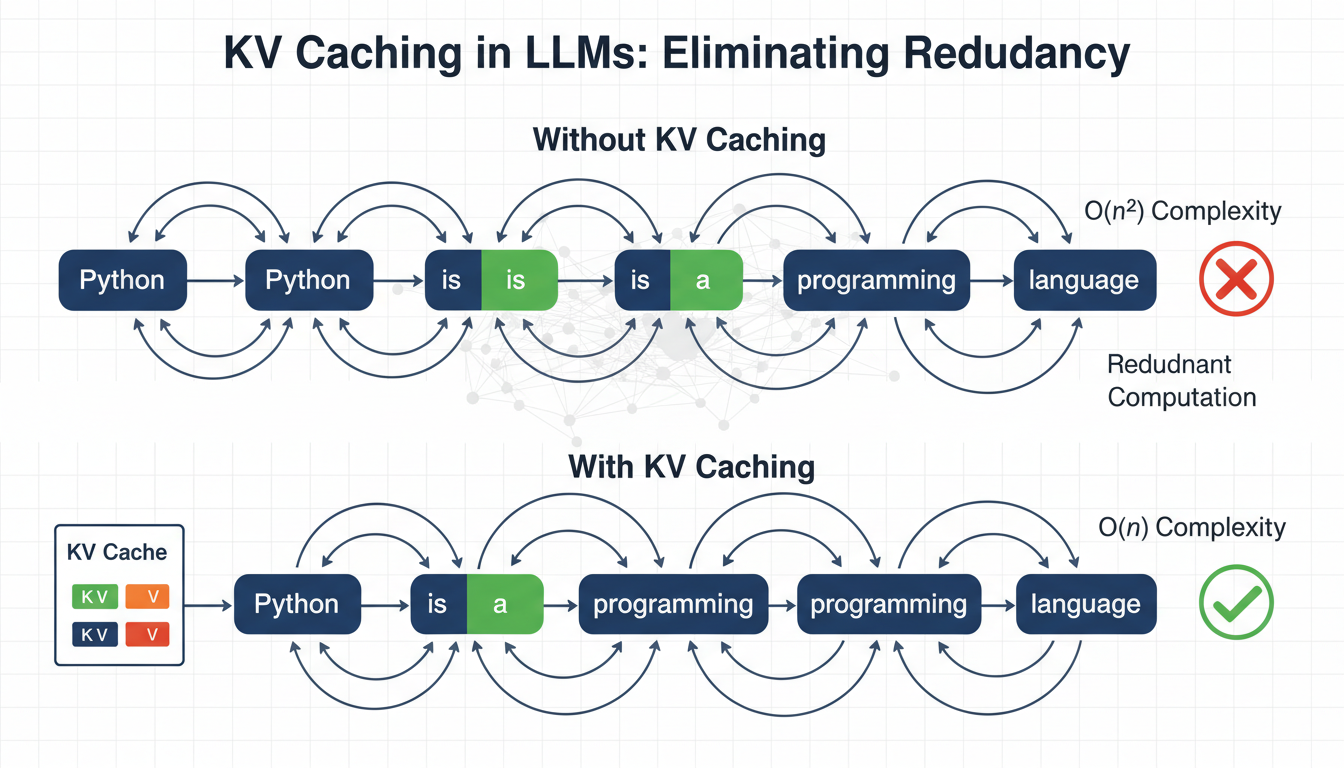
KV Caching in LLMs: A Guide for Developers - MachineLearningMastery.com
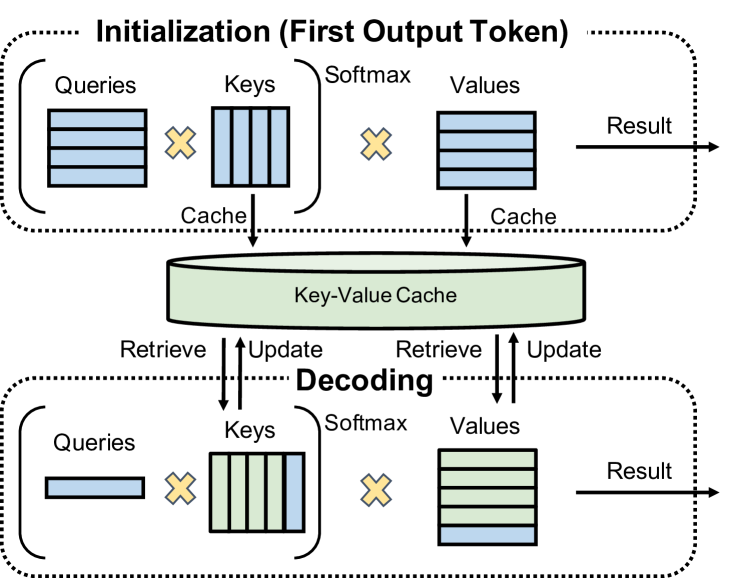
[2305.05920] Fast Distributed Inference Serving for Large Language Models
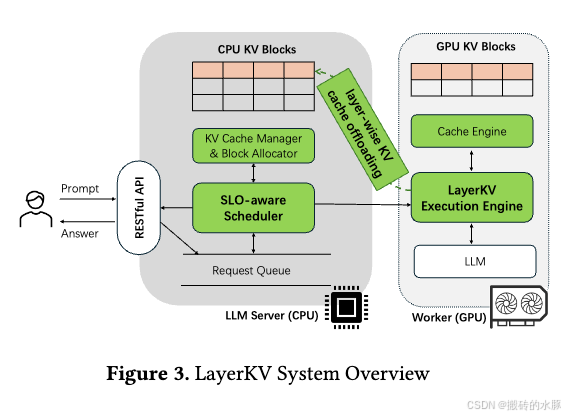
LayerKV: Optimizing Large Language Model Serving with Layer-wise KV ...
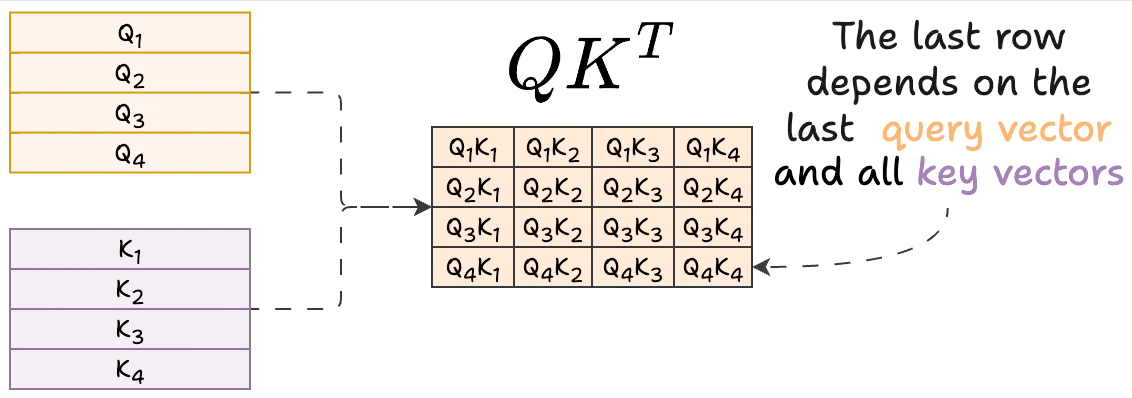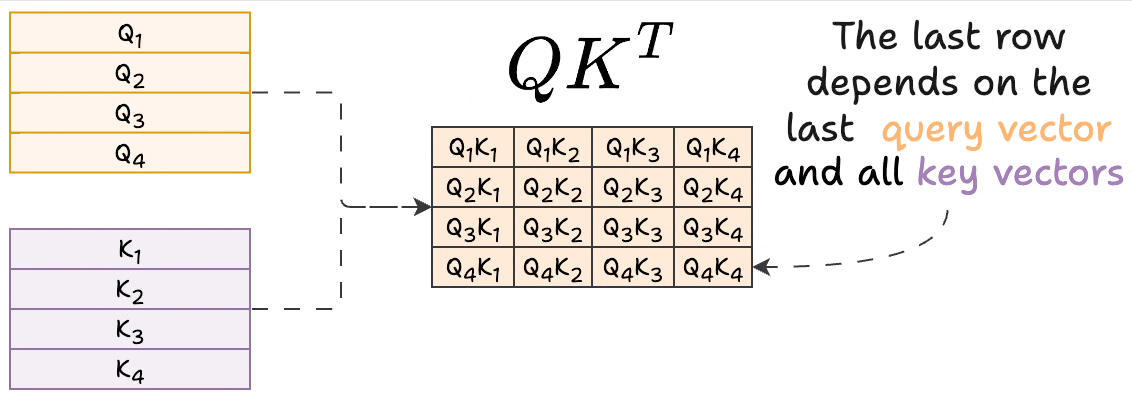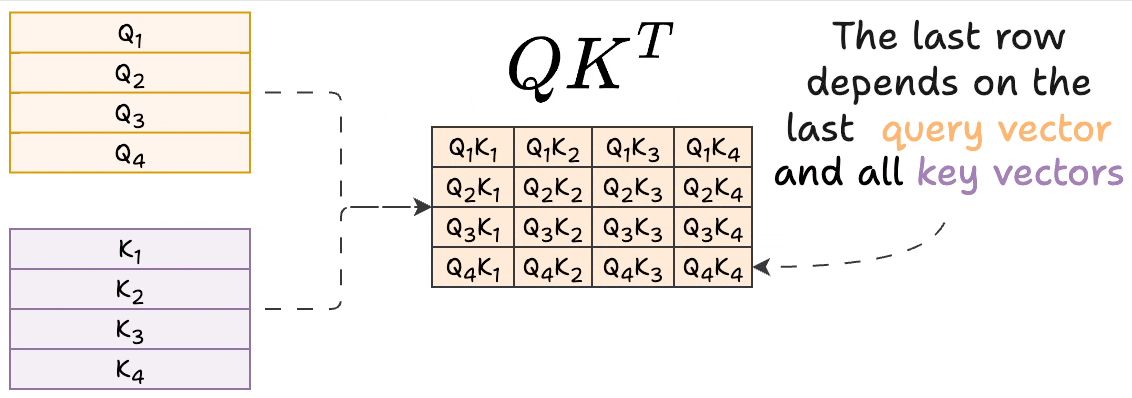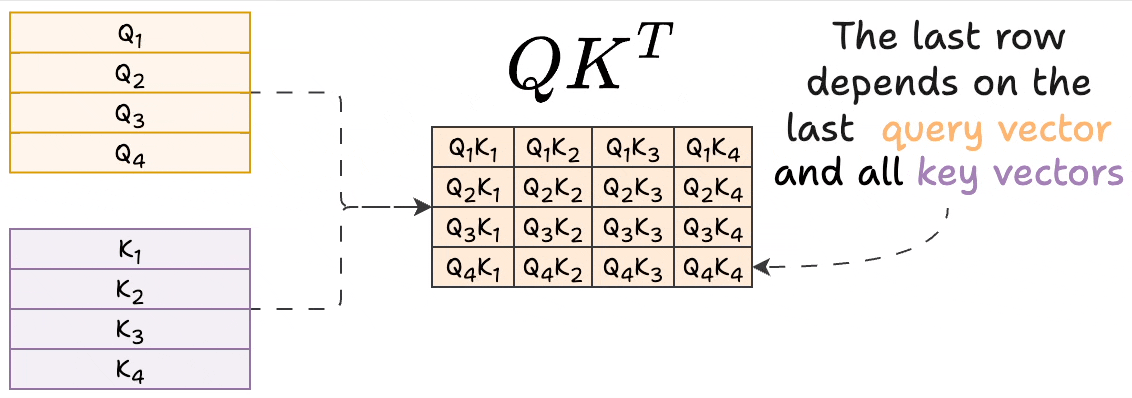
KV Caching in LLMs, Explained Visually. - by Avi Chawla