
Paper Page I Segmenter Integer Only Vision Transformer For Efficient

Paper page - I-Segmenter: Integer-Only Vision Transformer for Efficient ...

Paper page - I-ViT: Integer-only Quantization for Efficient Vision ...
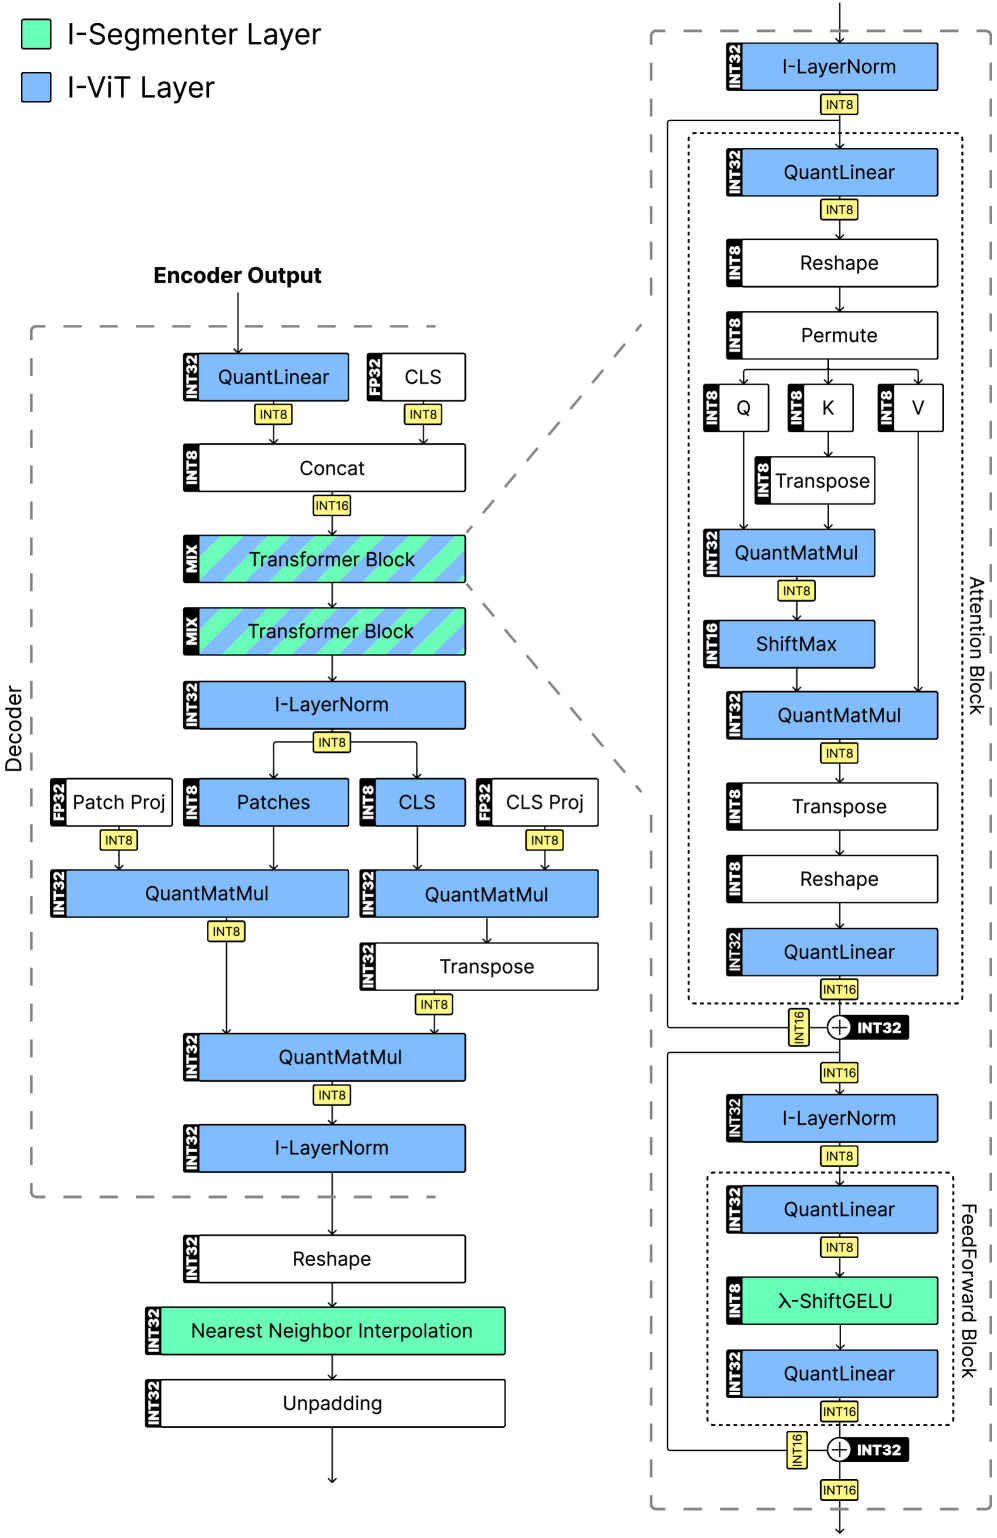
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
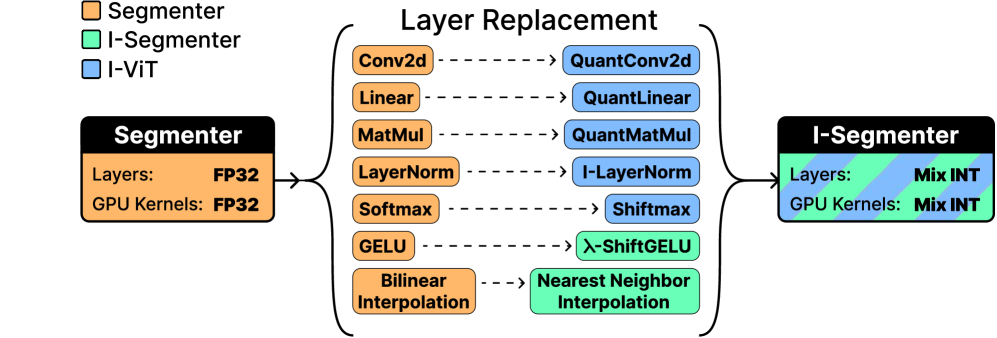
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...

(PDF) I-Segmenter: Integer-Only Vision Transformer for Efficient ...

I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
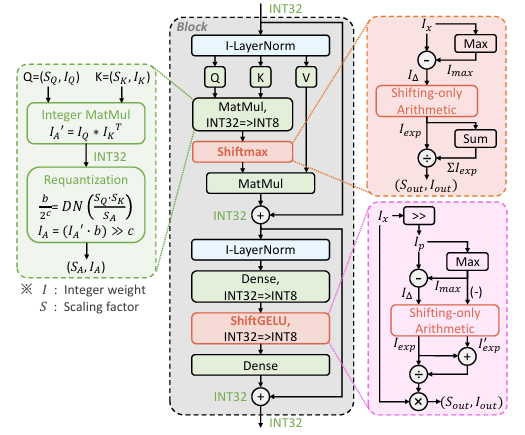
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
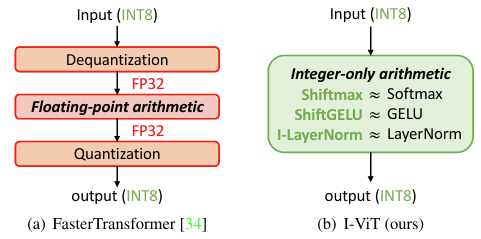
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
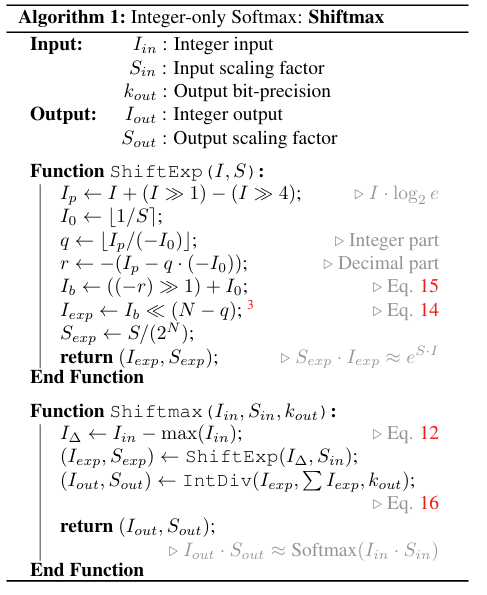
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
Advertisement Space (300x250)

I-ViT: Integer-only Quantization for Efficient Vision Transformer Inference
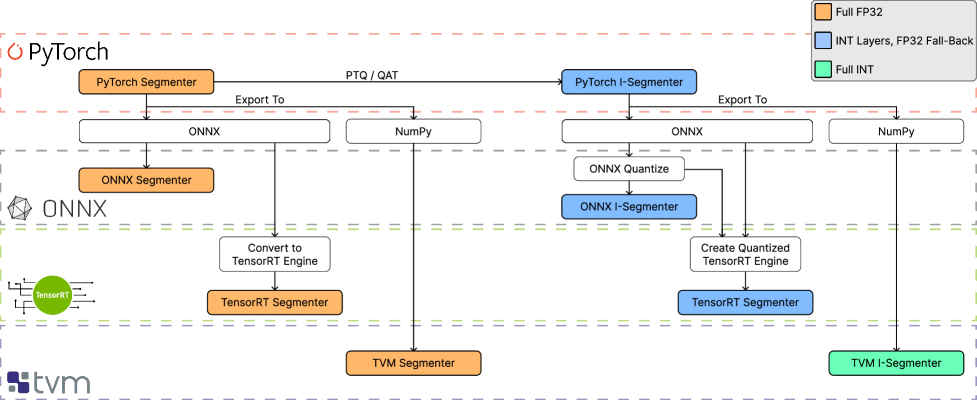
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
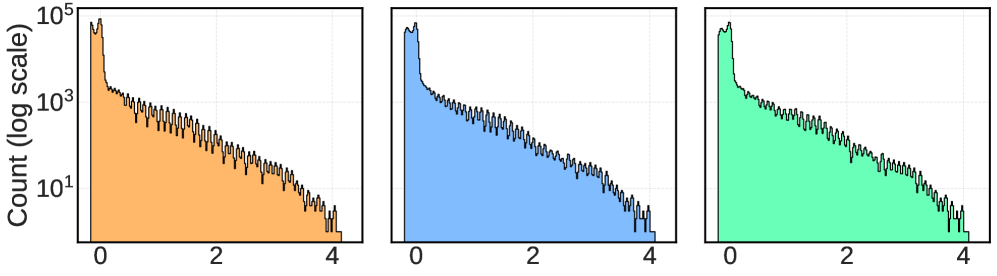
I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
Paper page - SegFormer: Simple and Efficient Design for Semantic ...

I-Segmenter: Integer-Only Vision Transformer for Efficient Semantic ...
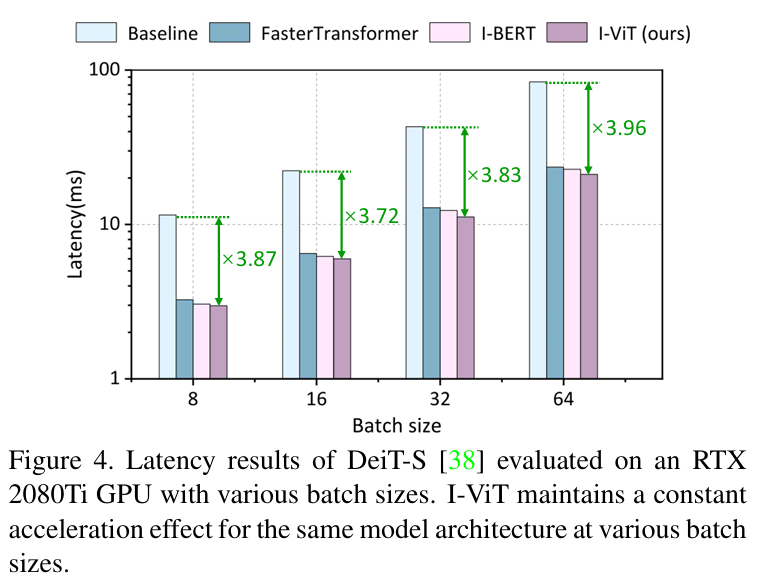
I-ViT: Integer-only Quantization for Efficient Vision Transformer ...
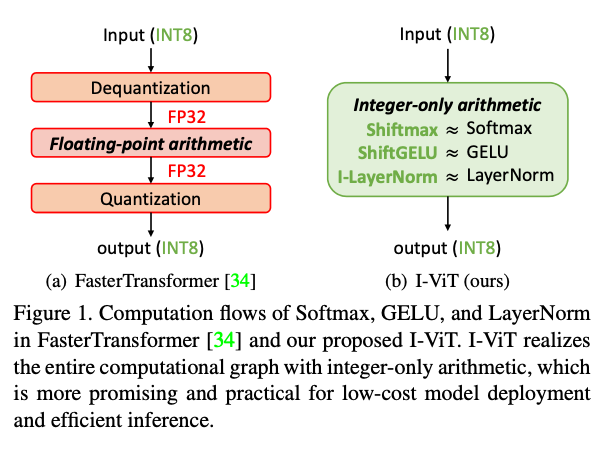
I-ViT: Integer-only Quantization for Efficient Vision Transformer ...

Strudel Segmenter Transformer For Semantic Segmentation ICCV 2021 Paper ...
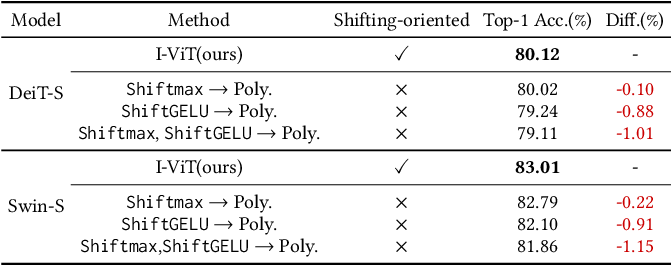
I-ViT: Integer-only Quantization for Efficient Vision Transformer Inference
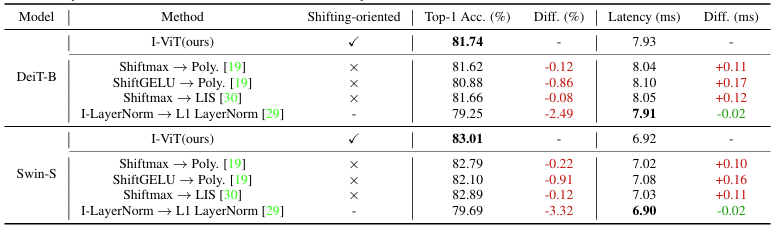
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
Advertisement Space (336x280)
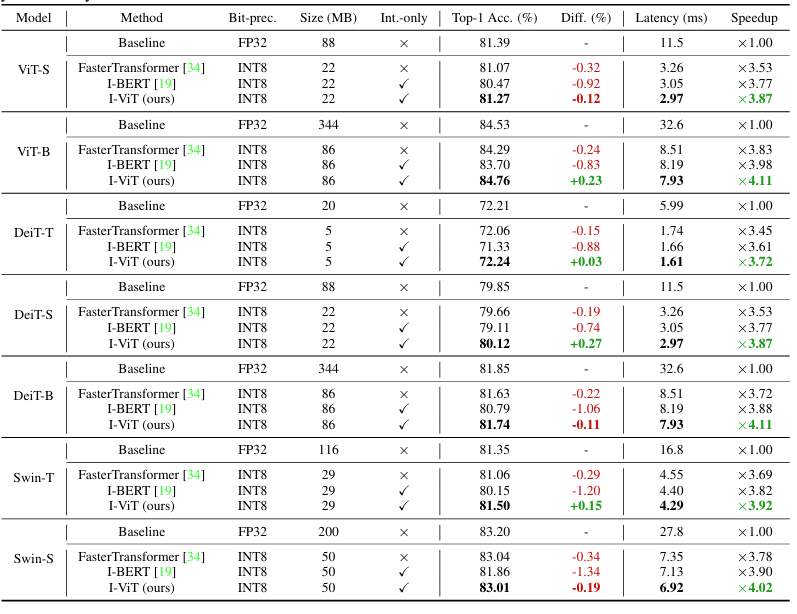
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
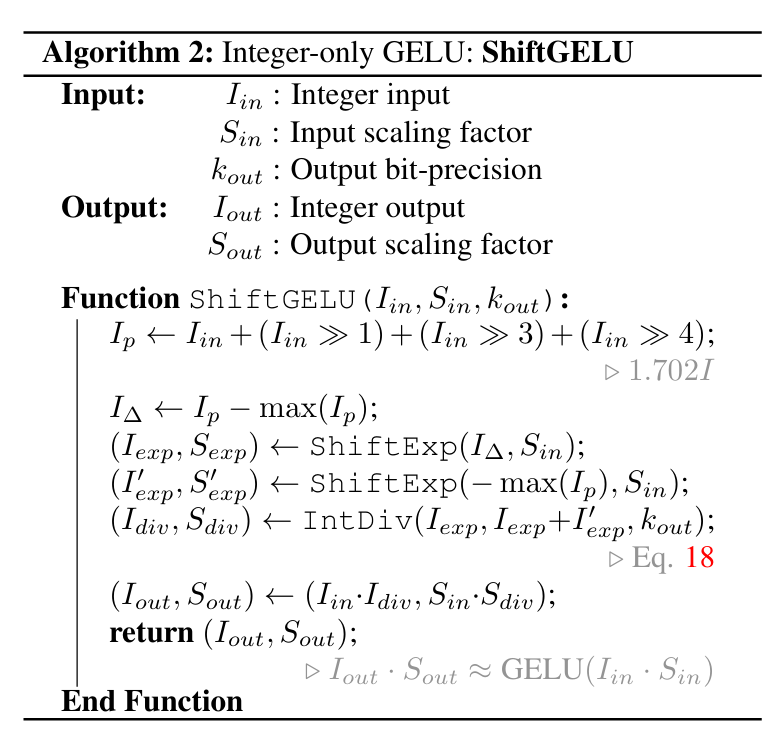
I-ViT: Integer-only Quantization for Efficient Vision Transformer ...
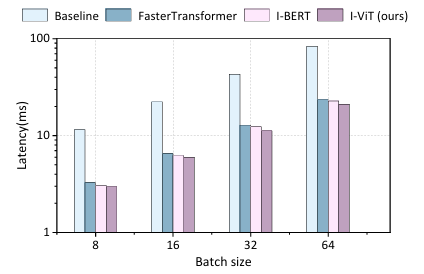
I-ViT Integer-only Quantization for Efficient Vision Transformer ...
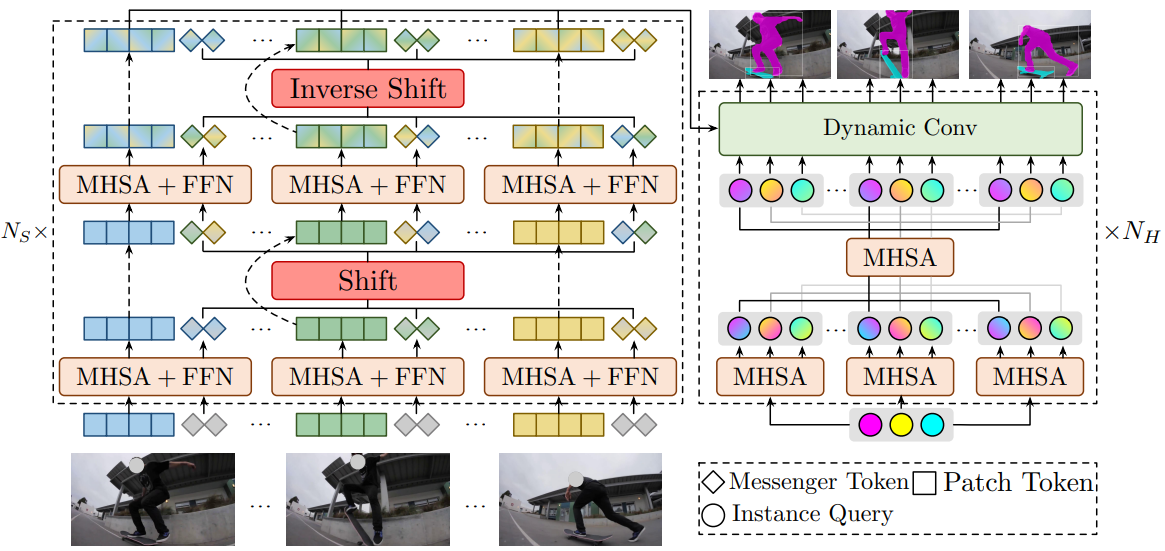
Temporally Efficient Vision Transformer for Video Instance Segmentation ...
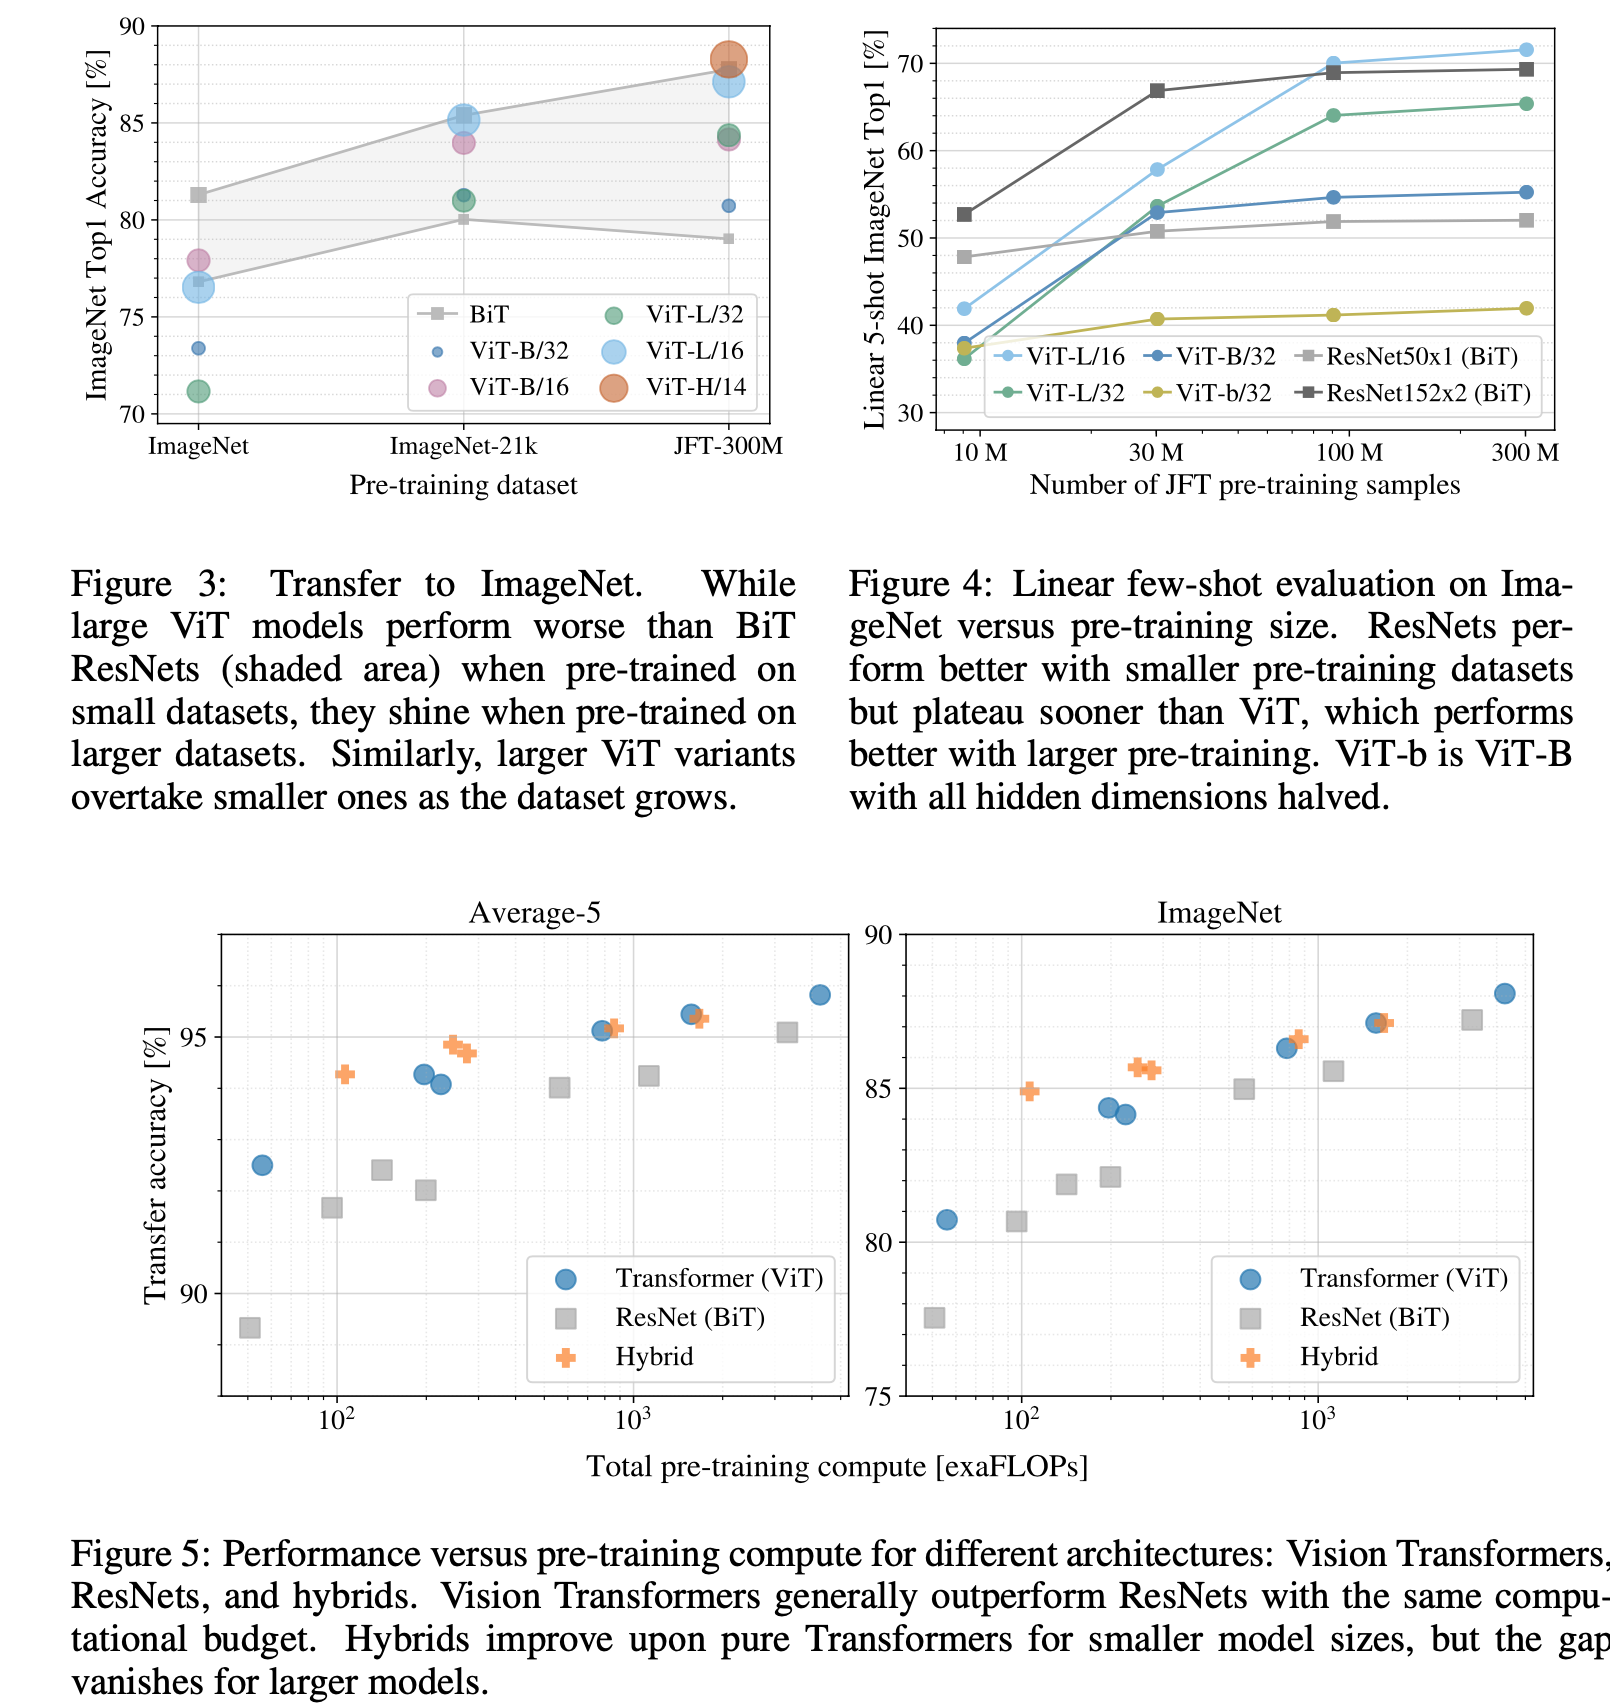
[Vision Paper Review] - ViT : Vision Transformer

Efficient Vision Transformers For Edge Devices | PDF
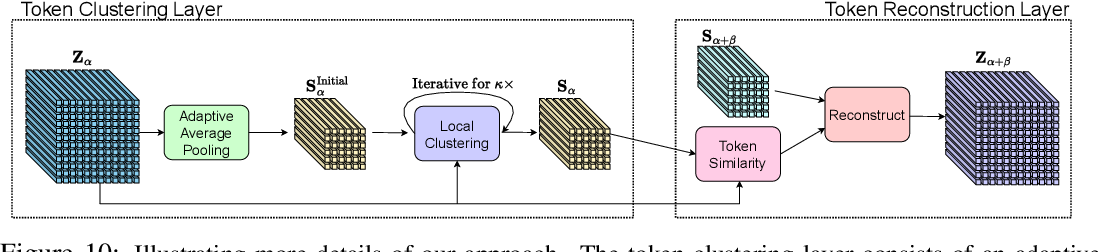
Figure 10 from Expediting Large-Scale Vision Transformer for Dense ...
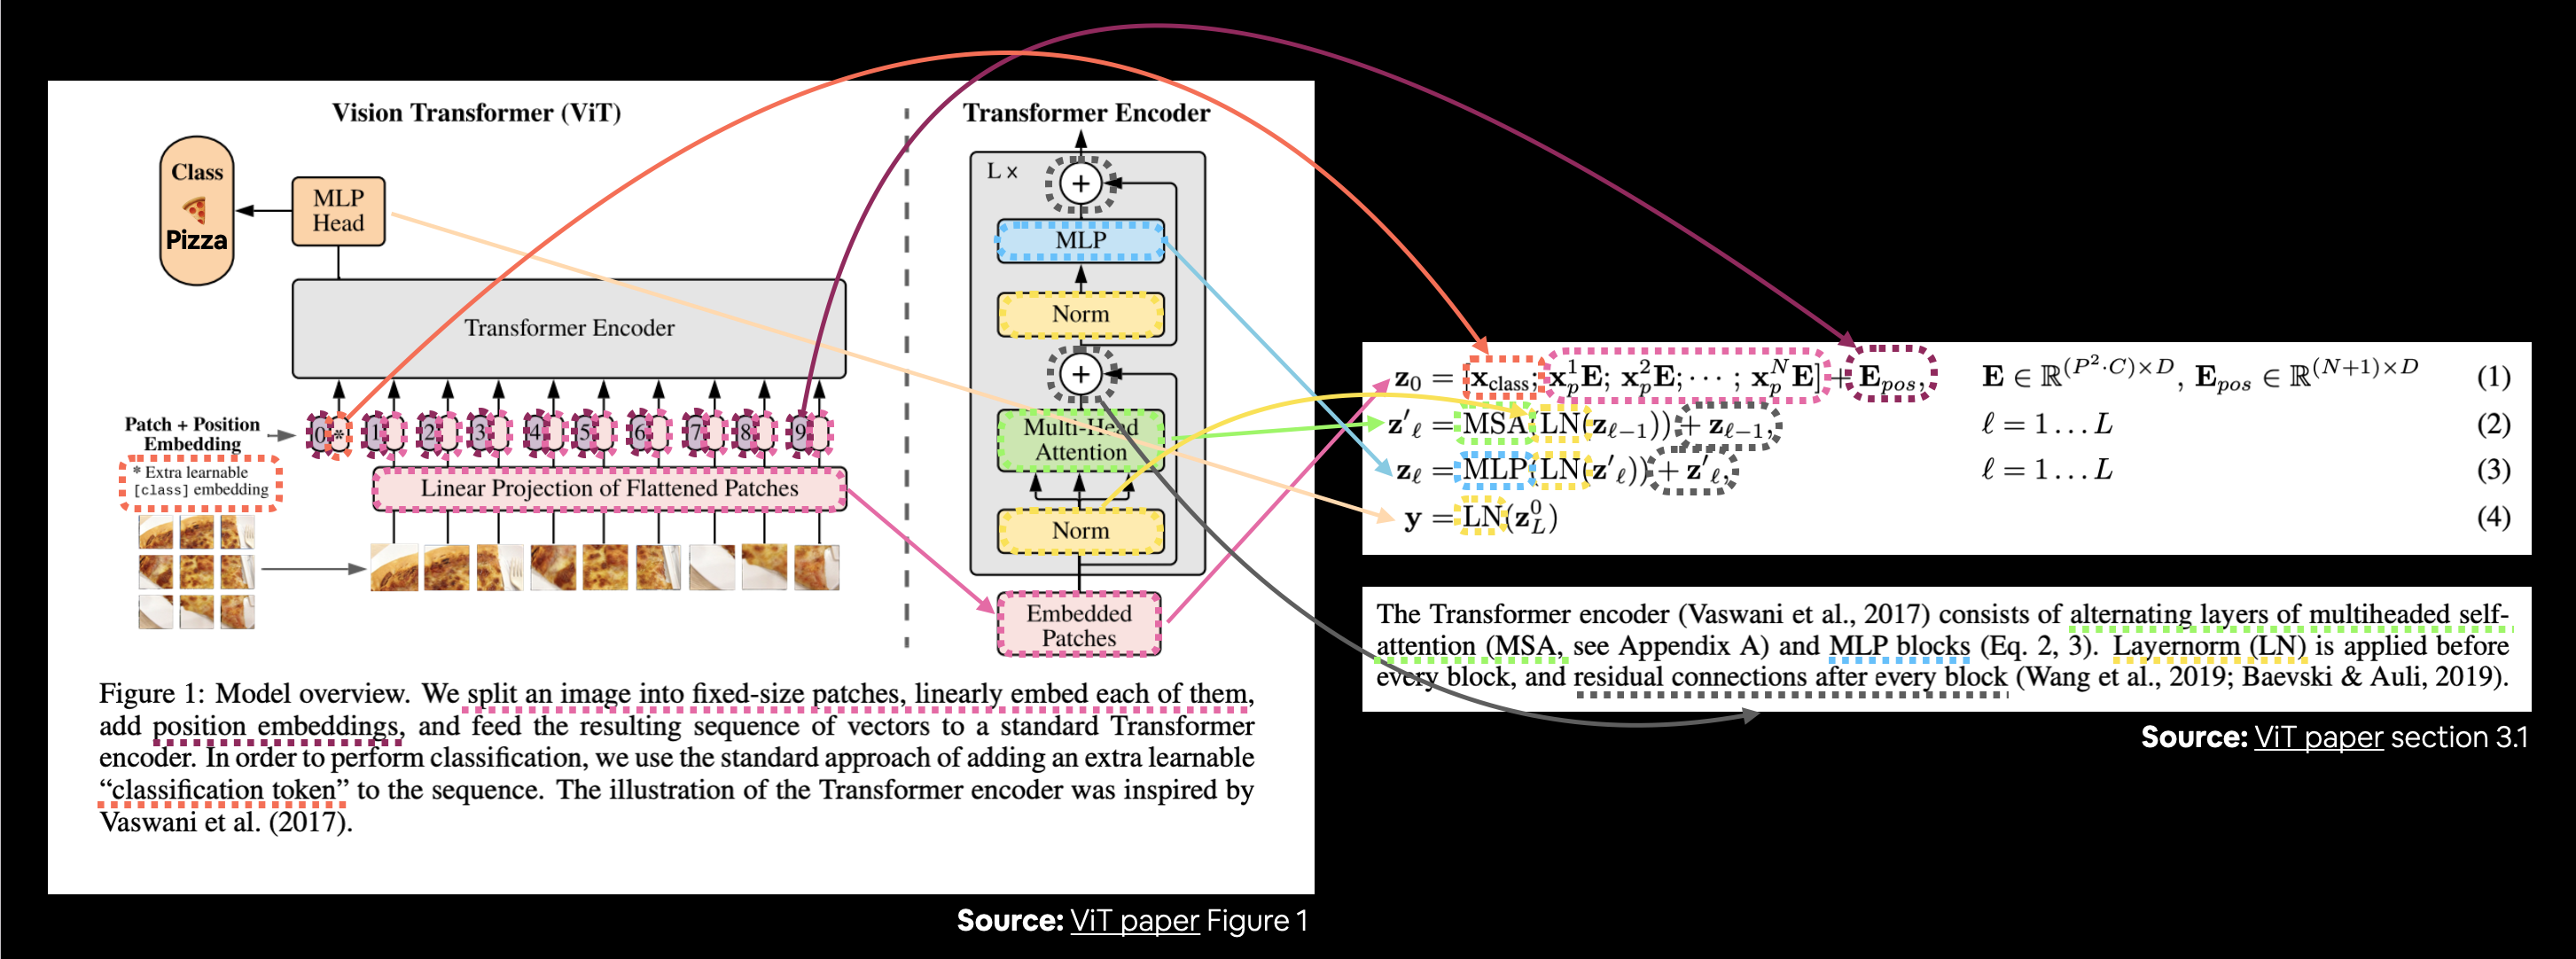
From Vision Transformer Paper to code

A Simple Single-Scale Vision Transformer For Object Localization | PDF ...

An Efficient Light-weight Vision Transformer Based on Split-and-Merge ...
Advertisement Space (336x280)
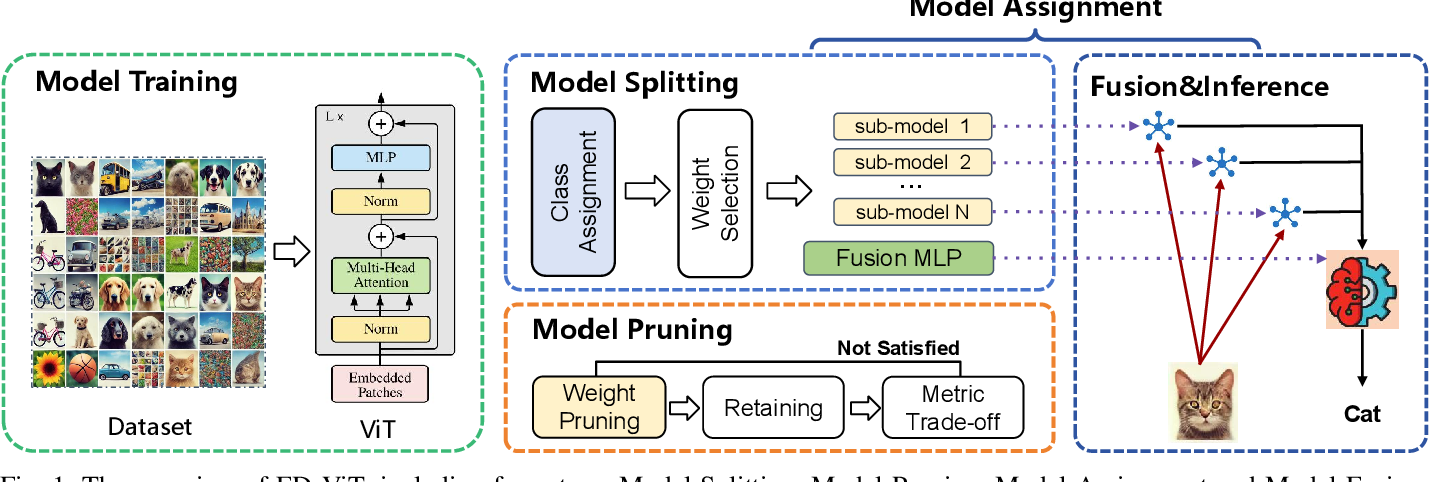
Figure 1 from Efficient Partitioning Vision Transformer on Edge Devices ...

Sequence-Aware Vision Transformer with Feature Fusion for Fault ...
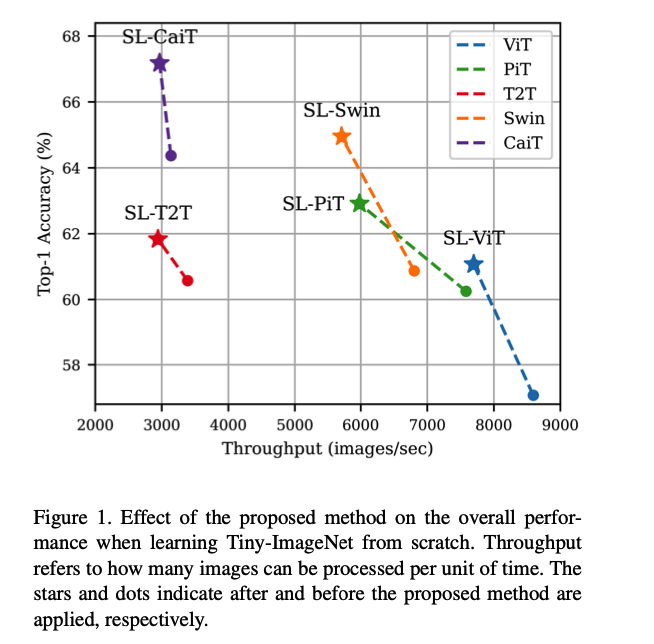
(paper 70) Vision Transformer for Small-Size Datasets - AAA (All About AI)
Vision Transformer Segmenter | rsub122/RescueNet-A-High-Resolution-Post ...
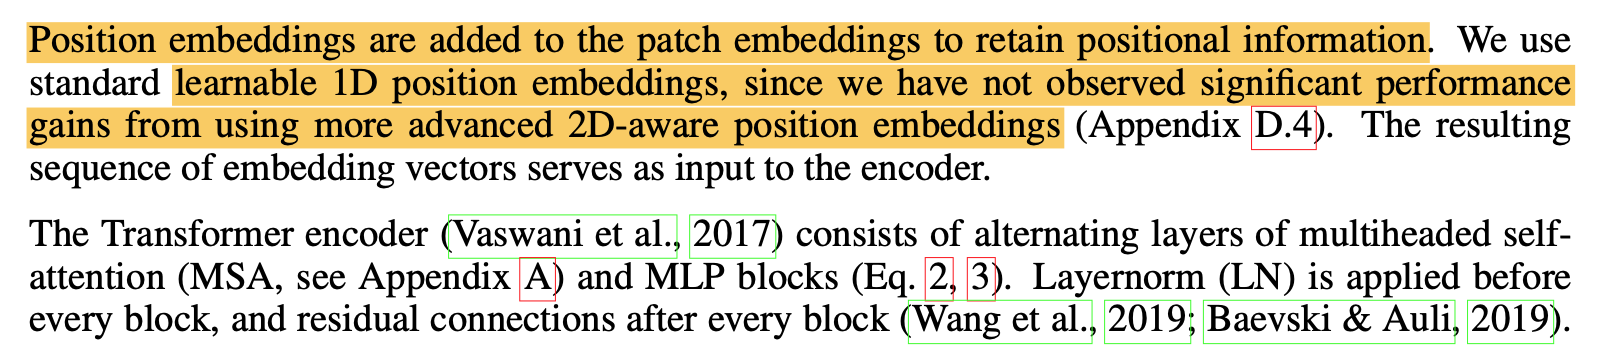
[Vision Paper Review] - ViT : Vision Transformer
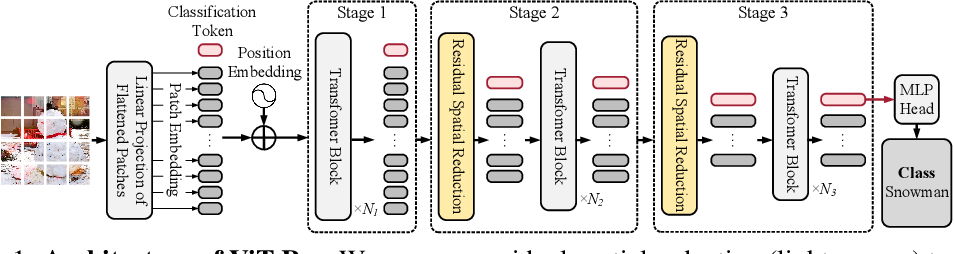
Figure 1 from Searching for Efficient Multi-Stage Vision Transformers ...